一、前言
做传统微服务、接口业务时,卡顿、报错、超时都很好定位,看日志、看QPS、看链路耗时,基本一分钟就能锁定根因,是数据库慢、代码bug、还是网络问题,一目了然。但大模型完全不一样,大模型服务是彻头彻尾的黑盒。传统后端服务出问题,我们心里有数、有据可查;但大模型线上出问题,大多时候只能靠猜。线上问题特别玄学:相同的提问,白天秒回、晚上卡顿;有的用户回复错乱、内容重复、半路截断,后台却没有任何报错日志;再加上现在主流架构都是网关、Agent、向量检索、模型推理层层嵌套,任意一环拖慢,都会影响最终体验。更关键的是,用户真正在意的回复质量、推理稳定性、算力利用率,传统监控完全覆盖不到。
早期我们的运维方式还如传统方式一样,基本停留在“看日志、靠经验、凭运气”的阶段。线上出问题只能被动救火,没法提前预警、没法精准复盘、没法系统性优化,故障反复出现却根治不了。想要彻底摆脱这种被动运维的局面,唯一的解法就是搭建一套适配大模型特性的专属可观测体系。也是经过了反复探索、试错,构建了基于OpenTelemetry+Prometheus+Grafana三位一体监控体系。既能复用云原生成熟的监控能力,又能针对性适配大模型推理、Token生成、KV缓存、Agent调度等AI专属场景。
二、LLM监控痛点
1. 传统监控适配缺陷
传统IT监控体系专为标准化微服务、业务接口设计,核心监控维度仅覆盖CPU、内存、磁盘、网络、接口QPS、错误率、延迟等基础指标,只能判断服务“是否存活、是否正常响应”,完全不匹配大模型应用运行特性:
1.1 业务维度不匹配:
- 大模型核心运行流程包含Prompt预处理、上下文拼接、KV缓存加载、Token逐一生成、向量检索匹配、Agent工具调用等AI专属环节,传统监控无对应采集指标。
- 例如传统监控仅能识别接口超时,但无法精准区分超时诱因是模型推理慢、缓存未命中、向量检索耗时高还是Agent调度异常。
1.2 故障特征不兼容:
- 传统服务故障以5xx、4xx报错、连接超时、资源耗尽等显性问题为主,可通过日志和指标快速定位。
- 而大模型故障多为隐性问题,包含响应幻觉、重复生成、文本截断异常、上下文失效、推理性能抖动、长请求阻塞等,这类问题无系统报错,却直接影响用户体验,传统监控完全无法感知。
1.3 数据粒度不达标:
- 传统监控以分钟级聚合指标为主,适配长期趋势观测。
- 但大模型推理是毫秒级、单请求级的动态过程,单次Prompt推理波动、单Token生成耗时、单次缓存命中状态等精细化数据,会被传统聚合监控完全丢失,无法支撑精准的故障复盘和性能优化。
2. 大模型专属运维难题
除去传统监控的适配短板,大模型落地生产后,还存在多项独有运维痛点,也是企业搭建专属大模型可观测体系的核心原因:
2.1 性能抖动无迹可寻:
- 大模型推理性能受Prompt长度、上下文复杂度、并发量、KV缓存状态多重因素影响。
- 低并发场景响应流畅,高并发、长文本场景下延迟会成倍飙升,且每次性能抖动的诱因各不相同。
- 无精细化监控的情况下,运维人员无法区分问题源于算力扩容不足、缓存失效还是模型本身性能缺陷。
2.2 资源利用率无法量化:
- 大模型部署核心成本为GPU显存与算力资源,成本投入极高。
- 多数企业普遍存在资源分配失衡问题,部分场景显存、算力闲置浪费,部分场景资源爆满阻塞业务,且无量化数据支撑资源调度、扩缩容决策,无法实现算力成本最优配置。
2.3 链路复杂难以排查:
- 主流大模型应用为多层串联架构,完整请求链路为:用户请求→网关路由→Agent调度→向量检索→模型推理→结果返回。
- 任意中间环节异常都会引发整体故障,传统监控仅能展示最终接口结果,无法串联全链路日志、追踪各环节耗时与状态,单次故障排查耗时可达数小时,运维效率极低。
2.4 服务质量无法量化考核:
- 大模型服务可用性不能仅以“能否正常响应”判定,还包含响应速度、Token生成效率、缓存命中率、内容合规率、低幻觉率等核心质量指标。
- 缺少专属监控体系,就无法量化LLM服务SLA,无法精准定位优化方向,难以持续迭代业务体验。
三、核心组件分工
1. OpenTelemetry:统一采集标准
OpenTelemetry,简称OTel,是整套监控体系的核心基石,也是目前云原生和AI领域唯一的开源可观测数据统一标准,核心价值是解决传统监控数据碎片化、格式不统一、无法联动分析的痛点。在OTel诞生前,链路追踪、指标、日志数据相互独立,排查问题需要切换多个工具,效率极低。其核心能力可完美适配大模型运维场景:
1.1 标准化全域数据模型:
- 统一定义Trace链路追踪、Metric性能指标、Log运行日志三类核心可观测数据规范。
- 大模型推理服务、Agent框架、向量数据库、网关等所有业务组件,均可按照统一格式输出数据,实现全栈数据互通、联动分析,彻底消除数据孤岛。
1.2 低侵入轻量化采集:
- 支持无代码、低代码埋点,无需大幅修改大模型业务代码,即可自动采集请求链路、推理耗时、Token数量、缓存状态、异常信息等核心数据。
- 同时兼容Sidecar、SDK、Collector多种部署模式,适配容器化、物理机、云服务等各类大模型部署环境,落地门槛极低。
1.3 大模型专属语义规范:
- 针对性定义LLM专属语义标签,可精准识别Prompt长度、响应Token数、prefill/decode推理阶段、模型版本、请求温度等AI独有参数;
- 解决了传统监控无法识别AI业务场景、无法精细化统计AI指标的核心问题。
2. Prometheus:时序指标存储
Prometheus时序数据库,主打高性能时序指标存储与实时查询,是整套监控体系的核心数据存储与计算组件,专门承接OTel采集的各类量化指标。区别于普通业务数据库,Prometheus专为高频、时序、聚合型的监控数据设计,完美适配大模型动态变化的性能指标,在LLM监控场景中,核心承载四类指标的存储与计算:
- 基础服务指标:包含LLM服务QPS、请求错误率、请求排队长度、接口延迟分布,用于衡量大模型服务整体运行稳定性。
- 推理性能指标:包含prefill上下文预处理耗时、decode单Token生成耗时、整体推理总耗时,是优化模型响应速度的核心数据依据。
- 缓存资源指标:以KV缓存命中率、缓存占用率、缓存失效次数为核心,直接反映大模型缓存调度策略的有效性。
- 硬件资源指标:包含GPU显存使用率、GPU算力利用率、CPU内存占用、并发连接数,用于管控硬件算力成本、规避资源瓶颈。
3. Grafana:可视化与告警
Grafana是整套监控体系的可视化终端与运维中枢,核心作用是将OTel采集、Prometheus存储的原始监控数据,转化为直观图表、可视化大盘、智能告警通知,降低运维观测门槛,无需编写复杂查询即可掌握大模型运行状态。在LLM监控场景中,核心价值体现:
3.1 一站式可视化大盘:
- 支持自定义搭建大模型专属监控面板,集中展示服务可用性、推理性能、缓存状态、GPU资源、请求流量趋势等核心数据,实现一屏观全域。
- 同时官方提供多款AI预构建模板,可快速落地开箱即用的监控页面,大幅缩短部署周期。
3.2 精细化全链路溯源:
- 可无缝对接OTel的Trace链路数据,可视化还原大模型完整请求链路,清晰展示Agent调度、向量检索、模型推理各环节的耗时占比。
- 支持单点点击查询,可快速查看单次请求的完整流程、异常节点和原始日志,精准定位隐性故障。
3.3 全场景智能告警:
- 支持自定义大模型专属告警规则,针对延迟飙升、缓存命中率过低、GPU资源过载、错误率突增、请求堆积等高频异常场景配置阈值。
- 可对接钉钉、企业微信、邮件等渠道实时推送通知,实现事前预警、事中快速处置、事后复盘优化的运维闭环。
四、整体流程架构
1. 分层架构设计
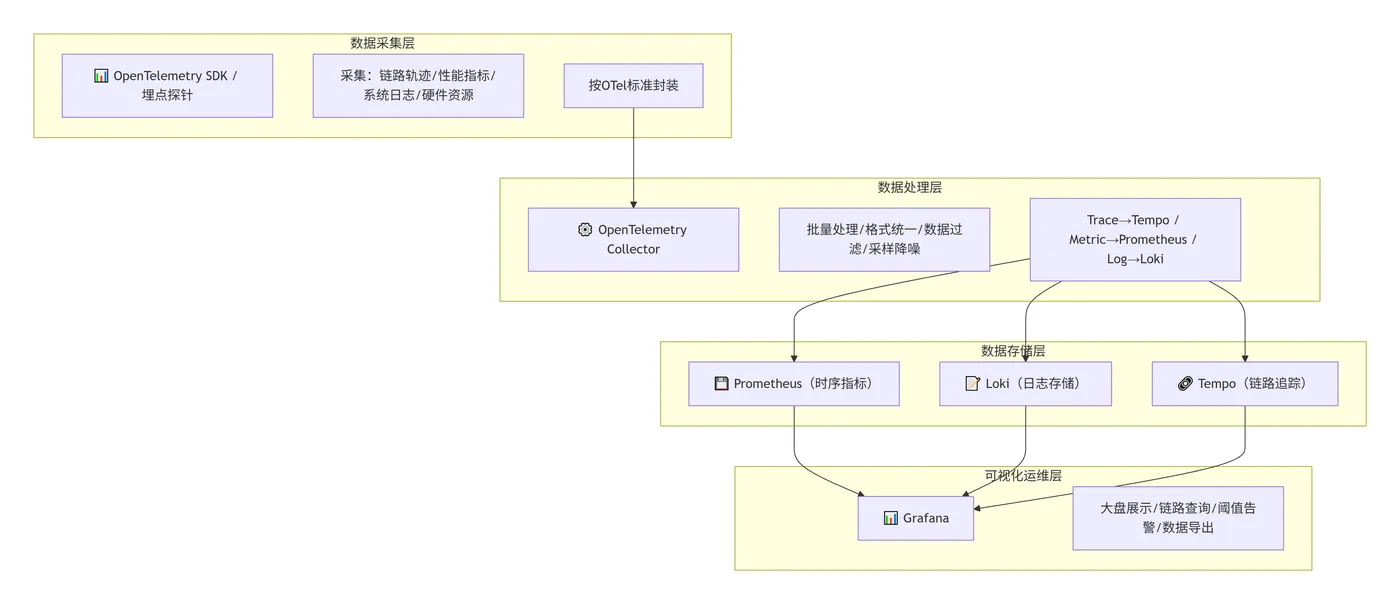
整套大模型可观测体系采用四层分层架构,层级清晰、各司其职、扩展性强,可完美适配单机、集群、K8s容器化等各类大模型部署架构,四层架构具体能力:
1.1 第一层:数据采集层(底层):
- 核心组件为OpenTelemetry SDK与埋点探针,部署在大模型应用、推理服务、向量数据库、Agent网关等所有业务节点。
- 核心职责是实时采集全量可观测数据,包含单次请求完整链路轨迹、推理性能指标、系统运行日志、硬件资源数据,并按照OTel标准完成数据标准化封装。
1.2 第二层:数据处理层:
- 核心组件为OpenTelemetry Collector,作为全域数据统一网关,承接采集层上报的所有监控数据。
- 支持批量处理、格式统一、数据过滤、采样降噪、字段补充能力,可过滤无效冗余数据、降低存储压力;
- 同时将Trace、Metric、Log数据分类分发至对应存储组件,是整套架构的调度核心。
1.3 第三层:数据存储层:
- 核心组件为Prometheus,负责持久化存储所有时序性能指标数据。
- 同时可拓展对接Loki存储日志、Tempo存储链路追踪数据,搭建完整的可观测数据存储体系,保障海量监控数据高效存储、快速查询,支撑长期趋势分析和故障复盘。
1.4 第四层:可视化运维层:
- 核心组件为Grafana,承接所有存储层数据,完成图表渲染、大盘展示、链路查询、阈值告警、数据导出等运维操作,是研发、运维人员的直接交互层级,实现监控数据可视化与运维闭环。
2. 完整数据流转链路
为方便直观理解整套架构的运行逻辑,下面拆解单次大模型用户请求的完整监控数据流转全流程,全覆盖请求生命周期,无数据盲区:
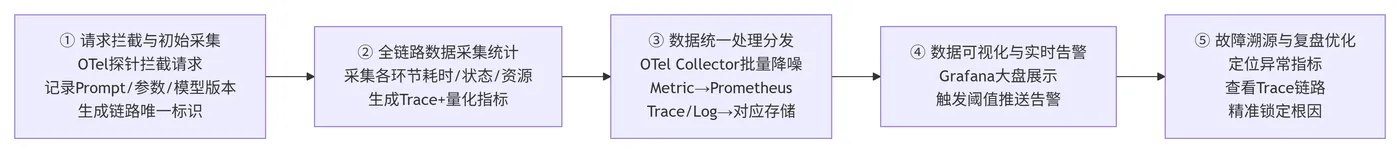
- 第一步:请求拦截与初始采集:用户发起问答、文本生成等大模型请求后,应用端OTel探针自动拦截请求、开启链路追踪,同步记录请求起始时间、Prompt内容、请求参数、模型版本等基础信息,生成链路唯一标识。
- 第二步:全链路数据采集统计:请求依次经过网关路由、Agent调度、向量检索、模型推理等环节,OTel持续采集各环节耗时、运行状态、资源占用情况,生成多个Span节点串联成完整Trace链路,同时实时统计QPS、请求延迟、缓存命中率等量化指标数据。
- 第三步:数据统一处理分发:所有采集到的Trace链路、Metric指标、Log日志数据,统一上报至OTel Collector。经过批量降噪、格式标准化、冗余数据过滤后,将时序指标推送至Prometheus存储,链路与日志数据分发至对应存储组件。
- 第四步:数据可视化与实时告警:Grafana定时拉取Prometheus、Tempo、Loki的存储数据,实时刷新监控大盘,动态展示业务请求趋势、服务性能、资源占用状态。一旦数据触发预设告警阈值,立即通过对应渠道推送告警通知。
- 第五步:故障溯源与复盘优化:线上出现故障或性能异常时,运维人员通过Grafana大盘定位异常指标,跳转对应Trace链路查看完整请求细节与日志,精准锁定问题根源,完成故障排查、修复与复盘优化。
五、部署与配置
1. 环境基础准备
本次实操采用轻量化Docker Compose部署方案,单机即可快速搭建整套监控栈,适配小规模生产场景,所有配置可直接复用,基础环境要求与准备工作如下:
- 硬件与软件要求:服务器配置2核4G及以上,设备预装Docker、Docker Compose环境,保障容器服务正常运行。
- 端口开放要求:开放核心服务端口,9090端口(Prometheus)、3000端口(Grafana)、4317/4318端口(OTel Collector),避免端口占用、端口冲突问题。
- 端口能力对应:OTel Collector通过4317端口接收GRPC协议数据、4318端口接收HTTP协议数据;Prometheus通过9090端口提供指标查询服务;Grafana通过3000端口提供可视化页面。
- 业务环境准备:提前部署并调试好大模型应用,确保LLM推理服务、接口服务可正常访问运行,后续仅需接入OTel埋点即可完成监控对接,无需改造业务核心逻辑。
2. 核心组件配置
第一步:编写docker-compose.yml编排文件
一次性定义并关联OTel Collector、Prometheus、Grafana三大核心服务,自动完成服务依赖、数据转发、端口映射配置,完整可直接运行代码:
version'3.8' services otel-collector imageotel/opentelemetry-collector-contriblatest command"--config=/etc/otel-collector-config.yaml" volumes ./otel-collector-config.yaml:/etc/otel-collector-config.yaml ports "4317:4317" "4318:4318" depends_on prometheus prometheus imageprom/prometheuslatest volumes ./prometheus.yml:/etc/prometheus/prometheus.yml ports "9090:9090" grafana imagegrafana/grafanalatest ports "3000:3000" volumes grafana-data:/var/lib/grafana depends_on prometheus volumes grafana-data

第二步:配置OTel Collector核心规则
新建otel-collector-config.yaml文件,定义数据接收、处理、转发全流程逻辑,适配大模型数据采集场景,开启批量处理、数据降噪能力,将指标数据精准推送至Prometheus,完整配置:
receivers otlp protocols grpc endpoint0.0.0.04317 http endpoint0.0.0.04318 processors batch timeout100ms memory_limiter check_interval1s limit_mib512 exporters prometheus endpoint"prometheus:9090" service pipelines metrics receiversotlp processorsmemory_limiter batch exportersprometheus

第三步:配置Prometheus采集规则
新建prometheus.yml文件,设置全局采集间隔、评估间隔,绑定OTel采集任务,保障稳定拉取大模型监控指标,完整配置:
global scrape_interval15s evaluation_interval15s scrape_configs job_name'otel-collector' static_configs targets'otel-collector:8889'

3. 启动与接入验证
所有配置文件编写完成后,可通过简单指令完成服务启动与环境验证,全程一键部署、快速校验,具体操作步骤如下:
- 服务启动:在项目根目录执行
docker-compose up -d命令,后台一键启动整套监控架构,所有组件自动初始化、关联运行。 - 服务可用性验证:启动完成后,分别访问对应服务页面校验状态:Prometheus:http://服务器IP:9090、Grafana:http://服务器IP:3000,页面可正常访问即为服务启动成功。
- Grafana数据源配置:首次登录使用默认账号密码 admin/admin,登录后强制修改初始密码。在数据源配置页面新增Prometheus数据源,填写地址 http://prometheus:9090,测试连接成功即代表基础架构搭建完成。
- 大模型应用埋点接入:通过Python OTel SDK实现极简低侵入埋点,自动采集LLM请求、推理性能、参数指标,接入后即可在Grafana大盘查看完整监控数据;
4. 大模型OTel埋点示例
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.grpc.trace_exporter import OTLPSpanExporter
# 初始化追踪器
trace.set_tracer_provider(TracerProvider())
tracer = trace.get_tracer(__name__)
# 配置OTel上报地址
otlp_exporter = OTLPSpanExporter(endpoint="http://localhost:4317")
trace.get_tracer_provider().add_span_processor(BatchSpanProcessor(otlp_exporter))
# 大模型请求链路追踪
def llm_infer(prompt):
    with tracer.start_as_current_span("llm-infer") as span:
        # 写入LLM专属自定义标签
        span.set_attribute("llm.prompt.length", len(prompt))
        span.set_attribute("llm.model.name", "Qwen-7B")
        # 模拟大模型推理逻辑
        result = f"模型响应:{prompt} 解析完成"
        span.set_attribute("llm.response.token_num", len(result))
        return result

六、LLM核心监控指标
1. 服务基础指标
服务基础指标是衡量大模型应用整体可用性、稳定性的核心观测维度,是日常运维巡检的核心依据。相较于传统服务指标,新增多项AI场景专属统计维度,更贴合LLM业务运行特性,核心包含五类指标,各指标能力与价值:
- 请求QPS:统计每秒大模型请求量,区分普通问答、流式生成、Agent工具调用等不同请求类型,用于观测业务流量波动,提前预判业务峰值压力,为扩容调度提供依据。
- 请求错误率:分类统计5xx服务异常、4xx参数异常、模型推理失败、请求超时等各类错误占比,精准区分业务参数报错、服务异常报错、模型原生报错,快速定位异常类型。
- 请求排队长度:实时监控LLM服务请求堆积数量,直观判断服务处理能力是否饱和,提前规避高并发场景下的请求阻塞、服务雪崩风险。
- 平均响应延迟:统计服务整体请求耗时,区分短文本、长文本请求延迟,精准识别服务性能抖动、响应卡顿问题。
- 服务在线状态:实时监控推理服务、网关服务、向量检索服务的存活状态,实现服务宕机、离线故障秒级发现。
2. 推理性能指标
推理性能指标是优化大模型用户体验、提升推理效率、降低算力消耗的核心依据,也是LLM监控区别于传统监控的核心亮点。大模型推理分为prefill上下文预处理、decode逐Token生成两大核心阶段,两大阶段耗时直接决定用户体验,核心监控指标:
- prefill阶段耗时:统计输入Prompt上下文的预处理耗时,该指标主要受文本长度、上下文复杂度影响,长文本场景耗时会显著升高,是长请求延迟过高的核心诱因。
- decode单Token耗时:统计模型单次生成一个Token的平均耗时,直接决定流式响应的流畅度,该指标异常升高,代表模型存在算力瓶颈、调度不合理等问题。
- 总推理耗时:单次请求从参数接收、预处理、推理生成到结果返回的全流程耗时,是用户感知最直观的性能指标,用于整体体验优化。
- Token生成速率:统计模型每秒可生成的Token数量,是量化大模型推理效率、评估模型性能的核心标准。
3. 缓存与资源指标
KV缓存是大模型提速、降本的核心机制,缓存运行状态直接决定推理性能与算力成本,是LLM运维的核心观测维度。同时搭配硬件资源指标,可全方位保障服务稳定运行,两类核心指标详情:
- 缓存核心指标:
- 包含KV缓存命中率、缓存占用率、缓存失效次数。
- 高命中率代表大量请求复用历史上下文缓存,推理速度大幅提升、算力消耗显著降低;
- 命中率持续偏低,说明缓存策略不合理、请求上下文重复度低,需优化缓存过期时间、扩容缓存空间;
- 缓存占用率过高会引发频繁缓存淘汰,反而降低推理性能,需及时调整缓存容量。
- 硬件资源指标:
- 核心监控GPU显存使用率、GPU算力利用率、CPU占用、内存占用。
- 大模型推理高度依赖GPU资源,显存爆满会直接导致推理失败、服务卡顿;
- 算力利用率过低代表资源闲置、成本浪费;
- 利用率过高代表算力瓶颈,需通过扩容、优化调度策略平衡稳定性与资源成本。
七、可视化看板搭建
1. 核心看板模块规划
基于上述LLM专属监控指标,可在Grafana中搭建生产级一站式大模型监控看板,无需复杂开发,依托原生图表组件即可实现全覆盖运维场景,整体分为五大核心模块,真正实现一屏掌控全域运行状态:
- 服务健康总览模块:集中展示服务在线状态、总请求量、整体错误率、平均延迟、活跃并发数,直观呈现服务整体健康度,适配日常巡检、全局异常快速排查场景。
- 流量趋势分析模块:通过折线图展示分钟级、小时级QPS变化趋势,区分不同模型、不同业务场景的流量分布,精准识别流量峰值与低谷,为资源调度、扩缩容提供数据支撑。
- 推理性能监控模块:可视化展示prefill/decode阶段耗时分布、Token生成速率、延迟百分位数据,精准定位推理性能瓶颈,支撑模型调优、参数优化。
- 缓存状态监控模块:实时展示KV缓存命中率、缓存占用率、缓存失效次数,持续监控缓存运行状态,辅助优化缓存策略,最大化提升推理效率。
- 硬件资源监控模块:动态展示GPU、CPU、内存资源使用率,实时监控资源波动,规避资源过载风险,减少资源闲置浪费。
2. 常用图表与PromQL示例
看板所有核心数据均依靠PromQL语句查询渲染,以下提供5组生产高频复用语句,适配大模型核心指标展示:
- 大模型服务QPS查询: sum(rate(llm_request_total[1m])) by (model_name) 作用:按模型维度统计每分钟请求量,直观展示实时流量波动趋势。
- LLM请求错误率查询: sum(rate(llm_request_error_total[1m])) / sum(rate(llm_request_total[1m])) 作用:计算1分钟内请求错误占比,实时监控服务异常波动。
- KV缓存命中率查询: sum(rate(llm_kv_cache_hit_total[5m])) / sum(rate(llm_kv_cache_all_total[5m])) 作用:统计5分钟缓存命中率,量化评估缓存策略有效性。
- 推理平均延迟查询: avg(rate(llm_infer_duration_seconds_sum[1m]) / rate(llm_infer_duration_seconds_count[1m])) 作用:统计模型平均推理耗时,精准观测服务性能波动。
- GPU显存使用率查询: avg(gpu_memory_usage_percent) by (gpu_id) 作用:按显卡维度统计显存占用,实时监控硬件资源负载状态。
3. 告警规则配置技巧
可视化展示是运维观测的基础,智能告警是实现主动运维、告别被动救火的关键。结合大模型业务特性,整理出核心告警规则,阈值适配通用AI服务场景,可根据自身业务精度微调。告警渠道支持企业微信、钉钉、邮件等主流方式,可配置分级告警策略,普通预警静默记录、严重故障实时推送,既避免告警轰炸,又保障核心故障零遗漏。具体告警规则:
- 服务异常告警:连续3分钟错误率>1%,触发告警,及时感知服务报错问题,提前规避故障扩散。
- 性能延迟告警:P95推理延迟>3s,持续2分钟,精准捕捉用户可感知的响应卡顿问题。
- 缓存失效告警:KV缓存命中率<60%,持续5分钟,及时发现缓存策略失效问题,快速优化调参。
- 流量堆积告警:请求排队长度>100,持续1分钟,提前预警请求阻塞、服务雪崩风险。
- 资源过载告警:GPU显存使用率>90%,持续3分钟,规避算力耗尽、推理失败问题。
- 服务离线告警:监控节点心跳中断,秒级感知服务宕机、离线故障。
八、问题排查链路
1. 慢请求精准定位
请求延迟高、响应卡顿是大模型线上最频发的问题,传统日志排查无法精准定位耗时环节。依托OTel全链路追踪能力,可实现慢请求一键溯源、精准定位性能瓶颈,无需逐行筛查日志,大幅提升线上问题排查效率,标准化排查流程:
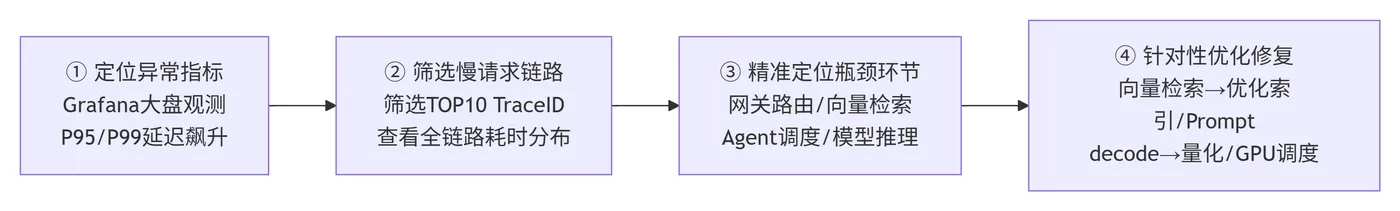
- 步骤一:定位异常指标:通过Grafana大盘观测P95、P99推理延迟,发现延迟飙升、性能抖动异常时,进入链路查询页面。
- 步骤二:筛选慢请求链路:筛选耗时TOP10的慢请求TraceID,点击进入链路详情页,可视化查看全链路耗时分布。
- 步骤三:精准定位瓶颈环节:清晰区分耗时瓶颈来自网关路由、向量检索、Agent调度、模型推理任一环节。
- 步骤四:针对性优化修复:向量检索耗时高,可优化数据库索引、精简检索向量;prefill耗时高,可优化Prompt长度、开启文本截断;decode耗时高,可升级模型量化、优化GPU调度策略。
2. 隐性故障排查方案
大模型隐性故障包含内容幻觉、重复生成、文本截断异常、上下文失效等,此类问题无系统报错、难以主动发现,是运维核心难点。依托整套可观测体系,可精准复现问题、多维分析诱因、界定故障范围,实现隐性故障的精准排查与完整复盘,具体方案:
- 场景精准复现:依托OTel链路持久化数据,完整留存单次请求的Prompt原文、响应内容、模型版本、上下文参数、请求时间,可精准复现异常场景,解决隐性问题难以复现的痛点。
- 多维度诱因分析:结合异常时段的缓存指标、GPU资源指标、流量指标综合研判:缓存未命中易引发上下文加载异常;GPU资源过载会降低推理精度;瞬时流量突增会导致模型调度异常,精准定位问题诱因。
- 问题范围界定:通过指标聚合分析区分问题类型:单条请求异常多为Prompt参数、单次输入问题;批量请求异常则为服务配置、缓存策略、资源调度等全局问题,针对性完成优化修复。
九、总结
大模型应用生产落地,最大的门槛从来不是模型调用、功能开发,而是稳定、可控、可观测的生产运维能力。AI项目很容易陷入“开发简单、运维混乱、故障频发、体验不稳定”的困境,核心原因就是缺失适配大模型特性的可观测体系,任由AI黑盒系统线上运行,所有问题只能被动兜底。
今天我们分析的OpenTelemetry+Prometheus+Grafana监控架构,也是结合了多方资源的考量和探索实践。OTel解决了数据标准化、全链路采集问题,打通了大模型多组件的数据孤岛;Prometheus解决了海量时序指标的高效存储与计算问题,精准量化AI服务性能;Grafana解决了数据可视化、智能告警、运维落地问题,实现监控闭环。三者结合,完美适配大模型推理、缓存调度、Agent流转、向量检索等专属场景。
主要的核心就是打破了大模型运维黑盒,实现了从“被动救火”到“主动预警”、从盲目优化到数据驱动的运维升级。不仅能快速排查线上故障、定位性能瓶颈,还能量化服务SLA、优化资源成本、持续迭代模型体验,为大模型业务稳定落地、规模化复用提供核心保障。未来随着大模型Agent、多模态AI、智能应用的持续普及,可观测性会成为AI工程的核心基础能力。