新人第一周接大模型调用,问题大多集中在参数上:temperature、max-tokens、stream、思考开关各填什么。帮助文本给的是取值和默认值,不给"填错之后返回里哪里会露出马脚"。
我把一轮对照实验的读数整理成了可以直接抄进团队文档的六条须知,配一张验收判据表。想要的是口径统一:同一份规范下,每个人对"答案完整不完整""输出能不能复现"给出同一个判断。
取数环境:阿里云百炼 CLI(bl 2.1.0),模型 qwen3.8-flash,输出是 2026-10-13 我在自己电脑上敲的,每次都是几十 token 的小调用。第一次调用怎么跑通另有一篇《第一次调用大模型,卡住我的不是代码》,规范里可以把它当先修材料,这篇从"已经能拿到一段结构化返回"开始。
一、三处容易被写进错误规范的地方
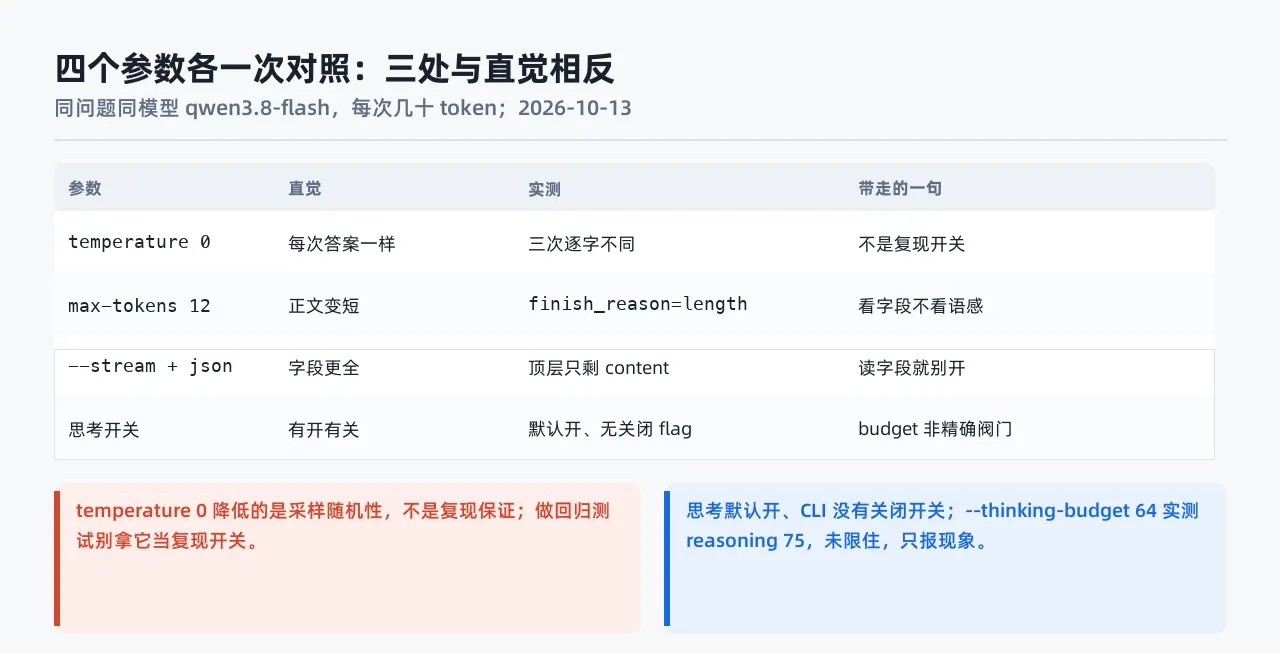
第一处是把 temperature 0 当复现开关。它管的是采样随机性,也就是模型挑下一个词时随机程度多大;同一个问题、同一组参数连调三次,三段文本逐字不同。规范里如果写"固定输出请设 temperature 0",回归对比这条流程从起点就是错的。
第二处是用句子通不通判断答案完整。被长度截断的答案有时候读起来也像完的,我这次拿到的半句是"安装:执行官方安装命令或下载安装包,完成软件"。判断完整性的字段是 finish_reason,stop 是说完,length 是被截。
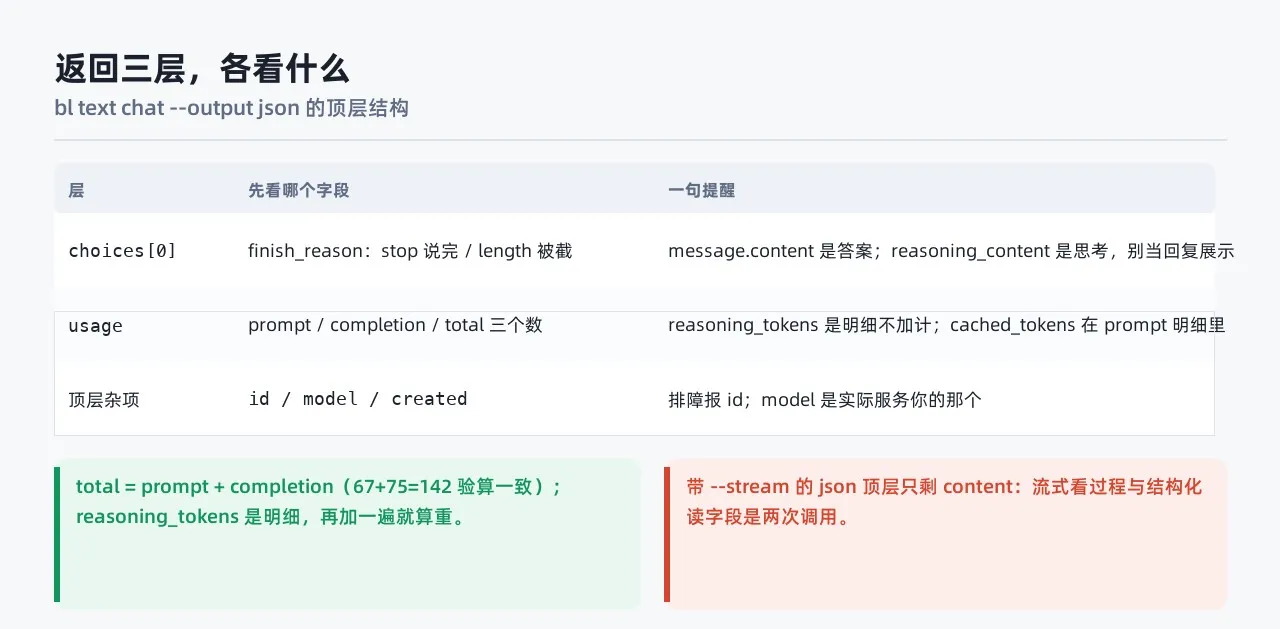
第三处是把 --stream 当成纯显示选项。它改的是返回结构:带 stream 的 json 顶层只有 content,choices、usage、finish_reason 都不在。
这三处的共同点是都不会报错。返回照给,内容也有,错的是后面拿这段返回去做的事:当成基准的输出对比、存进库的半句话、缺字段的解析逻辑。
二、环境与取数口径
- 装
bl:入口在 CLI 安装页,一条 npm 命令 - 配好 API Key:在 API Key 签发页 签发
- 统一加
--output json,返回才是结构化格式,字段可逐条核
bl text chat --model qwen3.8-flash --message "用一句话解释什么是 token。" --output json
规范里建议把模型名与 CLI 版本一起写死。这轮读数会变的部分是模型默认行为和参数口径,命令签名相对稳定,所以验收要连版本号一起记,过期读数不要沿用。
三、新人须知六条
六条里四条讲参数怎么设,两条讲返回怎么读。每条都对应这轮的一个读数,判据表里能查到。
- 要复现别靠
--temperature 0。 同问同参连调三次,三段文本逐字不同。它降低的是采样随机性,不是复现保证;回归测试和截图对比都不要拿它当基准 - 判断截断看
finish_reason == length。 不看句子通不通。命中 length 的两种处理:调高--max-tokens(帮助文本写的默认值是 4096)重试,或把这条结果显式标记为不完整再进下游 - 解析字段的代码路径里不要开
--stream。 帮助文本写的是"默认在终端里开"(default: on in TTY),脚本和管道里默认非流式;带 stream 时顶层只有 content。看过程与读字段是两次调用 - 思考默认开着,这条命令没有关闭位。 不加任何 thinking 参数时返回里就有
reasoning_content,usage里单列reasoning_tokens(我这次是 45)。与思考相关的开关只有--enable-thinking(开启)和--thinking-budget(上限,默认 4096),没有关闭思考的参数 --thinking-budget不是精确阀门。 设 64 时reasoning_tokens是 75,没被限住。为什么没限住我没查明,规范里按现象写,容量规划不要依赖它reasoning_content是思考不是答案,reasoning_tokens是明细不加计。 展示给用户的是message.content;total_tokens等于prompt_tokens加completion_tokens(我这次 67 + 75 = 142),reasoning 再加一遍就算重。排障时带上顶层id
四、验收判据表
新环境接入或者版本升级后,按这张表跑一遍,五项都对得上才算口径没变。跑完把日期与 CLI 版本记在表头,下一次的读数才有可比性。
| 验收项 | 期望读数(2026-10-13) | 判定命令 | 不符合时的处理 |
|---|---|---|---|
| 输出可复现性 | 逐字相同 = 否 | bl text chat --temperature 0 --output json 连跑三次 |
若三次逐字相同,更新规范第一条并复核模型版本 |
| 截断信号 | finish_reason = length,正文截断,reasoning_content 仍在 |
同上加 --max-tokens 12 |
若返回 stop,说明上限语义变了,重查帮助文本 |
| 流式返回形状 | json 顶层只有 content | 同上加 --stream |
若字段回来了,可合并为一次调用,同步改第三条 |
| 思考默认态 | 有 reasoning_content,reasoning_tokens 45 |
不加 thinking 参数 | 若思考段消失,说明默认态变了,重跑并更新第四条 |
| budget 上限 | 设 64 得 75,未限住 | 加 --thinking-budget 64 |
若被限住,第五条改写为可用阀门,注明版本 |
表里的 token 数(45、67、75、142)是这一轮的读数,会随提问内容变化;判据是它们之间的关系和字段的存在性,不是具体数值本身。
五、返回三层字段的读取规范
choices[0]:先读finish_reason决定这条数据能不能用,再读message.content。message.reasoning_content是思考过程,不得当回复渲染给用户usage:prompt / completion / total 三个数,加两个明细块(prompt 侧的cached_tokens、completion 侧的reasoning_tokens与text_tokens)。判断一次调用的体量看这里- 顶层杂项:
id是这次调用的编号,报障时必带;model是实际服务你的那个模型;created是时间戳
批量跑的时候按这个顺序读省事:先看结束原因决定这条数据能不能用,再看正文,最后才是体量与排障信息。评审别人代码时也一样,先看有没有处理 finish_reason == length 的分支,再看解析逻辑。
六、口径纪律:没有证据的结论不进规范
这轮有三处只写现象不写推断,规范里也照这个方式落笔。
一是 --thinking-budget 设 64 得 75 未被限住,为什么没限住我没查明。二是 --max-tokens 12 时思考段看起来没被那 12 个 token 限住,它和正文的计数口径我没查明。三是 --top-p:帮助文本只有一句"Nucleus sampling threshold",我跑了 0.01 和 0.9 各两次,finish_reason 都是 stop,看不出行为差异,不构成证据,所以规范里只引帮助文本口径,具体分工以官方文档为准。
写成"现象 + 待核"比写一个听起来合理的解释有用:后者会被下一个人当结论引用。
七、零价格口径
usage 只给 token 计数,返回里不给金额。想知道一次调用花了多少钱,去控制台账单页;想看额度余量,去控制台额度页。规范文档里不要抄任何金额与额度数字,这类数字有有效期,抄进文档就是过期源。我这边的控制台会话过期了,这轮的账单与额度数字查不到,也就不写。
团队要统计用量,口径统一用 total_tokens:它等于 prompt 加 completion。两个明细块里的数是给你看构成的,不是拿来累加的。
八、边界与移交
不在这份口径里的:第一次调用的跑通步骤(另有篇);--tool 工具调用与 --api responses 那条路(另有包讲过检索臂);多模型横向对比(这轮只锁 qwen3.8-flash 一个模型,为的是把参数这一个变量单独看清)。
第二节给过安装与 Key 两个入口,控制台侧还有一个 阿里云百炼首页,账单页与额度页从那里进。这轮验收加起来是一个 Key 和几十次小调用,按季度重跑一次就能保证判据表不过期。