摘要:系统拆解 Spark 全部 Transformation 算子——按 map/filter 类、聚合类、连接类、分区类、集合类五大分类,逐个剖析语法、依赖类型(窄/宽)、底层原理、性能特征和适用场景。配有 2 张原创架构图、25+ 算子速查表和完整 Scala 代码示例。面向 Java、大数据及 AI 开发工程师。
一、Transformation 算子全景分类
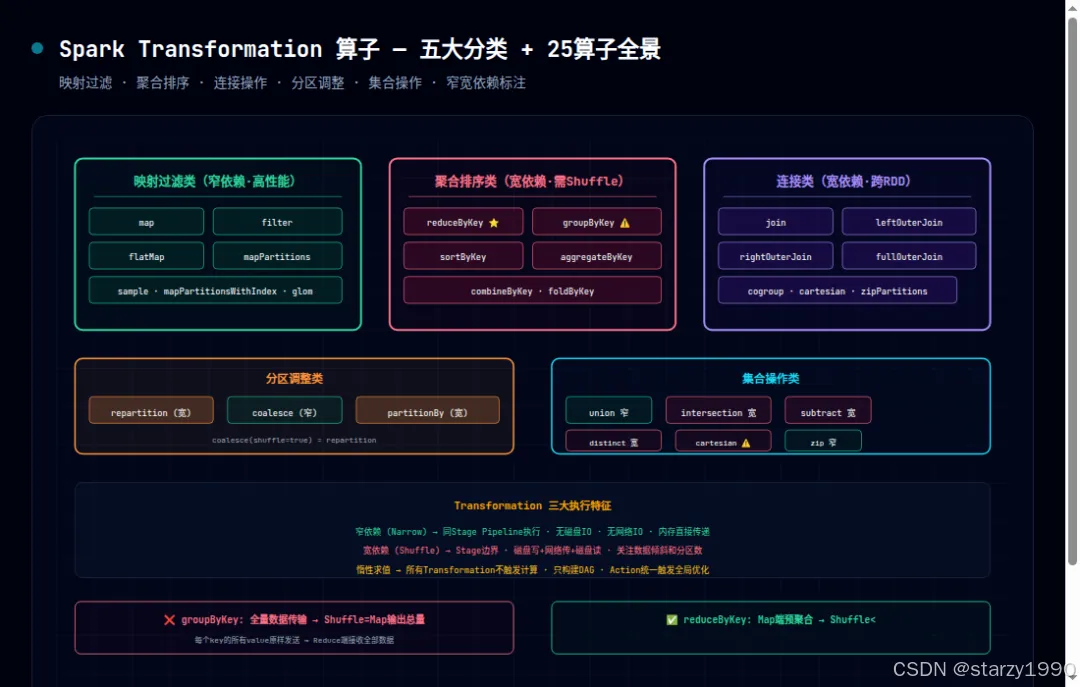
Transformation(转换算子)是 Spark RDD 编程的核心——返回新 RDD,惰性求值,不触发计算。按功能可划分为五大类:
| 分类 | 代表算子 | 依赖类型 | 核心特征 |
|---|---|---|---|
| 映射过滤类 | map / filter / flatMap / mapPartitions / sample | 窄依赖 | 1:1 映射,Pipeline 执行 |
| 聚合排序类 | reduceByKey / groupByKey / sortByKey / aggregateByKey / combineByKey | 宽依赖 | 需 Shuffle,Map 端可预聚合 |
| 连接类 | join / leftOuterJoin / rightOuterJoin / fullOuterJoin / cogroup / cartesian | 宽依赖 | 多 RDD 关联,触发 Shuffle |
| 分区调整类 | coalesce / repartition / partitionBy / repartitionAndSortWithinPartitions | repartition=宽 | 改变分区数或分区器 |
| 集合操作类 | union / intersection / subtract / distinct / zip | 部分宽依赖 | RDD 间集合运算 |
二、映射过滤类算子(窄依赖,高性能)
2.1 map — 逐元素映射
// 签名:def map[U](f: T => U): RDD[U]
// 依赖:OneToOneDependency(窄依赖)
// 性能:无Shuffle,Pipeline执行

val rdd = sc.parallelize(1 to 100)
val squared = rdd.map(x => x * x)           // 1:1 映射
val logs = sc.textFile("hdfs://logs/")
  .map(line => parseJson(line))              // 解析为对象
2.2 filter — 过滤保留
// 签名:def filter(f: T => Boolean): RDD[T]
// 依赖:OneToOneDependency(窄依赖)

val rdd = sc.textFile("hdfs://logs/")
val errors = rdd.filter(_.contains("ERROR"))  // 只保留包含ERROR的行
val valid = rdd.filter(_.nonEmpty)             // 过滤空行

// ⚠️ 性能建议:在Shuffle前尽早filter,减少后续数据量
rdd.filter(_.isValid).map(extract).reduceByKey(_ + _)  // ✅ filter在前
2.3 flatMap — 一对多映射
// 签名:def flatMap[U](f: T => TraversableOnce[U]): RDD[U]
// 依赖:OneToOneDependency(窄依赖)

// WordCount 分词 — flatMap 最经典用法
val words = sc.textFile("data.txt")
  .flatMap(line => line.split("\\s+"))  // 1行 → N个词

// 展开嵌套结构
val rdd = sc.parallelize(List(List(1,2), List(3,4)))
rdd.flatMap(identity).collect()  // Array(1,2,3,4)
2.4 mapPartitions — 分区级操作(性能优化关键)
// 签名:def mapPartitions[U](f: Iterator[T] => Iterator[U]): RDD[U]
// 依赖:OneToOneDependency(窄依赖)
// ⚡ key difference: f 的参数是整个分区的迭代器,不是单个元素

// ❌ 低效:每条记录创建一个数据库连接
rdd.map { record =>
  val conn = DriverManager.getConnection(url)  // 每条都创建连接
  conn.execute(record)
}.collect()

// ✅ 高效:每个分区创建一个连接
rdd.mapPartitions { iter =>
  val conn = DriverManager.getConnection(url)   // 每个分区只创建1次
  iter.map(record => conn.execute(record))      // 复用连接
}
2.5 sample — 随机采样
// withReplacement: 是否放回采样
// fraction: 采样比例
rdd.sample(withReplacement = false, fraction = 0.1)        // 10%不放回
rdd.sample(withReplacement = true, fraction = 0.5)         // 50%放回
rdd.takeSample(withReplacement = false, num = 100)         // 返回Array(Action!)
三、聚合排序类算子(宽依赖,需 Shuffle)
3.1 reduceByKey — 按 Key 聚合(Map 端预聚合)
// 签名:def reduceByKey(func: (V, V) => V): RDD[(K, V)]
// 依赖:ShuffleDependency(宽依赖)
// ⚡ Map 端先做 Combine(预聚合),大幅减少 Shuffle 数据量

val rdd = sc.parallelize(Seq(("a",1),("b",2),("a",3),("b",4)))
rdd.reduceByKey(_ + _).collect()
// Array((a,4), (b,6))

// reduceByKey 的执行流程:
// 1. MapTask 在每个分区内先做本地聚合 (Combine)
// 2. 将聚合后的结果写入 Shuffle 文件(数据量大幅减少)
// 3. ReduceTask 拉取后进行最终聚合
3.2 groupByKey — 按 Key 分组(慎用!)
// 签名:def groupByKey(): RDD[(K, Iterable[V])]
// 依赖:ShuffleDependency(宽依赖)
// ❌ Map端不做预聚合,全量数据 Shuffle!

val rdd = sc.parallelize(Seq(("a",1),("b",2),("a",3)))
rdd.groupByKey().collect()
// Array((a,CompactBuffer(1, 3)), (b,CompactBuffer(2)))

// ⚠️ 性能对比(关键面试题!)
// reduceByKey:Map端聚合 → Shuffle数据量 = O(分区数 × Key种类数)
// groupByKey:  Map端不聚合 → Shuffle数据量 = O(总数据量)
// 数据量大时性能差数倍到数十倍!
3.3 sortByKey — 按 Key 排序
// 依赖:ShuffleDependency + RangePartitioner
val rdd = sc.parallelize(Seq((3,"c"),(1,"a"),(2,"b")))
rdd.sortByKey().collect()              // 按Key升序
rdd.sortByKey(ascending = false)       // 按Key降序
rdd.sortBy(_._1)                       // 等价写法(sortBy底层调sortByKey)
3.4 aggregateByKey — 灵活的分区内/区间聚合
// 签名:def aggregateByKey[U](zeroValue: U)(seqOp: (U,V)=>U, combOp: (U,U)=>U)
// seqOp: 分区内聚合 · combOp: 分区间聚合

// 求每个key的平均值
val rdd = sc.parallelize(Seq(("a",1),("a",2),("a",3)))
val avg = rdd.aggregateByKey((0,0))(
  seqOp = { case ((sum,count), v) => (sum+v, count+1) },   // 分区内累积
  combOp = { case ((s1,c1),(s2,c2)) => (s1+s2, c1+c2) }    // 分区间合并
).mapValues { case (sum, count) => sum.toDouble / count }
3.5 combineByKey — 最底层的聚合算子
// combineByKey 是 reduceByKey/aggregateByKey/groupByKey 的底层实现
// createCombiner: 第一个值如何初始化累加器
// mergeValue: 分区内如何合并
// mergeCombiners: 分区间如何合并

val rdd = sc.parallelize(Seq(("a",1),("b",2),("a",3)))
rdd.combineByKey(
  (v: Int) => (v, 1),                                 // createCombiner
  (acc: (Int,Int), v: Int) => (acc._1+v, acc._2+1),   // mergeValue
  (a1: (Int,Int), a2: (Int,Int)) => (a1._1+a2._1, a1._2+a2._2) // mergeCombiners
).collect()
3.6 聚合算子选型速查
| 需求 | 推荐算子 | 理由 |
|---|---|---|
| 按Key求和/计数 | reduceByKey |
Map端预聚合,数据量小 |
| 按Key分组后自定义逻辑 | aggregateByKey |
灵活控制聚合逻辑 |
| 需要原始分组列表 | groupByKey + mapValues |
万不得已才用(⚠️慎用) |
| 实现自定义聚合器 | combineByKey |
最底层,完全控制 |
四、连接类算子(宽依赖)
4.1 join — 内连接
val orders = sc.parallelize(Seq((1,"iphone"),(2,"macbook")))
val users = sc.parallelize(Seq((1,"Alice"),(3,"Bob")))
orders.join(users).collect()
// Array((1,(iphone,Alice)))  — 只返回两边都有的key
4.2 leftOuterJoin / rightOuterJoin — 外连接
orders.leftOuterJoin(users).collect()
// Array((1,(iphone,Some(Alice))), (2,(macbook,None)))  — 左边全保留
orders.rightOuterJoin(users).collect()
// Array((1,(Some(iphone),Alice)), (3,(None,Bob)))      — 右边全保留
4.3 cogroup — 多 RDD 协同分组
// 同时对多个RDD按Key分组(join的底层实现)
val rdd1 = sc.parallelize(Seq(("a",1),("b",2)))
val rdd2 = sc.parallelize(Seq(("a","x"),("b","y")))
rdd1.cogroup(rdd2).collect()
// Array((a,(CompactBuffer(1),CompactBuffer(x))), (b,(CompactBuffer(2),CompactBuffer(y))))
五、分区调整类算子
5.1 repartition vs coalesce
// repartition: 强制Shuffle重新分区(可增可减)
rdd.repartition(100)                        // 宽依赖

// coalesce: 不Shuffle合并相邻分区(只能减少,不能增加)
rdd.coalesce(10)                            // 窄依赖(合并相邻分区)

// 区别:
// repartition(100) = coalesce(100, shuffle=true)  // 等价!
// coalesce(10) 不Shuffle → 数据分布可能不均匀
// coalesce(10, shuffle=true) 带Shuffle → 数据均匀分布
5.2 partitionBy — 指定分区器
// 对K-V RDD按指定Partitioner重新分区
rdd.partitionBy(new HashPartitioner(10))     // 宽依赖
rdd.partitionBy(new RangePartitioner(10, rdd)) // 宽依赖

// ⚡ 性能优化:co-partitioned join 免Shuffle
val r1 = data1.map((_,1)).partitionBy(new HashPartitioner(10))
val r2 = data2.map((_,1)).partitionBy(new HashPartitioner(10))
r1.join(r2)  // 0次Shuffle!— 因为两个RDD分区方案一致
六、集合操作类算子
val rdd1 = sc.parallelize(1 to 5)    // {1,2,3,4,5}
val rdd2 = sc.parallelize(3 to 7)    // {3,4,5,6,7}

rdd1.union(rdd2).collect()             // 并集 {1,2,3,4,5,3,4,5,6,7} — 窄依赖,保留重复
rdd1.intersection(rdd2).collect()      // 交集 {3,4,5} — 宽依赖(需Shuffle去重)
rdd1.subtract(rdd2).collect()          // 差集 {1,2} — 宽依赖
rdd1.distinct().collect()              // 去重 {1,2,3,4,5} — 宽依赖
rdd1.cartesian(rdd2).collect()         // 笛卡尔积 — 极耗资源,慎用!
rdd1.zip(rdd2).collect()               // 拉链 — 窄依赖,要求分区数+元素数相同
七、Transformation 执行原理全景
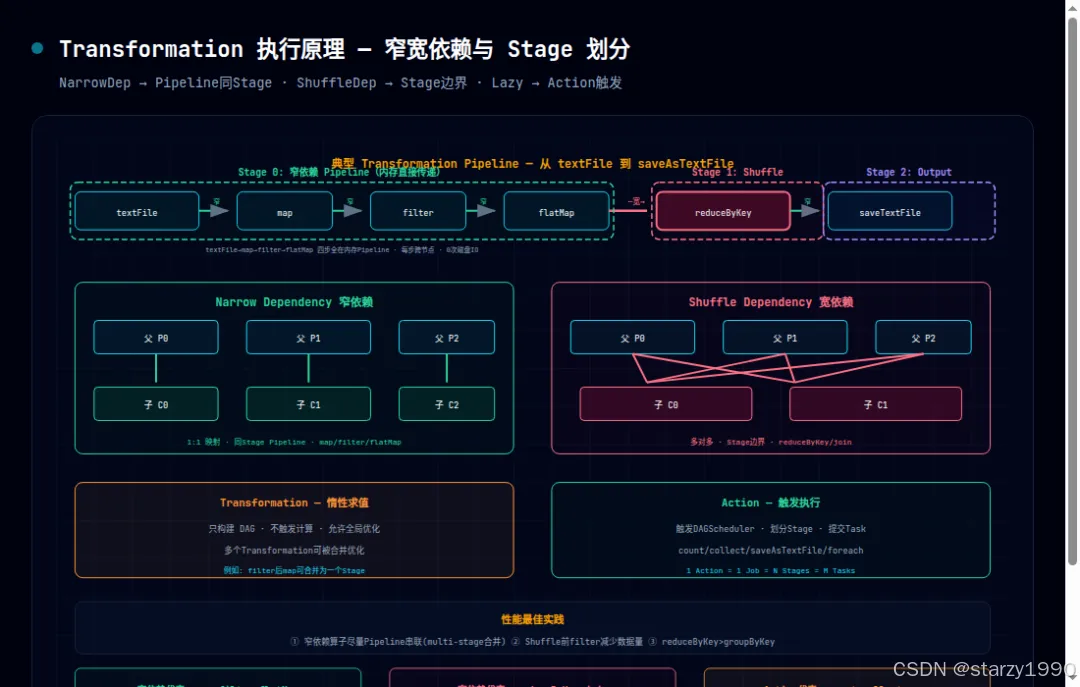
核心法则回顾:
- NarrowDependency(窄依赖):子 RDD 的每个 Partition 只依赖父 RDD 的一个 Partition → 同 Stage Pipeline 执行 → 无 Shuffle
- ShuffleDependency(宽依赖):子 RDD 的每个 Partition 依赖父 RDD 的所有 Partition → Stage 边界 → 磁盘 IO + 网络 IO
示例 Transformation Pipeline:

textFile → map → filter → flatMap
    |        |       |        |
    ├─ Narrow ─┤── Narrow ─┤  ← Stage 0 (Pipeline执行)

reduceByKey → map → saveAsTextFile
     |          |          |
     └─ Wide ──┤─ Narrow ─┤  ← Stage 1 → Stage 2
八、Transformation 算子速查表
| 算子 | 分类 | 依赖 | 核心功能 |
|---|---|---|---|
map |
映射 | 窄 | 1:1元素映射 |
filter |
映射 | 窄 | 条件过滤 |
flatMap |
映射 | 窄 | 1:N映射 |
mapPartitions |
映射 | 窄 | 分区级操作 |
sample |
映射 | 窄 | 随机采样 |
reduceByKey |
聚合 | 宽 | Map端Combine聚合 |
groupByKey |
聚合 | 宽 | ⚠️全量Shuffle分组 |
sortByKey |
聚合 | 宽 | RangePartitioner排序 |
aggregateByKey |
聚合 | 宽 | 分区间灵活聚合 |
combineByKey |
聚合 | 宽 | 最底层聚合算子 |
join |
连接 | 宽 | 内连接 |
leftOuterJoin |
连接 | 宽 | 左外连接 |
cogroup |
连接 | 宽 | 多RDD协同分组 |
repartition |
分区 | 宽 | Shuffle重分区 |
coalesce |
分区 | 窄/宽 | 合并分区 |
partitionBy |
分区 | 宽 | 指定分区器 |
union |
集合 | 窄 | 并集不排重 |
intersection |
集合 | 宽 | 交集 |
subtract |
集合 | 宽 | 差集 |
distinct |
集合 | 宽 | 去重 |
cartesian |
集合 | ⚠️ | 笛卡尔积 |
zip |
集合 | 窄 | 拉链 |
写在最后
掌握 Spark Transformation 算子,不只是背 API,而是要理解每个算子的依赖类型和执行特征:
- 窄依赖算子(map/filter/flatMap/mapPartitions)→ Pipeline 执行 → 高性能 → 放心用
- 宽依赖算子(reduceByKey/groupByKey/join)→ Shuffle → 关注数据倾斜和分区数 →
reduceByKey优先于groupByKey - 分区算子(coalesce/repartition)→ 理解不 Shuffle 合并的局限 → 需要均匀分布时用
repartition - 集合算子(distinct/intersection)→ 隐式触发 Shuffle → 注意
cartesian的资源开销
算子选对了,性能就对了。