上一篇我们完成了企业知识助手的综合实践,将 Context、RAG 、Tool Calling、State、Memory 和权限控制等能力组合到一个完整的 Agent 应用中。
但随着任务复杂度增加,仅具备这些能力还不够。例如,用户要求企业知识助手对比新旧采购制度、分析受影响的业务流程、查询相关合同并生成调整建议,系统可能需要完成多次检索、并行分析、结果校验和内容修订。如果完全依赖自由 Agent Loop,虽然可以动态调用工具、持续执行任务,但执行路径、结果质量、运行成本和完成时间都不容易控制。因此,除了 Agent 的基础能力和运行时框架,还需要一套可复用的任务组织方法,也就是 Agent Design Patterns(Agent 设计模式)。
本篇重点介绍常见 Agent 设计模式的分类、适用场景及工程实现思路,为后续的提示链、路由、并行、反思、规划和多智能体协作等专题建立基础。
一、Agent 设计模式的引入背景
传统软件开发通过设计模式解决反复出现的设计问题,例如工厂模式用于对象创建,策略模式用于算法切换,观察者模式用于事件通知。
Agent 同样存在大量可以复用的执行结构,但与传统程序相比,Agent 的一部分处理逻辑由模型动态决定,执行路径具有一定的不确定性。这种不确定性使 Agent 更适合处理开放式任务,同时也给复杂业务场景带来了新的工程问题。
| 典型问题 | 可能出现的情况 | 对应的处理方式 |
| 复杂任务 | 遗漏步骤、执行顺序不合理 | Planning、Prompt Chaining |
| 多种任务类型 | 所有请求使用同一处理流程 | Routing |
| 多个独立子任务 | 串行执行造成额外延迟 | Parallelization |
| 结果质量不稳定 | 内容错误、遗漏或相互矛盾 | Reflection |
| 外部系统操作 | 工具选择错误、重复调用或越权 | Tool Use、Human-in-the-Loop |
| 长时间任务 | 执行中断、反复重试、无法恢复 | Recovery、Checkpoint |
| 跨领域任务 | 单个 Agent 承担过多职责 | Multi-Agent |
这些问题不能仅靠优化 Prompt 解决。开发者还需要设计任务拆分、路由、并发、反馈、终止条件和异常恢复等机制。
Agent 设计模式的作用,就是针对这些反复出现的问题,提供可复用的任务编排和执行策略。设计模式并不消除模型的不确定性,而是通过更加明确的任务组织方式,使 Agent 的行为更容易理解、控制和评估。
二、设计模式与 Framework、Harness 的关系
前面的文章已经分别介绍了 Agent Framework 和 Agent Harness。设计模式与它们属于不同的抽象层次。
| 概念 | 主要职责 | 典型内容 |
| Agent Design Pattern | 定义任务如何组织和执行 | Routing、Reflection、Planning |
| Agent Framework | 提供模式实现所需的开发组件 | Spring AI、LangChain4j、LangGraph |
| Agent Harness | 提供稳定运行所需的工程机制 | Session、Sandbox、Hooks、Permission、Trace |
例如,一个需求分析 Agent 在生成需求后,需要进行质量检查,低于指定标准时自动修改并重新检查。这种方式属于 Reflection / Evaluator-Optimizer 模式。
实现时可以使用 LangGraph 的节点和条件边,也可以通过 Java 中的循环和条件判断实现;如果需要持久化、异常恢复、执行追踪和权限控制,则还要进一步依赖 Framework 或 Harness 提供的运行时能力。因此,同一种设计模式可以采用不同的技术实现,而同一个 Agent Framework 也可能支持多种设计模式。
设计模式解决任务组织问题,Framework 解决开发实现问题,Harness 解决运行保障问题。它们并不是相互替代的技术,而是可以组合使用的不同工程抽象。
三、常见 Agent 设计模式
结合目前主流 Agent 开发实践,可以按照任务组织方式,将常见设计模式归纳为以下几类。
| 设计模式 | 主要用途 | 典型应用 |
| Prompt Chaining(提示链) | 将任务拆成顺序执行的步骤 | 文档提取、分析、生成 |
| Routing(路由) | 根据请求选择处理路径 | 意图分类、模型与工具选择 |
| Parallelization(并行化) | 同时处理相互独立的子任务 | 多文档分析、多来源查询 |
| Reflection(反思) | 检查结果并进行有限次数修订 | 质量检查、代码审查 |
| Tool Use(工具使用) | 选择、组合并执行外部程序能力 | 业务 API、数据库、文件操作 |
| Planning(规划) | 拆解复杂目标并管理任务依赖 | 研究分析、长任务执行 |
| Human-in-the-Loop(人在回路) | 在关键节点引入人工决策 | 审批、付款、发布 |
| Recovery(异常恢复) | 处理失败、重试、中断和补偿 | 异步任务、长时间执行 |
| Memory & Adaptation(记忆与适应) | 利用历史信息和经验调整行为 | 偏好复用、经验沉淀 |
| Multi-Agent(多智能体协作) | 由多个专业 Agent 分工处理任务 | 研发协作、综合分析 |
这些模式并不是十种独立的 Agent 产品,也不存在固定的复杂度顺序。
例如,Prompt Chaining 和 Parallelization 都可以在完全确定性的 Workflow 中实现,不一定需要自由 Agent Loop;Reflection 可以嵌入某个生成节点,Planning 则可以结合 Tool Use 动态执行任务。
Multi-Agent 也不是必然比单 Agent 更高级。只有当任务确实需要不同的专业能力、执行环境或上下文隔离时,拆分多个 Agent 才可能带来收益。因此,设计模式应根据具体任务需要组合,而不是按模式数量衡量 Agent 的复杂程度。
四、设计模式组合:企业采购制度变更分析
继续使用上一篇的企业知识助手作为案例。假设用户提出:
对比 2025 年和 2026 年的采购制度,分析付款、审批和合同管理方面的变化,查询目前仍在执行的相关合同,并生成调整建议。
这个任务涉及制度检索、业务数据查询、文档对比和报告生成,已经超出简单 RAG 问答的范围。
任务路由与规划
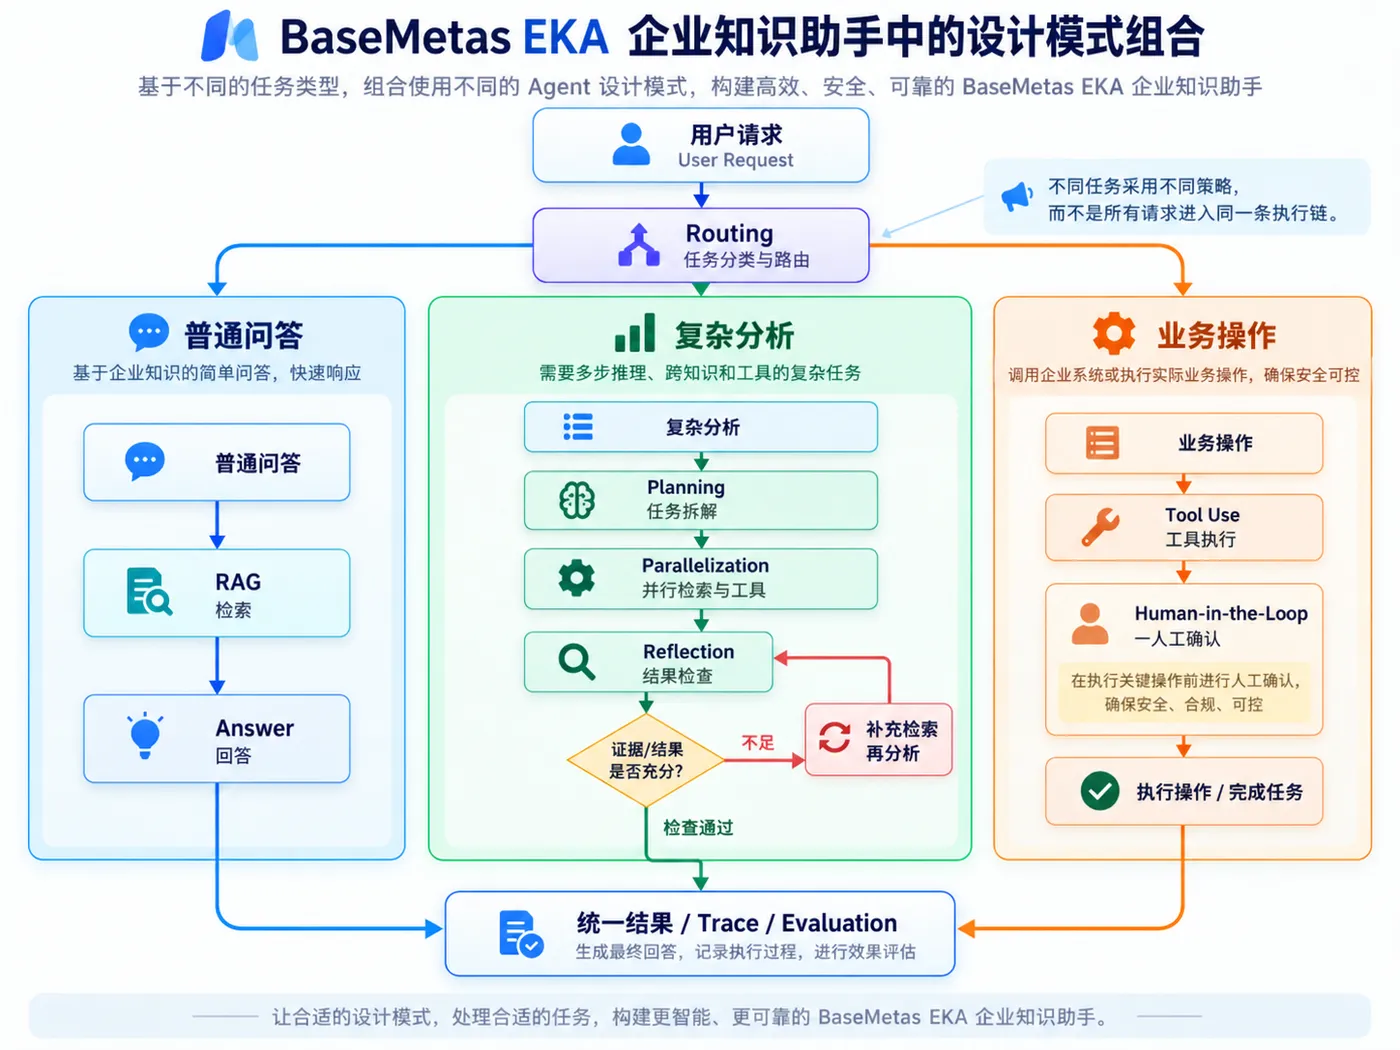
首先通过 Routing 识别请求类型,将其归入复杂业务分析,而不是普通制度问答或单次数据库查询。
随后通过 Planning 拆解任务,明确需要获取哪些资料、哪些步骤可以独立执行、哪些结果需要相互依赖。例如,新旧制度的检索与有效合同查询可以分别执行,而合同风险分析必须等待相关证据准备完成。
并行获取资料
对于没有直接依赖关系的任务,可以采用 Parallelization,同时检索两版采购制度,并通过 Business API 查询有效合同。
这里不一定需要三个独立 Agent。调用三个普通 Tool,或者通过线程池、异步任务执行三个函数,同样可以实现并行。
关键是区分:任务是否独立,与任务是否需要独立 Agent,是两个不同的问题。
结果检查与修订
获得资料以后,Agent 对比制度条款、识别差异,再结合合同内容判断潜在影响。
如果发现某些结论缺少证据,可以通过 Reflection 检查证据完整性,并使用 Tool 再次检索。但这种循环应该受到最大检索次数、Token 预算和终止条件的约束,避免重复搜索。
最终报告应包含相关制度条款、合同来源以及调整建议。对于缺少可靠证据的内容,应明确标记,而不是让模型自行补全。
业务操作与人工确认
如果用户只需要分析报告,系统可以直接交付结果;如果进一步要求修改合同、发送通知或提交审批,就进入 Tool Use 和 Human-in-the-Loop。
这些操作会改变真实业务状态,不能仅因为模型认为“分析已经完成”就自动执行,还需要权限校验、参数验证和必要的人工确认。
 编辑
以上通过BaseMetas EKA企业知识助手架构图展示 Routing、Planning、Parallelization、Reflection、Tool Use 和 Human-in-the-Loop 之间的关系,重点体现普通问答、复杂分析和业务操作三类任务采用不同处理策略,而不是所有请求都进入同一条执行链。
这个案例说明:一个完整的 Agent 应用可以同时使用多种设计模式,但每一种模式都应该解决一个明确的工程问题。
五、设计模式的选择依据
实际开发中,通常不应该先决定采用哪个 Agent Framework,再围绕框架提供的功能设计业务流程,而应该先分析任务特点,确定执行策略,再选择合适的实现工具。
| 任务特征 | 优先考虑的方案 |
| 单次模型调用即可完成 | Direct LLM Call |
| 多个顺序执行、结果可检查的步骤 | Prompt Chaining |
| 输入类型差异明显 | Routing |
| 多个独立任务可以同时执行 | Parallelization |
| 输出需要检查和修改 | Reflection |
| 执行路径无法提前完全确定 | Agent Loop、Planning |
| 存在不可逆或高风险操作 | Human-in-the-Loop |
| 需要等待外部事件或中断恢复 | Checkpoint、Recovery |
| 多个专业领域需要独立处理 | 专业 Tool、Skill,必要时 Multi-Agent |
这里需要特别注意 Workflow 与 Agent 的边界。如果一个任务可以被预先定义为固定步骤,而且每一步都有明确的输入输出,那么普通 Workflow 通常更加简单、稳定。例如,将合同文本转换成结构化 JSON,校验 Schema 后写入数据库,并不一定需要引入 Agent。
但如果执行过程中需要根据已有结果动态调整查询策略、选择工具或重新规划后续步骤,Agent 的自主决策才具有更明显的价值。因此,在任务选型时应该优先考虑:确定性程序 → Workflow → 单 Agent → 多 Agent。这不是技术演进的固定顺序,而是控制复杂度的一种原则。能够采用更简单方式解决的问题,没有必要直接使用复杂编排架构。
六、主流框架中的模式实现
截至 2026 年 10 月,主流 Agent 框架已经把许多常见设计模式逐渐封装为可以组合的开发能力,但不同项目的关注点存在明显差异。
OpenAI Agents SDK:Tool 与 Agent 编排
OpenAI Agents SDK 提供 Agent、Tool、Handoff、Guardrail、Session 和 Tracing 等基础能力。
其中,多 Agent 编排主要存在两种不同方式。
Agents as Tools 适合由一个主 Agent 统一负责目标和最终结果,其他专业 Agent 作为可调用工具完成子任务。
Handoff 则用于将当前任务的后续处理交给另一个 Agent,例如支持系统根据用户请求把问题交给订单、退款等专业 Agent。
两者都属于多 Agent 协作,但控制权和任务责任不同。因此设计多 Agent 时,首先要明确哪个 Agent 负责最终结果,而不是简单增加 Agent 数量。
LangGraph:显式 Workflow 与动态 Agent
LangGraph 采用 State、Node 和 Edge 组织任务,在官方文档中提供了 Prompt Chaining、Routing、Parallelization、Orchestrator-Worker 和 Evaluator-Optimizer 等常见模式。
例如,Routing 可以通过结构化输出决定进入哪个节点;Parallelization 可以并发执行相互独立的任务;Evaluator-Optimizer 可以让检查节点依据结果决定是否重新进入生成节点。
这些机制也可以与 Checkpoint、Interrupt 和持久化结合,用于构建具有明确流程边界的复杂 Agent。
DeepSeek Harness:自由循环与插件化扩展
DeepSeek Harness 采用基于 Cordis 的插件化架构,将 Agent Loop、Tool Registry、Model Adapter、Session Log 等拆成可以独立扩展的组件。
其核心仍然是模型调用、工具执行和 Observation 反馈,但可以通过插件、事件和运行时扩展点加入额外处理机制。它与 LangGraph 的显式状态图属于不同的组织方式:LangGraph 更适合预先定义执行关系,DeepSeek Harness 则更适合在自由 Agent Loop 周围扩展工具、运行控制和执行环境。
这些项目共同说明,设计模式正在从抽象的编排经验转变为框架可直接组合的工程能力。但框架只提供实现机制,是否使用、何时使用以及如何组合,仍然需要开发者根据任务特点决定。
七、执行边界与异常处理
Agent 设计模式不能只描述正常执行路径,还需要定义失败和终止行为。例如,Reflection 不能简单实现为“检查不通过就继续修改”,Planning 也不能只关注任务拆解而忽略执行预算。任何包含动态决策的模式,都应该明确以下几个方面。
| 设计要素 | 工程要求 |
| 触发条件 | 明确什么情况下启用该模式 |
| 输入输出 | 定义节点之间的数据契约 |
| 执行边界 | 限制循环次数、Token 和耗时 |
| 终止条件 | 明确成功、失败及部分完成状态 |
| 异常处理 | 提供重试、降级、补偿或人工介入 |
| 权限控制 | 对有副作用的 Tool 执行前置检查 |
| 可观测性 | 记录关键决策、工具调用和执行结果 |
例如,在文档质量检查场景中,可以将最大自动修订次数限制为三次。如果多次修订以后仍然未达到质量要求,系统应转人工处理,而不是无限调用模型。
对于可能重复执行的业务 Tool,还要考虑幂等性。例如支付或审批提交操作发生超时,并不能直接认为执行失败后重新提交,否则可能产生重复操作。因此,模式解决任务结构问题,执行可靠性仍然需要 Runtime、业务规则和权限体系共同保障。
八、设计模式的评估与优化
引入设计模式并不意味着系统一定会更加高效。例如,将一个分析任务从单 Agent 改造成 Planning + Parallelization + Reflection 后,虽然可能提高复杂任务的完成率,但也可能因为规划、检查和多次模型调用而增加整体耗时与 Token 成本。因此应通过实际任务数据评估模式是否有效,而不是仅凭执行流程是否更加完整来判断。
| 评估维度 | 主要指标 |
| 任务效果 | 完成率、正确率、遗漏率 |
| 工具调用 | 工具选择准确率、参数正确率 |
| 执行效率 | 响应时间、步骤数、并行收益 |
| 运行成本 | Token、模型请求数、工具调用成本 |
| 稳定性 | 失败率、超时率、重试次数 |
| 可观测性 | Trace 完整性、错误定位能力 |
| 人工介入 | 审批次数、人工修正率 |
例如,对于一组固定的企业采购分析任务,可以分别运行“单 Agent”和“Planning + Parallelization + Reflection”两个方案,再比较结果正确率、执行时间、模型调用次数和人工修改量。
如果增加模式以后正确率没有明显改善,反而显著增加延迟和成本,就应该重新评估架构复杂度。这种评估方式也延续了前一篇企业知识助手中的 Trace/Eval 思路:不仅检查最终答案,还要分析整个执行过程是否合理。
九、设计模式的工程化使用原则
在实际项目中,Agent 设计模式应以任务目标和工程收益为依据,而不是以模式数量或系统复杂度为目标。对于简单任务,优先采用确定性程序或少量模型调用;对于需要多个明确步骤的任务,可以先采用 Prompt Chaining;对于需要动态选择处理路径的任务,再引入 Routing 或 Agent Loop。
当任务包含独立子任务时,可以考虑并行化;需要质量反馈时,增加 Reflection;存在明确的执行依赖与长时间运行需求时,再采用 Planning、Checkpoint 或状态机编排。Multi-Agent 更应该谨慎使用。只有当单 Agent 已经难以承担任务,或者确实需要专业能力隔离、独立上下文和任务委派时,才有必要进一步拆分。
这些原则可以概括为:先确定任务结构,再选择设计模式,最后确定 Framework 和 Runtime 实现。不要把框架能够实现的所有模式都组合到一个 Agent 中。系统设计的最终目标仍然是以合理的成本、延迟和复杂度可靠完成任务。
十、本篇小结
从第 10 篇手写最小 Agent 开始,我们已经逐步学习了 Agent Loop、Framework、State Machine、Memory,并完成了企业知识助手的综合实践。这些内容主要解决 Agent 的基础能力和工程实现问题,而 Agent 设计模式进一步关注如何组织复杂任务,以及不同执行方式之间的取舍。
目前常见的 Prompt Chaining、Routing、Parallelization、Reflection、Planning 和 Multi-Agent 等模式,并不依赖某一个特定框架,也不应该作为固定组件全部引入。真正需要掌握的是根据任务特征判断:哪些步骤应该顺序执行,哪些任务适合并行,什么时候需要模型决策,什么时候应该交给确定性代码,以及怎样通过反馈、验证和异常处理控制整个执行过程。因此可以将几类工程能力作如下区分:Model 提供理解、推理和生成能力;Design Pattern 负责组织任务和决策;Framework 提供开发抽象;Harness 保障执行过程的稳定、安全与可观测。
后续文章将围绕这些模式逐篇展开,结合代码和实际业务案例,分析它们的实现方式、适用场景以及工程限制。
上一篇:
https://developer.aliyun.com/article/1767813?spm=a2c6h.13148508.setting.16.c59f4f0efwwEBu
下一篇:提示链模式——将复杂任务拆成多个步骤。
将从最容易落地的 Prompt Chaining 开始,重点介绍任务拆分、中间结果校验、上下文隔离与失败处理,进一步说明如何通过确定性的多步骤编排提高大模型应用的稳定性。