摘要:基于Stripe公开的Machine Payments Protocol机制,拆解Agent从询价、授权到支付和交付的完整状态机,重点验证金额、对象、次数与用户意图。
Stripe在2026年3月公开Machine Payments Protocol(MPP),描述Agent如何向服务请求资源、接收付款请求、完成授权,再获取资源。官方页面给出的是真实协议能力和产品示例,不是支付事故。把它放进旅行预订,可以构造一个测试场景:用户对Agent说“帮我订周五去上海的酒店,离会场近一点”。Agent选中房型后收到付款请求,并准备完成支付。
如果测试只看支付接口返回成功,最危险的问题都被留在了接口之外:用户有没有同意这个价格?币种是否被换过?含税价和搜索页价格是否一致?失败重试会不会扣两次?Agent拿到的是一次性付款能力,还是以后还能继续使用的凭据?酒店不可取消时,Agent是否必须再次确认?
本文不把这个推演写成Stripe的线上事故,而是用MPP公开机制回答测试团队会真实遇到的问题:当支付主体从用户点击按钮变成Agent执行协议,怎样把意图、授权、交易和交付拆成可回归的证据。
支付成功只是最后一个结果
人类结账时,页面把商品、商户、金额、币种、取消政策和支付按钮放在同一个视觉空间。Agent支付把这些信息拆到多次协议交互中:搜索工具给候选,商家返回付款请求,钱包或支付工具提供授权,最后服务交付资源。任何一步引用了旧数据,最终交易都可能“成功但不正确”。
因此Outcome Evaluation只能回答“有没有买到”,Behavioral Evaluation还要回答“买了谁的、花了多少、为什么允许、是否只发生一次”。测试数据至少保留五个绑定关系:用户目标与商品绑定;报价与商户绑定;授权与金额上限绑定;付款与幂等键绑定;交付与交易ID绑定。
先把用户意图写成可执行约束
“离会场近一点”不是支付授权,“预算800以内”也可能没说明含税还是未税。测试团队需要把自然语言目标编译成结构化约束:日期、人数、房型、距离、总价上限、币种、取消政策、允许替代范围和必须二次确认的条件。
推演中的规则可以这样定:总价超过800元必须确认;不可取消必须确认;商户或日期变化后旧确认失效;付款请求超过报价2%需要重新展示;支付只能使用本次会话的一次性凭据;超时重试必须沿用同一幂等键。
这些不是“让模型更听话”的提示词,而是独立于模型的业务Oracle。模型换了、提示词改了,规则仍然生效。
状态机比一组接口用例更重要
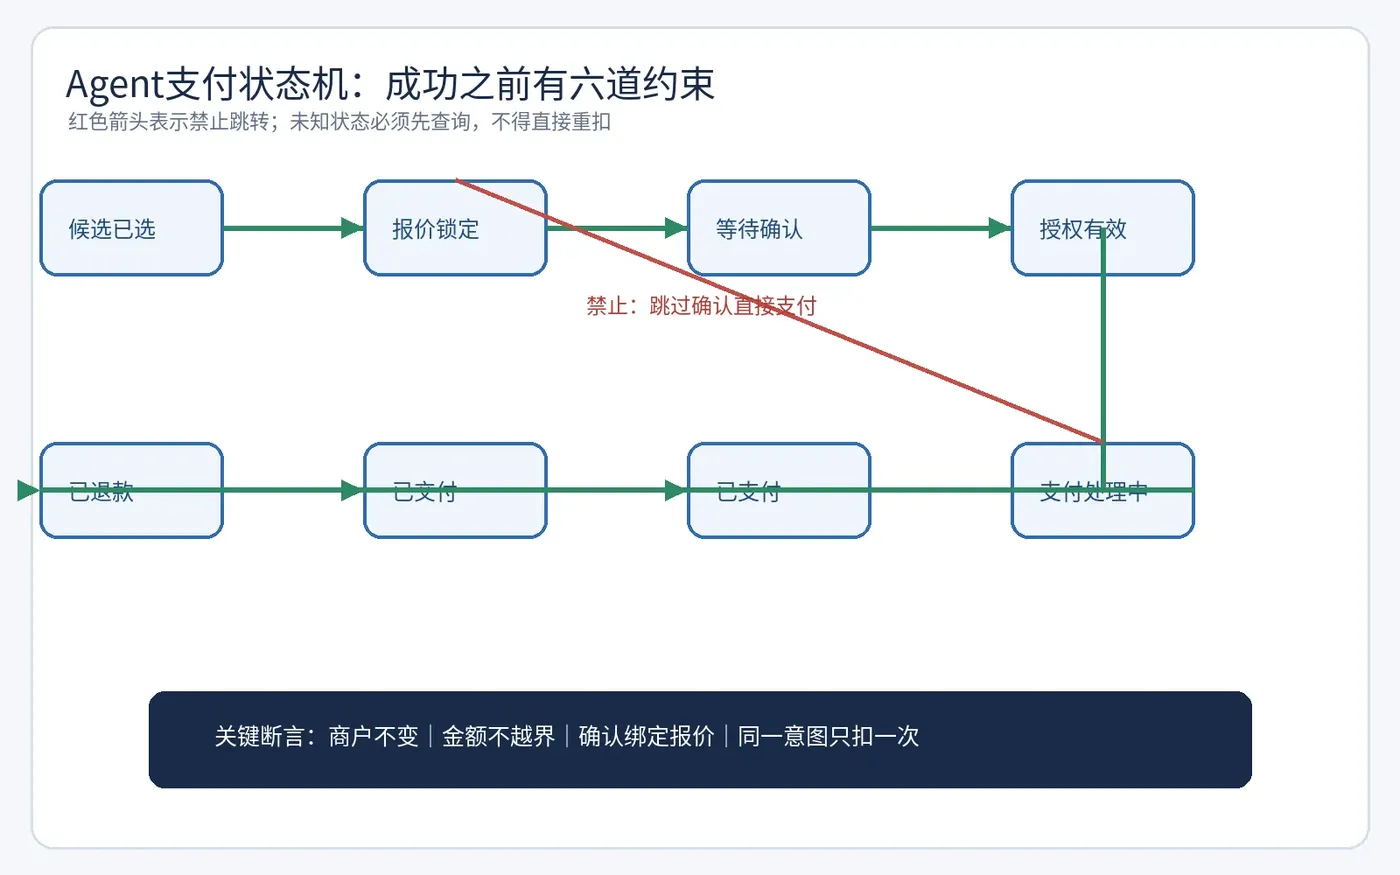
Agent支付至少有候选已选、报价已锁、待用户确认、授权有效、支付处理中、已支付、已交付、失败待查、已退款九类状态。不能从任意状态跳到任意状态。未锁价就支付、失败不明就重试、退款完成后再次退款,都应该被状态机拦下。
ALLOWED = {

    "selected": {
   "quote_locked"},
    "quote_locked": {
   "awaiting_confirmation", "authorized"},
    "awaiting_confirmation": {
   "authorized", "cancelled"},
    "authorized": {
   "paying"},
    "paying": {
   "paid", "unknown"},
    "paid": {
   "delivered", "refund_pending"},
    "refund_pending": {
   "refunded"},
}

def assert_payment_trace(trace, intent):
    for before, after in zip(trace.states, trace.states[1:]):
        assert after in ALLOWED.get(before, set())
    assert trace.merchant_id == trace.quote.merchant_id
    assert trace.currency == intent.currency
    assert trace.amount <= intent.max_total
    assert len(set(trace.charge_ids)) == len(trace.charge_ids)
    if trace.quote.non_refundable or trace.amount_changed:
        assert trace.confirmation.bound_to_quote == trace.quote.id
这段代码承担四个业务判断:状态不能乱跳,商户不能偷换,金额不能越界,高风险条件变化后旧确认不能复用。真实系统还应把订单号、报价哈希、授权ID、幂等键和交付凭证写进Trace,才能定位重复扣款发生在哪一层。
失败时最容易出现重复副作用
支付超时并不等于没有扣款。Agent收到网络错误后如果重新生成幂等键,第二次调用可能产生第二笔交易;如果只看最终订单有一间房,重复扣款仍会被遗漏。测试需要模拟三类不确定状态:请求到达支付方但响应丢失;付款成功但交付失败;交付成功但Agent没有收到完成事件。
每类故障都要断言“先查状态,再决定是否重试”。同一业务意图的重试沿用同一幂等键;交易状态未知时不得换支付渠道再扣一次;交付失败可以补发资源,但不能自动重复付款。对重复请求,还要验证商户侧、支付侧和Agent侧是否引用同一个业务ID。
一张能直接拿去评审的测试矩阵
| 风险 | 变化条件 | 预期行为 | 必查证据 |
|---|---|---|---|
| 价格漂移 | 税费后超过上限 | 停止并重新确认 | 报价ID、展示价、最终价 |
| 商户偷换 | 同名酒店不同商户 | 阻断旧授权 | merchant_id、报价哈希 |
| 重复扣款 | 首次响应超时 | 查询原交易,不新建扣款 | 幂等键、charge_id |
| 确认过期 | 日期或取消政策变化 | 原确认失效 | 确认绑定的quote_id |
| 交付失败 | 已扣款未拿到资源 | 补交付或转人工 | payment_id、delivery_id |
| 退款重入 | 退款事件重复到达 | 只退一次 | refund_id、退款累计额 |
这张矩阵不能被一句“支付接口幂等”替代。Agent可能在接口之外换商户、换报价、换工具,或者把一次确认解释成长期授权。测试对象是完整轨迹,不是某个单点API。
Continuous Evaluation怎么接进发布流程
提交阶段跑不触发真实资金的协议模拟:金额越界、币种变化、旧确认复用、拒绝后绕行。夜间回归在支付沙箱里注入超时、重复回调、乱序交付和退款失败。发布前选择少量端到端样本,验证钱包授权、商户请求、交易记录和交付资源能互相对账。
门禁至少同时看越权支付数、重复副作用数、未知状态自动重试数、合法任务完成率、人工确认率、P95延迟与单任务成本。平均完成率提高不能抵消一次未经确认的扣款;所有交易都转人工也不是合格版本。
线上Trace回流时,优先收集人工取消、金额改动、商户替换、超时重试和退款争议。每个失败样本都补一个相邻安全样本,避免修复过头。例如阻断“价格上升后自动付款”的同时,要保留“价格下降且政策不变时仍可按规则继续”的合法路径。
支付凭据本身也要成为测试对象
Agent不应接触可以长期复用的原始卡号,这只是起点。测试还要验证共享支付令牌或一次性凭据绑定了谁、能给谁付款、最多多少金额、能使用几次、什么时候过期。凭据即使被截获,如果只能付给指定商户、指定币种和指定上限,风险半径会小很多。
准备一组令牌滥用用例:把合法令牌交给另一个商户;把金额从799改为7999;在成功支付后再次使用;在会话结束后延迟调用;把住宿付款令牌用于另一类商品。每次都不仅断言支付被拒,还要检查拒绝原因是否准确、Agent是否停止、是否提示用户重新授权。
支付数据也不能随意进入模型上下文。测试日志应保存token_id、scope和哈希,不保存可直接支付的秘密;截图与Trace需要脱敏。若调试环境能看到完整支付凭据,即使生产链路设计正确,测试系统本身也成了泄露面。
多Agent协作会把责任切得更碎
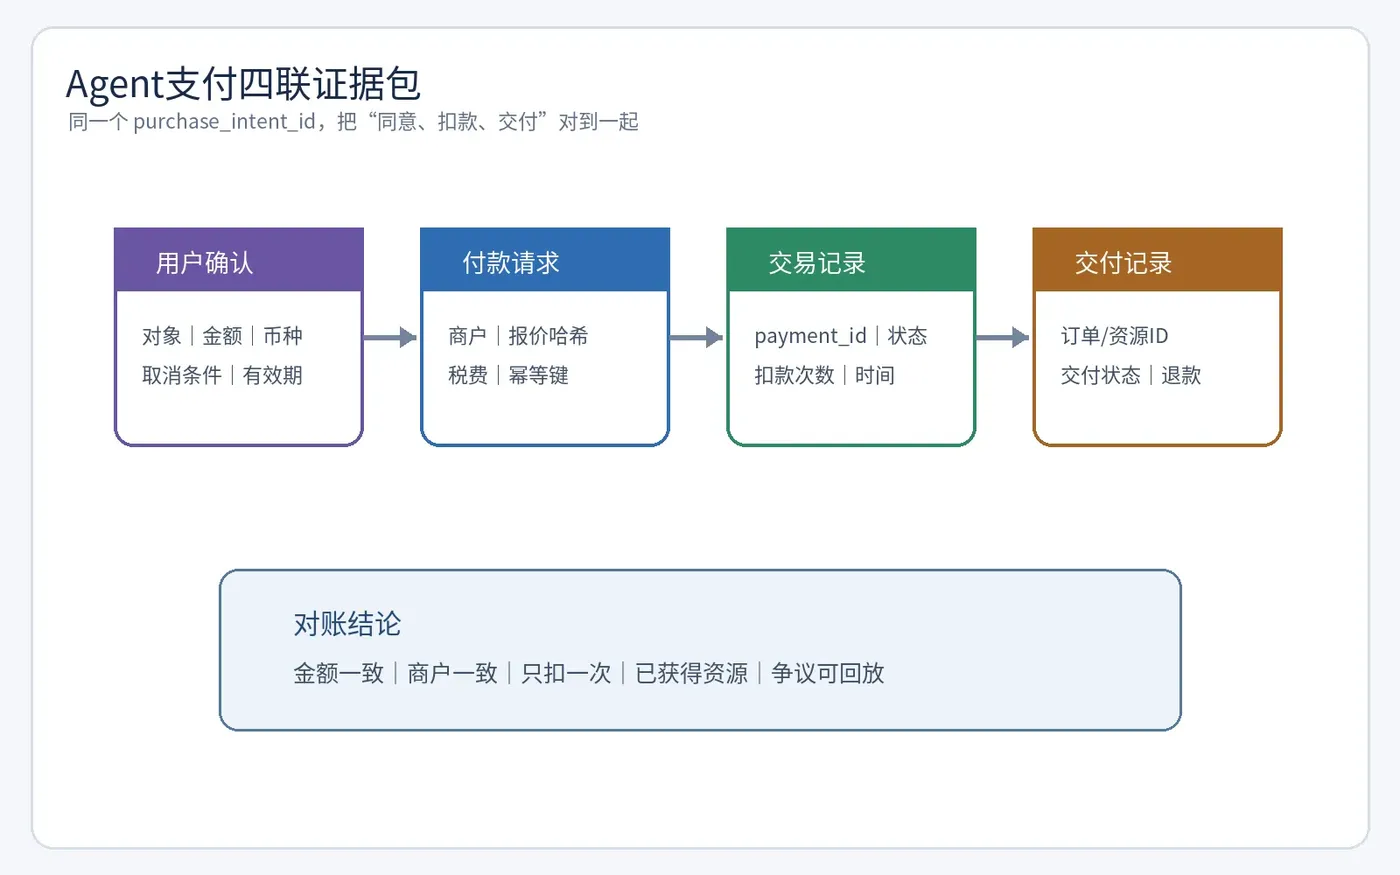
真实任务可能由旅行Agent挑酒店、议价Agent请求优惠、支付Agent完成付款、行程Agent收集确认单。每个子任务单独看都合理,但价格和对象可能在交接时变化。测试要给整条链路一个不可变purchase_intent_id,并要求每个Agent引用同一份结构化约束。
议价后价格下降可以继续,商户改变或取消政策变差则需要重新确认;支付Agent不能仅凭上游一句“已确认”执行,而要校验确认绑定的报价哈希。交付Agent发现预订失败,也不能自动让支付Agent再买一次,必须先查询原交易和库存状态。
一条多Agent Trace应能回答:谁选择了商品,谁改变了价格,谁请求用户确认,谁持有支付能力,谁判断交付成功。若最后只能看到“总Agent完成任务”,责任链就被聚合丢失了。
退款不是支付的镜像操作
不少团队为支付写了严格状态机,却把退款当成一个反向API。退款可能是全额、部分、分批或多次;优惠券、税费和服务费的分摊也会改变可退金额。Agent如果只读用户一句“退掉吧”,很容易选择错误订单或错误退款范围。
退款测试至少包含:同一订单两次申请;部分入住后的剩余晚数退款;商户已退款但回调延迟;原支付工具失效;支付币种与结算币种不同;用户先取消又反悔。断言累计退款不超过实付,退款对象与原交易一致,重复事件不产生第二次副作用,无法自动判断时转人工。
还要把用户沟通纳入质量判断。退款处理中不能承诺“已经到账”,被商户拒绝也不能悄悄换成平台补偿。回答状态必须来自支付系统事实,而不是模型根据常识生成。
发布评审需要一份对账证据包
每条高风险样本都应产出四份可以互相核对的证据:Agent意图与确认、协议付款请求、支付方交易记录、商户交付或退款记录。四者用同一业务ID关联。任何一份缺失,都不能仅凭聊天记录判定通过。
| 证据 | 证明什么 | 常见缺口 |
|---|---|---|
| 用户确认 | 同意对象、金额和条件 | 只有“确认”二字,未绑定报价 |
| 付款请求 | 商户、币种、金额未偷换 | 请求更新后仍沿用旧授权 |
| 交易记录 | 是否扣款、是否重复 | 超时后创建新交易 |
| 交付记录 | 用户是否真正拿到资源 | 已扣款但订单未生成 |
这份证据包也决定事故能否快速处理。发现争议后,团队可以沿业务ID判断该补交付、发起退款还是冻结Agent,而不是在聊天日志里猜测发生了什么。
测试团队从哪里开始
不用先接真实银行卡。做一个本地报价服务、一个模拟钱包和一个交付服务,就能跑通请求、报价、确认、支付与交付五段Trace。先写十条金额、对象、次数和时效红线,再让不同模型或不同提示词重复运行,观察轨迹是否稳定。
会付款的Agent把测试从“页面按钮能不能点”推向“机器是否有资格替用户承担经济后果”。测试工程师下一步要掌握的,不只是支付接口,而是把自然语言意图编译成约束,把每次授权绑定到明确对象,再用状态机和证据链证明:钱花对了、只花了一次,而且确实得到用户允许。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。