StarRocks 支持向量检索、混合检索和多模态检索吗?全模态能力与选型导读
结构化、半结构化和非结构化数据正在进入同一条处理、检索和分析链路。StarRocks 的全模态能力围绕对象处理、全文检索、向量检索和统一分析展开。
作者|周康,阿里云开源 OLAP 引擎团队负责人
一支基础模型训练团队正在准备下一轮训练数据。
候选数据已经积累到百亿级 Embedding。团队面对的并不是一次简单的"相似内容搜索":他们需要先根据任务、语言、来源、质量和版本等条件缩小范围,再结合语义相似度、去重规则和样本分布,形成数百万级候选集,最终关联原始内容、标注结果和模型评测,判断哪些数据真正值得进入训练。
这类查询既有向量召回,也有结构化过滤、文本匹配和大结果集处理;找到样本只是第一步,后续还要继续分析样本质量、覆盖度和训练效果。
类似的问题出现在更多行业。智能驾驶团队希望从海量路测视频、点云和车辆信号中找到长尾场景;机器人团队希望从相机、LiDAR、IMU、触觉、力控和动作轨迹中找到失败样本与相似成功经验;短剧团队需要从剧本、分镜、视频和音频中找到可用素材;游戏团队则要在角色、立绘、动画、台词、音乐和设定文档之间保持资产、版本与世界观的一致性。
这些行业使用的数据不同,业务链路却很接近:
原始对象与业务数据 → 内容理解与特征化 → 结构化、全文和向量检索 → 关联业务结果 → 反哺训练、生产或运营。
过去,这条链路通常由对象存储、数据处理任务、模型服务、搜索引擎、向量数据库和分析数据库共同完成。每个系统解决其中一段问题,应用再负责把数据和结果重新拼接起来。
StarRocks 建设全模态能力的出发点,就是让这条链路中更多步骤回到统一的数据语义和 SQL 分析流程中。
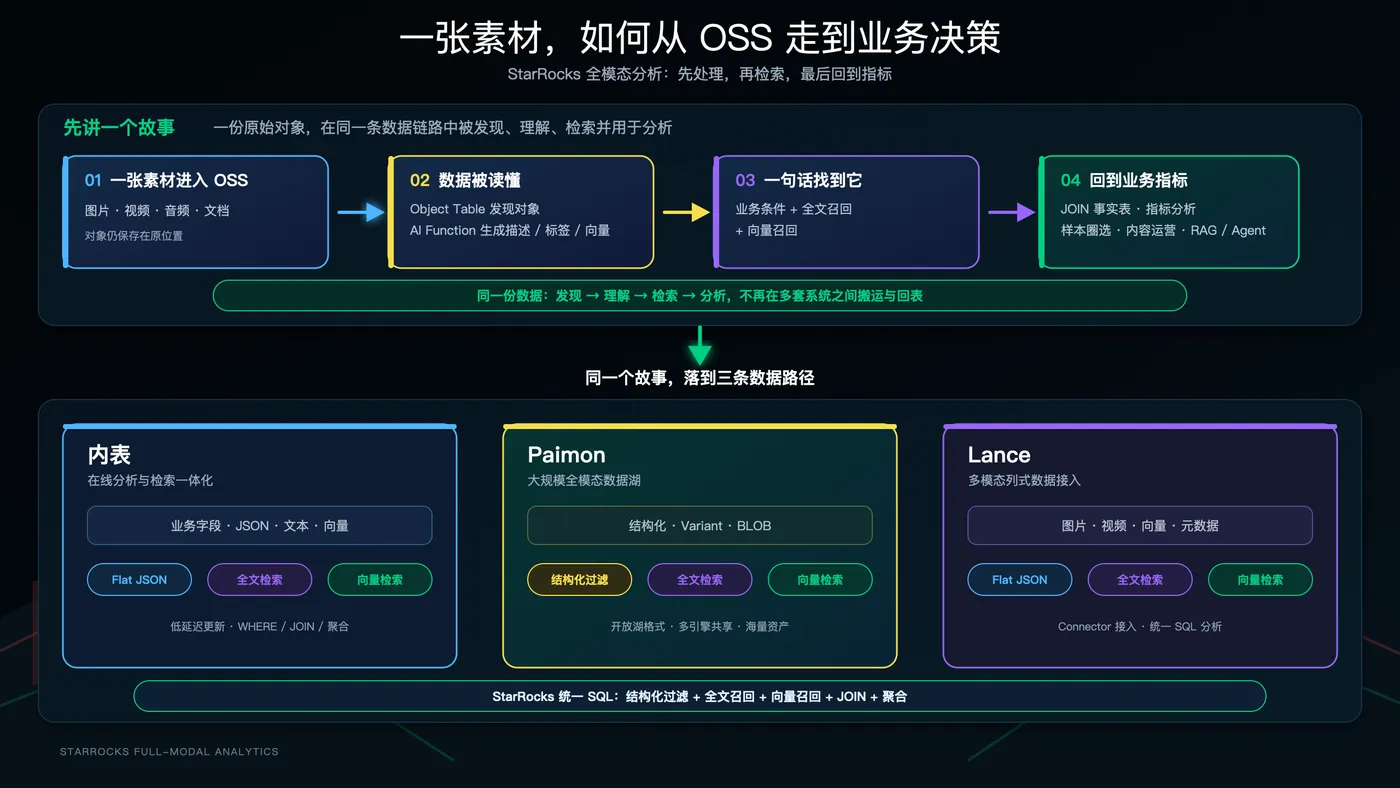
图 1:从百亿级 Embedding 训练数据圈选出发,StarRocks 将多模态处理、内表/Paimon/Lance 检索与行业分析组织成一条连续的数据链路。
01 什么是"全模态"
"多模态"和"全模态"经常被混在一起使用。
多模态通常强调模型能够同时理解文本、图片、视频和音频。全模态数据则更关注企业实际数据环境中,不同形态的数据如何被统一组织和使用。
这些数据大致可以分为三类:
- 结构化数据:时间、设备、用户、车型、版本、状态、指标等具有稳定 Schema 的字段;
- 半结构化数据:JSON、Variant、动态属性、模型返回结果等结构可能变化的数据;
- 非结构化数据:图片、视频、音频、文档,以及对象存储中的其他文件。
只把这些数据放在同一个存储系统中,还不能称为完整的全模态能力。
业务还需要先理解内容,把图片、视频或文档转换为描述、标签、结构化字段和向量;随后通过确定性条件、关键词和语义相似度找到目标;最后把检索结果与训练结果、设备状态、质量数据或运营指标关联起来。
这里所说的全模态是:
让结构化、半结构化和非结构化数据进入同一条处理、检索与分析链路。
全模态描述的是数据使用方式,不是一种新的数据类型,也不要求单一模型处理所有问题。
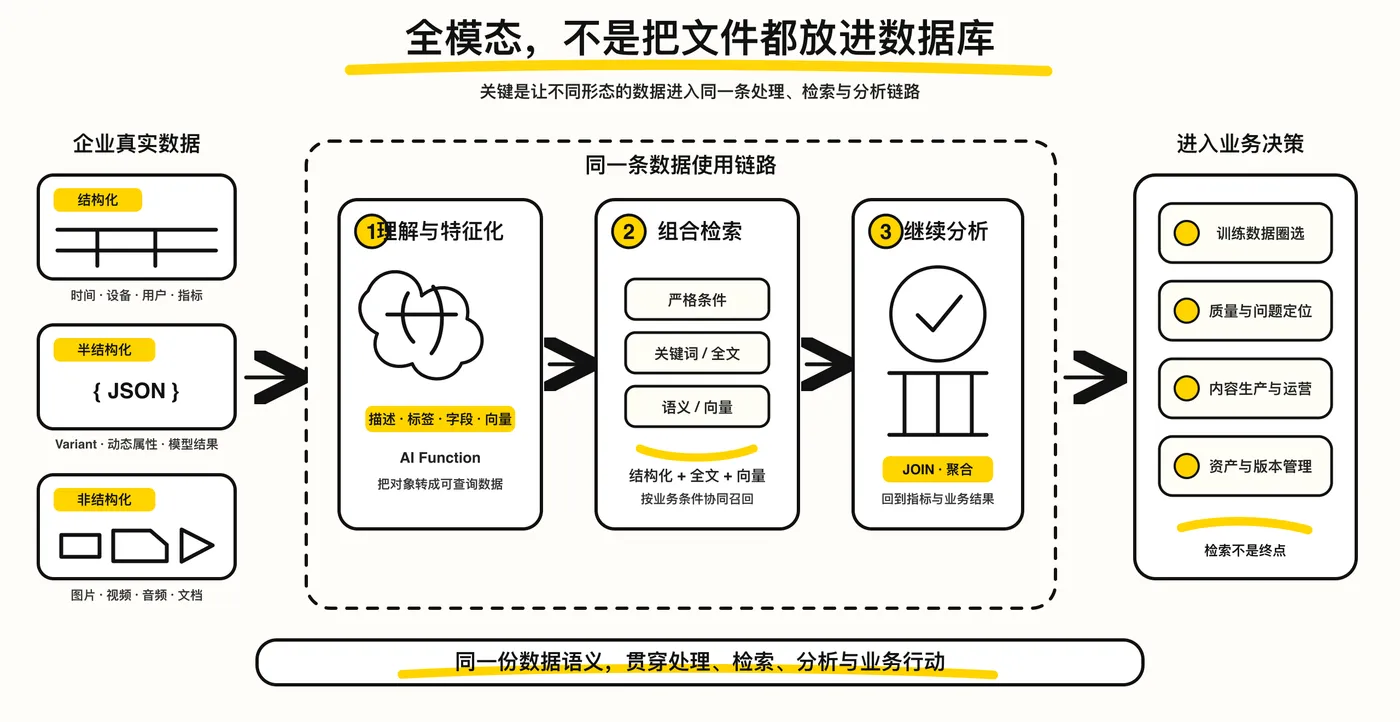
图 2:结构化、半结构化和非结构化数据先被理解和特征化,再通过结构化条件、全文和向量完成检索,命中结果继续参与 Join、聚合和业务决策。
02 AI 时代为什么需要处理全模态数据
过去,进入分析系统的数据通常已经完成清洗和建模。数据库看到的是订单、设备事件、用户行为和业务指标,图片、视频和文档更多只是一个 URL。
AI 让非结构化内容第一次可以被批量理解和特征化。模型能够生成图片描述、提取文档字段、识别视频场景、对内容进行分类,并把不同模态映射为可以比较的向量。大量原本只能依靠人工浏览的数据,开始真正进入生产系统。
这种变化已经出现在多个行业,但每个行业面对的第一问题并不相同:
- 基础模型训练:训练团队需要从百亿级 Embedding 和多模态语料中,结合来源、语言、质量、版本等条件圈选高价值数据,再完成去重、覆盖分析和模型评测;
- 智能驾驶:研发团队需要在路测视频、点云、车辆信号、事件区间、ROI 标签和模型输出之间寻找长尾场景,构建训练集与回归集,并定位不同模型版本的退化问题;
- 具身智能:机器人数据通常由相机、LiDAR、IMU、触觉、力控和动作轨迹组成,并以 HDF5、MCAP、ROSbag 等格式保存。团队需要完成时序对齐、质量检查和特征化,再召回失败片段与相似成功经验,判断新增数据是否补足了稀缺状态;
- 短剧与内容生产:内容团队需要从剧本、分镜、图片、视频、音频和字幕中找到可用素材,同时检查角色一致性、版权、版本和投放效果;
- 游戏与 IP 资产:游戏团队需要在角色、立绘、3D、动画、台词、音乐和设定文档之间查找关联内容,并维护版本、本地化和世界观的一致性。
这些需求已经超出了传统报表查询。用户不再只问"时间等于什么、状态等于什么",还会问"哪些数据值得进入下一轮训练""与这个失败动作相似的轨迹有哪些""找出雨夜加塞的历史片段""哪些镜头符合当前剧情和角色设定"。
这些问题既不能只依靠结构化过滤,也不能只依靠向量相似度。它们通常需要同时满足:
- 权限、时间、设备、版本等严格条件;
- 故障码、角色名、专业术语等明确关键词;
- 视觉、动作或文本语义上的相似性;
- 检索结果与后续业务指标之间的关联。
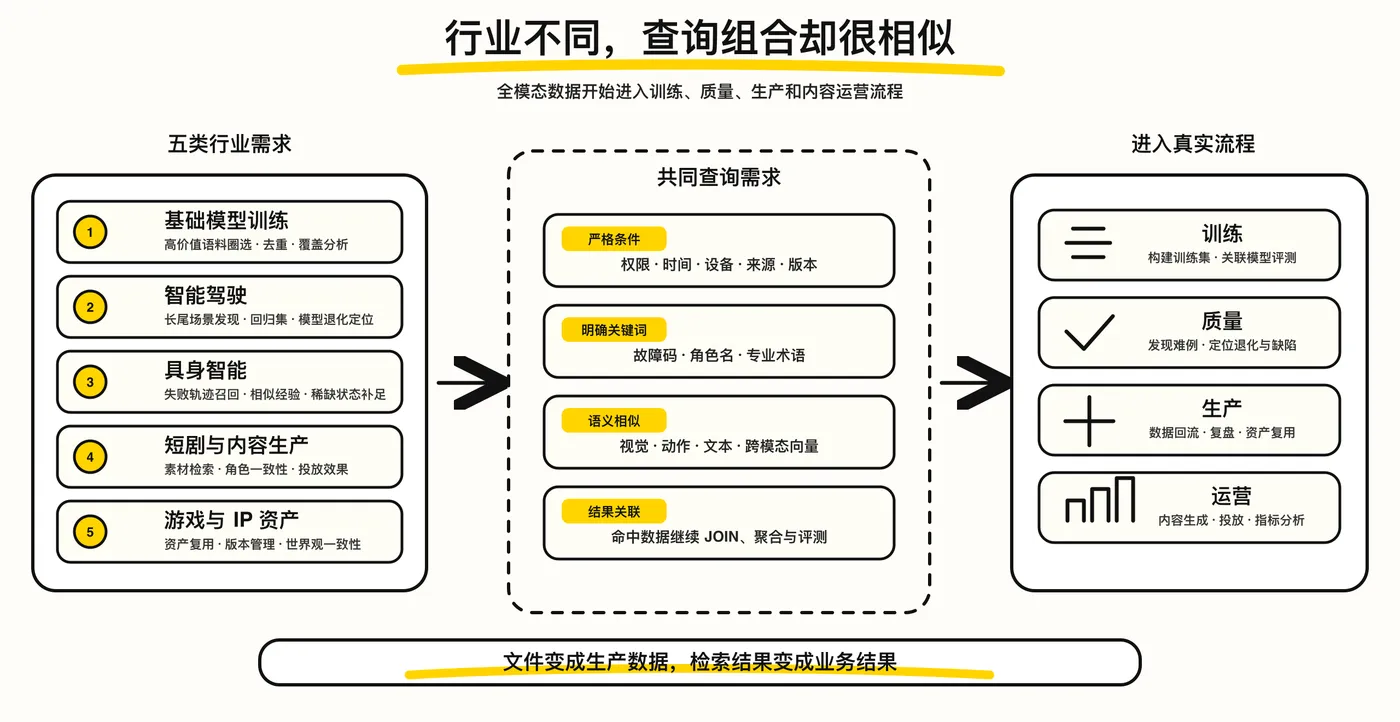
图 3:基础模型训练、智能驾驶、具身智能、短剧和游戏/IP 的数据形态各不相同,但都需要组合严格条件、关键词、语义相似度和业务结果关联。
在 AI 业务中,图片、视频、音频、文档、轨迹和向量已经成为训练、生产和内容运营的核心数据。系统既要找到它们,也要继续分析它们产生的结果。
03 StarRocks 为什么开始建设相关能力
StarRocks 原本承担的核心工作,是对结构化业务数据进行实时分析、Join、聚合和多维查询。
图片、视频、文档和向量进入业务流程后,检索结果必须回到业务数据中。
训练数据圈选后,需要比较不同模型版本的表现;缺陷图片召回后,需要关联设备、位置和处置工单;内容素材被找到后,需要检查版权状态、渠道版本和投放指标;知识片段被召回后,还需要叠加租户和权限条件。训练场景还要求检索结果与数据版本、快照、训练配方和评测结果对应,否则样本虽然找到了,模型效果仍然难以稳定复现。
如果全文和向量检索全部在独立系统中完成,通常需要维护额外的数据副本和同步链路,再把命中的 ID 拉回分析数据库继续计算。数据更新、删除、权限和 Schema 变化也需要在多套系统之间保持一致。
因此,StarRocks 开始把对象处理、半结构化分析、全文检索和向量检索逐步纳入现有的数据分析链路。
StarRocks 保留对象存储、模型平台和专用检索系统各自的职责,同时缩短"找到数据"与"分析数据"的链路:模型产生的描述、标签和向量可以继续作为数据使用,召回结果也可以直接参与过滤、Join、聚合与指标计算。
04 StarRocks 当前主要围绕哪些方向演进
StarRocks 的全模态能力沿四个方向演进。
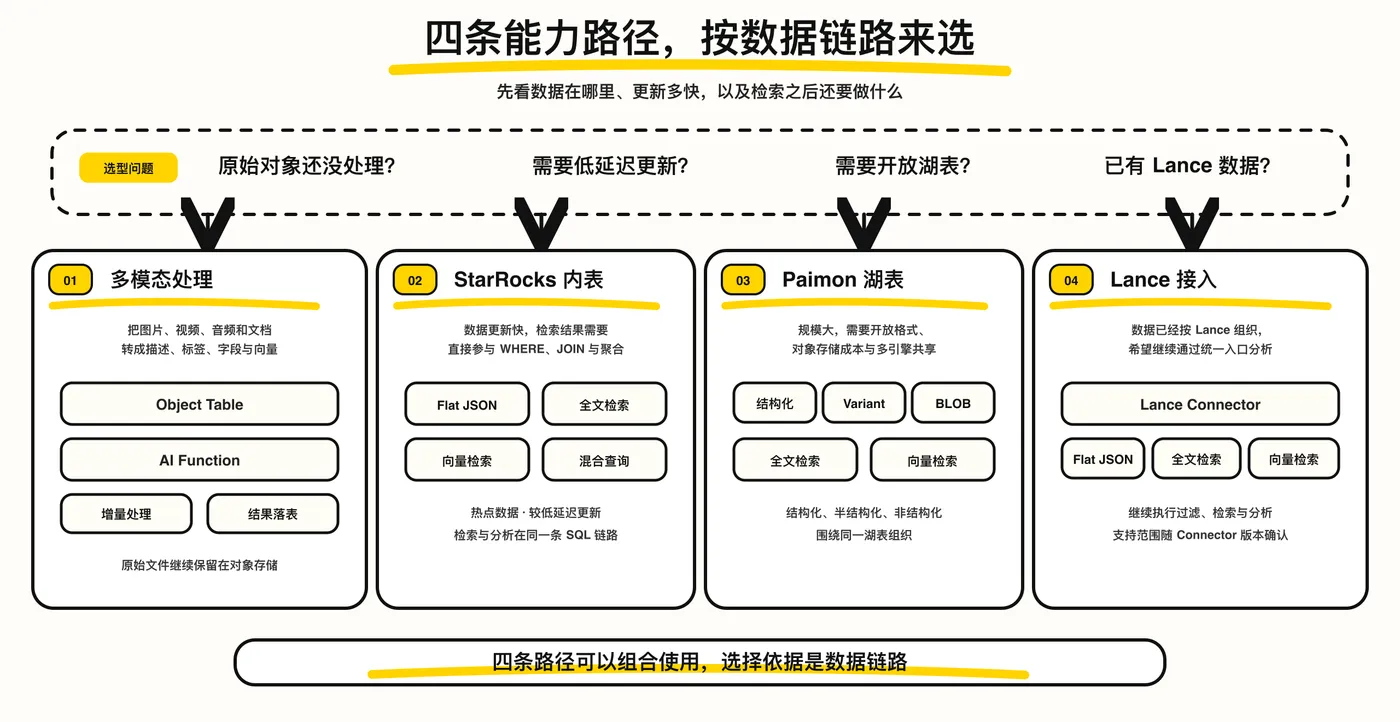
图 4:多模态处理、StarRocks 内表、Paimon 湖表和 Lance 接入分别对应不同的数据位置、更新方式与分析链路,四条路径也可以组合使用。
多模态处理:先让对象变成数据
Object Table 面向对象存储中的图片、视频、音频和文档,管理对象位置、版本和基础元数据;AI Function 则负责内容理解、抽取、分类、生成和向量化。
原始文件继续保存在对象存储中,Object Table 和 AI Function 负责把对象接入数据处理流程。
内表:面向更新更快的在线分析与检索
当数据需要较快写入、较快可查,并且检索结果经常需要与业务字段执行 Join 和聚合时,可以使用 StarRocks 内表承载可检索特征与热点数据。
内表覆盖 Flat JSON、全文检索和向量索引,并可直接与普通 SQL 条件组合。
Paimon:面向长期、大规模的全模态数据湖
当图片、视频、轨迹和文档规模较大,需要保留开放格式、对象存储成本与多引擎共享能力时,Paimon 是重要的数据承载路径。
在这一方向中,结构化字段、Variant 半结构化内容、BLOB 非结构化对象、文本描述和向量可以围绕同一湖表组织,并通过版本与快照固定训练数据边界,为复现和回溯提供数据基础。
Lance:接入已有的多模态与向量数据
一些团队已经使用 Lance 管理多模态和向量数据。StarRocks 的 Lance 方向关注如何通过统一查询入口访问这些数据,并继续执行过滤、检索和分析。
生产使用需要结合 Connector 版本确认支持范围和查询边界。
05 全模态能力可以覆盖哪些行业场景
实际项目中的需求已经覆盖五类行业,但业务查询并不是"输入一个向量,返回若干 Top-K"这么简单。
| 行业方向 | 最常见的业务问题 | 检索后的动作 |
|---|---|---|
| 基础模型训练 | 从百亿级 Embedding 和多模态语料中,组合来源、语言、质量、版本和向量相似度,形成数百万级候选集 | 数据圈选、去重与覆盖分析,生成版本化训练集并关联模型评测 |
| 智能驾驶 | 在路测母带、点云、车辆信号、事件区间、ROI 片段、单帧标签和模型向量之间,按时间、标签、元数据和语义相似度寻找长尾场景 | 跨场景集合运算、排除已标注数据、构建训练集与回归集,并统计标签分布和定位模型退化 |
| 具身智能 | 联合相机、LiDAR、IMU、触觉、力控、动作轨迹、任务版本和执行结果,召回失败片段与相似成功经验 | 数据对齐与质检、训练与评测、失败复盘、稀缺状态补足、技能和示教数据复用 |
| 短剧与内容生产 | 把整片视频理解为带时间码的分镜,切成可播放 clip,并把片段字节、分镜文本和向量围绕同一湖表组织 | 自然语言检索、命中片段直接回放、高光剪辑、投放分析与内容二次生成 |
| 游戏与 IP 资产 | 在角色、立绘、3D、动画、台词、音乐和设定文档之间,组合元数据、关键词和语义相似度查找关联内容 | 资产复用、版本与本地化管理、世界观一致性校验和内容生产 |
同一个行业内部,查询形态还会继续分化:
- 只按标签、元数据或 JSON 条件精确筛选;
- 只做全文检索或向量 Top-K;
- 组合标签、元数据、全文和向量进行混合检索;
- 在多棵场景树或多个候选集合之间执行交集、并集和半连接;
- 用时间点落入时间区间、区间重叠等关系关联帧、片段与事件;
- 通过反连接排除已经标注或已经进入训练集的数据;
- 分别返回明细、完整命中数、标签分布和分桶统计;
- 按数据集版本和训练配方生成可追溯的样本清单。
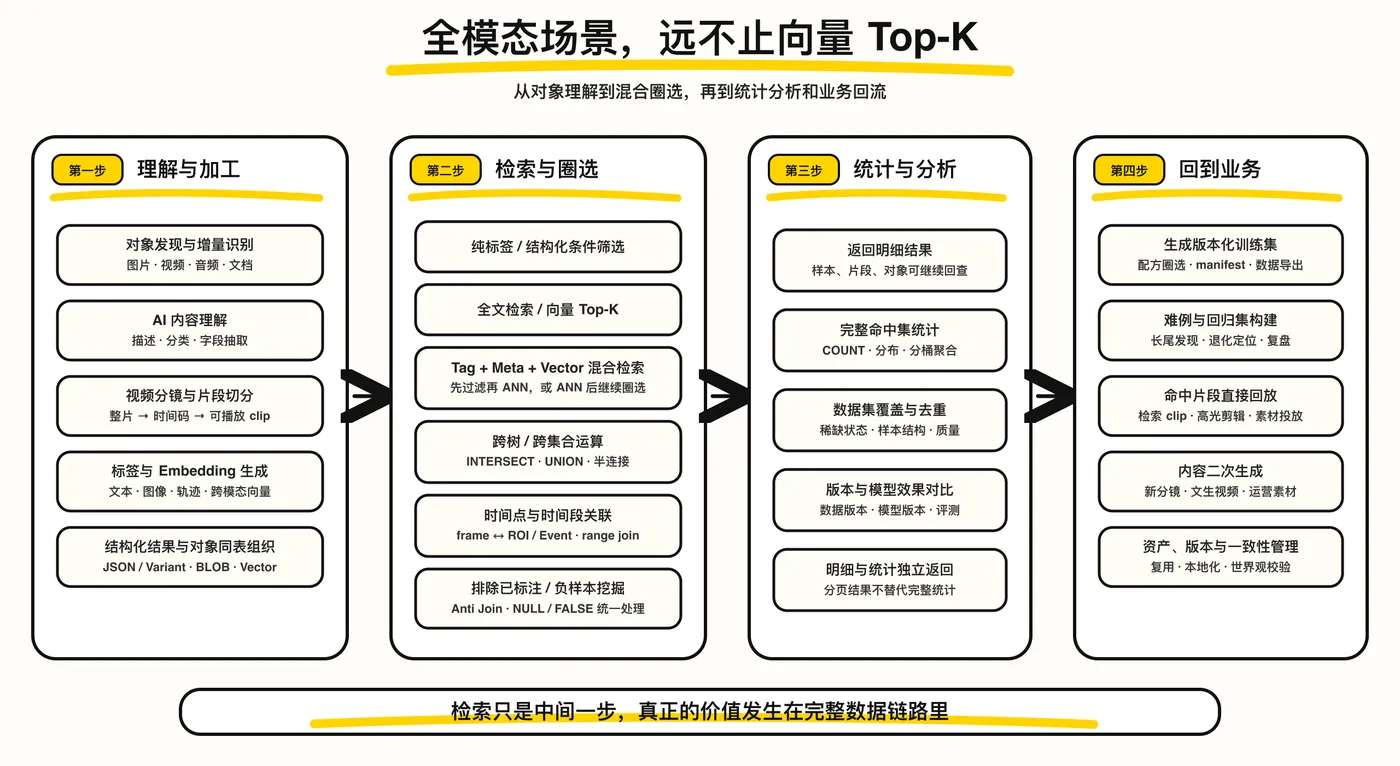
图 5:全模态能力覆盖对象理解、精确筛选、全文和向量检索、混合圈选、时间关联、集合运算、统计分析以及训练和内容生产回流。
场景价值不只取决于"搜到了什么",还取决于检索结果能否进入训练、质量、生产或运营流程,并在下一次训练和评测中被复现。
06 能力地图
围绕上述数据链路,能力主题分为:
- 多模态处理:AI Function 与 Object Table 如何完成对象发现、内容理解、特征化和增量处理;
- 内表全文检索:文本如何建立索引,并与结构化过滤、Join 和聚合一起执行;
- 内表向量检索:向量数据如何组织,语义 Top-K 如何进入分析链路;
- 全模态混合检索:结构化条件、关键词和向量召回如何协同;
- Paimon 全模态检索:结构化、Variant、BLOB、全文和向量如何围绕同一湖表组织;
- Lance 全模态检索:StarRocks 如何读取并分析 Lance 中的多模态与向量数据;
- 行业实践:基础模型训练、智能驾驶、具身智能、短剧内容和游戏/IP 等场景的真实落地方法。
结束语
图片、视频、音频、文档、JSON 和业务指标正在同一条业务链路中被使用。对象需要先被发现和理解,再被检索;命中结果还要继续参与 Join、聚合和指标计算。
StarRocks 正在围绕多模态处理、内表、Paimon 和 Lance 四个方向建设相关能力,让对象可以进入数据处理,让检索结果可以继续分析、版本化和复用。
这套链路的价值由业务结果检验:训练数据覆盖是否提升,问题定位是否更快,内容生产与运营链路是否缩短。
开源 StarRocks、EMR Serverless StarRocks Stella 及不同版本的具体支持范围可能不同,生产使用时请以对应版本文档和发布说明为准。