Java程序员写过
public static void main(String... args)吧?这个String...就是Java的可变参数。
很多人第一次看到Scala的可变参数,第一反应是:"这不是和Java一样吗?不就是个数组吗?"
对,也不对。
说它对——Scala的可变参数本质上确实是一个序列。说它不对——Scala的可变参数比Java灵活太多了。Java的可变参数你只能传离散的值,Scala的可变参数你可以直接传一个集合——用:_*语法。
// Java:你只能传离散的值
public static void print(String... args) {

  for (String s : args) System.out.println(s);
}

print("a", "b", "c");  // 可以

String[] arr = {
   "a", "b", "c"};
print(arr);  // 也可以——但这是隐式的

List<String> list = Arrays.asList("a", "b", "c");
print(list);  // 编译报错!List不是String[]
// Scala:你可以传离散值,也可以传一个集合
def print(args: String*): Unit = {
  args.foreach(println)
}

print("a", "b", "c")       // 离散值,没问题
val arr = Array("a", "b", "c")
print(arr: _*)              // 传一个Array,用:_*展开
val list = List("a", "b", "c")
print(list: _*)             // 传一个List,也用:_*展开
看出区别了吗?Java的可变参数只认数组,Scala的可变参数认任何序列——只要你用:_*告诉编译器"把这个集合展开成可变参数"。
这篇文章不讲"可变参数是什么"这种入门废话,直接说干货:Scala的可变参数底层是什么?:_*到底在做什么?和Java的可变参数比有什么区别?有什么坑?
先从一个痛点说起
你写一个函数,要接收任意个数的参数。Java里你会怎么做?
// Java:用可变参数
public static int sum(int... nums) {

  int total = 0;
  for (int n : nums) total += n;
  return total;
}

sum(1, 2, 3);        // 6
sum(1, 2, 3, 4, 5);  // 15
看起来挺好的。但问题来了——如果你已经有了一个数组或List怎么办?
int[] arr = {
   1, 2, 3};
sum(arr);  // 可以——因为int...本质就是int[]

List<Integer> list = Arrays.asList(1, 2, 3);
sum(list);  // 编译报错!List不是int[]
Java的可变参数有一个隐藏的限制:它本质上就是一个数组。你传List进去,它不认——因为List不是数组。
那你怎么办?把List转成数组:
sum(list.toArray(new Integer[0])); // 强转一圈,麻烦
Scala呢?
def sum(nums: Int*): Int = {
  nums.sum
}

sum(1, 2, 3)              // 6
val arr = Array(1, 2, 3)
sum(arr: _*)              // 6——直接传Array
val list = List(1, 2, 3)
sum(list: _*)             // 6——直接传List
val seq = Seq(1, 2, 3)
sum(seq: _*)              // 6——直接传Seq
不用转数组,不用强转——只要加个:_*就行。
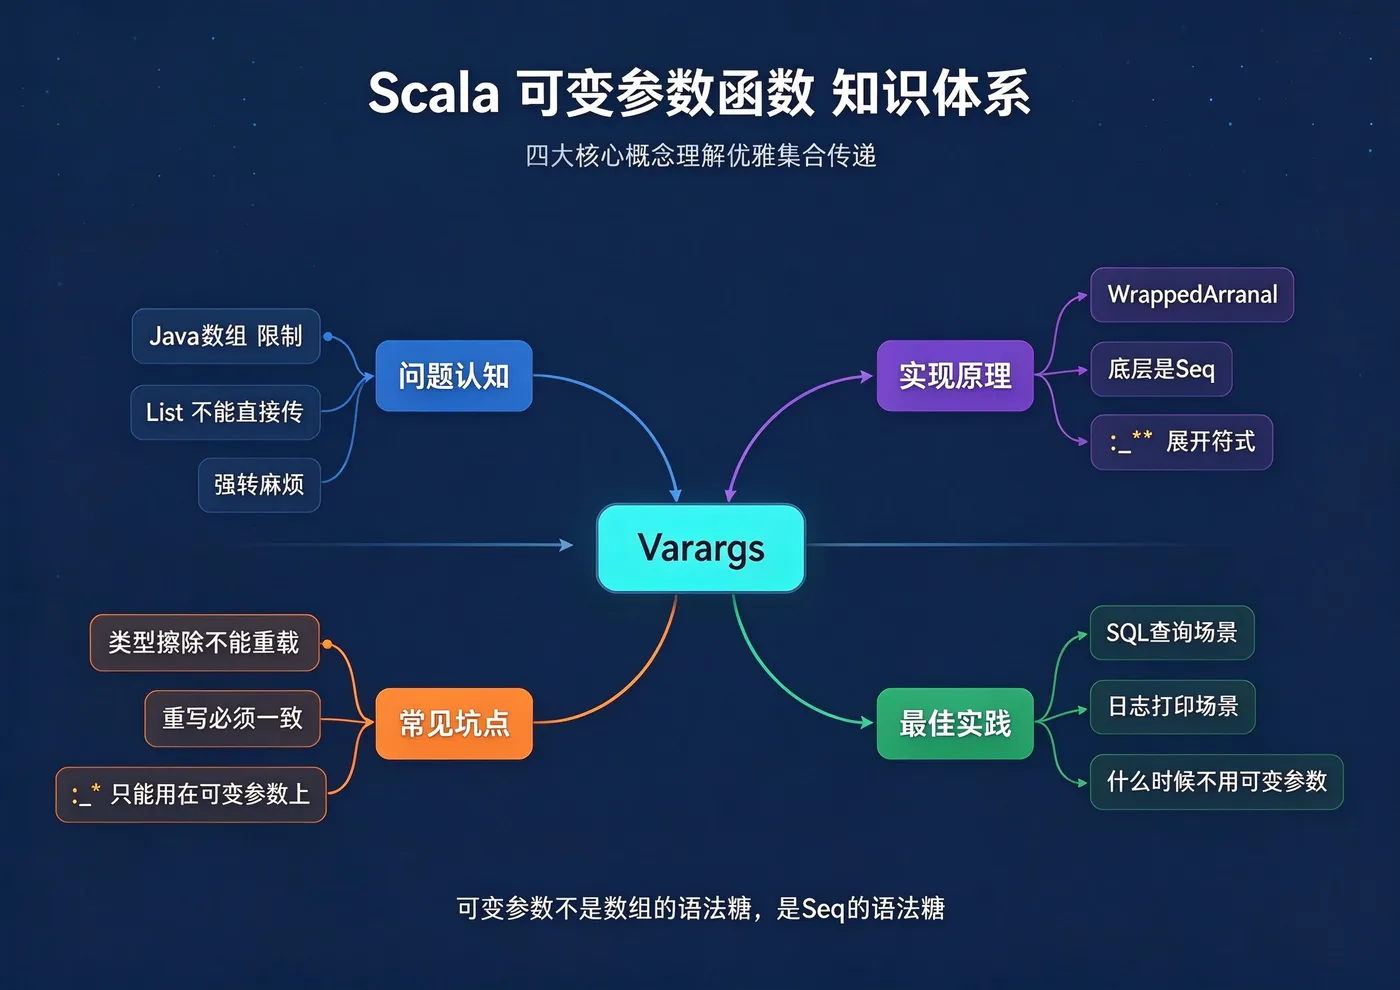
这就是Scala可变参数和Java最大的区别:Java的可变参数是"数组的语法糖",Scala的可变参数是"序列的语法糖"。
可变参数的本质:它是一个WrappedArray
Scala里你写:
def sum(nums: Int*): Int = {
  nums.sum
}
这个nums: Int*在底层是什么?——是一个Seq[Int]。更准确地说,是一个scala.collection.mutable.WrappedArray。
def whatAmI(args: Int*): Unit = {
  println(args.getClass.getSimpleName)
}

whatAmI(1, 2, 3)  // 输出:WrappedArray$ofInt
看到了吗?可变参数不是数组——它是一个包装过的序列。这就是为什么你可以在上面调用.sum、.map、.filter这些Seq的方法——因为它本身就是个Seq。
def process(args: String*): Unit = {
  // 直接调用Seq的方法
  args.foreach(println)
  args.map(_.toUpperCase).foreach(println)
  args.filter(_.startsWith("a")).foreach(println)
}
Java的可变参数你能干这个吗?Java的int...就是int[]——你只能用数组的方法。想调用.stream()?要自己转。想.map()?要自己写for循环。
Scala的可变参数天生就是集合——它自带所有Seq的方法。
:_*到底在做什么?
这是Scala可变参数最神奇的语法。很多人第一次看到:_*的时候,完全不知道这是什么意思。
简单说::_*就是告诉编译器——"把这个集合展开成可变参数"。
def sum(nums: Int*): Int = nums.sum

val list = List(1, 2, 3)

// 不带:_*——编译器报错
sum(list)  // 类型不匹配:期望Int*,实际List[Int]

// 带:_*——编译器把list展开成三个参数
sum(list: _*)  // 6
为什么要这个语法?因为Scala的可变参数接受的是Int*——一个特殊的类型标记。你传一个List[Int]进去,编译器不知道你是想传一个List,还是想把List里的元素展开成三个参数。
:_*就是你明确告诉编译器:"我要展开。"
这个语法设计得非常好——它是显式的,不是隐式的。你想把集合展开成可变参数,你必须明确说出来。编译器不会猜你的意图。
和Java可变参数的对比
很多人会问:Scala的可变参数和Java的有什么区别?
| 对比维度 | Java可变参数 | Scala可变参数 |
|---|---|---|
| 底层类型 | 数组 T[] |
序列 Seq[T](WrappedArray) |
| 传集合 | 不支持,要转数组 | 支持,用:_*展开 |
| 可调用方法 | 只有数组方法 | 所有Seq方法(map/filter/sum等) |
| 调用方式 | f(1,2,3) 或 f(arr) |
f(1,2,3) 或 f(seq: _*) |
| 类型安全 | 编译时擦除,有坑 | 编译时类型检查,安全 |
最关键的区别就是:Java的可变参数是数组的语法糖,Scala的可变参数是Seq的语法糖。
这意味着Scala的可变参数天生就是函数式的——你可以在上面做map、flatMap、filter、fold这些操作,不用转来转去。
Java的可变参数呢?它就是个数组——你想用集合操作?自己转Stream吧。
几个常见的坑
坑1::_*只能用在可变参数函数上
def sum(nums: Int*): Int = nums.sum

val list = List(1, 2, 3)
sum(list: _*)  // 可以——因为sum是可变参数函数

def add(a: Int, b: Int): Int = a + b
add(list: _*)  // 编译报错——add不是可变参数函数
:_*这个语法只能用在可变参数函数上——它的作用就是"把集合展开成可变参数"。普通函数你用这个语法,编译器直接报错。
坑2:可变参数和类型擦除
// 这个会出问题
def print(args: String*): Unit = args.foreach(println)
def print(args: Int*): Unit = args.foreach(println)

// 编译报错——两个方法签名在擦除后一样
Java的可变参数也有这个问题——因为String*和Int*擦除后都是Object[],所以它们不能重载。
Scala也一样。这不是Scala的问题,是JVM类型擦除的问题。
坑3:可变参数方法的重写
class Base {
  def print(args: String*): Unit = println("Base")
}

class Derived extends Base {
  // 重写的时候,参数类型必须一致
  override def print(args: String*): Unit = println("Derived")
}
重写可变参数方法的时候,参数类型必须完全一致——你不能在子类里改成Seq[String],也不能改成List[String]。必须和父类一模一样。
什么时候用可变参数?
不是所有函数都该用可变参数。判断标准很简单:
这个函数的参数个数是不是"不确定的"?
比如:
sum(nums: Int*)—— 求和,参数个数不确定 → 用print(args: String*)—— 打印任意行,参数个数不确定 → 用query(sql: String, params: Any*)—— SQL查询,参数个数随SQL变化 → 用
什么时候不用?
- 参数个数固定的 → 不用
- 参数类型不同的 → 不用(可变参数只能是同一种类型)
- 参数需要命名的 → 不用(可变参数没有参数名)
简单说:当你需要"任意多个同类型参数"的时候,用可变参数。其他时候不用。
实战:SQL查询里的可变参数
这是大数据开发里最常见的场景——写一个SQL查询函数,参数个数随SQL变化:
def query(sql: String, params: Any*): List[Row] = {
  // 用?占位,params填充
  val pstmt = connection.prepareStatement(sql)
  params.zipWithIndex.foreach { case (param, i) =>
    pstmt.setObject(i + 1, param)
  }
  // 执行查询...
}

// 调用
query("SELECT * FROM users WHERE id = ?", 1)
query("SELECT * FROM users WHERE name = ? AND age > ?", "zhangsan", 20)
query("SELECT * FROM orders WHERE status = ? AND amount > ? AND created_at > ?", "PAID", 100, "2024-01-01")
SQL里有几个?,你就传几个参数——可变参数完美匹配这个场景。
Java里你怎么写?用数组?用List?都别扭——因为参数个数是随SQL变化的,你提前不知道要传几个。
Scala的可变参数就是为这种场景设计的。
写在最后
我写这篇文章的时候,特意没罗列可变参数有多少种用法——因为用法很简单,谁都能写。
真正值得花时间理解的是:Scala的可变参数为什么比Java好用?
不是因为它有:_*这个语法——而是因为它的底层是Seq,不是数组。
Java的可变参数是数组的语法糖——你传List进去,它不认,因为List不是数组。你想传?自己转。
Scala的可变参数是Seq的语法糖——你传任何序列进去,只要用:_*展开就行。不用转,不用强转,一行代码搞定。
这就是函数式语言的设计哲学:可变参数不是"数组的便捷写法",它是"序列的便捷写法"。你写的是可变参数,背后是整个集合库——你可以在上面做map、filter、fold,不用转来转去。
Java的可变参数是命令式思维的产物——它就是个数组,你想用集合操作?自己转Stream吧。
Scala的可变参数是函数式思维的产物——它就是个Seq,天生就是集合,天生就是函数式的。
可变参数不只是"传任意个参数"——它是函数式编程里"把集合当参数传"的优雅方式。