阿里云 EMR Serverless Spark 发布 Agent Skill:让自然语言驱动 Spark 任务与资源管理

简介: 阿里云EMR Serverless Spark正式发布Agent Skill,支持通过自然语言完成工作空间创建、Spark作业提交与监控、弹性资源扩缩容及交互式SQL查询等核心运维操作,覆盖从基础设施配置到任务调度的全链路管理;该Skill已实现与RAM授权、DLF元数据、OSS存储及Kyuubi服务的深度集成,并规划接入智能告警、成本优化与故障诊断能力,推动数据运维从被动响应迈向主动协同。

如今的技术圈仿佛按下了倍速键:上周我们还在热议多模态大模型的边界,这周 Agent 架构已成标配,转眼之间,“OpenClaw”又成了极客们手中的新宠。在这种“周更式”的技术浪潮中,一种普遍的焦虑正在蔓延:今天的热搜,会不会成为明天的遗迹?新鲜劲过后,这些工具是否注定沦为过气的玩具?

在 EMR Serverless Spark 的世界里,我们没有时间争论一只“虾”是否过时,因为我们正忙着将它处理、加工,并端上企业级数据处理的盛宴。我们将这只“虾”从极客的玩具箱中取出,直接投入真实、严苛的企业生产线中。在这里,它不再是展示品,而是驱动业务增长的核心食材。

想要解锁EMR Serverless Spark的全新玩法吗?EMR Serverless Spark 的 Skill 将为你揭示答案。

一、告别“控制台PTSD”:从点击到对话的降维打击
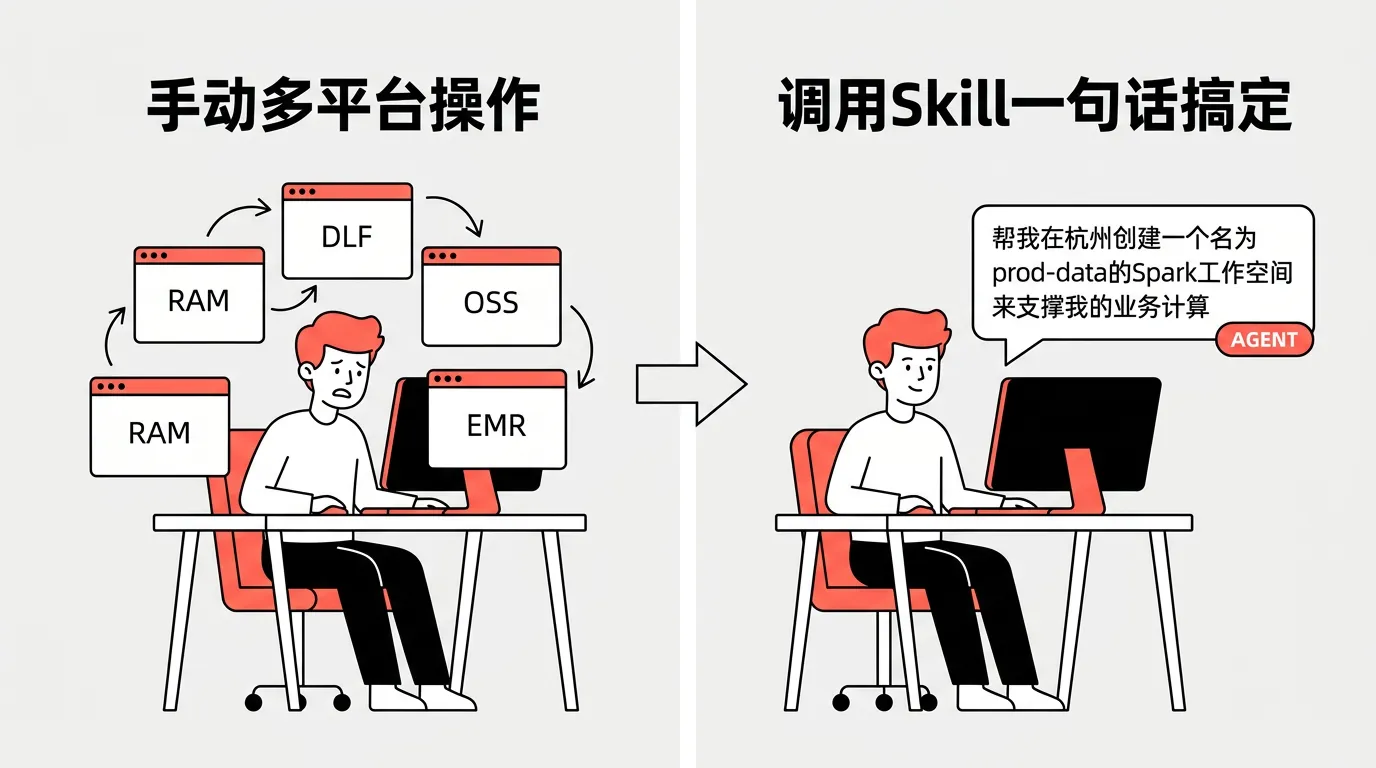
你有没有在阿里云的控制台里迷过路?

在控制台里手动创建一个 Spark 工作空间,流程不短。首先得确保前置依赖到位:RAM 角色授权、DLF 服务开通、OSS 存储桶创建,这些分散在不同的产品控制台里。准备工作做完之后,进入创建页面还要逐项配置计费模式、算力额度、基础路径、元数据目录等参数。如果需要独立的 DLF Catalog,还得跳到 DLF 控制台新建一个再回来选择。整套操作涉及多个页面的来回跳转,对不熟悉的人来说容易卡在某个环节上。

用 EMR Serverless Spark 的 Skill,这些步骤可以收进一句话:

"帮我在杭州创建一个名为 prod-data 的 Spark 工作空间,来支撑我的业务计算"

Agent 在后台自动处理依赖检查和参数配置,通过 API 完成资源编排。原来需要在多个控制台之间跳转才能完成的事情,现在一次对话就搞定了。这不仅仅是效率的提升,更是一种交互体验的降维打击——它把复杂的云原生架构,折叠进了一次简单的对话里。

二、作业调度:把“脚本语言”翻译成“自然语言”

提交 Spark 作业通常是数据工程师的日常。过去,你需要写脚本、配参数、传 OSS 路径,稍微手抖输错一个数字,作业就跑不起来。

现在,场景变成了这样:“提交一个 PySpark 作业,名字叫‘user-agg’,代码在 OSS 的 bucket 里,给我开 4 个 Executor,内存大一点。”
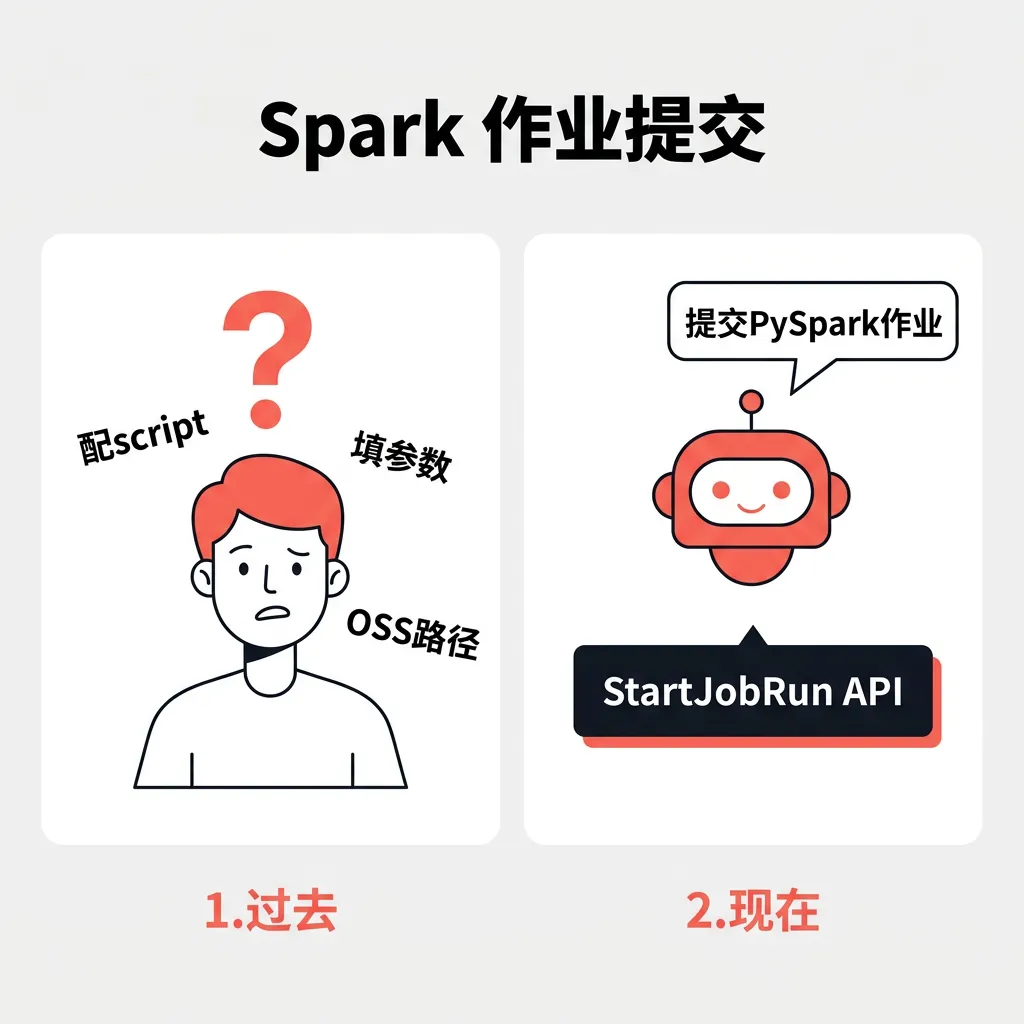
此时的 Agent 就像一个经验丰富的调度员,它会自动解析你的需求,将自然语言转化为标准的 StartJobRun API 调用。更有趣的是它的反馈机制。当作业跑起来后,你不用再切屏去控制台刷日志,直接问它:“那个作业跑得咋样了?”它就能实时抓取状态,甚至把关键的报错日志“喂”到你嘴边。

这种体验,就像是你不再需要亲自去车间拧螺丝,而是坐在办公室里,通过广播指挥着整个流水线的运转。

三、弹性伸缩与交互式查询:懂业务的 AI 才是好运维

云原生的核心优势在于“弹性”,但弹性的开关往往掌握在复杂的配置项里。EMR Serverless Spark 的 Skill 让这种弹性变得触手可及。
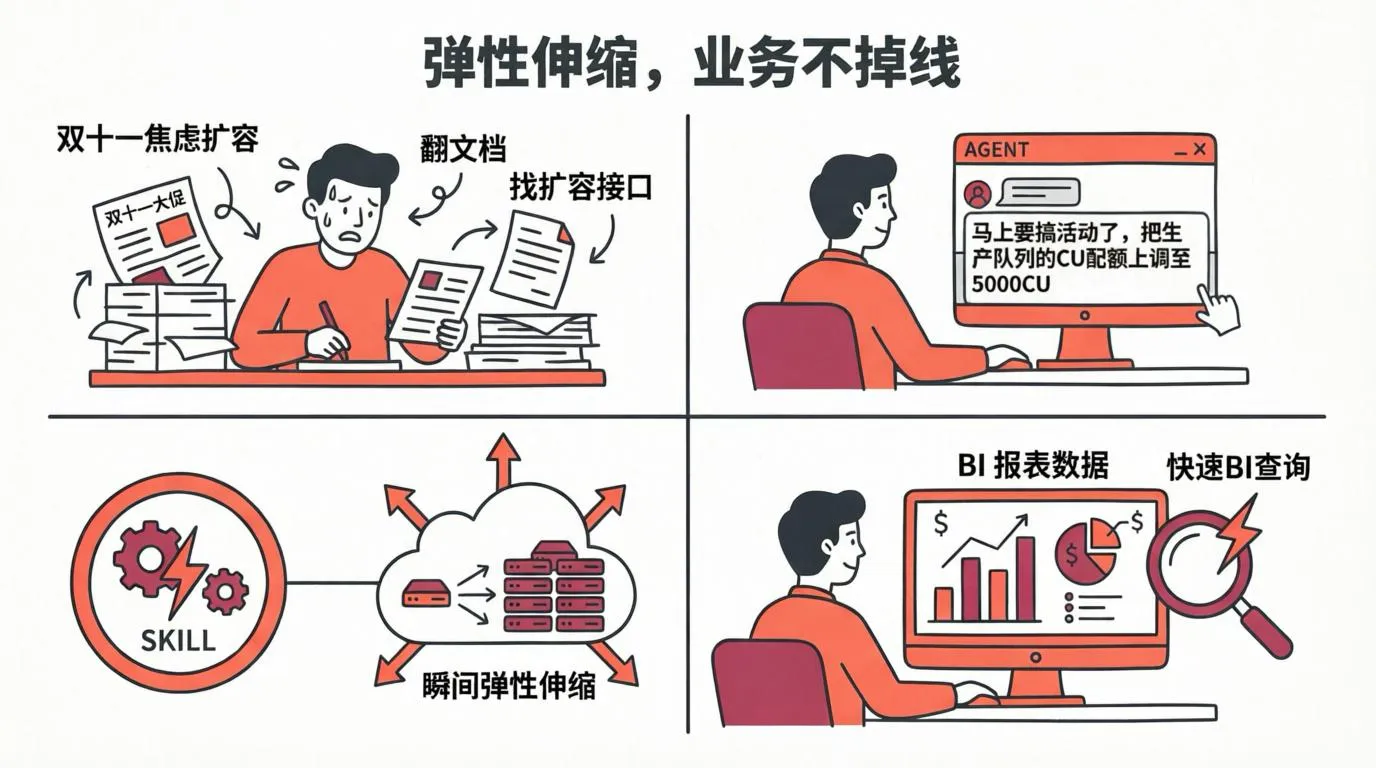
想象一下双十一大促的场景,流量洪峰即将到来。你不需要去翻文档查找扩容接口,只需对 Agent 说:“马上要搞活动了,把生产队列的CU配额上调至5000CU”

Skill 会立即调用 UpdateResourceQueue 接口,瞬间完成资源的扩缩容。此外,对于即席查询场景,Skill 还能通过 CreateKyuubiService 和 Execute SQL 接口,帮你快速拉起一个交互式查询服务,让数据分析师也能通过自然语言直接获取报表数据。

四、未来展望:从“被动响应”到“主动思考”

目前 Skill 覆盖的是工作空间管理、作业调度、资源伸缩、交互式查询这些核心场景,已经能满足大部分日常操作需求。接下来我们计划进一步扩展它的能力边界:

  • 接入监控与告警:让 Agent 能感知作业运行状态,当作业耗时异常或资源队列水位偏高时,主动推送提醒,而不是等你来查。
  • 资源成本优化建议:根据队列的实际使用情况,在低峰时段给出缩容建议,帮你把钱花在刀刃上。
  • 作业问题诊断:作业失败或性能异常时,Agent 自动分析日志和运行指标,定位问题原因并给出修复建议,减少人工排查的时间。

我们希望 Skill 不只是一个听指令干活的工具,而是逐步成为你在数据运维中的搭档——你还没开口问,它已经把关键信息准备好了。

不知道怎么用?把问题抛给 Agent

在 AI Agent 的时代,“安装”本身也可以是对话的一部分。你完全不需要自己动手去敲命令行或翻阅文档,因为你的 Agent 比你更懂怎么“照顾”自己。

你可以在 Agent 中直接导入 Skill 或者直接在对话框里对 Agent 下达指令:“帮我安装 alibabacloud-emr-spark-manage 这个 Skill”。Agent 足够智能,它会自动检测依赖,引导你完成 RAM 角色的授权。

一旦 Skill 导入成功,你只需要问它一句:“你现在支持哪些功能?给我一个上手指南”,Agent 就会把能力清单列给你。这才是真正的“零门槛”——不仅操作是零门槛的,连“学会使用工具”这个过程,也被 AI 承包了。

点击下方链接下载 Skill 开始使用:

https://skills.aliyun.com/skills/alibabacloud-emr-spark-manage
相关文章
|
机器学习/深度学习 算法 PyTorch
深度学习经典算法PPO的通俗理解
#1 前置知识点 基本概念 [https://www.yuque.com/docs/share/04b60c4c-90ec-49c7-8a47-0dae7d3c78c7?#](https://www.yuque.com/docs/share/04b60c4c-90ec-49c7-8a47-0dae7d3c78c7?#) (部分符合的定义在这里) 要理解PPO,就必须先理解Actor
10318 0
|
4月前
|
人工智能 分布式计算 Serverless
阿里云 EMR Serverless Spark 全托管 Ray 再进化:加速构建全模态数据处理新基建
阿里云 EMR Serverless Spark + Ray 双引擎构建全模态数据处理的新基建,通过极致内核优化和统一数据、算力底座,彻底打通了大数据工程与 AI 模型训练的割裂。结合 RayData、Daft、Data-Juicer 等多模态引擎,以及 CPFS、OSS 等高性能存储生态,阿里云正在为全球的 AI 开发者提供一套最具竞争力的数据新基建。
761 0
阿里云 EMR Serverless Spark 全托管 Ray 再进化:加速构建全模态数据处理新基建
|
5月前
|
人工智能 自然语言处理 前端开发
阿里云百炼Qwen3.7-Max模型详解:综合能力、核心优势与订阅计划全指南
Qwen3.7-Max是阿里云通义实验室联合百炼平台打造的新一代旗舰大模型,也是Qwen3.7系列中的顶配版本,定位为**智能体时代全能基座模型**。区别于仅支持单轮对话、简单指令的传统大模型,它从底层架构针对智能体运行逻辑进行深度优化,核心目标是让AI独立完成跨越数百步甚至数千步的复杂长周期任务,真正实现“无人值守式”作业。该模型依托阿里云成熟的算力基础设施与百炼全链路服务体系,不仅具备顶尖的自然语言理解、逻辑推理、多语言处理能力,还原生支持MCP(模型上下文协议),可无缝对接主流智能体框架、第三方工具、云服务组件,打破技术栈壁垒。在行业横向对比中,Qwen3.7-Max在多项权威基准测试中
812 0
|
4月前
|
人工智能 分布式计算 Serverless
EMR Serverless Daft 如何简化多模态数据处理:视频抽帧、清洗、标注全流程与具身智能实践
阿里云 EMR Serverless Spark 引入 Ray 分布式计算框架与 Daft 高性能数据引擎,为用户提供了一套开箱即用、免运维且极致高效的多模态数据处理基础设施。
|
9月前
|
存储 人工智能 资源调度
迈向AI4S 2.0,上海AI实验室开源书生1T Moe 科学大模型Intern-S1-Pro!
2月4日,上海AI实验室开源万亿参数科学多模态大模型Intern-S1-Pro,全球开源社区中规模最大的AI4S模型。基于SAGE“通专融合”架构与MoE设计,融合傅里叶位置编码与创新路由机制,科学推理达奥赛金牌水平,综合能力稳居国际第一梯队,赋能AGI for Science范式革命。(239字)
837 4
|
4月前
|
存储 大数据 Serverless
分链路差异化设计的DSP准实时数仓|钛动科技基于阿里云实时计算 Flink 版 + DLF Paimon + EMR Serverless StarRocks 的实践
钛动科技针对DSP广告业务9.6PB数据规模及多场景SLA差异,将原StarRocks All-in-One架构重构为三条差异化链路:NRR链路利用DLF Paimon存储低频数据,降低60%成本;BT链路依托EMR Serverless StarRocks主键表,实现2分钟新鲜度及P99<5ms在线点查;CT链路负责数据归并。通过解耦实时点查与BI物化视图,该方案在保障故障隔离的同时,兼顾了低成本、高性能与高稳定性,实现了阿里云大数据产品栈的高效协同。
436 0
|
7月前
|
存储 算法 定位技术
一套底座支撑多场景:高德地图基于 Paimon + StarRocks 轨迹服务实践
面对轨迹数据“高实时、高并发、长周期存储”的典型特征,高德团队以访问跨度为依据完成热/温/冷分层,并以 Apache Paimon + StarRocks 构建统一的数据底座,支撑轨迹数据的近实时写入与高性能查询。
|
机器学习/深度学习 移动开发 自然语言处理
大模型Prompt-Tuning技术入门(二)
Prompt-Tuning是一种在大型语言模型中进行下游任务适配的技术,起源于GPT-3的In-context Learning和Demonstration Learning。它通过构建Prompt(提示)和Verbalizer(标签映射)来转换任务,比如将分类任务转化为填空问题。PET模型是Prompt-Tuning的早期实践,通过固定模板(Pattern)和标签词(Verbalizer)来实现。Prompt-Oriented Fine-Tuning是Prompt-Tuning的一种形式,将任务转换为与预训练任务相似的形式,如BERT的MLM任务。
|
SQL Serverless 测试技术
体验 Serverless StarRocks × Paimon (DLF) 查询 TPC-DS 标准库性能
本文介绍如何通过共享TPC-DS样例数据集,创建并绑定DLF Catalog到StarRocks实例,实现高效数据查询与分析。内容涵盖RAM用户授权、外部Catalog连接、性能测试(如TPC-DS Query 3)、数据写入内外表、物化视图构建数仓DWD-ADS层,以及通过Quick BI进行可视化报表展示的完整流程,助力快速搭建湖仓一体架构。
429 0
|
人工智能 前端开发 架构师
Agent 2.0“三剑客”:MCP协议、A2A协议、AG-UI协议

热门文章

最新文章
