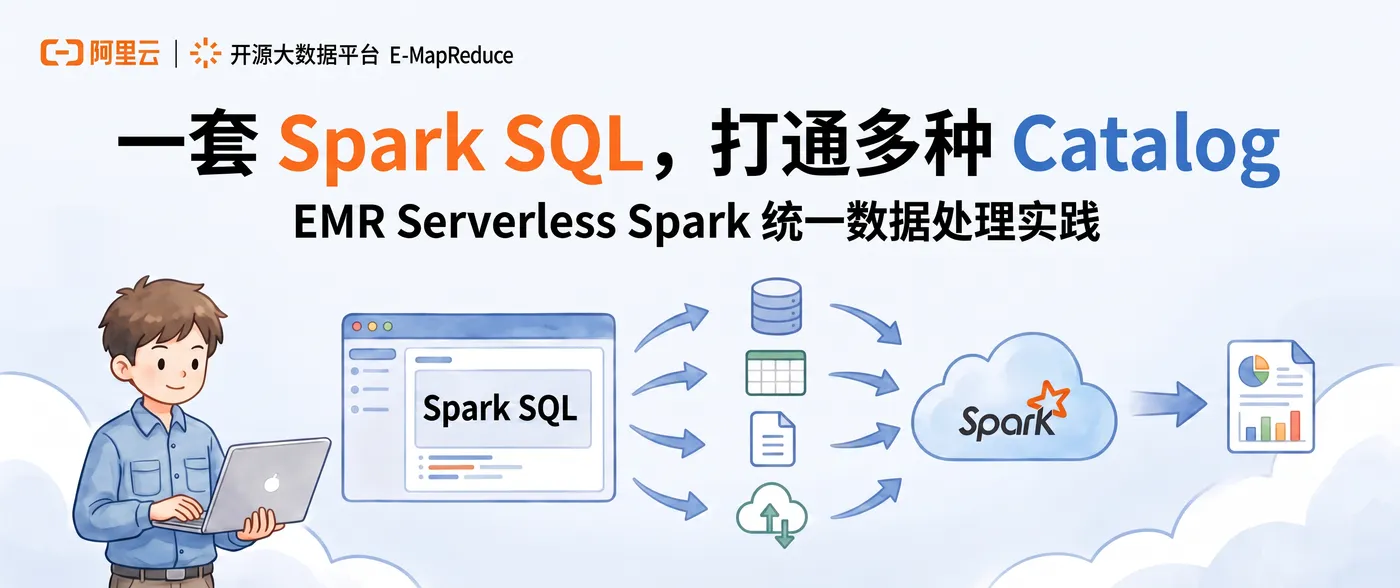
企业的数据往往分散在不同的系统中:数仓、数据湖、在线分析库各自独立,而业务计算又常常需要把它们放在一起。过去,跨系统加工通常意味着多套连接配置、中间表搬运和一串相互依赖的任务。
阿里云 EMR Serverless Spark 的多 Catalog 能力改变了这个前提。通过在工作空间中接入多种 Catalog,一个 Spark Session 就能同时访问 DLF、Hive Metastore、MaxCompute、Hologres、StarRocks、Paimon、Iceberg 等数据空间,跨系统的读取、关联和写入收敛到同一条 Spark SQL 中完成。
本文从一个真实的跨 Catalog 加工场景出发,介绍 Serverless Spark 的 Catalog 支持范围,以及它如何简化数据链路和开发体验。
一个常见的跨 Catalog 加工场景
假设数据团队要生成一张用户经营日报。订单明细和会员等级分别保存在不同的数据空间,每张表都能独立查询,日报却需要把它们放在一起关联和计算。
实际的业务逻辑并不复杂:过滤当天订单,关联会员维度,再把结果写入新的明细表。麻烦通常出现在 SQL 运行之前——准备多套连接、搬运数据、创建中间表,再用多个任务把链路串起来。
EMR Serverless Spark 多 Catalog 将这些数据空间带进同一个 Spark Session。订单表、会员表和结果表可以直接出现在同一条 Spark SQL 中,开发者只需要继续完成日报的关联和写表逻辑。
随着 Catalog 支持面扩充,Spark Session 能够直接访问的数据会越来越多。表名仍然遵循同一种格式:
<catalog>.<database>.<table>
新增 Catalog 扩大了 Spark 的数据范围,已有的业务 SQL 可以继续沿用。
Serverless Spark 的 Catalog 支持全景
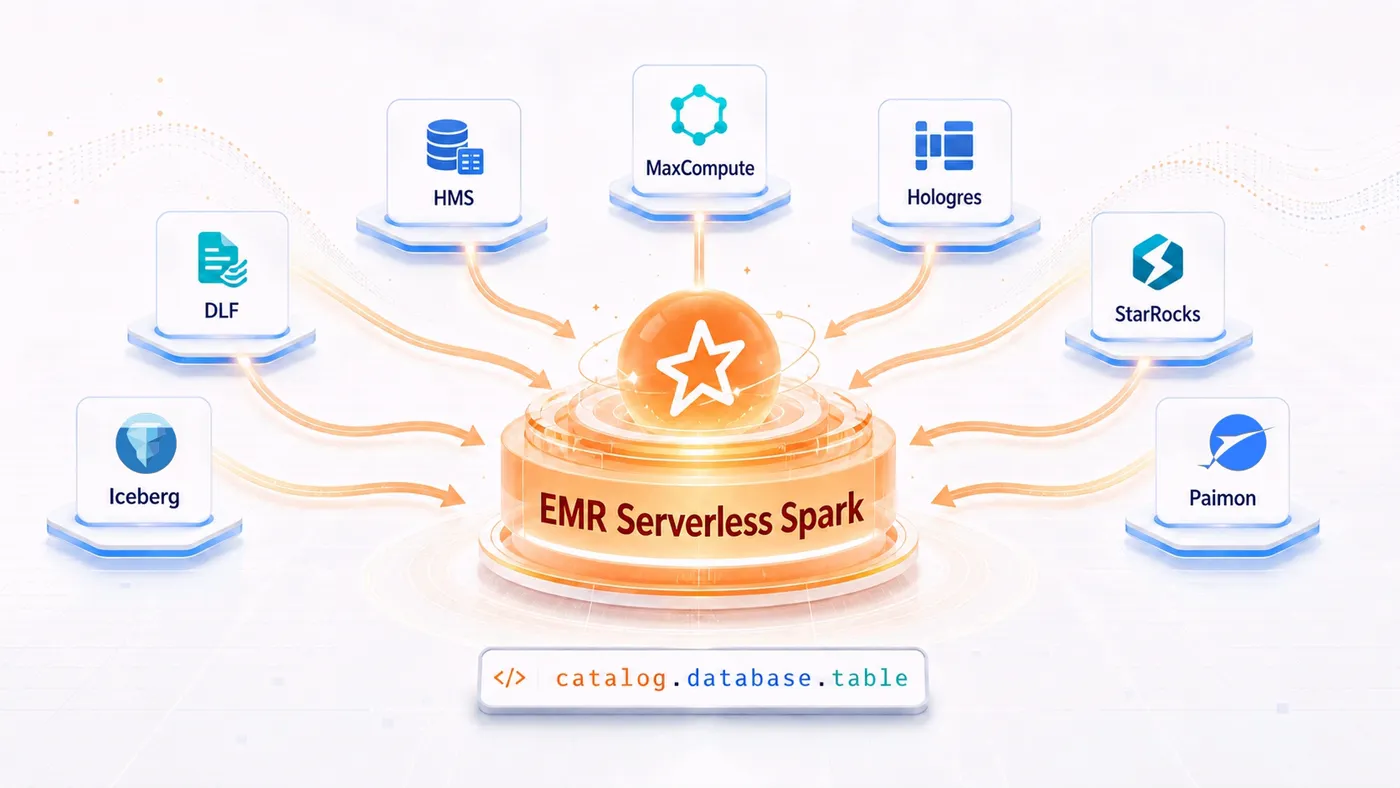
目前,DLF、Hive Metastore、Hologres、StarRocks 等 Catalog 已经可以直接在工作空间“数据目录”中添加。“数据目录”是工作空间统一展示和管理 Catalog 的入口,不影响 Catalog 本身的可用性。这个入口还会继续扩充。
Serverless Spark 同时支持 MaxCompute、Paimon、Iceberg 和自定义 Catalog。完整的支持范围包括:
- DLF Catalog:访问 DLF 中注册的数据库和表,其中包括 Paimon、Iceberg 等表。
- Hive Metastore Catalog:将已有 HMS 中的数据库和表纳入 Spark Session,保留原有元数据体系。
- MaxCompute Catalog:通过内置 MaxCompute DataSource V2 访问 MaxCompute 项目中的表。
- Hologres Catalog:通过三段式表名直接读写指定数据库中的表。
- StarRocks Catalog:在 Spark SQL 中直接读写 StarRocks 库表。
- Paimon Catalog:支持以 DLF、HMS 或 Filesystem 管理元数据,也可以在一个 Session 中访问多个 Paimon Catalog。
- Iceberg Catalog:支持通过数据目录访问 DLF、HMS 中的 Iceberg 表,也支持独立 Iceberg Catalog。
- 自定义 Catalog:基于 Spark CatalogPlugin 机制继续扩展,接入企业自己的元数据与数据系统。
接入一次,表即刻可用
在工作空间“数据目录”中选择 Catalog 类型、填写连接信息,即可完成添加。接入一次后,工作空间内的任务和会话都可以复用。业务代码引用稳定的逻辑表名,连接地址、网络和认证信息由平台集中管理。如果使用的 Catalog 类型还无法在数据目录中添加,也可以通过 spark.sql.catalog 配置自行注入访问。
常用数据源与 Paimon、Iceberg 等湖格式能力已经内置。开发者可以省去找包、打包、上传 JAR 和处理 ClassPath 冲突的过程,打开 Spark SQL 就开始写业务逻辑。
一个 Spark Session 可以同时看到这样的表:
dlf_prod.retail.orders
hms_warehouse.ods.user_events
odps.retail_dw.dwd_order_di
holo_realtime.public.dim_user_level
sr_analytics.ads.product_report
paimon_curated.ads.user_pay_detail
iceberg_archive.history.closed_orders
这些表可以直接出现在同一条查询中。Catalog 名称标明数据来自哪里,后面的 Filter、Join、聚合、窗口和写表仍然使用标准 Spark 语法。
三个 Catalog,一条 SQL
把开头的用户经营日报写成 SQL:支付订单来自 MaxCompute Catalog,会员等级来自 Hologres Catalog,结果写入 Paimon Catalog。目标 Paimon 表已经创建,Spark 直接完成读取、关联和写入:
INSERT INTO paimon_curated.ads.user_pay_detail
SELECT
  '${bizdate}' AS dt,
  o.order_id,
  o.user_id,
  COALESCE(u.member_level, 'NORMAL') AS member_level,
  o.pay_amount
FROM odps.retail_dw.dwd_order_di o
LEFT JOIN holo_realtime.public.dim_user_level u
  ON o.user_id = u.user_id
WHERE o.ds = '${bizdate}'
  AND o.order_status = 'PAID';
odps、holo_realtime、paimon_curated 三个 Catalog 共同组成一条 Spark SQL。中间没有同步表和搬运脚本,整条链路只提交一个 Spark 作业。
会员表迁移到 StarRocks、HMS 或 DLF 后,只需替换全限定表名,原有业务逻辑可以继续使用。目标表也可以切换到 DLF 管理的 Paimon 表或 Iceberg 表,读取、计算和写入仍然由 Spark 完成。
多 Catalog 进入同一份 Spark 执行计划
来自不同 Catalog 的表会进入同一个 Spark 逻辑计划。Spark 可以结合完整 SQL 安排数据扫描、条件下推、分区裁剪、Join 和 Shuffle,随后将结果直接写入目标 Catalog。
开发者无需把一段业务逻辑拆成多套客户端脚本,也不用靠临时表串联多个计算任务。代码、资源和运行状态都收敛在一个 Spark 作业中。
Serverless 平台按需拉起计算资源,Spark UI 展示完整执行过程,Driver 与 Executor 日志集中保留。跨 Catalog 作业与普通 Spark 作业拥有相同的开发、调优和排障方式。
写在最后
多 Catalog 让一个 Spark Session 可以访问更多数据空间。开发者沿用现有 SQL 和 DataFrame 代码,完成跨 Catalog 的读取、计算和写入。
随着“数据目录”持续扩充,更多 Catalog 会直接进入工作空间。用户面对的依然是熟悉的 Spark 作业、Spark UI 和运行日志。