想做 AI 推理、模型训练、或者 GPU 加速的数据处理?阿里云 EMR Serverless Spark 支持 CPU 和 GPU 异构计算,开箱即用,不用自己花费时间搭集群。本文手把手教你怎么在EMR Serverless Spark产品中买到 GPU 资源,买到之后怎么跑起来。
什么是EMR Serverless Spark?
EMR Serverless Spark是一款面向Data+AI的高性能Lakehouse产品。该产品为企业提供了一站式的数据平台服务,包括任务开发、调试、调度及运维等功能,显著简化了数据处理与模型训练的全流程。同时,它100%兼容开源Spark和Ray生态,用户可以一键部署运行Spark任务和Ray集群,能够无缝集成到客户现有的数据平台。通过使用EMR Serverless Spark,企业可以更加专注于数据处理分析及模型训练的优化,从而提升工作效率。
什么场景需要 GPU?
- 大模型推理 / 微调:LLM 的 LoRA 微调、vLLM 推理服务等
- 机器学习训练:XGBoost、LightGBM 等框架的 GPU 加速模式
- 深度学习:PyTorch、TensorFlow 的分布式训练
- GPU 加速 ETL:cuDF 等 RAPIDS 库做大规模数据预处理
- Ray 分布式任务:使用Ray进行分布式推理或训练
如果有上述需求,那 EMR Serverless Spark 的 GPU 实例非常适合你。
如何购买 GPU 资源
当前EMR Serverless Spark支持按量付费和包年包月两种形态,按量付费的GPU仅在使用时进行计费,包年包月GPU则是一次性付清费用,可以根据自己的需要进行选择,当前GPU按量付费支持地域为北京、上海、杭州、深圳和乌兰察布,包年包月GPU支持地域为北京、上海和杭州。
按量付费GPU购买
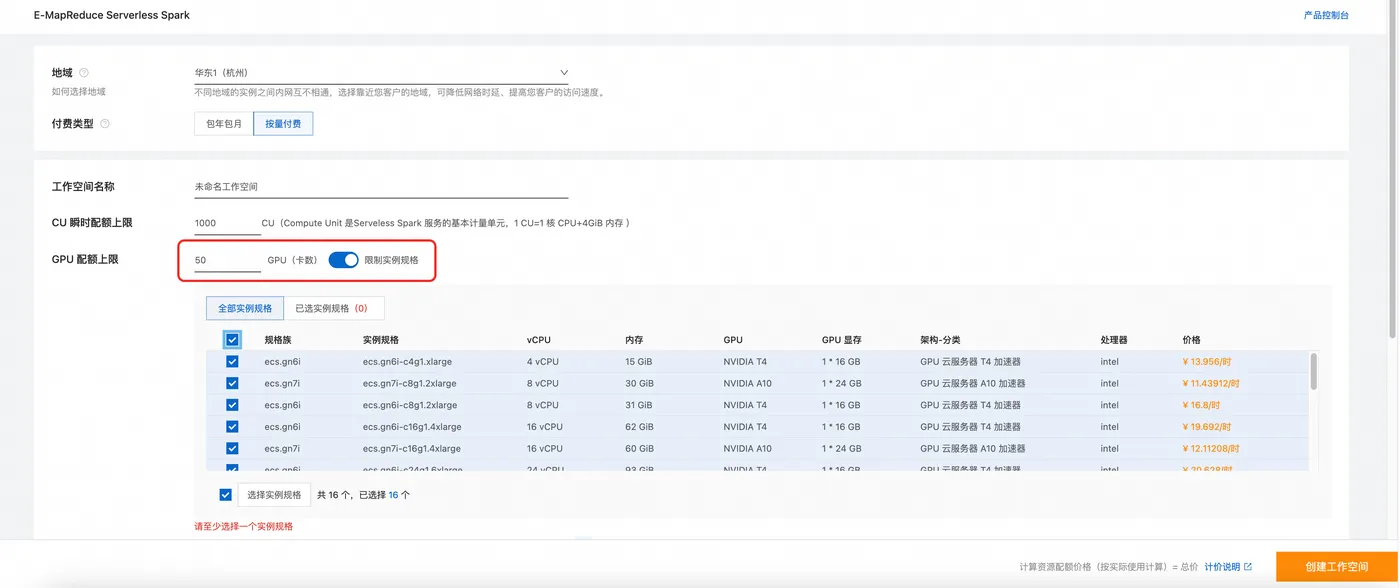
按量付费GPU有两种下单方式,一种是在创建工作空间时设置GPU卡数配额上限,并选择需要的GPU机型,如下图所示,
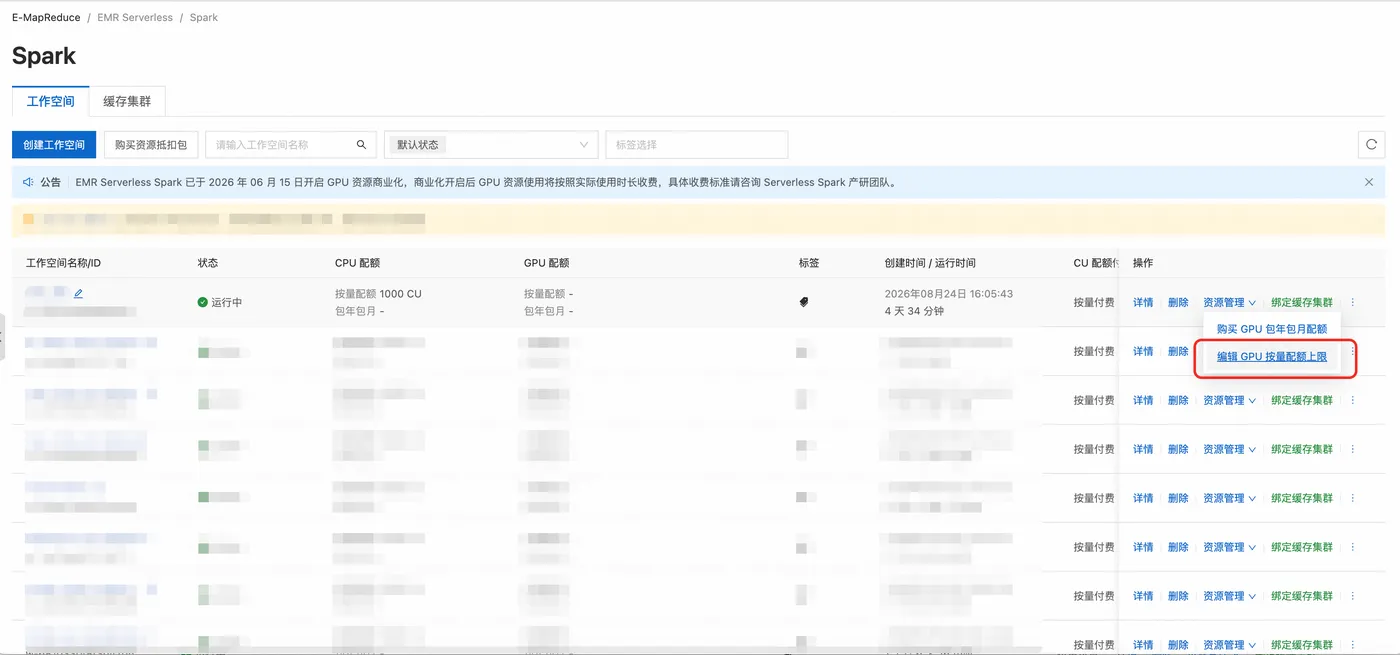
另一种是针对已经创建好的工作空间,可以在工作空间列表页点击资源管理 - 编辑GPU按量配置上限。
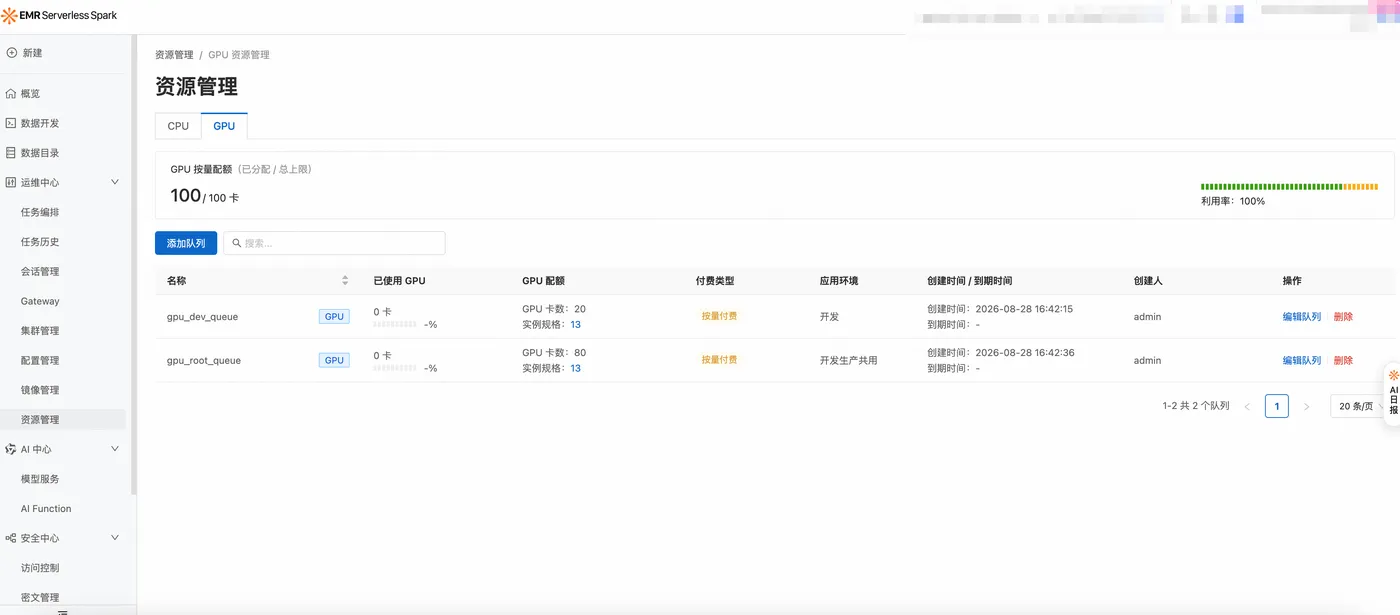
编辑完毕后可以在工作空间的队列页面看到刚创建出来的GPU队列,后续创建作业时选择这两个队列即可。
包年包月GPU购买
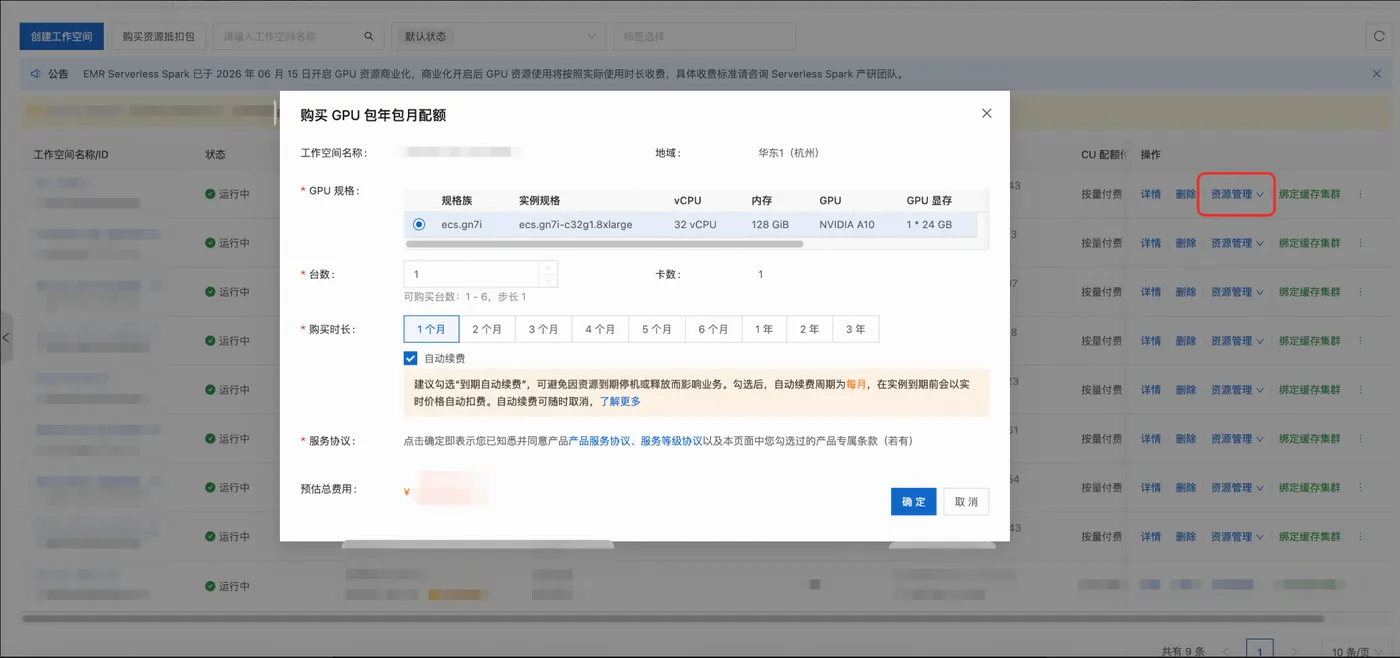
当前包年包月GPU为白名单功能,需要提交工单进行咨询,加入白名单后在工作空间列表页点击资源管理 - 购买GPU包年包月配额可以看到能够购买的包年包月GPU机型,选择需要的机型、数量和购买时间进行下单。
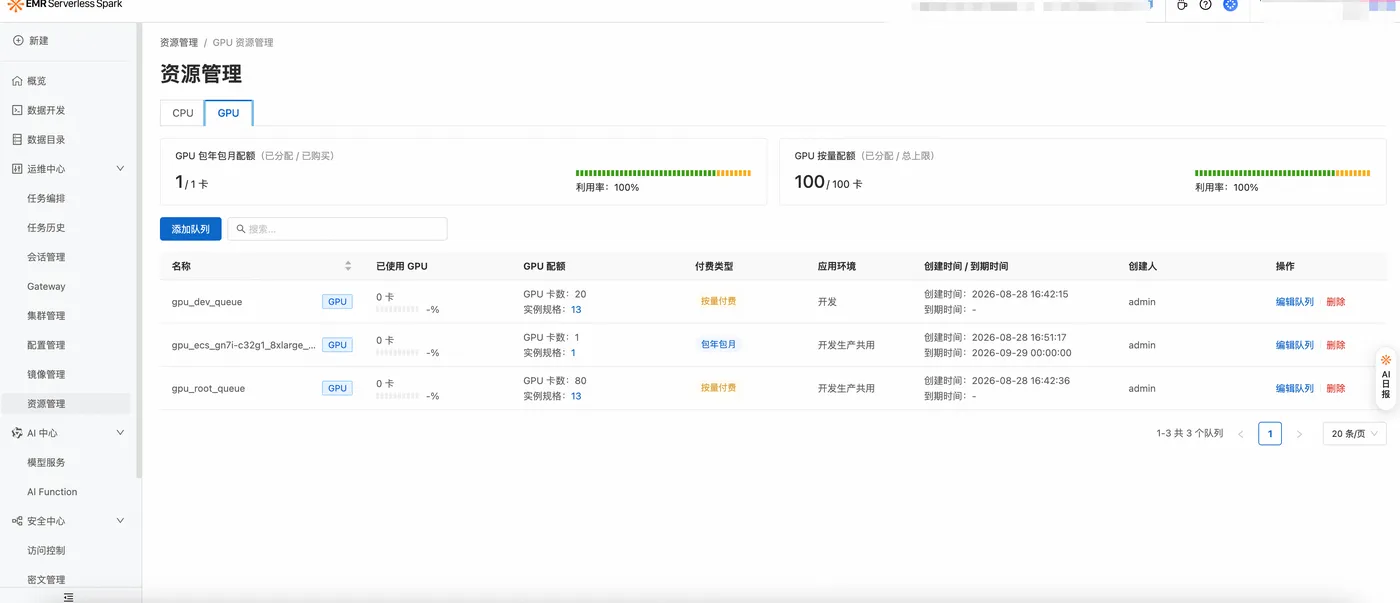
支付完毕后可以在队列页面看到新创建的默认包年包月队列。
快速跑通两个 Demo
GPU 买好后我们用两个真实可运行的 Demo 来验证环境是否就绪:
- PySpark Demo —— 用 PySpark 提交一个 GPU 任务,验证 GPU 能被正常识别和调用
- Ray Demo —— 创建一个Ray集群,跑一个分布式GPU任务
Demo 1:PySpark GPU 任务
这里以Notebook会话中运行PySpark为例,创建Notebook时将Executor部署队列选择为刚刚创建的GPU队列,根据自己的需要选择GPU机型并启动。
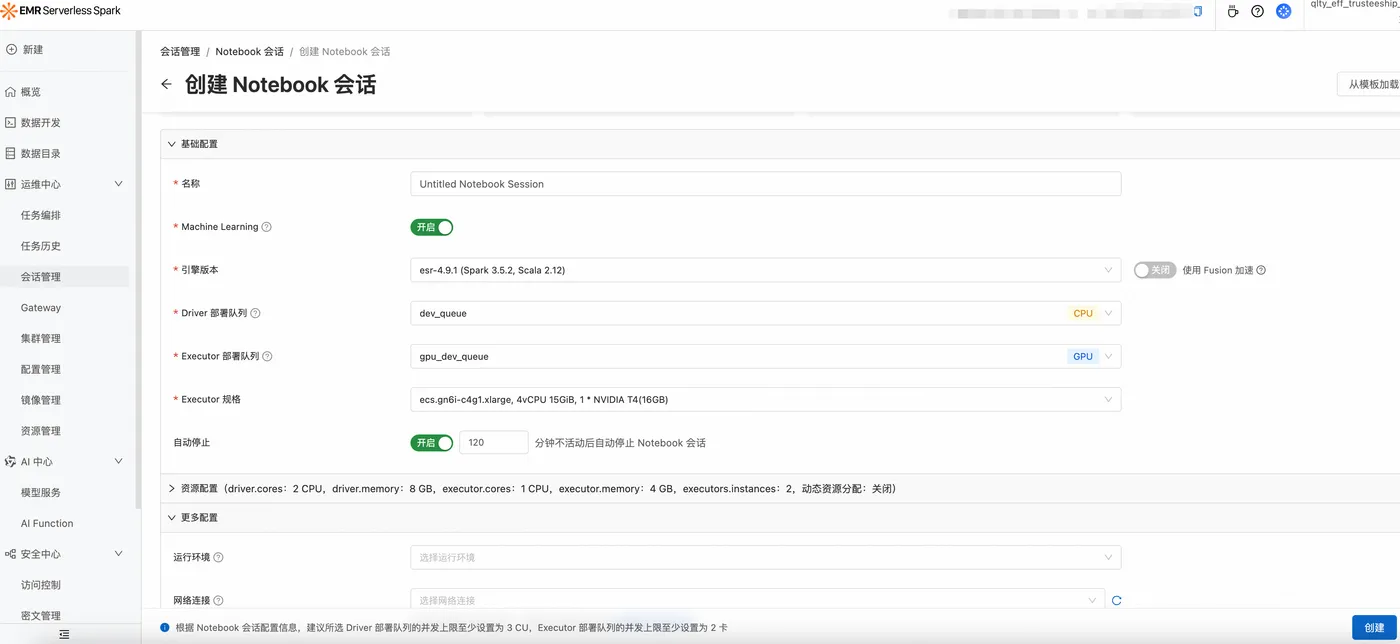
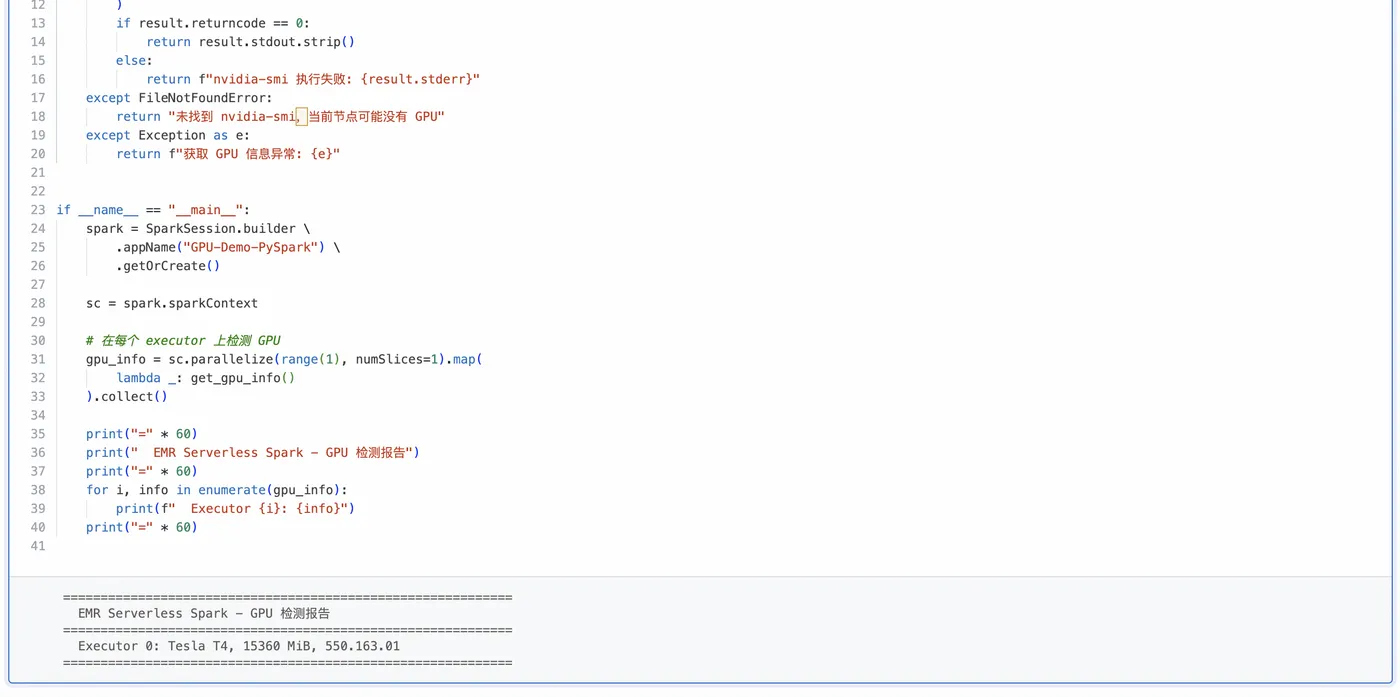
提交一个 PySpark 任务,让它检测当前环境的 GPU 信息并打印出来。如果你的 GPU 资源购买和配置都正确,任务日志里会输出 GPU 的型号、显存等信息。
代码
# pyspark_gpu_demo.py

from pyspark.sql import SparkSession
import subprocess

def get_gpu_info():
    """调用 nvidia-smi 获取 GPU 信息"""
    try:
        result = subprocess.run(
            ["nvidia-smi", "--query-gpu=name,memory.total,driver_version", "--format=csv,noheader"],
            capture_output=True, text=True, timeout=10
        )
        if result.returncode == 0:
            return result.stdout.strip()
        else:
            return f"nvidia-smi 执行失败: {result.stderr}"
    except FileNotFoundError:
        return "未找到 nvidia-smi,当前节点可能没有 GPU"
    except Exception as e:
        return f"获取 GPU 信息异常: {e}"

if __name__ == "__main__":
    spark = SparkSession.builder \
        .appName("GPU-Demo-PySpark") \
        .getOrCreate()

    sc = spark.sparkContext

    # 在每个 executor 上检测 GPU
    gpu_info = sc.parallelize(range(1), numSlices=1).map(
        lambda _: get_gpu_info()
    ).collect()

    print("=" * 60)
    print("  EMR Serverless Spark - GPU 检测报告")
    print("=" * 60)
    for i, info in enumerate(gpu_info):
        print(f"  Executor {i}: {info}")
    print("=" * 60)
预期输出
任务跑完后,在日志里你应该能看到类似这样的内容:
============================================================
  EMR Serverless Spark - GPU 检测报告
============================================================
  Executor 0: NVIDIA A10, 24576 MiB, 535.129.03
============================================================
Demo 2:Ray 分布式任务
在这个Demo中我们展示了Ray集群上GPU的可用性以及简单的GPU矩阵计算。
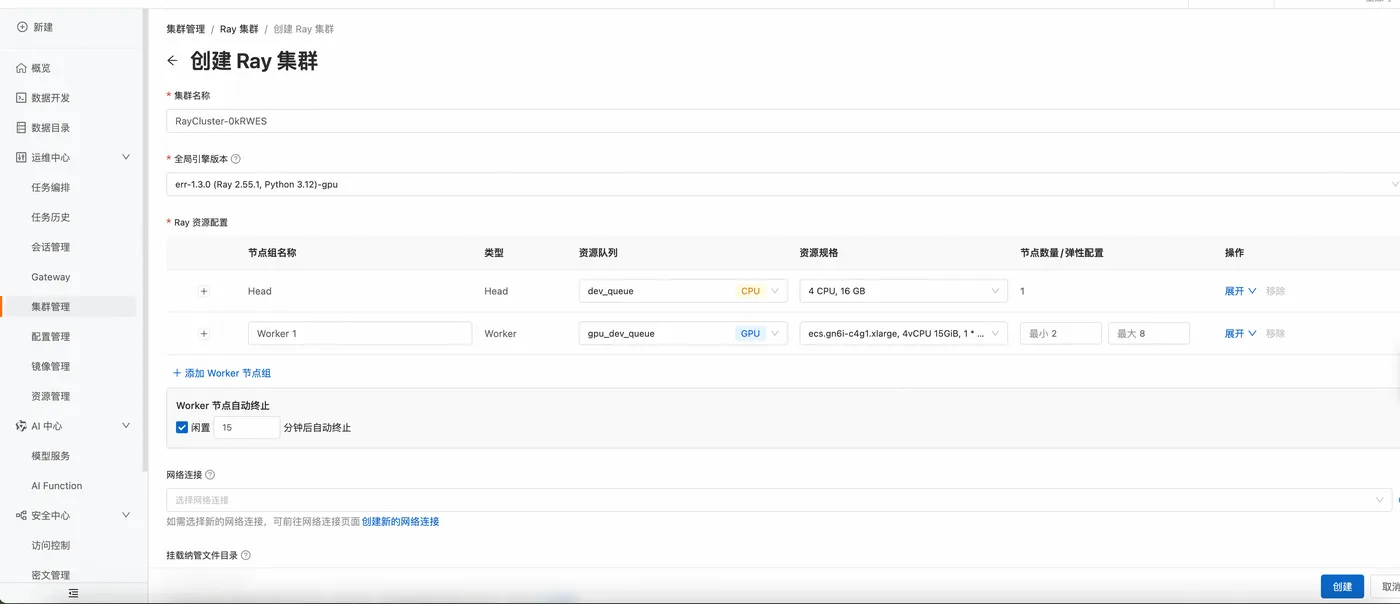
首先到工作空间的集群管理 - Ray集群中创建一个Ray集群,根据需要选择head节点或worker节点为GPU,然后启动。
代码
# ray_demo.py

import ray
import torch
import time

# 初始化 Ray(本地调试用;集群提交时替换为 ray.init(address="auto"))
ray.init(num_gpus=2)  # 根据实际可用 GPU 数量调整

@ray.remote(num_gpus=1)  # ✅ 关键:声明每个 Task/Actor 需要 1 张 GPU
class GpuWorker:
    def __init__(self):
        # Ray 会自动设置 CUDA_VISIBLE_DEVICES,无需手动指定
        self.device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
        self.gpu_id = torch.cuda.current_device()

    def train_step(self, size: int = 1024):
        """模拟一个 GPU 计算任务"""
        x = torch.randn(size, size, device=self.device)
        y = torch.randn(size, size, device=self.device)
        result = torch.mm(x, y)  # 矩阵乘法,触发 GPU 计算
        return {
            "gpu_id": self.gpu_id,
            "device": str(self.device),
            "result_shape": list(result.shape),
        }

# ========== 主逻辑 ==========
print(f"集群可用 GPU 总数: {ray.cluster_resources().get('GPU', 0)}")

# 创建多个 Worker(Ray 会自动将不同 Worker 调度到不同 GPU)
num_workers = 2
workers = [GpuWorker.remote() for _ in range(num_workers)]

# 并发提交任务并收集结果
futures = [w.train_step.remote() for w in workers]
results = ray.get(futures)

for i, r in enumerate(results):
    print(f"Worker {i} -> GPU:{r['gpu_id']}, Device:{r['device']}, Shape:{r['result_shape']}")

ray.shutdown()
从本地提交到Serverless Spark的Ray集群,需要安装ray客户端,
pip install "ray[default]==2.55.1"
# ray job submit前必须设置ray address和headers
# ay address和headers可以从调用信息中获取
export RAY_ADDRESS='https://emr-spark-ray-gateway-cn-beijing.aliyuncs.com'
export RAY_JOB_HEADERS='{"ray-token": "xxxxxxxx"}'

## 提交任务
### working dir 支持本地 & Ray core distrubuted sort
ray job submit --working-dir "." -- python ray_demo.py
预期输出
可以在Ray集群的Dashboard UI上看到运行日志。
集群可用 GPU 总数: 2.0
Worker 0 -> GPU:0, Device:cuda, Shape:[1024, 1024]
Worker 1 -> GPU:1, Device:cuda, Shape:[1024, 1024]
常见问题
Q:任务提交后报错找不到 nvidia-smi?
检查你选择的是否是 GPU 队列。如果不是请选择GPU队列和GPU机型。
Q:GPU节点长时间处于启动中?
对于按量付费的GPU机型,可能会存在无库存风险,可以过一段时间再试或切换到包年包月GPU实例上。
Q:GPU 和 CPU 任务能混着跑吗?
可以。同一个工作空间下可以同时提交 GPU 任务和 CPU 任务,它们会使用不同的实例规格,互不影响。