目录
3. Evidence Collection:runtime 不等于真实运行日志
5. 第一道门:Precheck 检查的是 Evidence key 是否齐备
6.1 Case A:只有学生自述,没有形成 runtime key
6.2 Case B:存在 runtime key,但内容不足以证明目标行为
7. 第二道门:Reviewer 判断语义,但模型没有总分权
8. 第三道门:CI 能确定的事情尽量不交给 Reviewer
13. Weight:当前是人工权重,不是科学校准后的最优权重
14.1 与 Microsoft Foundry Rubric Evaluator 的区别
15. 缓存:保证的是 Evidence Snapshot 复用,不是 Commit 级一致性
摘要 本系列前三篇文章,分别讨论了 Agent 交付物验收的核心逻辑、Evidence 证据采集的工程实现、Rubric 验收标准的设计与生效验证。但 Rubric 写出来以后,系统到底怎么执行?从提交请求到最终输出验收结果,中间经过哪些环节?哪些判断交给代码,哪些交给 LLM?
本文以 AI Tutor Engine(信科院智能助手)的真实代码为基础,完整拆解 Evidence Pipeline 自动验收链路,涵盖证据采集、预检、CI 直判、LLM 语义评审、确定性聚合全流程,同时记录 CI 证据契约修复的完整过程、当前方案的能力边界,以及和业界现有方案的定位差异,工程实现复盘所有结论基于本地测试环境与代码快照,不代表生产级端到端验证。
1.Rubric 的核心数据结构
当前数据结构是这样的:
class Rubric(BaseModel):
    id: str
    task_id: str = ""
    criterion: str = ""
    description: str = ""
    required_evidence: list[str] = Field(default_factory=list)
    pass_condition: str = ""
    weight: int = 1
    visual_check: Literal["none", "supported"] = "none"
    visual_pass_condition: str = ""
    evaluation_role: EvaluationRole = EvaluationRole.acceptance
它已经能够描述:验什么、需要什么类型的证据信号、什么情况下算达标、这项标准的权重、是否参与最终交付判定。 但这里有两个容易混淆的维度,必须先分开。
1.1 evaluation_role:决定标准的角色
class EvaluationRole(str, Enum):
    acceptance = "acceptance"
    theory = "theory"
    reflection = "reflection"
它回答的是:这条 Rubric 在项目完成判定里扮演什么角色? 只有 acceptance 会进入项目最终 score 和 status;theory 未达标进入 Learning Gap;reflection 则只作为过程记录。这个分桶逻辑我们在第一篇已经详细介绍过。
1.2 Evidence:存在两套词汇体系
这是理解后面所有代码的重要前提:系统实际上存在两套 Evidence 词汇,并不完全统一。
Schema 层定义了枚举类型:
class EvidenceType(str, Enum):
    CODE = "code"
    CI = "ci"
    RUNTIME = "runtime"
    VISUAL = "visual"
    GITHUB = "github"
    DESCRIPTION = "description"
    MANUAL = "manual"
    TRACE = "trace"
    REPORT = "report"
    ISSUE = "issue"
但真正参与 Precheck 的 required_evidence 并不是 list[EvidenceType],而是自由字符串列表。与此同时,运行时 available 字典还会出现 test、url、deployment 等自由字符串 key。
换句话说,持久化 Evidence 的枚举类型,与评审链内部使用的 Evidence key 并不是完全相同的一套类型系统。
比如 required_evidence = ["ci", "runtime"] 表达的是这是一条会参与交付判定的 Rubric,同时要求评审链能够识别 ci 和 runtime 两种证据信号,而不是 “CI 是一种 EvaluationRole” 。
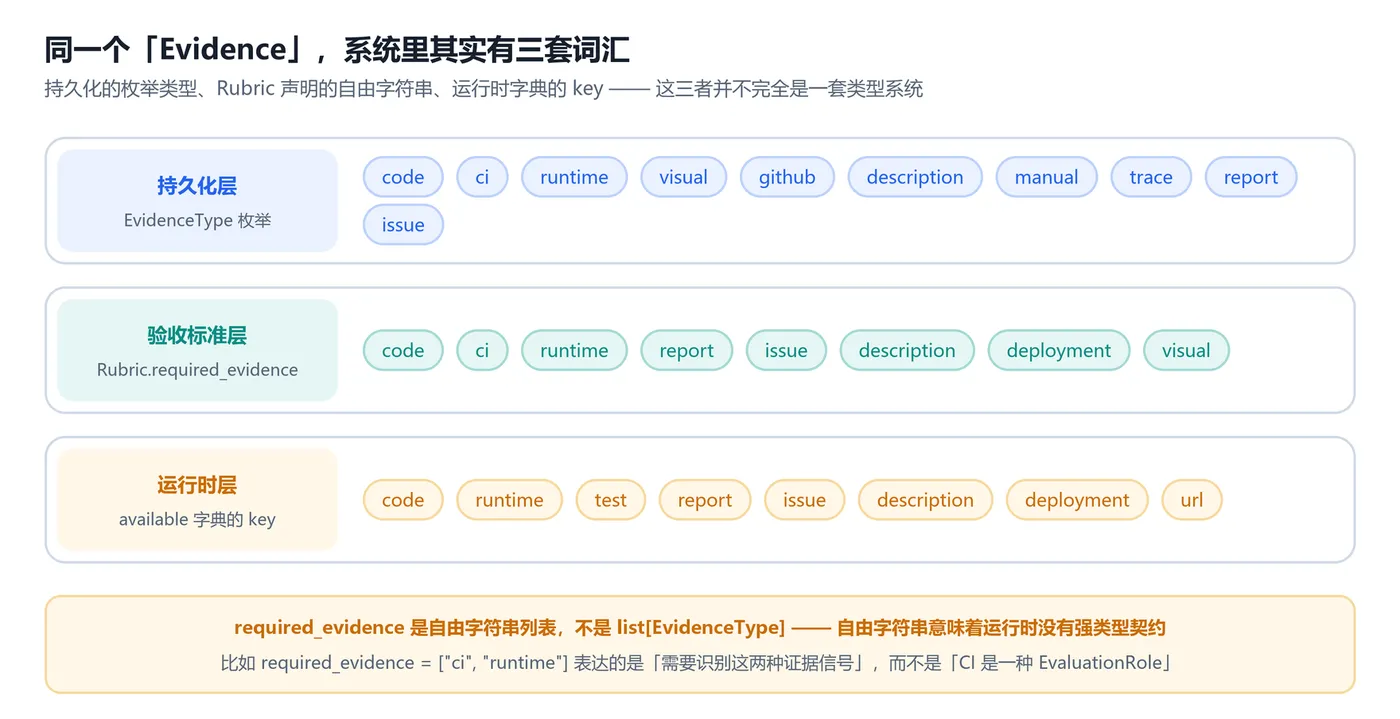
图 1 同一个「Evidence」,系统里其实有三套词汇
2. 一次真实评审经过哪些环节?
当前完整的请求链路大体可以概括为:从提交请求开始,经过证据采集、预检、CI 直判、LLM 评审、确定性聚合,最终落库。
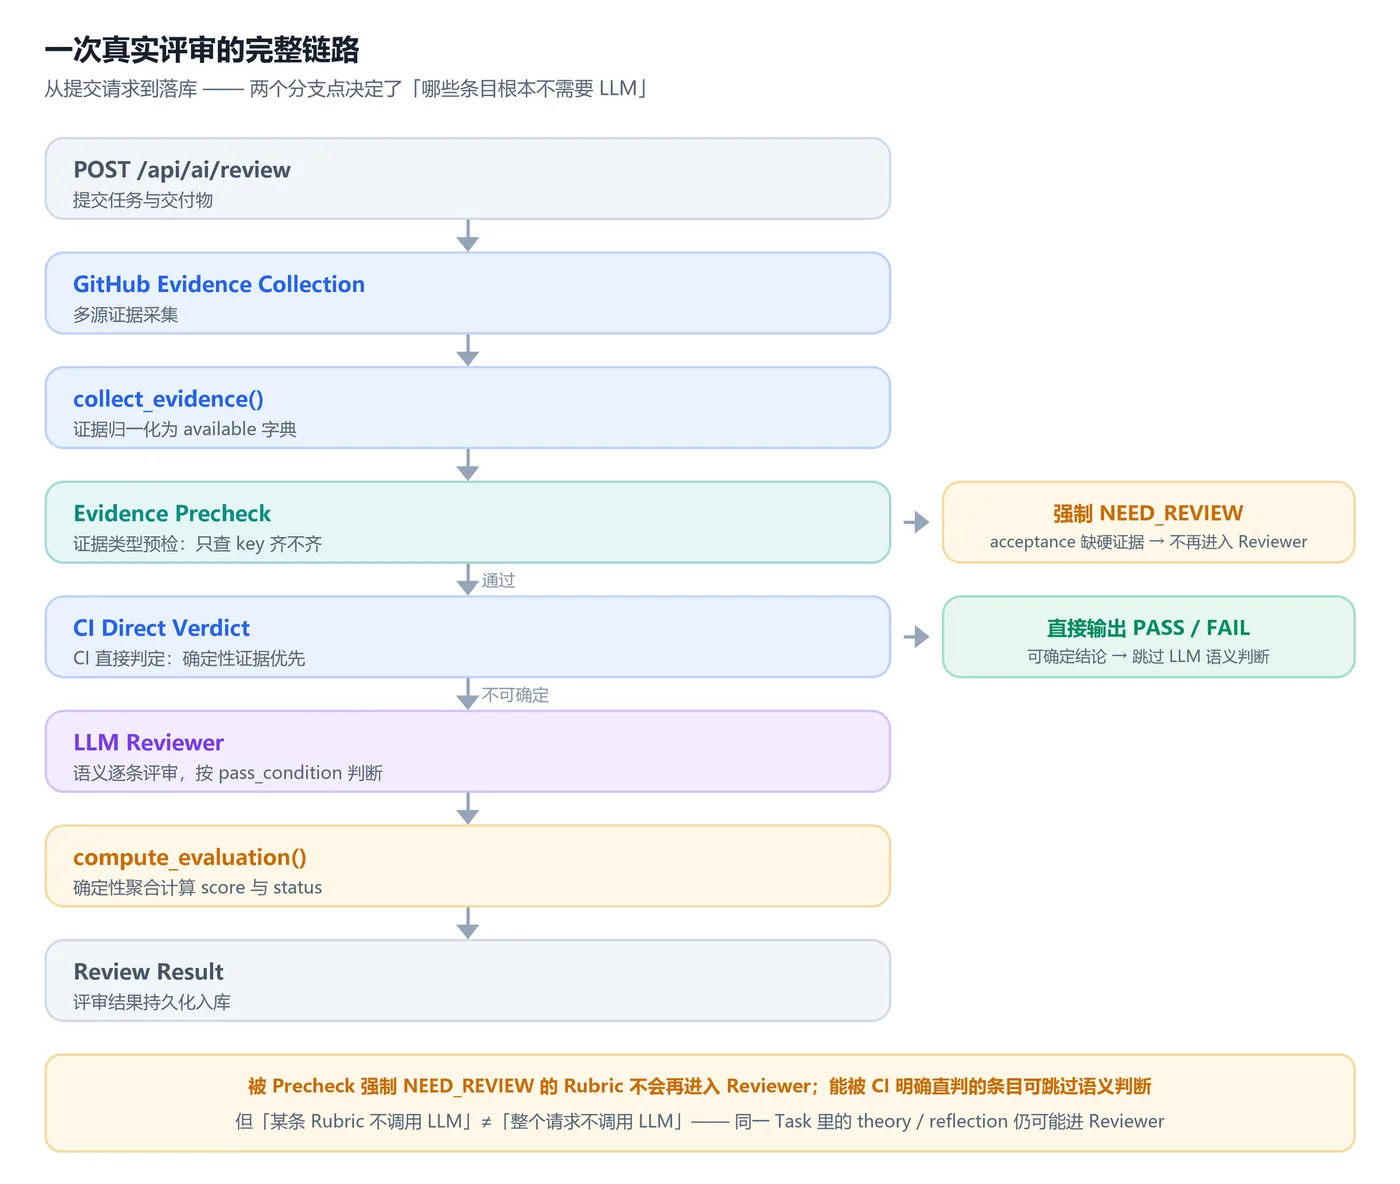
图 2 一次真实评审的完整链路:两个分支点决定了哪些条目不需要 LLM
这里有两个非常关键的执行规则:
- 被 Precheck 强制 NEED_REVIEW 的 Rubric,不会再进入 Reviewer 环节
- 能够被 CI 明确直判的 acceptance Rubric,可以跳过对应条目的 LLM 语义判断
只有剩余无法通过确定性规则判断的 Rubric,才进入 Reviewer。
同时要避免一个过度概括:某条 Rubric 不调用 LLM 不等于 整个请求一定不调用 LLM。如果同一个 Task 中还存在 theory 或 reflection 条目,它们仍可能进入 Reviewer。系统确实存在无 Reviewer 调用的短路路径,但不是所有 CI 直判场景都能实现整个请求零 LLM。
3. Evidence Collection:runtime 不等于真实运行日志
这是技术准确性上非常重要的一点:runtime 证据不等于程序真实运行成功的日志。
当前 collect_evidence() 中,runtime key 至少可能来自三个渠道:
- 在线部署地址推导
- 用户提交说明中识别出的启动命令
- README 中提取的启动命令回填
核心逻辑简化为:
if sub.deployment_url:
    ev["deployment"] = ...
    ev["runtime"] = ...

if sub.description:
    ev["description"] = ...
    if "runtime" not in ev:
        cmd_line = detect_run_cmd(sub.description)
        if cmd_line:
            ev["runtime"] = "本地可复现运行说明(学生自述含启动命令):" + cmd_line
所以更准确的定义应该是:runtime 是当前评审链对“具备运行/复现信息”的一种分类信号,而不是“已经观察到程序真实运行成功”的强事实类型。
比如一句 uvicorn app:app --reload 就可能让系统获得一个 runtime key,但它最多证明提交中存在可复现的启动说明,并不能证明服务真的成功启动,更不能证明某个具体业务行为真的发生。
因此 Evidence Pipeline 必须区分两个独立的问题:
- runtime 类型是否存在?→ Precheck 处理
- 这个 runtime 内容是否足以证明当前 Rubric?→ 语义评审处理
4. GitHub Evidence 也不能无限采集
取证时的工作区实现对 GitHub 内容设置了明确的上限:
STRUCTURE_MAX = 200
KEY_FILES_MAX = 10
FILE_LINES_MAX = 120
REPORT_LINES_MAX = 250
EVIDENCE_CHAR_CAP = 20000
CACHE_TTL = 300
ISSUES_MAX = 5
系统并不是简单地把整个仓库塞给模型,而是先获取仓库结构,再选择关键文件,并限制文件数、行数和总字符数。
这对 BYOK 场景尤其重要。更多 Evidence 同时意味着更高 Token 成本、更多无关上下文、更大的截断概率、Reviewer 更难定位真正相关的证据。但它也带来一个必须承认的边界,没有进入采样窗口的代码,就不会进入本轮 Reviewer 的 Evidence Context。 后面谈缓存一致性时,这一点还会再次产生影响。
5. 第一道门:Precheck 检查的是 Evidence key 是否齐备
核心函数是 evidence_precheck(),它做的本质是集合差集运算:Rubric 要求的证据类型,减去当前已有的证据 key,等于缺失类型。
简化关键逻辑后:
present = set(available.keys())
if ci_provided:
    present.add("ci")

for r in rubrics:
    if role(r) != acceptance:
        passable.append(r)
        continue

    needed = set(r.required_evidence) - optional_bonus
    missing = needed - present

    if missing_real:
        forced_needs_review.append(...)
    else:
        passable.append(r)
当前还有几个重要规则:
- 只有 acceptance 会因为缺硬证据被强制进入 NEED_REVIEW
- deployment、visual、report、issue 目前被当作 optional bonus,从硬门槛中剔除
- description 不作为缺失硬证据阻断 acceptance
最重要的一点:Precheck 不读取证据内容来判断语义充分性。 对它来说,{"runtime": "server started"} 和 {"runtime": "session B 成功恢复 session A 写入的数据"} 在类型层面都是 runtime exists。
所以与其把 Precheck 描述成“验证 Evidence 是否有效”,不如更准确地称为:Evidence presence / type gate(证据存在性/类型闸门)。
6. 两个对照案例:缺类型和缺语义不是同一种问题
我们用一条真实存在的 Rubric 做两个对照测试,可以非常清晰地看到两层职责的区别。
Rubric ID: rb_c3t08_2 Criterion: 跨会话恢复真的发生过 required_evidence: ["runtime"] weight: 2 evaluation_role: acceptance(缺省)
6.1 Case A:只有学生自述,没有形成 runtime key
构造输入:
available = {

    "description": "I implemented cross-session restore"
}
注意这里 description 中没有可被 detect_run_cmd() 识别的启动命令,因此不会自动派生出 runtime。
实际路径推演结果:
forced: rb_c3t08_2 → missing=["runtime"] 最终:status = NEED_REVIEW,score = 0
也就是说,“我已经完成”这样的纯声明,不足以满足 runtime 类型要求,直接被 Precheck 阻断。
6.2 Case B:存在 runtime key,但内容不足以证明目标行为
测试夹具:
available = {

    "runtime": "run log: python main.py -> server started on :8000"
}
此时 Precheck 得到 forced = [],所以 rb_c3t08_2 可以进入 Reviewer。 但这条 Evidence 只能证明“有启动信息/启动成功迹象”,不能自然推出跨会话状态确实被恢复。当前后端没有专门的程序化 Semantic Evidence Validator 去做这个推理。
因此,当 Reviewer 分别返回 PASS、NEED_REVIEW、FAIL 时,后端会分别聚合成对应结果。
注:案例 B 的 runtime 文本是构造夹具,LLM 三种输出也是枚举模拟,不是生产模型调用结果。素材核验阶段没有运行真实 LLM 端到端评审。
这个案例非常明确地展示了两层职责:
- Case A:Evidence type 不存在 → Precheck 阻断
- Case B:Evidence type 存在 → 交给语义 Reviewer 判断内容是否足够
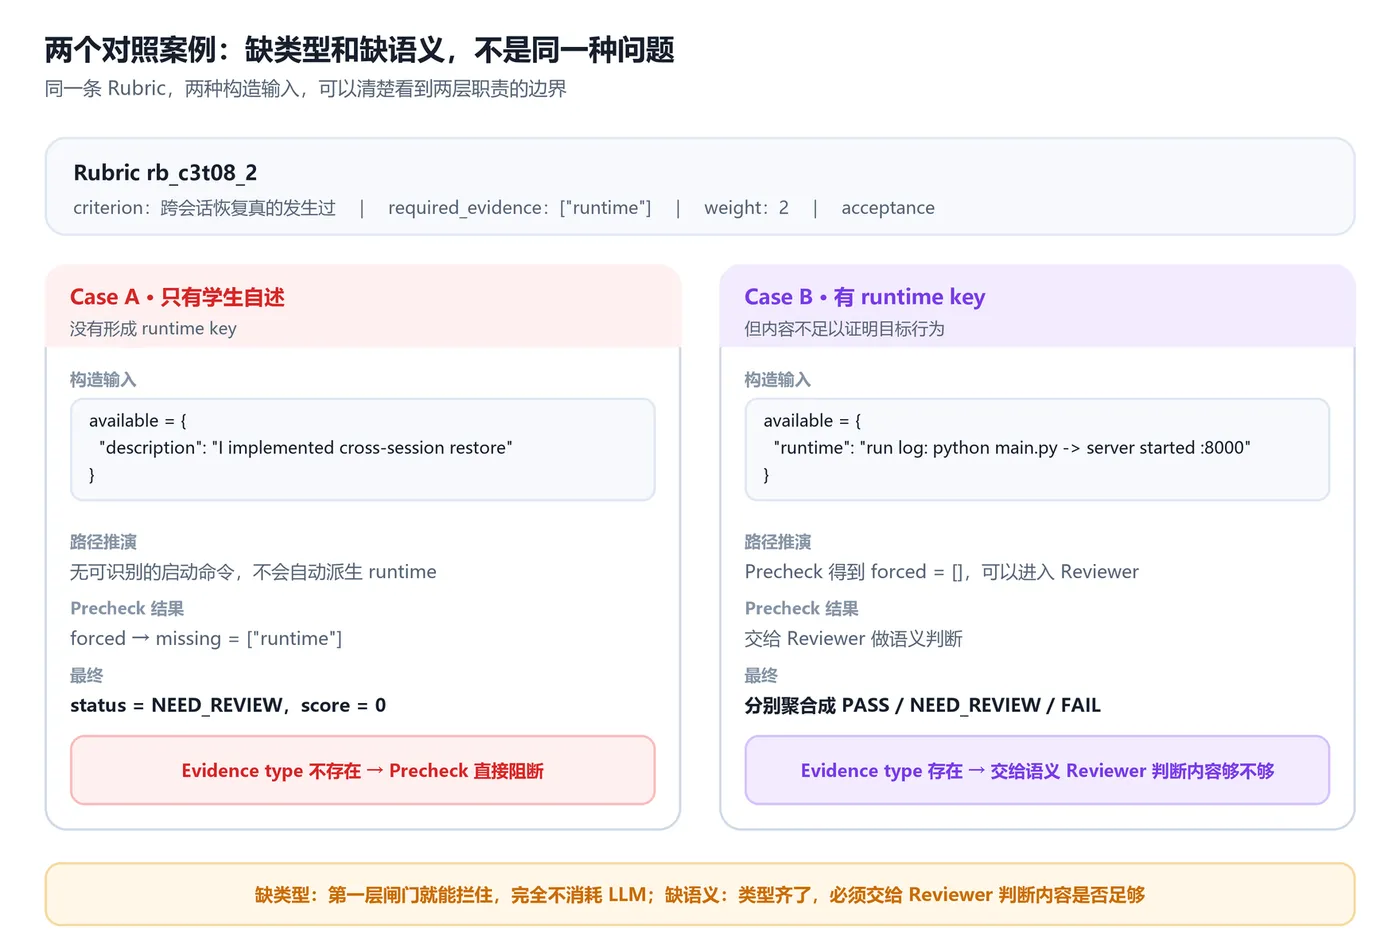
图 3 两个对照案例:缺类型和缺语义不是同一种问题
7. 第二道门:Reviewer 判断语义,但模型没有总分权
进入 Reviewer 的 Rubric 会被组织进 System Prompt,模型看到的包括:Rubric ID、criterion、description、required_evidence、pass_condition、weight、已有 Evidence 文本、缺失证据提示。
模型的输出被严格限制成固定格式,没有总 score 和 overall status 字段:
{

  "criteria": [
    {

      "rubric_id": "rb_xxx",
      "status": "PASS",
      "evidence": "判定依据",
      "reason": "判定理由"
    }
  ],
  "next_step": "下一步"
}
模型只能负责逐条 ReviewCriterion,不能决定最终总分和整体状态。 Prompt 中还有类似这样的硬约束:
- 没有证据支撑的判定一律 NEED_REVIEW
- 不得因为代码“看起来合理”就断定功能能跑通
- 不得伪造运行结果
模型输出后还会进入 _semantic_validate_review()。但这里“semantic validate”这个函数名很容易令人误解。 它真正验证的是:
- criteria 是否为空
- rubric_id 是否越界
- evidence 字段是否非空
- reason 字段是否非空
- 是否覆盖所有送审 Rubric
它并不会验证 evidence='server started' 是否真的能够推出跨会话恢复成功。 更准确地说,这里完成的是输出契约与覆盖完整性校验,而不是 Evidence grounding 的形式化证明。
当前 MAX_RETRIES = 2,对应最多两次模型尝试,而不是第一次失败以后再额外重试两次。
8. 第三道门:CI 能确定的事情尽量不交给 Reviewer
CI 是当前系统里最典型的 deterministic evidence。但实现中曾经出现过一个真实的契约问题。
GitHub Actions 的结果一直作为 ci_workflows 独立传递,与此同时 collect_evidence() 不会生成 available["ci"]。 修复前,Precheck 只查看 set(available.keys()),因此只要一条 Rubric 写着 required_evidence=["ci", "runtime"],即使真实 CI 已经存在,Precheck 仍会认为 ci missing,导致 forced NEED_REVIEW。
真实设计中的 rb_c3t11_3 就受到了这个问题影响。同时旧的 ci_direct_verdict() 对 "ci" 这个 required-evidence key 也没有对应处理分支。
于是出现了非常讽刺的情况:GitHub Actions 有真实结果,CI 数据已经拿到了,Precheck 却仍说 ci 不存在。
问题的本质不是API 没接好,而是同一份事实在不同模块之间没有共享一致的数据契约。
9. CI 修复:统一存在性,但不要夸大成全系统统一
修复后增加了 CI 证据状态的统一判定函数:
CI_EVIDENCE_TYPE = "ci"
_CI_DEFINITIVE = ("success", "failure")

def ci_evidence_state(ci_workflows):
    cons = [
        str(w.get("conclusion") or "").strip().lower()
        for w in (ci_workflows or [])
    ]
    cons = [c for c in cons if c in _CI_DEFINITIVE]

    if cons and set(cons) == {
   "success"}:
        return {
   "provided": True, "conclusion": "success"}
    if cons and set(cons) == {
   "failure"}:
        return {
   "provided": True, "conclusion": "failure"}

    return {
   "provided": bool(cons), "conclusion": ""}
这里有三个需要准确理解的状态:
- 全部 definitive 结论都是 success → provided = True,conclusion = success
- 全部 definitive 结论都是 failure → provided = True,conclusion = failure
- success 和 failure 混合存在 → provided = True,conclusion = ""
也就是说:混合结论不是没有 CI 证据,而是有 CI 证据,但无法归并成一个统一 conclusion。如果工作流只有 queued、cancelled、空 conclusion 等非 definitive 状态,则不会被认为提供了有效 CI Evidence。
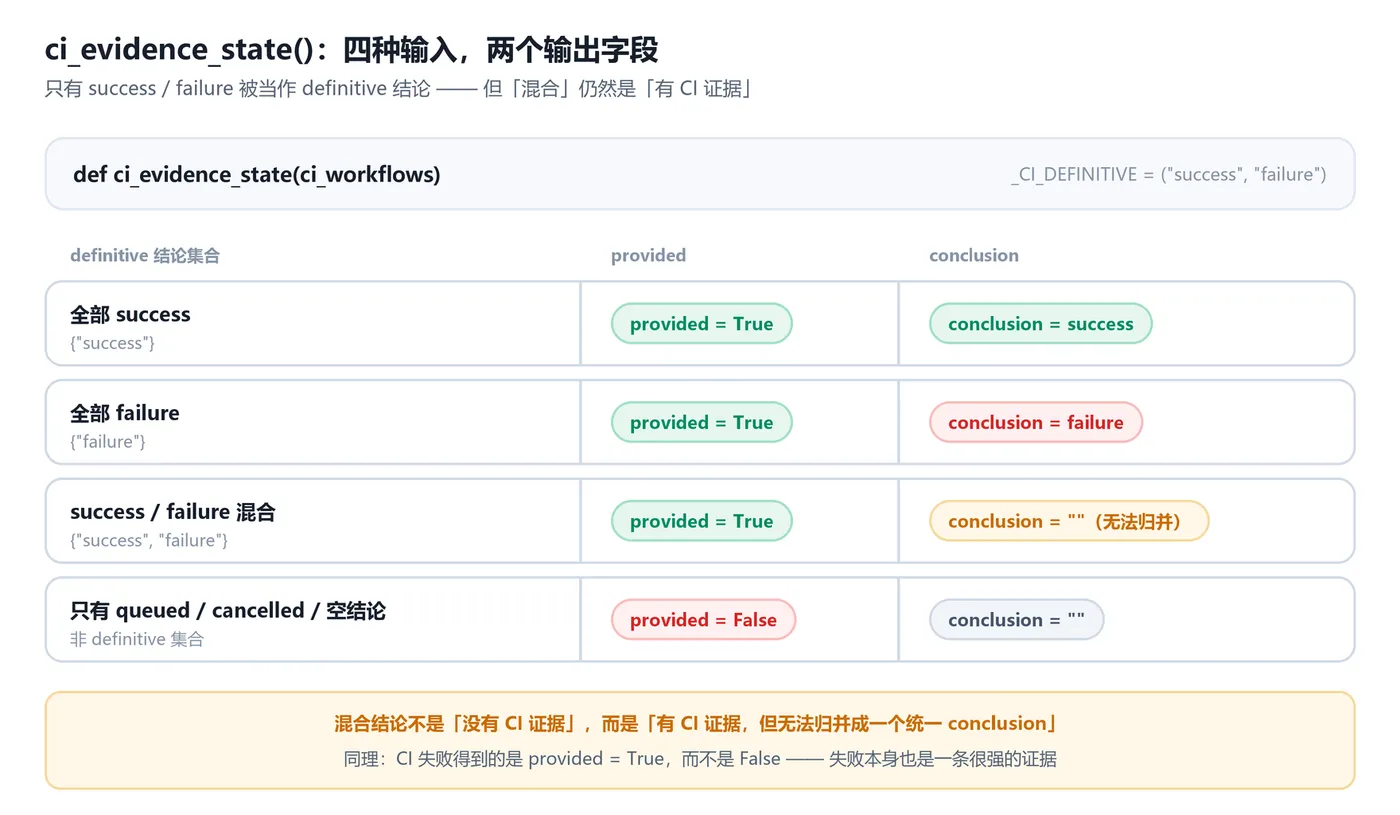
图 4 ci_evidence_state():四种输入,两个输出字段
之后,evidence_precheck() 和 Reviewer Prompt 的缺失证据计算都会使用这个 provided 事实。而 ci_direct_verdict() 仍然直接读取原始 ci_workflows,只是现在增加了 "ci" 分支,并使用相同的 success / failure definitive 词汇去尝试直接判定。
所以准确的表述不是“Precheck、Prompt、CI 直判都直接读取同一个 ci_state”,而是: 评审链通过 ci_evidence_state() 统一了 CI 是否“已提供”的判定口径;CI 直判仍读取结构化 workflows,但补齐了 ci Evidence 类型和 definitive conclusion 的处理。
10. “证据存在”不等于“证据通过”
这是 CI 契约中非常重要的一点。
例如 GitHub Actions conclusion = failure,得到的是 provided = True,而不是 provided = False。 因为 CI 失败本身也是一条非常强的 Evidence:它明确证明检查没有通过。
所以:
- Evidence Presence = True
- Verdict = FAIL
这能够避免一种常见错误:失败结果 → 被当成“没有结果” → 进入 NEED_REVIEW。 当前系统会尽量保留失败本身的事实语义。
11. 这次 CI 修复解决了什么,没有解决什么?
已解决
- required_evidence 含 ci 时,不再因为 available 字典没有 "ci" key 而永久误判缺失
- ci_direct_verdict() 增加了对 "ci" 的处理
- queued、cancelled 等状态不会单独被当作 definitive CI Evidence
- failure 被保留为“证据存在但检查失败”
- REVIEW_ENGINE_VERSION 从 2 升到 3,使旧幂等评审缓存不再继续命中修复前结论
- CI Contract 新增了 35 条确定性断言;素材核验时列出的 15 个可运行测试文件全部通过
未解决
第一,评审链之外另有 _ci_conclusion() 用于简历口径,它在混合 success/failure 时采用“任一 success 即 success”的逻辑。因此只能说此次统一针对评审链,不能说整个项目所有 CI 口径已经完全统一。
第二,真实 Rubric rb_c3t11_3 写的是 required_evidence=["ci", "runtime"],代码对这个列表按照 AND 处理。但它的 pass_condition 文案却是“GitHub Actions 成功;没有 CI 时给出完整本地测试输出”,这实际上表达了一个 OR 关系。
因此此次修复解决的是 CI Evidence 契约断裂,没有解决这条 Rubric 自身的 AND/OR 建模不一致。
上一轮修复交付记录显示,该修复文件被同步到生产机并完成 pm2 restart 与 health check;不过真实 Reviewer LLM 的完整端到端路径没有在该轮完成验证,因此我不能说整个自动验收系统已经完成生产级端到端验证。
12. 最终评分为什么必须回到代码层?
Reviewer 完成逐条判定以后,不负责回答“这个项目综合应该得多少分”。聚合由 compute_evaluation() 完成。
核心公式是:
score = Σ(PASS acceptance 的权重) / Σ(全部 acceptance 的权重) × 100
最终 status 的规则是:
- 存在 acceptance FAIL → 最终 FAIL
- 否则存在 acceptance NEED_REVIEW → 最终 NEED_REVIEW
- 否则 → 最终 PASS
theory 和 reflection 会提前进入其他分桶,不改变交付状态。
这里有一个非常重要的设计点:score 不参与 PASS 阈值判断。 系统没有 score >= 60 → PASS 的规则,而是要求所有 acceptance 都 PASS,最终才 PASS。
因此:
- score 回答的是:当前有多少加权 acceptance 已通过?
- status 回答的是:是否还存在阻断交付的问题?
两个含义完全不同。
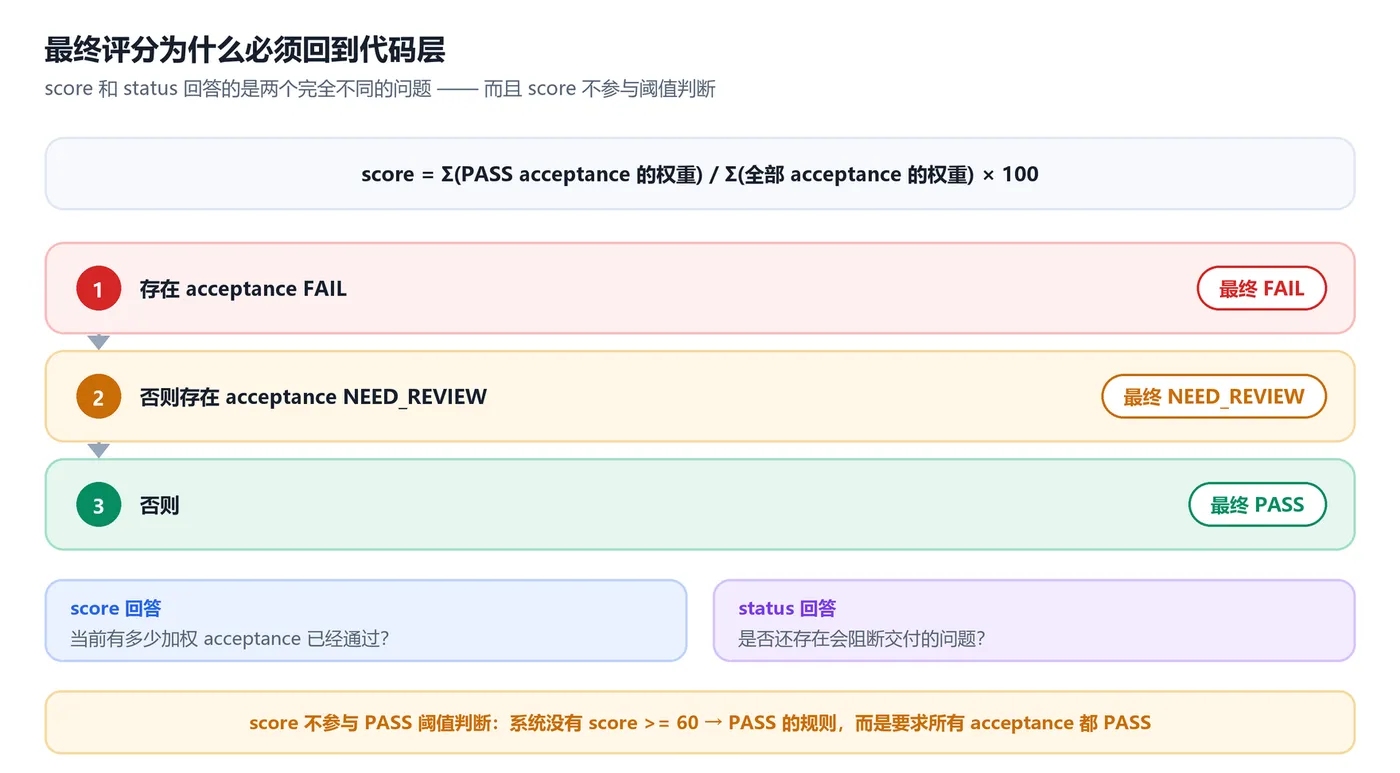
图 5 最终评分为什么必须回到代码层:status 优先级与 score 的定位
13. Weight:当前是人工权重,不是科学校准后的最优权重
Rubric 的 weight: int = 1 由我直接写入模块。
当前没有历史标注集拟合、没有 A/B 对照实验、没有与人工评分做权重回归、没有自动调权。 因此当前系统使用人工配置的整数权重,对 acceptance Rubric 的逐条结果进行确定性加权聚合。,所以未经过实验找到最优权重。
还有两个代码边界值得记录:
- weight 在 Schema 层没有范围约束,负数不会直接校验失败,而是在聚合时通过 max(int(weight), 0) 夹成 0
- 如果一个任务完全没有 acceptance 条目,当前 compute_evaluation() 会得到 score = 0,status = PASS
这是现有实现的真实边缘行为,也说明后续还可以继续加强 Schema 和聚合不变量约束。
14. 和现有方案的关系与定位
本文实现并不是在声称提出一种新的 Agent Evaluation 理论。更准确的定位是在一个真实教学系统中,把 Evidence、Rubric、确定性程序和 LLM Judge 组合成一条可以执行的验收链。
14.1 与 Microsoft Foundry Rubric Evaluator 的区别
微软 Foundry 当前的 Rubric Evaluator 支持自定义加权 criteria,LLM Judge 对每个适用维度给出 1–5 分,然后计算加权平均并归一化到 0–1;截至本文撰写时,该能力仍标注为 Preview。
当前 AI Tutor Engine 的路线不同:Reviewer 只输出 PASS / FAIL / NEED_REVIEW 三态,后端根据 acceptance + weight 做确定性聚合。两者虽然都属于 rubric-based evaluation,但评分语义并不一样。
14.2 与 RULERS 的区别
2026 年的 RULERS 提出 compiler-executor 框架,把自然语言 Rubric 编译成版本化、不可变的执行规格,并结合结构化解码、deterministic evidence verification 和后处理校准。
它与本文的工程问题有明显交集:Rubric 如何稳定?Evidence 怎样锚定?哪些判断应确定性执行?怎样减少 Judge 的自由度? 但当前项目没有实现 RULERS 的完整 executable-spec 编译和 calibration,所以不能写成“项目已经实现 RULERS”。
14.3与 GenRubric 的区别
GenRubric 研究的是另一端的问题:如何从未标注查询出发,通过自演化改进 query-specific rubric 生成,并且在这一过程中不要求额外人工标注。
而当前系统的 Rubric 仍然主要由课程作者手工编写。因此两者的关注点可以概括为:
- GenRubric:怎样生成更好的 Rubric?
- 当前工程:Rubric 已经给定以后,怎样把它可靠地执行?
LLM-as-a-Judge 本身也已经形成较系统的研究方向。EMNLP 2025 的综述从 “what to judge / how to judge / how to benchmark” 三个维度整理了该领域,并讨论了仍然存在的挑战与未来方向。 这也说明:限制模型输出格式,只是可靠性工程的一部分,而不是 Judge 正确性的证明。
15. 缓存:保证的是 Evidence Snapshot 复用,不是 Commit 级一致性
系统会把 task_id + available evidence + CI workflows conclusion 序列化并生成 snapshot_hash。
Review Cache Key 最终包含:
- task_id
- snapshot_hash
- rubric_version
- prompt_version
- engine_version
- model
也就是说,在这些 key 分量保持一致且缓存仍存在时,可以复用之前的评审结果。
但 head_sha 并不进入这个 key。因此可能出现: Git Commit 改变 → 改动文件没有进入 Evidence 采样 / 差异出现在截断范围之外 → 最终 Evidence 文本和 CI 结论没变 → snapshot_hash 没变 → 继续命中旧 Review Result。
所以准确的工程承诺是相同评审 key 可以复用相同结果,而不是每个不同 Git commit 一定重新评审。 这是 BYOK 成本、稳定性与 Evidence 新鲜度之间的一个现实取舍。
16. 这条 Pipeline 真正解决了什么?
现在可以重新看整条链:
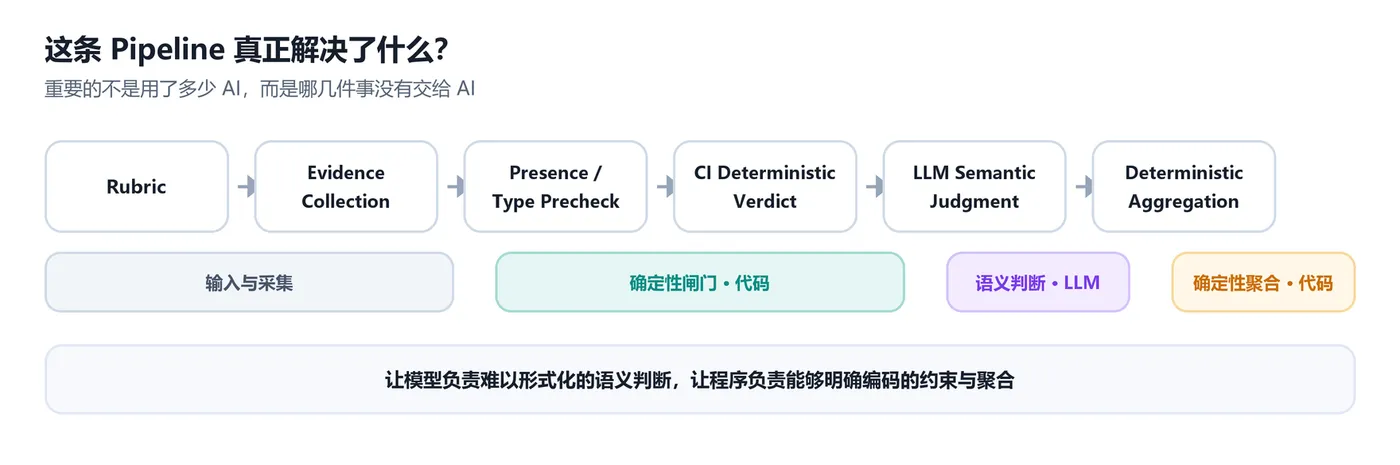
图 6 全链路与职责分工:让模型负责语义判断,让程序负责约束与聚合
其中最重要的其实不是用了多少 AI,而是哪些决定没有交给 AI:
- Evidence key 有没有缺失,可以写确定性规则
- CI 有明确 success / failure 时,可以尽量直接使用系统事实
- 权重如何聚合,可以写确定性规则
- 最终 status 的优先级,也可以写确定性规则
LLM 真正适合承担的是剩下的部分:已有这些内容,它们在语义上是否足以满足这条 Rubric?
所以如果用一句话概括当前设计,我更愿意写成:
让模型负责难以形式化的语义判断,让程序负责能够明确编码的约束与聚合。
但当前实现仍有很清楚的边界:
- runtime key 本身并不证明程序真的运行
- 没有程序化 Evidence Semantic Validator
- Reviewer 可能给出结构合法但事实错误的 PASS
- required_evidence 仍是自由字符串,而不是强类型契约
- weight 没有数据驱动校准
- 某些课程 Rubric 仍存在 AND/OR 表达能力不足
- CI 简历口径与评审口径尚未完全统一
- review cache 不提供 head_sha 级隔离
这些并不会让这套 Pipeline 失去意义。相反,它们说明下一阶段的问题已经从能不能自动评变成了自动评到什么程度以后,我们才能证明它值得相信?
17. 下一步:从可执行走向可验证、可校准
后续真正值得继续做的,可能已经不是再堆更多 Prompt,而是更底层的可靠性工程:
- 怎样给 runtime / test / trace 建立更强的语义契约?
- 哪些 Rubric 可以编译成确定性检查?
- 怎样表达 required_evidence 的 AND / OR / alternative?
- 怎样验证 Reviewer 引用的 Evidence 真的存在?
- 怎样建立人工标注 Benchmark?
- Reviewer 与人工评审的一致率是多少?
- Weight 应怎样通过实际教学数据校准?
- 不同模型下 Judge 结果是否稳定?
这些问题最终指向的是同一个目标:不仅让系统可以自动评,还要逐渐能够解释和验证为什么这样评。 这也是我认为 Agent Evaluation 从 Demo 走向真实工程系统时,更值得投入的方向,我目前正在做真实用户数据的验证,在这之前这些所谓底层的可靠性工程,是无法被实现的,我常见的情况是大量ai用户,哪怕提出了这些需求,大模型也没有真正的做出,而是写死或者编造数据,或者出现幻觉。这里插一个题外话,按照目前的情况看来,真实的数据资产,已经比技术更具备价值了。
参考与延伸
- Microsoft Foundry, Rubric Evaluators:自定义加权维度、LLM Judge、1–5 分维度评分与归一化聚合,目前为 Preview
- Li et al., From Generation to Judgment: Opportunities and Challenges of LLM-as-a-judge, EMNLP 2025:LLM-as-a-Judge 的系统综述与 taxonomy
- Hong et al., RULERS: Locked Rubrics and Evidence-Anchored Scoring for Robust LLM Evaluation, 2026:Rubric locking、Evidence anchoring、结构化执行与校准
- Chen et al., GenRubric: Self-Evolving Rubric Generation for Scalable LLM Evaluation, 2026:面向 query-specific Rubric 的自演化生成
项目实践:AI Tutor Engine(信科院智能助手 · INFO SYSTEM) 本文工程描述基于 2026 年 10 月 12 日取证代码和修复记录。文中的跨会话 A/B 案例包含构造测试夹具,不代表生产数据;真实 Reviewer LLM 的端到端表现也没有被当作实验结论。