
从事软件开发的这些年,我见过太多人在多分支开发上浪费时间。正在feature分支写了一半业务逻辑,线上突然抛异常要紧急修复,要么手忙脚乱git stash一堆未提交代码,要么临时提交一串"wip"提交记录,切到master修完再切回来,遇上百万行级别的项目,一次全量编译十几分钟就没了,思路也断得一干二净。不少人图省事直接clone两三份仓库放不同目录,结果就是磁盘占用翻倍,代码同步要来回push pull,哪天搞混了仓库提交错分支又是一堆麻烦事。
Git Worktree就是为解决这个痛点而生的。从Git 2.5正式引入到现在,它已经是我日常开发中使用率仅次于commit、push的命令。同一个Git仓库,同时检出多个工作目录,共享同一个对象库,每个目录对应不同分支,编译缓存、代码修改完全隔离,不用切来切去,也不用重复clone。
一、底层本质:共享与隔离的边界
很多人用了很久worktree却不知道它到底是什么,只知道能开多个目录。理解底层结构是避开坑的前提,先从最基础的Git仓库结构说起。
1.1 传统单工作树的结构
普通的Git仓库由两部分组成:
- 工作目录(Working Tree):你看到的所有源码文件、配置文件,就是实际编辑的地方
- Git仓库目录(.git):隐藏在工作目录根目录下,存了所有版本数据,包括objects对象库、refs分支引用、index暂存区、HEAD指针、日志等
单工作树模式下,一个.git对应一个工作目录,你每次切换分支,本质上就是用分支指向的commit树覆盖工作目录和暂存区。
1.2 Worktree的核心设计
Worktree的核心逻辑非常朴素:同一个Git仓库,可以挂载多个工作目录。所有工作目录共享仓库的核心数据,同时各自维护独立的工作状态。
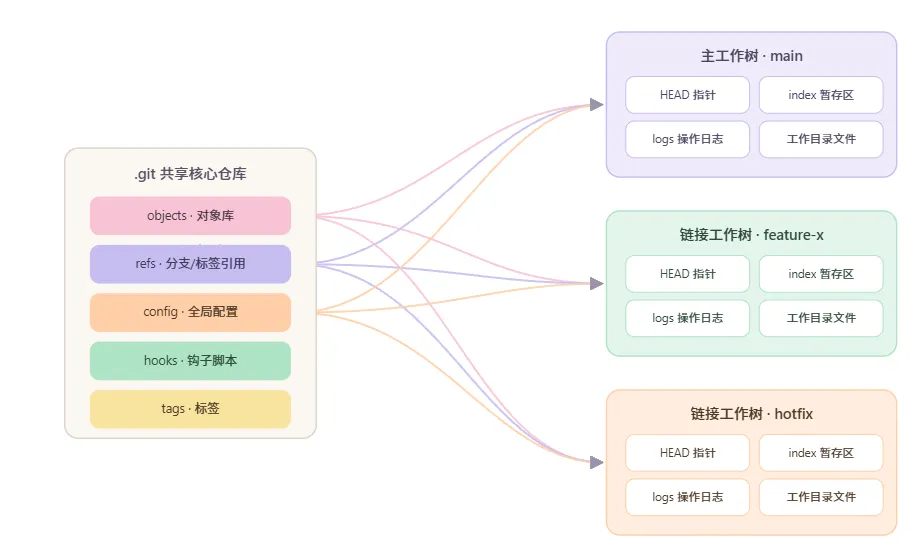
共享部分(所有worktree共用一份):
- objects目录:所有提交记录、文件内容、树对象,这是仓库体积最大的部分,共享意味着开多少个worktree都不会重复占用磁盘
- refs目录:所有分支、远程分支、标签的引用指针
- 全局config配置、hooks钩子、info信息等
独立部分(每个worktree各有一份):
- HEAD指针:当前工作树指向哪个分支或提交
- index暂存区:git add的内容存在这里
- logs日志:reflog等操作日志
- MERGE_HEAD、REBASE_HEAD等临时状态文件
- 工作目录本身:你编辑的所有源码文件
这就是为什么你在A工作树修改文件不会影响B工作树——它们有独立的工作目录和暂存区;但你在A工作树提交一个新分支,B工作树立刻就能看到——因为分支引用存在共享的refs目录里。
1.3 磁盘上的真实结构
创建worktree后,仓库里会发生两个变化:
第一,主仓库的.git/worktrees目录下会多出一个子目录,目录名默认是你创建的工作目录的文件夹名,里面存放这个worktree独有的元数据:
.git/
└── worktrees/
    └── hotfix-123/
        ├── HEAD          # 该worktree的HEAD指针
        ├── index         # 该worktree的暂存区
        ├── gitdir        # 文本文件,记录对应工作目录的路径
        ├── logs/         # 该worktree的操作日志
        └── config.worktree # 该worktree的独立配置(可选)
第二,你创建的新工作目录根目录下,没有.git目录,只有一个名为.git的文本文件,内容只有一行:
gitdir: /path/to/main/repo/.git/worktrees/hotfix-123
Git就是通过这个文件识别出这是一个链接工作树,并找到对应的元数据和共享仓库。你在这个目录下执行的所有Git命令,最终都会操作共享的核心仓库,但状态只作用于当前worktree。
1.4 一个最容易踩的底层规则
同一个本地分支,默认不能同时在两个worktree里检出。
很多人第一次遇到这个报错都会困惑:我只是想开两个目录都看master分支而已,为什么不行?
原因就在底层设计上:分支引用(refs/heads/master)是全局共享的,只有一份。如果两个worktree都检出master分支,你在A工作树提交一次代码,master指针就往前走了一步,而B工作树的暂存区和工作目录还停留在旧的commit上,Git不会自动同步B的工作区,结果就是B工作树会出现大量"被修改"的文件,状态完全混乱。
Git为了避免这种自毁行为,默认直接阻止同一个分支在多个worktree检出。你可以用--force强制绕过,但除非你明确知道自己在做只读操作,否则绝对不要这么做。
二、核心命令逐条拆解
Worktree的命令不多,一共就6个,但每个都有不少细节和适用场景。下面按使用频率排序逐一讲解,所有示例都经过实际运行验证。
2.1 git worktree add - 创建工作树
这是最常用的命令,语法格式:
git worktree add [选项] <路径> [提交/分支]
基础用法:基于已有分支创建
git worktree add ../hotfix-202410 master
在上级目录创建一个名为hotfix-202410的工作目录,检出master分支。执行完直接进目录就能用,和正常的Git仓库没有任何区别。
如果不指定分支,默认会创建一个和目录同名的新分支,基于当前HEAD指向的提交。
创建并切换到新分支
git worktree add -b feature-order-pay ../feature-order-pay develop
基于develop分支新建feature-order-pay分支,同时创建对应的工作目录。这是开发新需求最常用的写法。
如果分支名和目录名一致,可以简化成:
git worktree add -b feature-order-pay ../feature-order-pay
省略最后的基准分支,默认基于当前所在分支创建。
分离头指针模式
git worktree add --detach ../test-v1.2.0 v1.2.0
创建一个指向v1.2.0标签的分离头指针工作树。适合临时查看历史版本、复现旧版本bug、做性能测试等场景,用完直接删掉,不会产生多余分支。
跟踪远程分支
git worktree add --track -b feature-user ../feature-user origin/feature-user
本地没有对应分支,直接基于远程分支创建并建立跟踪关系。和git checkout --track的逻辑完全一致。
如果远程分支名和本地分支名相同,可以简化:
git worktree add ../feature-user origin/feature-user
Git会自动识别并创建跟踪分支。
常用选项说明
| 选项 | 作用 |
-b <分支名> |
新建分支并检出 |
-B <分支名> |
新建分支,如已存在则重置 |
--detach |
分离头指针模式,不关联任何分支 |
--track |
建立远程跟踪关系 |
--no-checkout |
只创建元数据,不检出文件,特殊场景用 |
--force |
强制创建,可绕过"分支已检出"限制(不推荐) |
-d |
基于当前HEAD创建分离头指针工作树,简写 |
2.2 git worktree list - 查看所有工作树
git worktree list
输出示例:
/home/dev/main-project       abc1234 [main]
/home/dev/feature-order      def5678 [feature-order]
/home/dev/hotfix-202410      ghi9012 [hotfix-202410]
每行依次是:工作目录路径、当前提交哈希、当前分支(分离头指针会显示(detached HEAD))。
加--porcelain参数会输出机器可读的结构化格式,适合写脚本用。
2.3 git worktree remove - 删除工作树
git worktree remove hotfix-202410
删除指定的工作树,会同时删除工作目录和对应的.git元数据。注意几个规则:
- 只能删除"干净"的工作树:没有未提交的修改,没有未跟踪的文件
- 如果工作树是脏的,删除会失败,加
--force可以强制删除 - 主工作树不能被删除
- 路径可以写绝对路径,也可以写目录名
重要提醒:绝对不要手动删除工作目录。如果直接rm -rf删掉了文件夹,Git仓库里.git/worktrees下的元数据还会残留,变成无效条目。正确做法是用remove命令,或者手动删了之后执行prune清理。
2.4 git worktree prune - 清理失效元数据
当你手动删除了工作目录,或者工作目录在U盘上现在没插,git worktree list里还会显示这些条目。这时候用prune清理:
git worktree prune
它会检查.git/worktrees下的所有条目,验证对应的工作目录是否还存在,不存在的就删掉元数据。
常用参数:
--dry-run:预览哪些会被清理,不实际执行--expire <时间>:只清理超过指定时间的失效条目
建议定期执行,尤其是经常手动删目录的人。
2.5 git worktree move - 移动工作树
git worktree move ../feature-order ../feature-order-new
把工作树移动到新的路径,同时更新所有内部关联。注意限制:
- 主工作树不能用这个命令移动
- 包含子模块的工作树不能移动
如果手动移动了主工作树的位置,所有链接工作树都会失效,这时候需要用repair命令修复。
2.6 git worktree repair - 修复关联
git worktree repair
当你手动移动了主仓库的位置,或者移动了工作目录,导致worktree关联断裂,执行这个命令可以自动修复指针。
它的原理是遍历所有worktree的gitdir文件,重新建立正确的路径映射。
三、执行流程与状态流转
很多人对add命令的执行过程一知半解,遇到报错不知道问题出在哪。下面完整拆解git worktree add的执行流程。
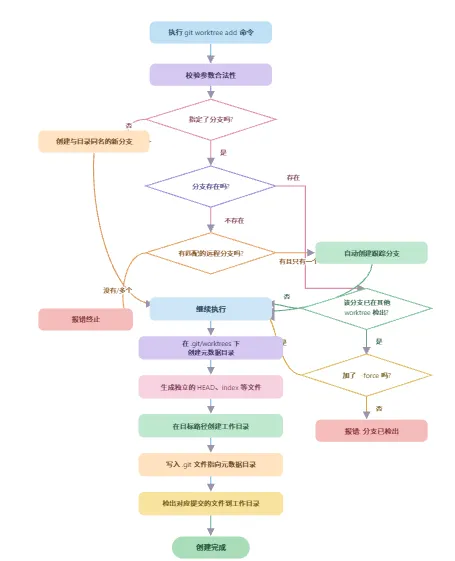
理解这个流程,遇到报错就能快速定位原因。比如报"cannot lock ref",基本就是目标分支已经在另一个worktree里检出了,先list查一下在哪,切走或者删了就行。
四、实战场景
讲完命令和原理,回到实际开发。我自己做Java微服务开发多年,下面这几个场景是worktree最能发挥价值的地方,基本都是每天都会遇到的。
4.1 紧急线上Bug修复
这是worktree最经典的应用场景,没有之一。
传统流程:
- 正在feature分支写了一半代码,先git stash暂存
- 切到master分支,等待IDE索引重建
- 修复bug,提交,打包上线
- 切回feature分支,git stash pop恢复
- 等待IDE重新索引,等待Maven重新编译
- 找回刚才的开发思路,继续写
整个过程顺利的话十几分钟,遇上大项目光编译就要十分钟,而且来回切换非常打断思路,stash用多了还容易搞混。
Worktree流程:
- 不用管当前写了一半的代码,也不用stash
- 执行
git worktree add -b hotfix-pay ../hotfix-pay master - 新窗口打开hotfix-pay目录,修复bug,提交,打包上线
git worktree remove ../hotfix-pay- 回到原来的feature窗口,代码、编译缓存、调试配置都在,接着写
全程不影响主开发环境,上下文完全保留,切换成本几乎为零。修复完删掉工作树,仓库里干干净净,不会留下多余的临时提交。
我自己的习惯是所有hotfix都用worktree做,修复合并完立刻删掉,从来不在主工作树切master分支。
4.2 多版本并行维护
很多To B的项目需要同时维护好几个版本,v1.0给客户A用,v2.0给客户B用,master开发v3.0。
以前的做法是clone三份仓库,每次有公共bug修复,要在三个仓库分别改,或者改完一个cherry-pick到另外两个,非常麻烦。
用worktree的话,一个仓库搞定:
git worktree add ../v1-maintenance v1.0-stable
git worktree add ../v2-maintenance v2.0-stable
三个版本的代码同时在硬盘上,各自独立编译独立运行,互不干扰。修复公共bug的时候,在一个版本改完提交,另外两个直接cherry-pick提交哈希就行,不用跨仓库来回导patch。
最重要的是,三个版本共享同一个objects库,比clone三份节省至少三分之二的磁盘空间。对于动辄几个G的Java项目来说,这不是小数目。
4.3 代码评审与跨分支对比
做Code Review的时候,经常需要同时看两个分支的代码差异。单纯git diff只能看文本差异,遇上复杂的重构,需要对照着看上下文,就非常费劲。
用worktree可以把两个分支同时检出到本地:
git worktree add ../feature-refactor feature-refactor
然后用Beyond Compare或者IDE的目录对比功能,直接对比两个工作目录,整个项目的结构差异一目了然。尤其是涉及到文件移动、类拆分这种大重构,比单纯看diff高效太多。
我自己评审大的PR的时候,都会开一个对应分支的worktree,直接在IDE里打开运行调试,比只看代码靠谱得多。
4.4 历史版本复现与测试
线上报了个bug,怀疑是某个版本引入的,需要在本地跑起来复现。
传统做法是git checkout切到对应tag,改完再切回来,又要经历一遍编译缓存失效的痛苦。
用worktree就很简单:
git worktree add --detach ../debug-v1.5.2 v1.5.2
直接把对应标签的代码检出到独立目录,编译运行调试,查清楚问题之后,删掉这个目录就行,主开发环境完全不受影响。
4.5 大仓库多模块并行开发
微服务项目,一个仓库里十几个模块,不同模块对应不同分支。比如你正在订单模块做需求,同时要帮同事看一下用户模块的bug。
以前要么切分支,要么另开一个clone。用worktree的话,可以针对不同模块开不同的工作树,配合稀疏检出,甚至只检出你需要的模块目录,体积更小速度更快。
五、最佳实践与踩坑指南
这些都是我用了五六年worktree踩过的坑和总结的经验,很多点官方文档不会说,但实际开发中经常遇到。
5.1 目录管理规范
- 统一命名前缀:所有worktree目录统一用
wt-开头,比如wt-hotfix-pay、wt-feature-order。这样一眼就能区分哪些是worktree,哪些是独立的项目,清理的时候也方便批量处理。 - 集中存放:不要散落在各处,统一放在主仓库同级目录下,管理起来方便。
- 用完即删:临时的hotfix、测试用的worktree,用完立刻remove,不要攒着。时间长了你自己都忘了是干嘛的,占空间不说,还容易误操作。
5.2 IDE与构建优化
- 排除索引:IntelliJ IDEA打开主项目的时候,把所有worktree目录加到排除列表里。不然IDE会把所有目录都索引一遍,又卡又占内存。
- 构建缓存共享:Maven的本地仓库是全局共享的,这点没问题。但每个worktree的target目录是独立的,第一次编译都要全量编。对于大项目,可以考虑用Maven的build cache插件,或者把target目录软链接到共享位置,节省编译时间。
- 独立运行配置:每个worktree在IDE里的端口、调试配置要分开,不要冲突。
5.3 常见坑点避坑
坑1:手动删除工作目录
很多人图省事直接rm -rf删工作目录,结果git worktree list里还一直显示。虽然不影响正常使用,但看着难受,时间长了一堆无效条目。
解决:要么用git worktree remove删,要么删完立刻执行git worktree prune清理。
坑2:子模块不同步
如果仓库用了Git Submodule,记住子模块的状态是每个worktree独立的。你在主工作树更新了子模块,其他worktree不会自动同步,每个worktree都要单独执行git submodule update --init --recursive。
坑3:同一个分支强制多开
千万不要为了图省事用--force把同一个分支开两个worktree。你在A提交代码,B的工作区不会自动更新,状态会完全乱掉,到时候各种莫名其妙的diff,排错都没法排。
真的需要同时看同一个分支的两份代码,开一个分离头指针指向该分支的最新提交就行,只读不写,安全得多。
坑4:网络盘/共享盘使用
不要把worktree创建在网络共享盘或者U盘上。Git依赖文件锁保证数据一致性,网络盘的文件锁机制不可靠,很容易出现仓库损坏。
坑5:配置共享问题
默认情况下,所有worktree共享同一份.git/config配置。你改了用户信息、远程仓库地址,所有worktree都会生效。
如果需要给某个worktree单独配置,进入该worktree目录,执行:
git config --worktree user.name "临时测试账号"
这个配置只会保存在当前worktree的config.worktree里,不会影响其他工作树。
坑6:rebase/merge状态隔离
每个worktree的合并、变基状态是独立的。你在A工作树rebase到一半卡住了,不会影响B工作树,完全可以先放着,去别的分支干活,回头再回来解决冲突。
这其实是个非常好用的特性,遇上复杂的rebase不用死磕到底,随时可以切换去做别的事。
5.4 性能与边界
很多人问worktree有没有数量限制。官方没有硬限制,我自己最多同时开过8个,没遇到什么问题。但不建议开太多,多了你自己也管不过来,反而降低效率。
和其他方案对比:
| 方案 | 磁盘占用 | 切换速度 | 代码同步 | 隔离性 | 适合场景 |
| git stash | 无额外占用 | 快(大项目慢) | 自动 | 差 | 短时间切换 |
| git worktree | 只有工作目录体积 | 秒级创建 | 自动 | 较好 | 数小时到数天并行开发 |
| 多次clone | 完整仓库体积,多份重复 | 慢 | 手动push/pull | 最好 | 长期独立版本、完全隔离环境 |
简单说:切换几分钟就回来,用stash;要并行开发半天以上,用worktree;需要完全隔离的环境,比如不同大版本依赖不兼容,用多clone。
六、高级技巧与自动化
6.1 批量清理已合并的worktree
项目分支多了,经常合并完忘了删worktree。可以写个简单的脚本,批量删除所有对应分支已经合并到master的worktree。
#!/bin/bash
# 清理所有分支已合并到main的worktree
main_branch="main"

git worktree list --porcelain | grep '^worktree ' | awk '{print $2}' | while read worktree_path; do
    branch=$(cd "$worktree_path" && git rev-parse --abbrev-ref HEAD 2>/dev/null)
    if [ -z "$branch" ] || [ "$branch" = "HEAD" ]; then
        continue
    fi

    if git branch --merged "$main_branch" | grep -q "^  $branch$"; then
        echo "Removing merged worktree: $worktree_path ($branch)"
        git worktree remove "$worktree_path"
    fi
done
定期跑一下,自动清理垃圾worktree。
6.2 配合git bisect二分查找
排查历史引入的bug时,git bisect非常好用,但它会不断切换提交,污染你的工作目录,而且你没法同时干别的。
配合worktree就很完美:开一个专门的bisect工作树,在里面跑二分查找,主工作树该干嘛干嘛。
git worktree add --detach ../bisect-debug v1.0.0
cd ../bisect-debug
git bisect start
git bisect bad
git bisect good v0.9.0
# 运行测试,标记好坏
查完直接删掉整个目录,干干净净。
6.3 裸仓库+worktree做部署
服务器上的Git仓库通常是裸仓库(bare repo),没有工作目录。可以用worktree直接从裸仓库检出指定分支到部署目录,比git clone高效得多,更新也方便。
# 在裸仓库中创建worktree到部署目录
git --git-dir=/opt/repo/app.git worktree add /opt/app/deploy-v2 v2.0-stable
更新的时候直接进入部署目录git pull就行,比每次重新clone快很多。
七、写在最后
Git Worktree不是什么高大上的黑科技,它解决的问题非常朴素——让你不用在多个分支之间反复横跳。但恰恰是这种朴素的特性,能实实在在地提升开发效率。我见过很多开发者,工作五六年了,切换分支还是只会stash和checkout,宁愿clone三五份仓库也不愿意花半小时了解一下worktree。工具是用来解放生产力的,很多时候你觉得习以为常的麻烦,其实早就有更好的解决方案。当然,worktree适合中短期的并行开发,如果你需要长期维护两个完全独立的版本,或者依赖环境差异很大,那多clone几份甚至用容器隔离依然是更好的选择。技术工具的选择,从来都是看场景。理解底层原理,知道每个工具的边界和适用场景,才能用得得心应手。最后再强调一遍:所有命令都要在理解的基础上去用,不要上来就加--force。Git的很多保护机制不是为了限制你,是为了防止你把自己搞死。



