最近我在 GitHub 上翻到一个项目:e2e,挺实用的,分享给大家。
这项目今年 7 月 22 号才建仓,到我写稿这天刚满两个半月,star 已经冲过 9000。
10 月第一周它直接起飞,我去翻了 Wayback Machine 的存档快照,10 月 1 号晚上它还只有 549 个 star,10 月 4 号晚上 2942,10 月 6 号早上 5123,10 月 7 号早上 6790。掐着快照时间算,10 月 4 号到 6 号这 33 个小时里涨了 2181 个 star,折算单日 1500 往上,一路把它顶上 GitHub Trending 第一。
这个项目,记住几个关键信息就行:
- 项目:
e2e,TesterArmy 团队开源的新一代端到端测试框架,覆盖 Web 和移动端 - 技术栈:TypeScript,Apache-2.0 协议,npm 包名就叫
e2e - 热度:9000+ star,npm 上周下载 23.8 万
- 迭代:不到三个月发到 0.19.0,最新版 10 月 9 号刚出
- 地址:github.com/tester-army/e2e
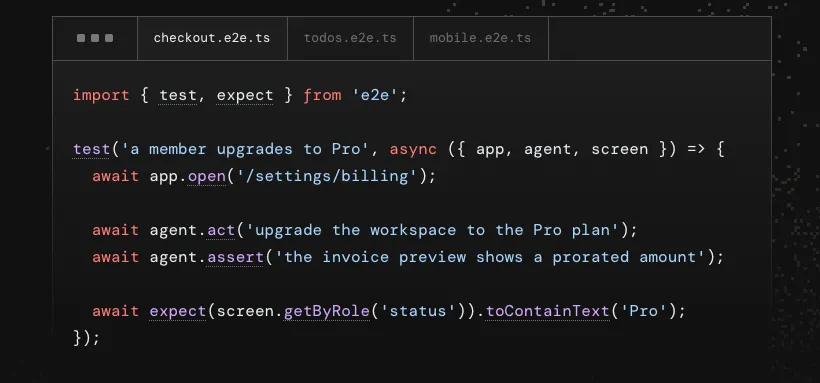
它干的事很简单,一句话概括:你用自然语言描述一个测试目标,AI Agent 驱动应用把这个目标跑完,再用传统的定位器和断言校验结果。
直接看官方示例,一段代码就看明白。
// tests/checkout.e2e.ts
import {
    test, expect } from 'e2e';

test('a member upgrades to Pro', async ({
    app, agent, screen }) => {

  await app.open('/settings/billing');

  await agent.act('upgrade the workspace to the Pro plan');
  await agent.assert('the invoice preview shows a prorated amount');

  await expect(screen.getByRole('status')).toContainText('Pro');
});
AI Agent 自己看页面、找按钮、把整个升级流程走完。走完之后,最后一行还是传统断言,比如用getByRole('status') 验证是否含有 Pro 字样。
一条测试里,AI 干 AI 的,断言干断言的。
凭什么它单日能狂揽 1500+ star
用 AI 做 e2e 测试,这两年大家多少都用过一些,但基本最后都会遇到两类问题。
第一类,让 AI 生成 Playwright 脚本,生成完就归脚本管。看着省事,老问题一点没少。UI 改一个按钮文案,一堆定位器跟着失效,CI 红一片,你还是得人工去修。AI 只在写脚本那一刻出场,后面的维护成本还是全归你。
第二类,测试本身就是一段自然语言,每次运行都让模型现场推理着把流程走完。灵活是真灵活,贵也是真贵。CI 每晚跑一遍回归,登录页一个字没改,模型也得重新看一遍、重新想一遍、重新点一遍,每次都是真金白银的 token。而且纯靠模型驱动的测试在 CI 里跑,稳定性没法看,今天过明天挂。
e2e 项目的解题思路,是让两种写法在同一条测试里各管一段。哪个步骤你写得出稳定定位器,就用传统写法;哪个步骤界面复杂、selector 难写、改动频繁,就丢一句自然语言给 agent.act()。官网有句话总结得很准,AI where it helps, code where it counts,AI 管不确定的部分,代码管必须精确的部分。
Vercel CEO Guillermo Rauch、Sentry 创始人 David Cramer、Expo 官方团队都在 X 上公开夸过它(我在它官网口碑墙上翻到的,这类背书听听就行)。大佬点赞不代表适合你,但「确定性加智能体」这个混合方向,确实被一圈人验证过值得做。
最值钱的设计,让 AI 只想一次
光混合还不够,让它从一堆 AI 测试框架里杀出来的,是回放机制。
agent.act() 第一次执行时,AI Agent 看屏幕、推理、操作,同时把每一步动作记下来。
第二次跑同一条测试,框架先检查应用有没有变,没变就直接回放上次录好的动作序列,一次模型都不调。应用改了,比如结算按钮换了位置,回放失败,才重新唤起模型再想一遍,顺便把新动作录下来,供下一次回放。
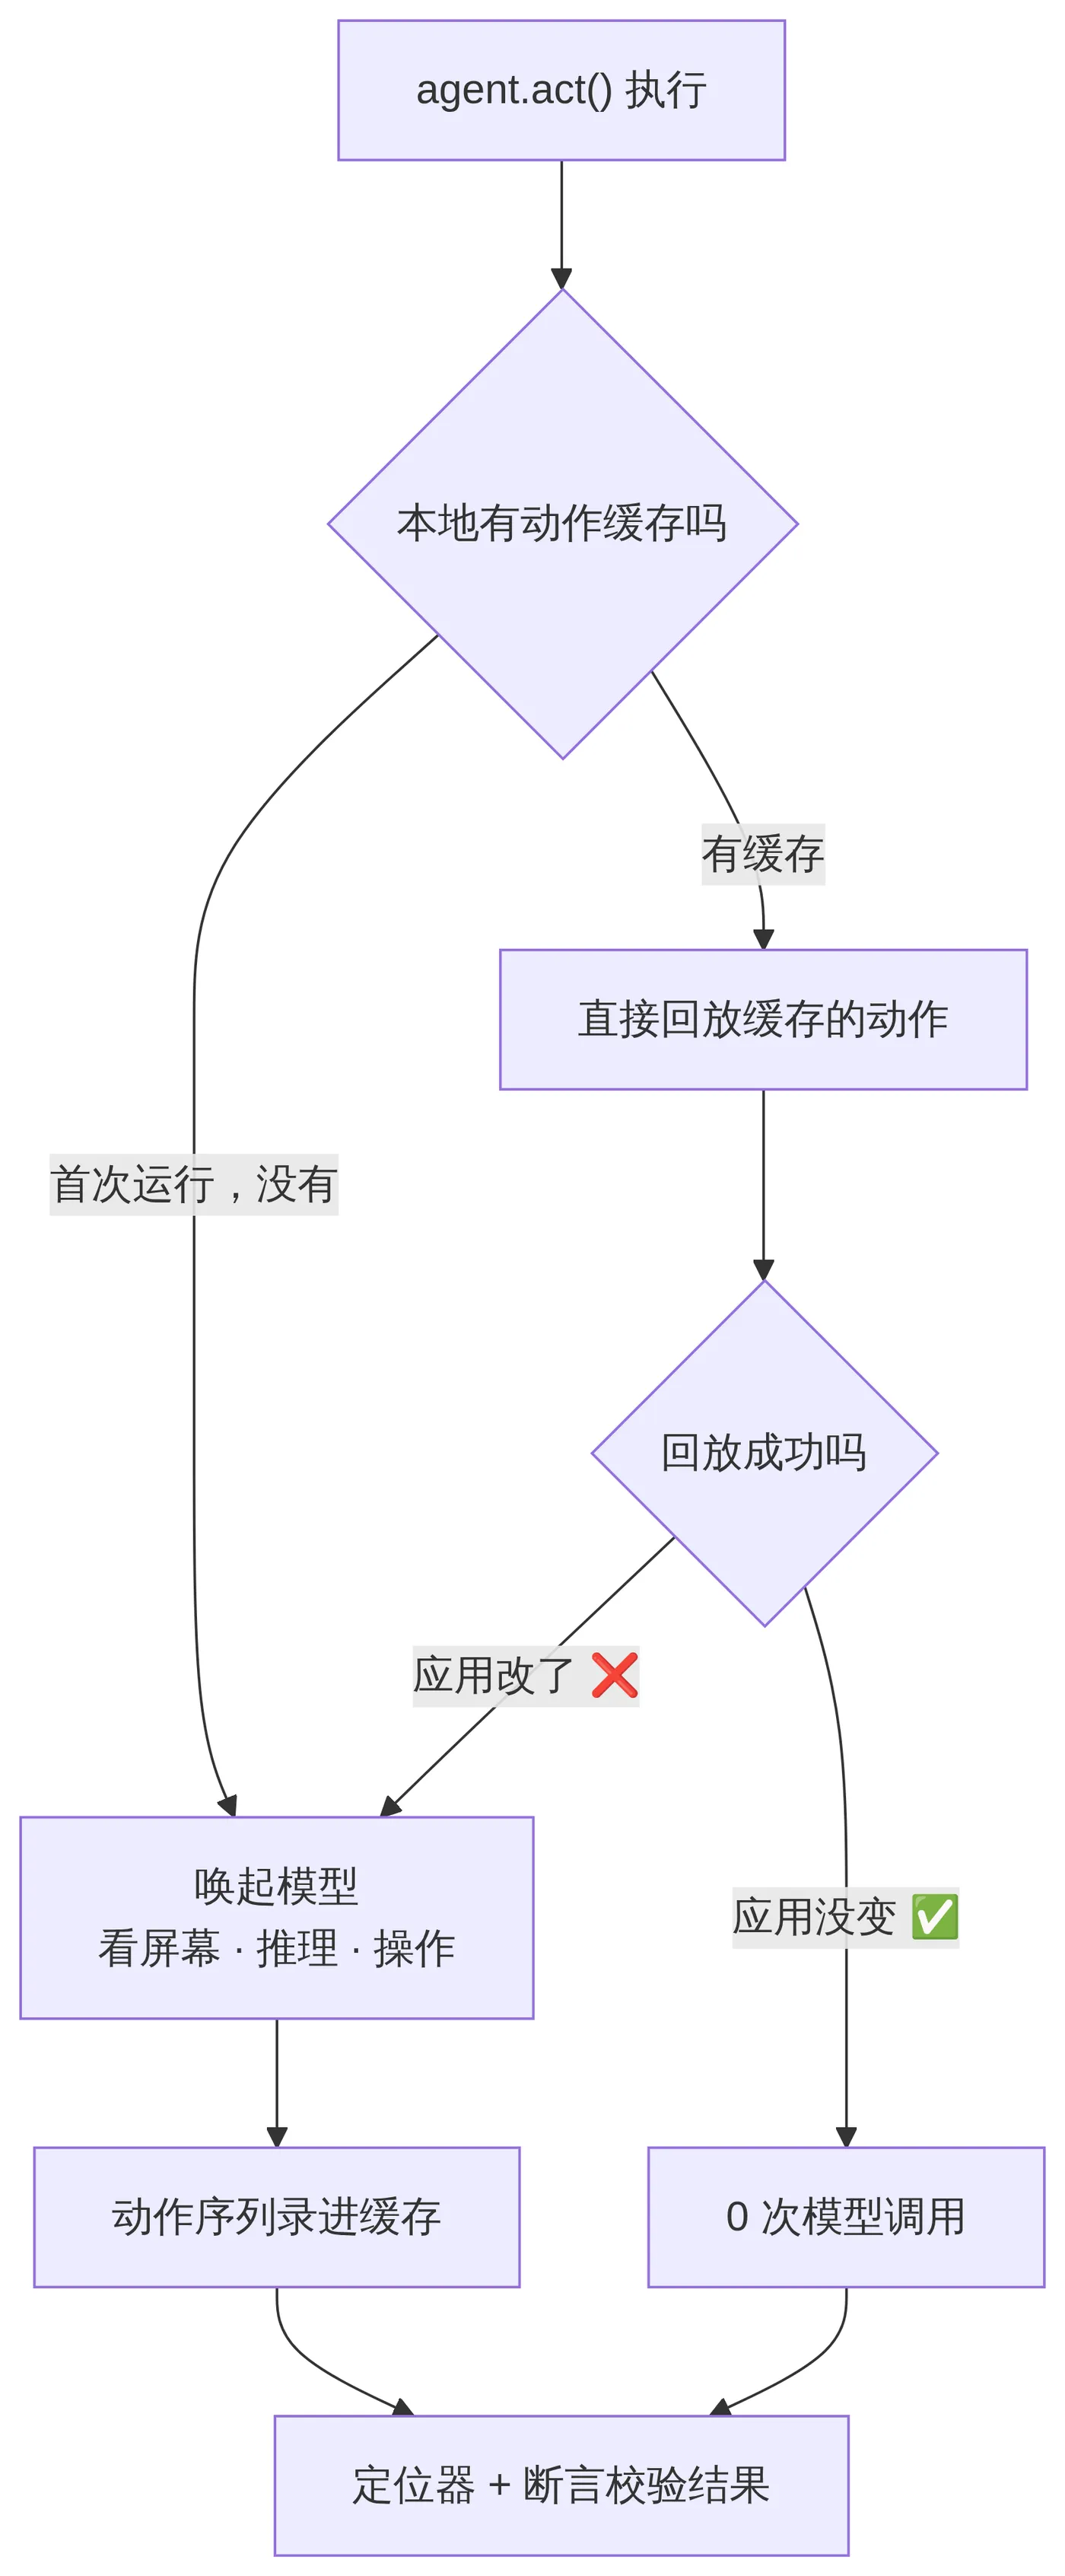
官网 FAQ 把 CI 场景说得更具体。CI 模式自动开启,规则是单次重试加只读的 trace 缓存,agent 步骤在应用没变时回放已验证的动作,全程零模型调用。
X 上有条评论被顶得很高,原话大意是,一个没改过的登录页,不该每次 CI 跑的时候都让模型重新审一遍。假设你的回归套件里有 50 条带 agent 步骤的测试,这周只有 2 条涉及的界面改过,那你只为这 2 条付模型的钱,剩下 48 条按普通脚本跑,免费。
还有一条隐含规则。测试里压根没写 agent 步骤的,整个框架就退化成一个普通测试跑器,一个 token 不花。所以你可以渐进式迁移,一条测试一条测试地往里加 AI 步骤,不用一步到位。
快速上手
前面讲的都是设计,落到自己动手,从装到跑通只有两条命令。
安装命令:
npx e2e init
用 pnpm、bun 的换成
 pnpm dlx e2e init
 bunx e2e init
安装时向导会问两件事,引擎选 Web 还是 Mobile,模型来源选订阅、API key,或者选 None 先不接 AI。
选完它把 e2e.config.ts 配置写好
import type {
    E2EConfig } from 'e2e';
import {
    web } from '@e2e-dev/web';
import {
    gateway } from 'ai';

export default {

  agents: {
    default: {
    model: gateway('openai/gpt-6-luna-fast') } },
  targets: [{
    engine: web(), app: {
    url: 'http://localhost:3000' } }],
} satisfies E2EConfig;
还有一条示例测试tests/example.e2e.ts和依赖一次性写好,已有的文件不动。
import {
    test } from '@e2e-dev/web';
import {
    expect } from 'e2e';

test('app opens', async ({
    app, browser }) => {

  await app.open('/');
  await expect(browser.locator('body')).toBeVisible();
});
环境上有个门槛,Node 要 24.8 以上(22.22.3 以上也行),Windows 得在 WSL 里跑,测移动端还得本机装了 Xcode 的 iOS 模拟器或 Android SDK 的模拟器。
运行命令,直接输入:
npx e2e run
第一次跑它会自己下载浏览器或启动模拟器,检查你的应用能不能打开,打印结果。
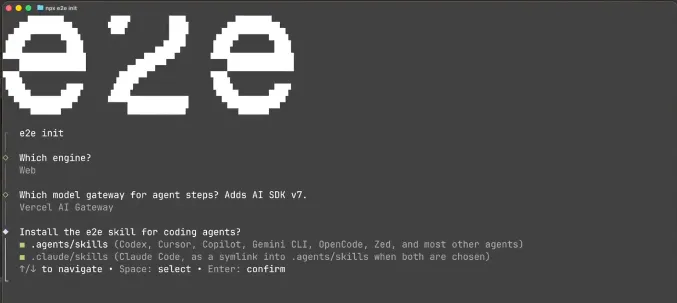
这条示例测试不调模型,一行 key 都不用配就能跑通。先让框架在你机器上活起来,接模型、加 agent 步骤都是之后的事。
装完看 node_modules,里面多出一串 e2e 和 @e2e-dev/ 开头的包,官网文档列了张表说明各自是干嘛的。
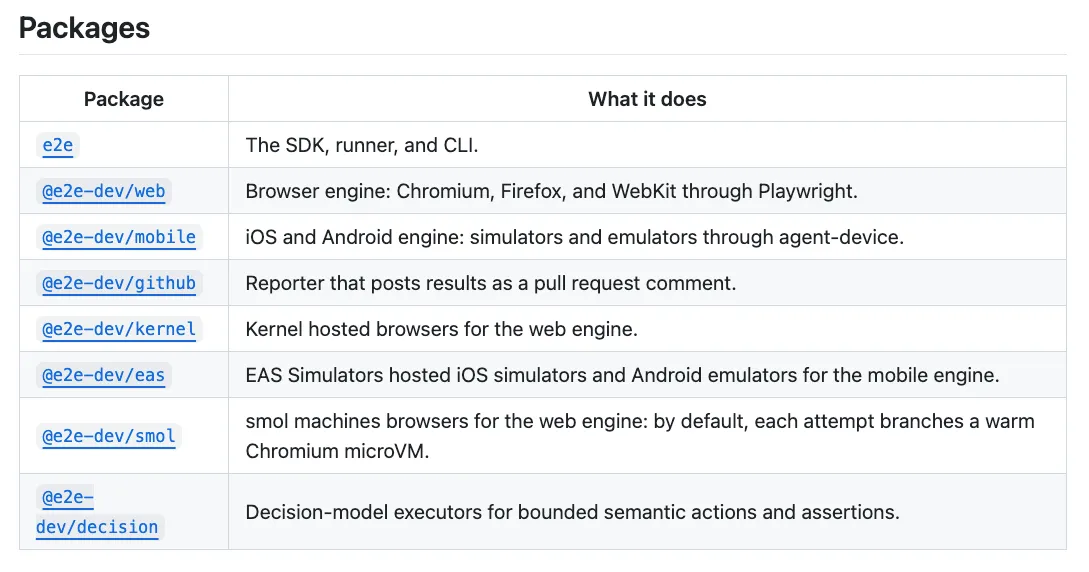
新手记住前三个就够用。
e2e是主包,SDK、测试跑器、CLI 三合一。@e2e-dev/web是 Web 引擎包,底层 Playwright。@e2e-dev/mobile是移动端引擎包,驱动 iOS 和 Android 模拟器。
init 时选了哪个引擎,向导就给你装哪个。剩下几个按需再用。
@e2e-dev/github是个 reporter,把测试结果自动贴成 GitHub 的 PR 评论。@e2e-dev/kernel、@e2e-dev/eas、@e2e-dev/smol是三个云端托管件,分别提供托管浏览器、EAS 托管模拟器、预热好的 Chromium 微虚拟机,本地跑测试碰不到,等测试要搬上云端再回头查。@e2e-dev/decision是决策模型执行器,管有边界的语义动作和断言,属于进阶用法。
简单上手记住这些就够了,npx e2e init 进门,npx e2e run 见绿,后面所有进阶都是从这两条命令长出来的。
模型支持订阅和API两种模式
模型接入这块它做得很克制。e2e init 的时候让你选模型来源,支持四种接法:
- 登录你已经付费的 ChatGPT、GitHub Copilot 或 SuperGrok 订阅
- 走 Vercel AI Gateway 或 OpenRouter 的 key
- 直连 OpenAI、Claude、Gemini、DeepSeek 这些厂商的 API
- 指到本地模型服务上
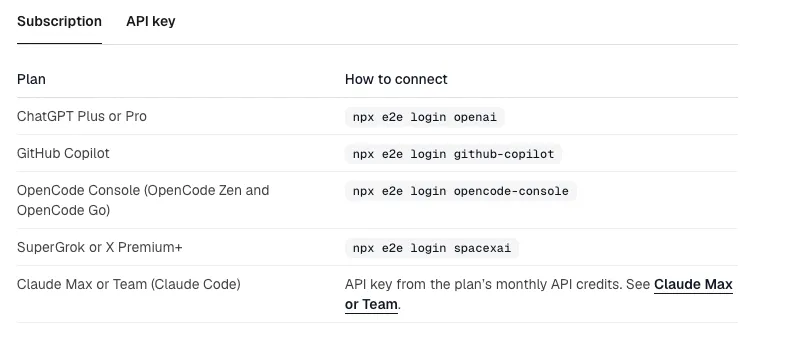
官方口径是 e2e adds no markup,框架本身不加价,token 花多少是模型的事。
这一条对国内团队其实很关键。订阅制的 AI 工具大家手里多少有几个,测试框架能直接复用这些订阅,等于增量成本近乎为零,比专门为测试开 API 充值好接受得多。
配置长这样,引擎、模型、agent 的系统提示词都收在一个 e2e.config.ts 里。
import type {
    E2EConfig } from 'e2e';
import {
    web } from '@e2e-dev/web';
import {
    gateway } from 'ai';

export default {

  targets: [{
    engine: web(), app: {
    url: 'http://localhost:3000' } }],
  agents: {

    default: {

      model: gateway('openai/gpt-6-luna-fast'),
      system: 'You are a QA testing agent.',
    },
  },
} satisfies E2EConfig;
agent 的系统提示词全开放,你可以把它调教成一个特别较真的 QA,也可以按自家业务约定操作边界。凭证和测试代码是分开的,secret 只放环境变量,配置里引用名字,运行时才注入,模型看不到值,也不会泄进测试报告。
Web 和 Mobile,一个 API 全包
浏览器这边,底层就是 Playwright,Chromium、Firefox、WebKit 三个内核都支持。
import {
    test } from '@e2e-dev/web';
import {
    expect } from 'e2e';

test('a visitor signs up for a trial', async ({
    app, agent, screen }) => {

  await app.open('/');

  await agent.act('sign up for a free trial as {name} with email {email}', {

    params: {
    name: 'Ada Lovelace', email: 'ada@example.test' },
  });

  await agent.assert('the welcome screen greets Ada by name');
  await expect(screen.getByRole('status')).toContainText('trial');
});
移动端是 @e2e-dev/mobile 包,驱动 iOS 模拟器和 Android 模拟器。
import {
    test } from '@e2e-dev/mobile';
import {
    expect } from 'e2e';

test('the agent opens General', async ({
    agent, app, device }) => {

  await app.open();
  await agent.act('open {section} settings', {
    params: {
    section: 'General' } });

  await agent.assert('the General settings screen is showing');
  await expect(device.locator('role=NavigationBar id=General')).toBeVisible();
});
关键在统一。同一套 test、expect、agent.act() 写法,换个引擎配置就从 Web 测试切到移动测试,断言和夹具都是同一批。
npx agent-device doctor      # the toolchain, the daemon, the booted devices
npx agent-device daemon stop # after a wedge: drops every session, the next run starts the daemon
xcrun simctl shutdown <udid> && xcrun simctl boot <udid>
从别的框架迁过来也有官方指南,覆盖 Playwright、Cypress、Selenium、Detox、Maestro,思路是定位器和断言基本原样平移,最脆的那部分 selector 换成 agent 步骤。跑挂了会给你一份报告,精确到失败步骤,带截图、trace 和日志,--headed 或 --debug 重跑可以盯着看。
AI Agent 写、AI Agent 跑、人审结果
这项目有个细节值得提一下。官网首页摆了两条安装命令,给人用的是 npx e2e init,给 AI Agent 用的是 npx skills add tester-army/e2e。
它还把整套文档直接打进 npm 包,路径在 node_modules/e2e/docs,Coding Agent 装好包就能离线读,不用联网查。配合上面那条 skill 安装命令,你在 Claude Code、Codex 里让 AI Agent 写 e2e 测试,它对这个框架的理解是原厂直供的。
把这几个点连起来看就明白了,这框架在设计上就奔着「AI Agent 写、AI Agent 跑、人审结果」的流程去的。测试工程师的角色从写脚本,挪到定目标、审断言、看报告。
泼点冷水
热闹归热闹,几个现实问题得摆出来。
版本号 0.19.0,官方自己挂着提示,奔 1.0 的路上 minor 版本之间 API 和配置都可能变。现在就把核心回归套件押上去,要有跟着改代码的心理准备。
agent 步骤第一次执行是真烧 token,界面越复杂烧得越多,有用户在 X 上提醒过要盯着消耗。回放机制能把长期成本打下来,但首次全量铺开时,账单会有一次爬坡。
还有一层,TesterArmy 是家公司,商业产品是跑在 PR 上、按计划定时执行自然语言测试的平台。开源框架是地基,楼上盖什么、收不收费,看后续。框架本身 Apache-2.0,这层目前是干净的。
写在最后
我的看法,工具可用可不用,思路可以学走。
一条是「让 AI 只想一次」。回放机制把模型调用从每次执行都付钱,变成只有变化才付钱,这个账任何用 AI 做测试、做自动化的团队都算得过来。就算你不用 e2e,自己给 agent 步骤加一层动作缓存和回放,收益立竿见影。
另一条是「混合比纯血好用」。确定性断言保住 CI 的稳定,agent 步骤吃掉写不出 selector 的那部分界面,两边各干各的活。纯脚本和纯 agent 都算走极端,中间那块才是大多数项目真正的落点。
项目地址放这,感兴趣的自己翻。
GitHub:github.com/tester-army/e2e
官网: tester.army/e2e