
前言
这是一份 文字整理,从 VLA 的基本定义和硬件基础讲起,沿着 RT-2、OpenVLA、π0 的发展线,把输入输出、网络架构、训练数据、强化学习和世界模型都串在同一条线上,让你看清机器人是怎么从「看懂画面」走到「真正把事情做完」的。
部分内容以及截图来源于:https://v.douyin.com/mUcgRebkPzQ 博主【可lip】的抖音作品,非常非常优秀的一个抖音具身智能博主。 原视频较长,该博客提供文字版简短总结,也算是我自己的学习笔记。 任何总结、解读无法代替原视频,如果有时间和心力,还是建议大家前往观看博主的原视频!。
1. VLA 是什么
1.1 三个字母:视觉、语言、动作
VLA 三个字母分别是 vision、language 和 action。顾名思义,它的输入就是这三样东西。
vision 是相机拍到的画面,一般有 2 到 3 个相机。language 是我给它的指令,比如我告诉机械臂「你要把这件衬衫给叠起来」。action 是机器人自己每个关节当前的状态。
以这三点作为输入,输出就是这个机器人的动作。这个动作并不是一句话或者别的什么,它是一串数字,代表接下来机器人的每个关节应该运动到哪些角度。做完这个动作之后,相机再拍一帧,然后重复这样的过程,我们就用 VLA 这个模型控制住了整个机械臂。
2. 硬件基础:机械臂上的那些名词
2.1 自由度、关节与编码器
拿一台 UR5E 单臂机械臂做例子,它有 6 个自由度,也就是 6 个能独立转动的关节。每个关节里有一个电机,还有一个编码器,编码器可以读到当前传感器的位置,然后传送给后端的大模型。自由度其实就是由它的 XYZ 坐标,再加上三个不同的仰角等等决定的。
2.2 夹爪、相机与底座
机械臂末端还有一个夹爪,英文叫 gripper,它的开合可以用 0 到 1 之间的数字表示。
一般的机械臂手腕上都会装相机,叫腕部相机,它会跟手一起动,专门看手里现在抓的是什么东西。在机械臂旁边还会有一个固定机位的相机,看整个全景。另外还有底座,底座上有控制器,负责这个臂怎么移动等等。
2.3 赫兹:动作频率为什么重要
还有一个词是频率,赫兹。赫兹的意思是机械臂每秒要发几条动作。比如 50 赫兹,基本就是每 20 毫秒做一个动作。
这个赫兹其实非常重要。一般低赫兹的机械臂,动作就是一顿一顿的。像叠衣服这种动作,一顿一顿地做,衣服都掉了还没叠起来。所以赫兹带来的流畅度,是能不能做精密操作的一个关键。
3. VLA 的输入长什么样
3.1 三张 RGB 图加本体状态
具体到一个双臂平台,模型每一步首先拿到的是 RGB 图,三张左右:左右手腕各一张,加上最上面那个总览相机一张,一共 3 张 RGB 图。
然后是本体状态,也就是模型得知道当前各个关节处在什么位置。它一般是一个 18 维的向量:左臂 6 个关节(XYZ 加上 roll、pitch、yaw 等等),右臂 6 个,再加上两个 gripper 夹爪各一个 0 到 1 的数字,剩下的还有底盘、升降躯干等等。一般就用这 18 维来代表当前机械臂的状态。
4. 训练数据的格式
4.1 一个 episode 有多少帧
一个完整的演示叫一个 episode。比如叠一件衣服需要 30 秒,如果机械臂是 50 赫兹,那总共就是 50 乘 30,等于 1500 帧。
每一帧需要三样东西。 第一是图像,也就是左臂、右臂和背部三张图。 第二是文本指令,比如「我要叠衣服」。这里要注意,相对于大语言模型来说,VLA 任务的文本是非常稀疏的,一般 30 秒的动作就只有一句指令,在 π0 里面并没有非常细致的标注。 第三是当前的状态,就是刚刚讲的 18 维向量,再加上这 30 秒里每一帧动作的下一个 action,也存起来。
4.2 训练时的监督方式
训练的时候,一般会取一个样本,然后用它后面 50 步来作为监督。这基本上就是数据格式的存放方式和训练范式。
5. 发展脉络之一:RT-2
5.1 第一篇正式的 VLA 文章
第一篇正式讲 VLA 的文章,是 Google DeepMind 机器人组做的,叫 RT-2。这篇论文有 50 多个作者。 大家可以重点记四个人的名字,正是这四个人做完这篇之后离开了 Google,创办了后来做 π 模型的 Physical Intelligence。
5.2 把动作当成文字来输出
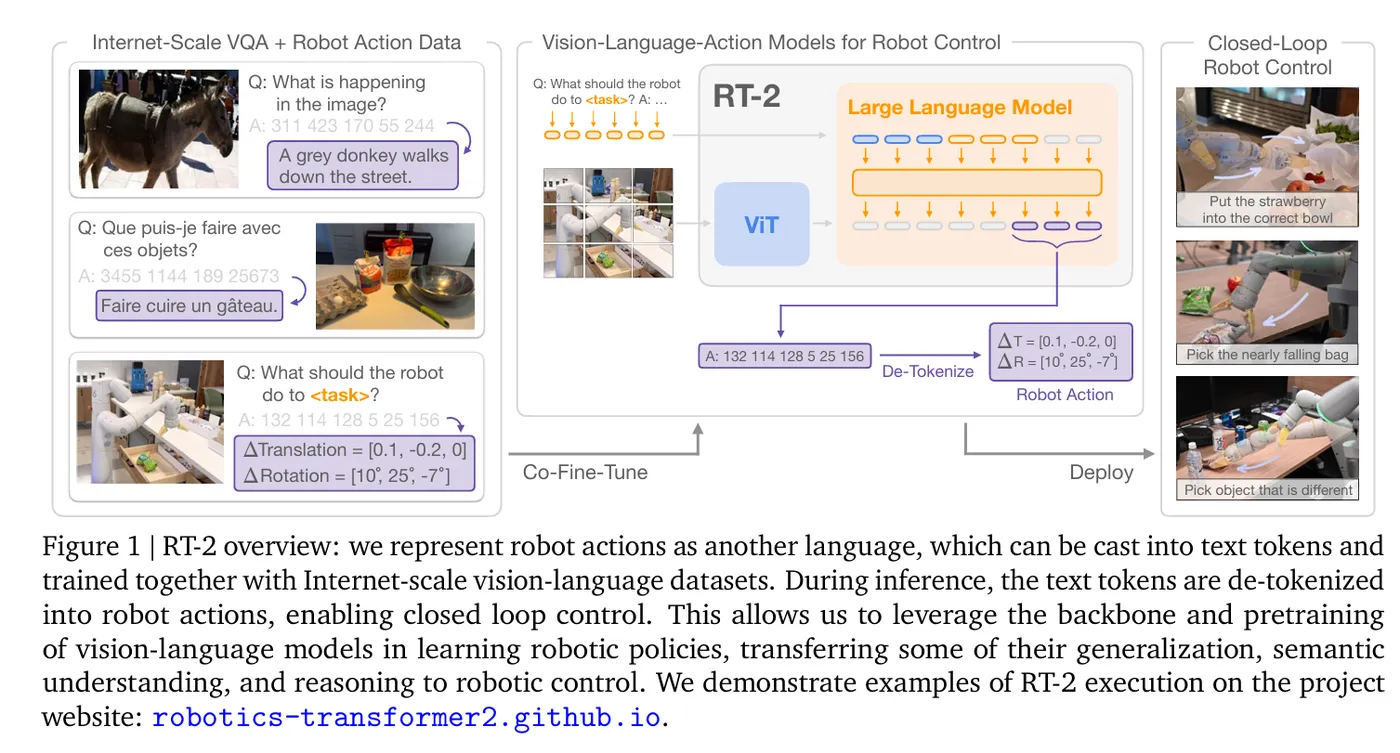
RT-2 干的事情,是第一个用大语言模型直接输出机器人的动作。它的做法现在看非常简单:把动作当成文字来输出。
具体做法是把动作离散成 8 个整数,其中一个代表结束位,三个是末端位置的增量,还有三个是旋转的增量(当时只用于单臂机械臂),再加上一个夹爪 gripper。然后把每一维切成 256 个桶,把原来连续的动作变成离散值,再拿一个现成的视觉语言模型——当时用的是 Google 自己的 PaLM-E——给它一段文本,告诉它机器人接下来该做什么,让它像回答问题一样把这 8 个数写出来。本质上就是像 LLM 一样,只不过输出的是机器人的动作,而且不添加任何参数。
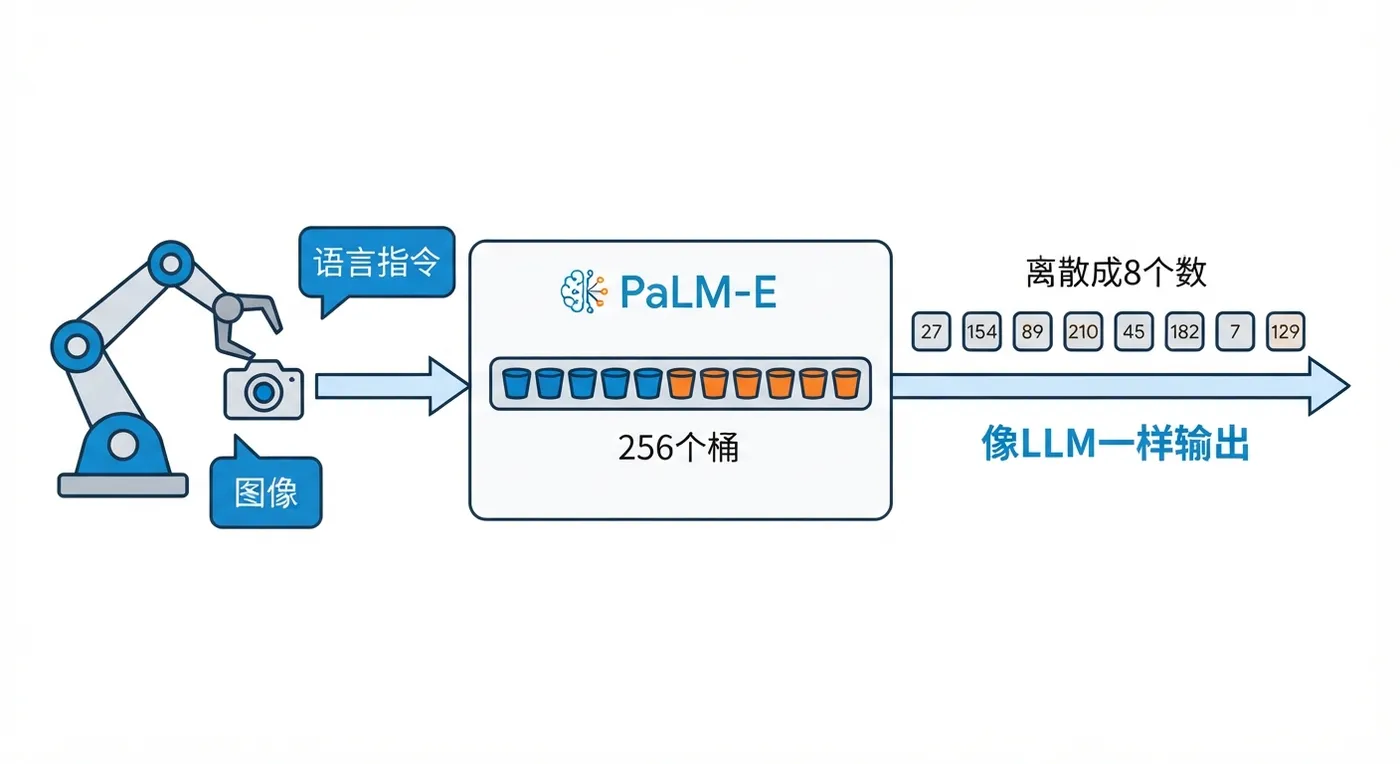 RT-2 将连续动作切成256个桶变成整数,让语言模型像答题一样写出动作。
5.3 混着网页数据一起训,但慢得没法用
训练的时候,它把网页上的图文问答数据和机器人数据混在一个 batch 里一起训练。
它的性能确实挺高,但问题是非常慢。当时是 55B 的模型,每秒居然只能出 1 到 3 个动作,也就是 1 到 3 赫兹,这根本没法用。而且 Google 出的模型、数据、测评平台全部闭源,大家根本复现不了。
但它基本是第一个提出用大语言模型来做 action 这件事的工作,所以可以叫它 VLA 之父。VLA 这个词,应该也是在这篇文章里第一次被提到。
6. 发展脉络之二:OpenVLA
6.1 斯坦福牵头,把这条路跑通并开源
接下来第二篇是同样很著名的 OpenVLA,由 Stanford 牵头,作者里有一大堆著名机构的人,UC Berkeley、Google、MIT 等等,也包括著名的 Fan、Chelsea Finn。
他们其实就是把刚刚那条路径跑通、跑得更好,并且完全开源出来。所以这个工作基本是所有后面做 VLA 都要比的 baseline,因为它是开源的,从训练数据到模型全部可以无缝复现。这里也感叹一下开源的重要性。
6.2 架构没变,换上了更强的组件
它的范式完全没变,和 RT-2 是同一个范式,只是加了一个视觉编码器,用的是 SigLIP 加 DINOv2 两个视觉编码器拼在一起。语言模型用的是当时最火的 Llama 2 7B。
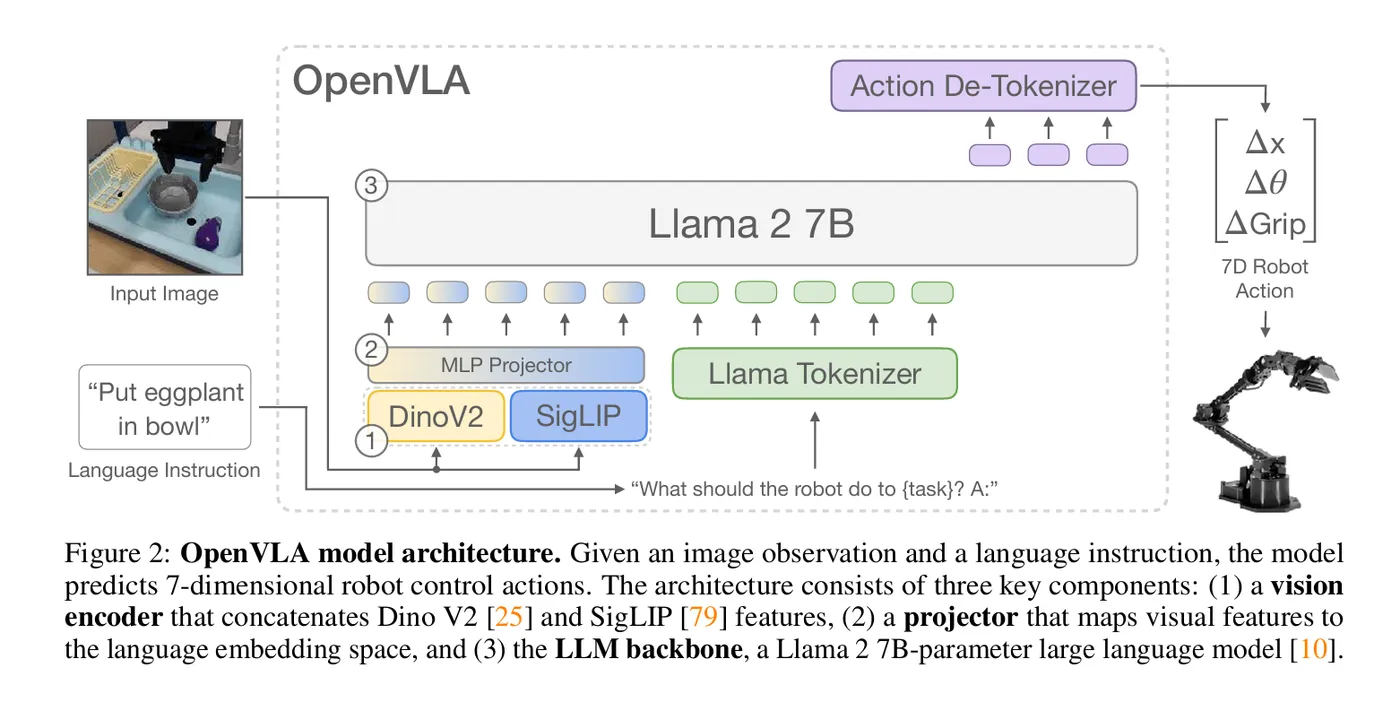
输入同样是一张图片加一句指令,输出一样是 7 个动作 token,每一维都是 256 个桶。算 loss 的时候,就算这 7 个动作的交叉熵。
6.3 97 万条轨迹、64 张 A100 跑 14 天
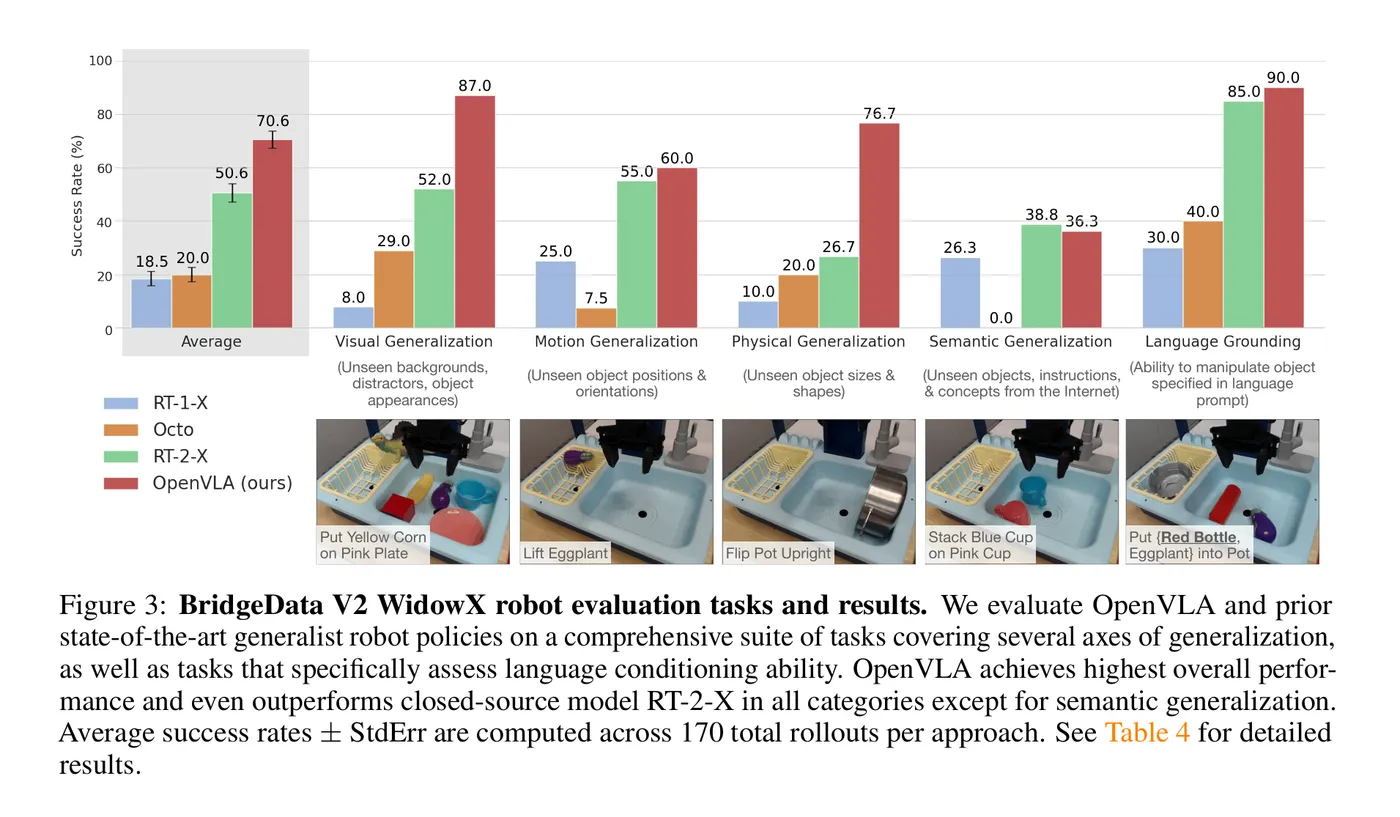
当时训练数据用了 97 万条轨迹,宣称是 64 张 A100 跑了 14 天。最后结果是在 Bridge 平台上跑了 70.6%,这在当时应该算非常高了,超过了 RT-2 那个 55B 的大模型。
而且它还给了微调的方法,让所有高校实验室都可以非常简单地在单张卡上微调 OpenVLA 模型。所以虽然架构没变,但它开源了,数据、模型全部内容开源,而且保留了一条非常重要的框架。
7. 前两代的共同问题
那么刚刚这两个工作存在什么问题?可以分析一下。
第一,因为它用的是 LM 的推理架构,每次推理只出一步动作,这就导致推理非常慢,控制频率非常低,最高只能 6 赫兹。一般好的机械臂能到 50 赫兹,它根本用不了。
第二,离散化也非常致命。动作本来是连续的,强行离散成 256 个 bin 之后,精度就会出问题。
第三,是单图,而且没有本体状态,没有记忆,没有历史。这可能受限于当时的计算资源和语言模型的能力。
8. 英雄登场:Physical Intelligence 与 π0
8.1 公司背景与融资节奏
接下来英雄登场,我们介绍 Physical Intelligence 这家公司,以及它的 π0。
先科普一下背景。Physical Intelligence 在 2024 年 3 月成立于旧金山,创始人就是 RT-1、RT-2 的那四位作者,再加上另外一些投资人。当时种子轮融了 7000 万美元。
π0 是他们的第一个模型,2024 年 10 月发布,发布之后 11 月马上 A 轮融了 4 亿美元,当时估值 24 亿。2025 年 2 月,他们把 π0 的整个数据和模型全部开源,并成立了一个公开社区叫 Open π。4 月发布了 π0.5,11 月发布了 π0.6。同月,也就是 11 月,B 轮融了 6 亿美元,现在估值 56 亿。到今年 4 月又发布了 π0.7。
Physical Intelligence 可能是具身智能公司里,startup 里面最早的一批,也是最成功的一批创始公司。
8.2 论文本身值得一读
另外再说一点,π0 它的 inner 写得非常大开大合、荡气回肠,但又非常实在,还有一些浪漫主义特色,而且写得非常清楚。我觉得从论文角度来讲,它也是一篇好论文。
它首先分析了当前 VLA 的三个问题。 第一是训练规模不够,RT-2、OpenVLA 归根到底数据量规模不够,白扯。 第二是架构不对,像之前那样跟 LM 一样,单崩,像崩大豆一样一个动作一个动作往外蹦,这个动作就没法搞高频 第三是配方也不对。
所以正式的 VLA 就从这三个方面,提出了自己完整的一套新方法。
8.3 数据:90 多万个时间步,1 万多小时
先看数据。π0 的一个训练样本就是一个时间步,一帧后面接 50 个动作,这是规定的。它自采了 903000 个时间步,单臂有 106000,双臂有 79700。这个数据量在当时是非常可怕的,加起来有 1 万多个小时,包含 7 种机器人的构型、68 类任务。所以这个数据量跟前两个完全不是一个量级。同时它也基本都开源了,这是非常难得的事情。
π0 自采90.3万个时间步,覆盖7种机器人构型与68类任务,量级远超此前工作。
8.4 数据从哪来:遥操与类别加权 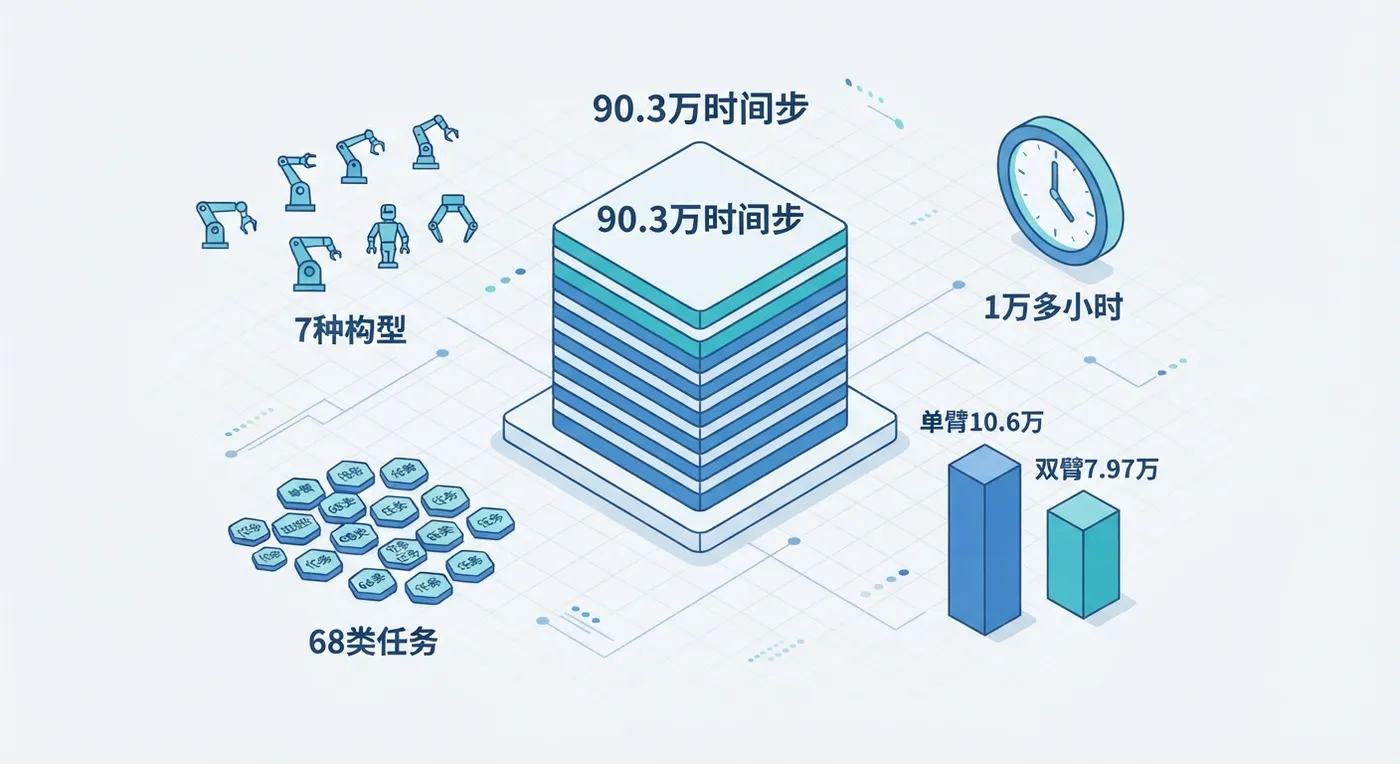
这里再科普一下,一般训练机器人的数据都是怎么来的。
第一部分基本全部是人类的遥操数据。什么叫遥操数据?一般机械臂你可以理解成带一个遥控器,操作员带着机器人做任务,用遥控器遥控机器人叠衣服、拿杯子等等。系统会录下当前机器人的画面、关节角,还有当时人类发出的命令。动作就是人的命令,状态就是机器人的反馈。
第二个特点是,刚刚讲的 68 类其实是非常大的类,并不是说你拿不同种类的杯子就算不同的类,不是这样。这 68 类是真的真实世界非常重要的 68 类数据,类别包含非常多。
第三步是它会给数据加权,保证每一类的数据量都差不多。
8.5 架构:3B 视觉语言模型加一个 3B 的 action expert
再来看 π0 的架构,其实和之前的大差不差。
左边是一个 Google 开源的 3B 视觉语言模型,叫 Gemma,Gemma 1。图像编码用 SigLIP,是一个 4 亿参数的图像编码器。把三个图像同时编码之后,混合上文本一起送到 Gemma 里面。这一步和之前大差不差。
最重大的区别是加了这个 action expert,它只有 3B 参数。你可以把这个 action expert 理解成一个扩散模型的扩散头。以前的范式更像 LM,是单崩、一个 token 一个 token 往外蹦的;但这个 action expert 是以 flow matching 为基础、以扩散模型为基础的,一口气就把这 50 个动作完全扩散出来。所以它中间会经过多次去噪。我们可以理解成:用 LM 作为基准,同时接了一个扩散模型头,来输出 50 步动作。这个架构非常有用,现在基本上是 VLA 的范式,也是 π0 的标志性范式。后面我们会分析为什么要这样做。
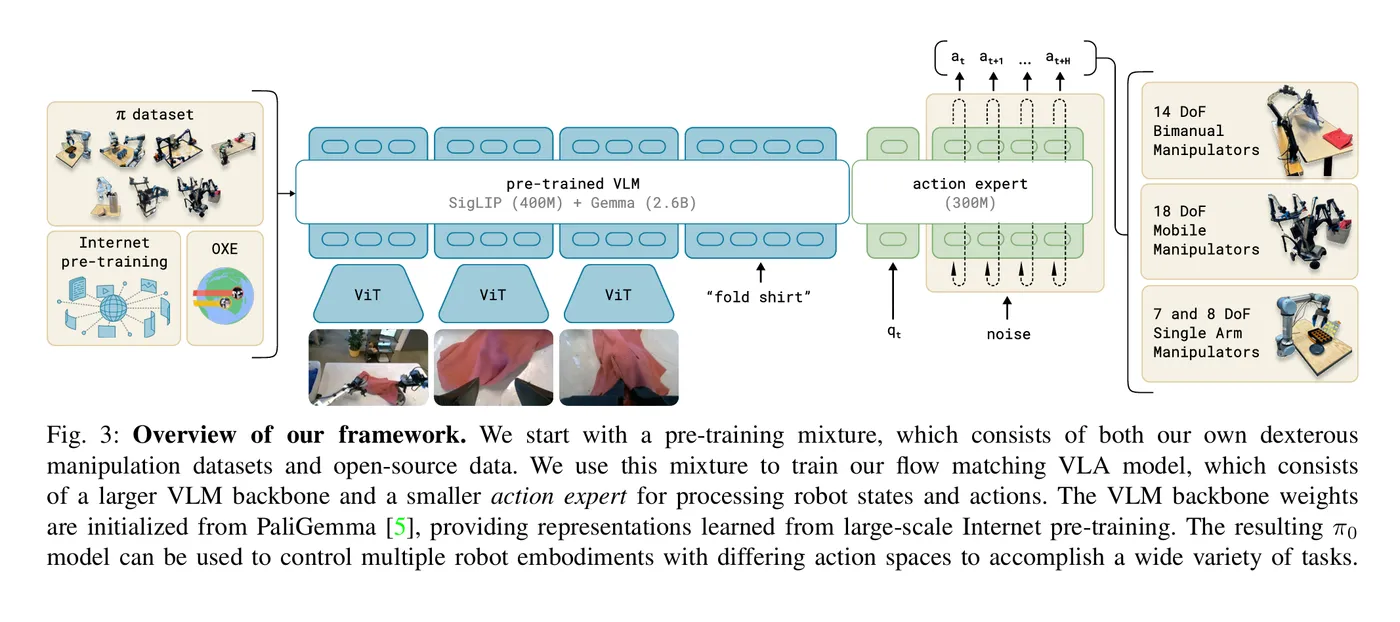
整个 token 表示上,前一部分叫 prefix token,可以用 3 张图加上语言指令,放在前面。之后有一个 QT token,QT 就是当前机械臂的状态。然后 action expert 负责最后这个部分,进行 N 步去噪,去噪完成就是一整段动作。这是它的整个架构。
8.6 训练配方:预训练加后训练
接下来看训练配方。之前的都是一步,π0 的训练配方其实是借鉴了 LM 的训练方式。LM 是先 pre-train,大量预训练之后再进行后训练。π0 一样,分两步。
预训练的时候,把刚刚讲的那一整锅数据全部喂进去,目的是尽可能覆盖更多的任务、更多的场景、更多的机器人。这些数据其实并不是很干净。
后训练的任务,是筛选出一部分高质量的数据,专门做模型微调,最简单的有 5 个小时,最复杂的可能有 100 多个小时,目的是让做这个任务的时候更加流畅、更加一致。
为什么要分成这两段?π0 论文里的说法是:只用高质量的数据,学不会犯错以后怎么恢复,因为高质量数据完全没有错误。而杂的预训练数据里面可能有很多错误数据,模型就可以根据这些错误学到如何恢复正确的动作。这也是为什么 π0 模型有错误恢复机制——一个动作做错了,它可以复原回来。
8.7 为什么用扩散模型:动作分布是多峰的
接下来分析 π0 为什么成功,有几个特点。
第一个特点,为什么要用扩散模型,而不直接用交叉熵或者 L2 loss 去回归动作?因为 π0 认为机器人的动作分布和 LM 不一样,机器人的动作分布是多峰的。比如任务是绕过碗去拿盘子,从上面绕和从下面绕都对,都能拿到,我不管你怎么拿,而且人的演示里这两种可能都有。如果你用单峰的方式,直接用 L2 loss 回归,它很有可能陷入这两种动作的一种平均,而这两条平均下来是一条直线,可能直接穿过碗,就会导致失败。随着数据规模扩大、采的数据越来越多,这种多解问题会越来越多。所以单一任务其实是有无数条路线可以达成的。我们需要一个能表示整条 50 步联合分布的输出头,采样的时候要么整条走上面,要么整条走下面。这就是为什么要用联合分布的扩散模型方法,而不是直接用 L2 loss 回归某一条轨迹——因为这是一个多峰分布。
8.8 flow matching 与注意力掩码
然后是注意力机制。整个输入是三个块:第一个是图像和文本块,第二个是本体状态块,第三个是动作块,也就是最后要求的那个块。它的 attention mask 保证只能往前看,也就是块内部可以随便看,但块跟块之间只能往前看。
也就是说,预训练的图文数据看不到后面的 action 和本体状态。为什么?因为 Gemma 这个模型训练的时候就没见过机器人动作,如果训练时让它大量去看这些奇奇怪怪的机器人动作,会导致训练非常困难,它看不懂。所以我做一个挡板,挡住图文这个块的时候,就不要去影响 Gemma 本身的预训练知识。反过来,本体状态和每个带噪的 action,是能看到前面这些东西的,因为我做动作肯定需要前面的知识。这就是它的 attention 机制。
8.9 KV cache 复用与 action chunk
第四个特点是可以复用 KV cache。因为它是扩散模型,扩散模型要推理多步,这里 π 使用的是十步推理。但图文状态这 800 多个 token,也就是前面那一长条 token,推理的每一步都不变,而且 mask 保证了它们不受动作 token 的影响——因为有 mask 存在,动作怎么变它都看不到。所以每一层的 K 和 V 都可以复用。也就是说我只要算一次前面这些 token 的 K 和 V,只需要算后面 50 个动作的 token,这样就可以复用前面 800 个 token 的 K 和 V,省下非常大的计算量。如果没有 cache,前缀也要算十遍。
这就是 π 模型的四个特点。
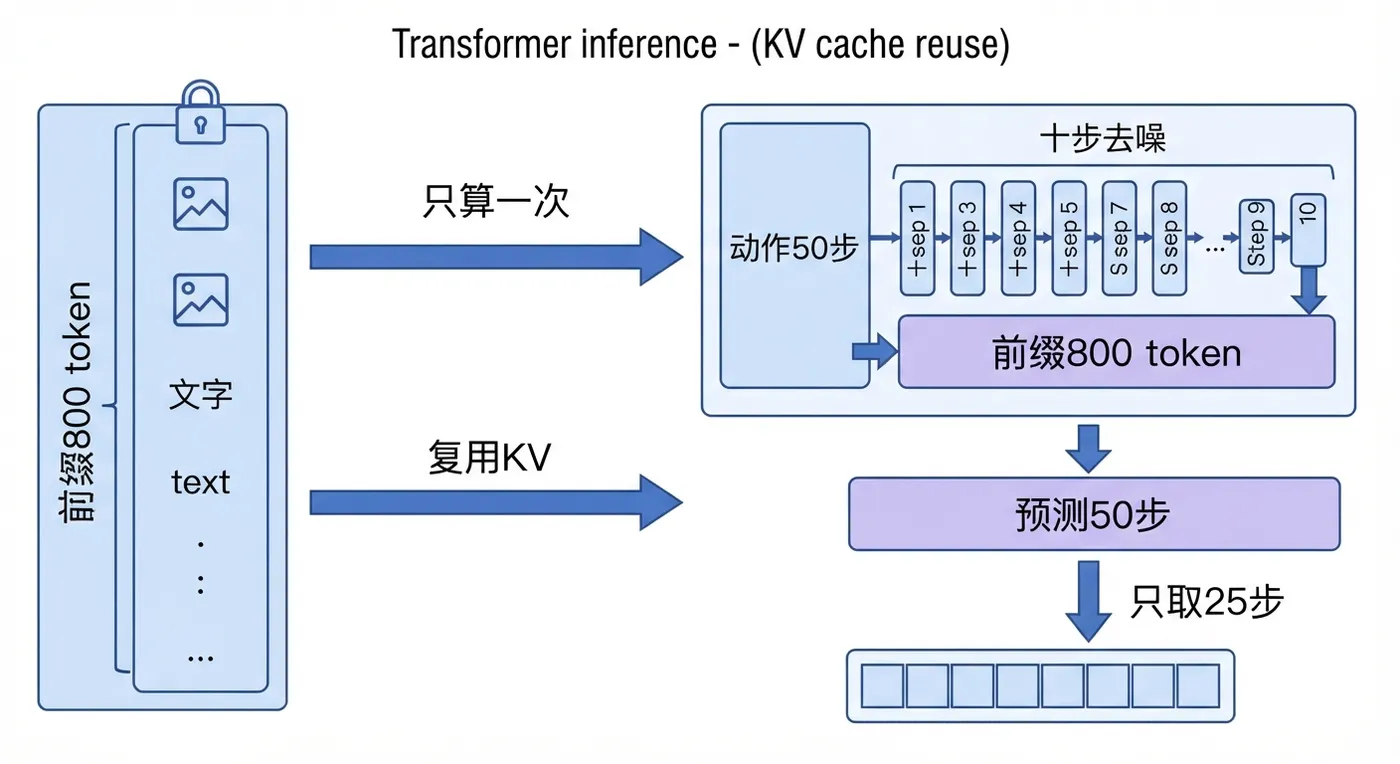
注意力掩码让前缀不受动作影响,因此前缀的K和V只算一次即可被十步去噪复用。
8.10 实验表现
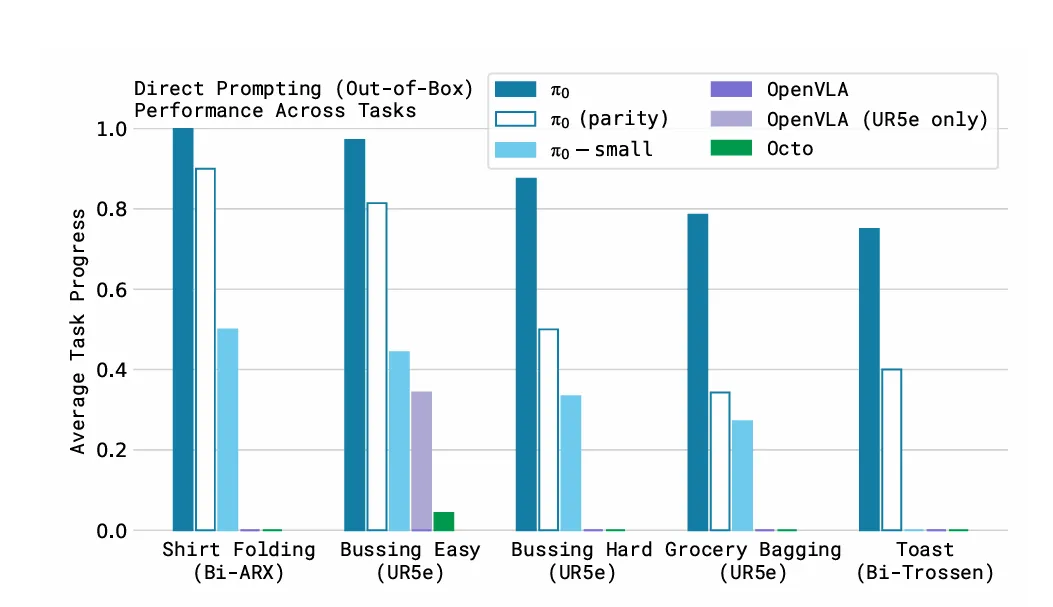
最后看实验。在 2024 年的时候它是遥遥领先的,甩了之前的 OpenVLA、RT-2 等等一大条台阶。不管是在直接用语言跟随的任务,还是用后训练、做微调之后的任务,它都是遥遥领先,效果非常好。具体数字就不多说了,有兴趣可以直接看 π 的论文。
9. 从 π0 到 π0.5:把泛化性补上
9.1 先给 π0 之前的这条线做个小结
到 π0 为止,这条技术路线其实可以顺着数下来。最早是 Google 的 RT-2,它头一回把动作当成文本 token 来处理,于是模型有了一定的语义泛化能力,你说个没见过的说法,它大致能懂。 到了 2024 年 6 月,OpenVLA 把这条路开源了出来,让更多人能上手跑。 再到 2024 年 10 月,π0 出现,它做的关键改动是用 flow matching 取代了自回归的 token 生成。这一换带来的直接结果就是快:50 步一次出完,能支持 50 赫兹的机器人控制。而且它是联合分布,不是一维一维地往外蹦。再加上它那套独特的注意力机制、大规模数据,以及预训练加后训练的组合,这几样叠在一起,把具身智能的整体能力往上抬了一个台阶。
这是到 2024 年为止的进度。到了 2025、2026 年,Physical Intelligence 又陆续放出了 π0.5、π0.6,一直到最近 4 月的 π0.7。那它们各自改了什么?
9.2 为什么 π0.5 值得单独讲
π0.5 也是 Physical Intelligence 做的,2025 年 4 月放出论文,模型同样全部开源。到今天为止,它应该是非常重要的一个 baseline,也是第一个能真正放进实际场景里用的 VLA 模型。所以花时间把它搞清楚是必要的。
先花一分钟回顾 π0 的三条主要贡献。 第一是数据:90.3 万个时间步,也就是 1 万多小时的遥操数据。 第二是架构:用 PaliGemma 加一个外挂的 3300 兆参数 action expert,靠 flow matching 一步做出 50 步的动作块,而不是像以前那样一个 token 一个 token 地输出。 第三是训练配方:它首次用「预训练 + 后训练」的方式来训 VLA。
但 π0 有个问题:它所有的测评和训练数据都在相同的环境里,泛化性到底怎么样,其实没验证过。另外它的动作都是原子动作,比较简单,比如把杯子拿过来这种。 而 π0.5 要干的事是——我给一句话,比如「你把这个房间给我打扫干净」,然后让机器人在一个训练时完全没见过的家里或者环境里,自动把卧室这些地方收拾干净。它一次任务的时长也扩展到了 10 到 15 分钟。这就是 π0.5 能实际使用的原因。
π0 的贡献是数据、架构、配方三条,但训练与测评同环境,泛化性没被验证。
9.3 两篇铺垫工作:π-FAST 与 Hi Robot
在正式进 π0.5 之前,得先讲两篇铺垫工作,因为 π0.5 的两个关键设计都是从这儿来的。它们都是 Physical Intelligence 在 2025 年 3 月前后发布的: 一篇是 1 月的工作,叫 π-FAST,解决的是「动作怎么变成离散 token,才能让自回归模型训得动」; 另一篇是 2 月的 Hi Robot,解决的是「一句复杂的指令,怎么拆成低层次模型能听懂的指令」。
9.3.1 π-FAST:把动作从时域搬到频域
π-FAST 的团队也是 PI 和 USC Berkeley、Stanford 等一起做的,作者其实都差不多。它要解决的问题是:把生成重新拉回到离散化,也就是 token by token 的那种生成方式。因为 action expert 那套 flow matching 的生成本身是有问题的——训练速度很慢,而且指令跟随性不太好。π-FAST 想做的就是:我还是 token by token 地生成,但能不能比以前生成得更快更好?
用一个具体例子说明它要解决什么。 RT-2 和 OpenVLA 把动作变成 token 的方式是:每个时间步、每个维度,把连续的数值切成 256 个桶,数值落在哪个桶就是哪个 token。假设一个关节在一秒内从 0.1 平滑地转到 0.3,50 赫兹意味着一秒有 50 步,那每一步只变 0.004,大概要两步才能跨过一个桶的边界。也就是说,相邻 token 之间的数值变化太小了,有大量相邻 token 其实根本没变化,在 50 赫兹这个量级上尤其明显。而自回归模型的损失就是给定前面的 token 预测下一个,如果下一个 token 和上一个相同的概率很高,模型就会偷懒,直接抄上一个 token,损失很低,这个位置就不产生梯度。结果就是真正带着运动信息的 token 非常少,训练变得很困难。
π-FAST 怎么解决?它换掉了 token 代表的东西,做的是频率上的结合。对一整段 50 步,先做一次 DCT,把时域的 50 个数换成频域的 50 个系数,按从低频到高频排列,越往后越是高频细节。整个流程基本分五步:
- 归一化:把每个动作映射到 -1 到 1 之间,这样不同机器人、不同量纲的动作能在同一个尺度上。
- DCT 变换:做离散余弦变换,把动作从时域变到频域。
- 量化:乘一个缩放系数伽马之后再取整。绝大多数高频系数取整后直接变成零,整个系数矩阵变得很稀疏——真正的压缩就发生在这一步。π-FAST 还做了个实验,发现对机器人运动来说低频更重要,高频那些抖动往往是机械噪声带来的,把它去噪反而有好处。
- 展平:把整个系数矩阵展成一整串整数,顺序是低频在前、中低频在中间、高频在后。
- BPE 分词:用语言模型分词那套 byte pair encoding。因为这串数字里有大量零和反复出现的组合,BPE 可以把它们合并成词表里的 token,词表大小定为 1024。
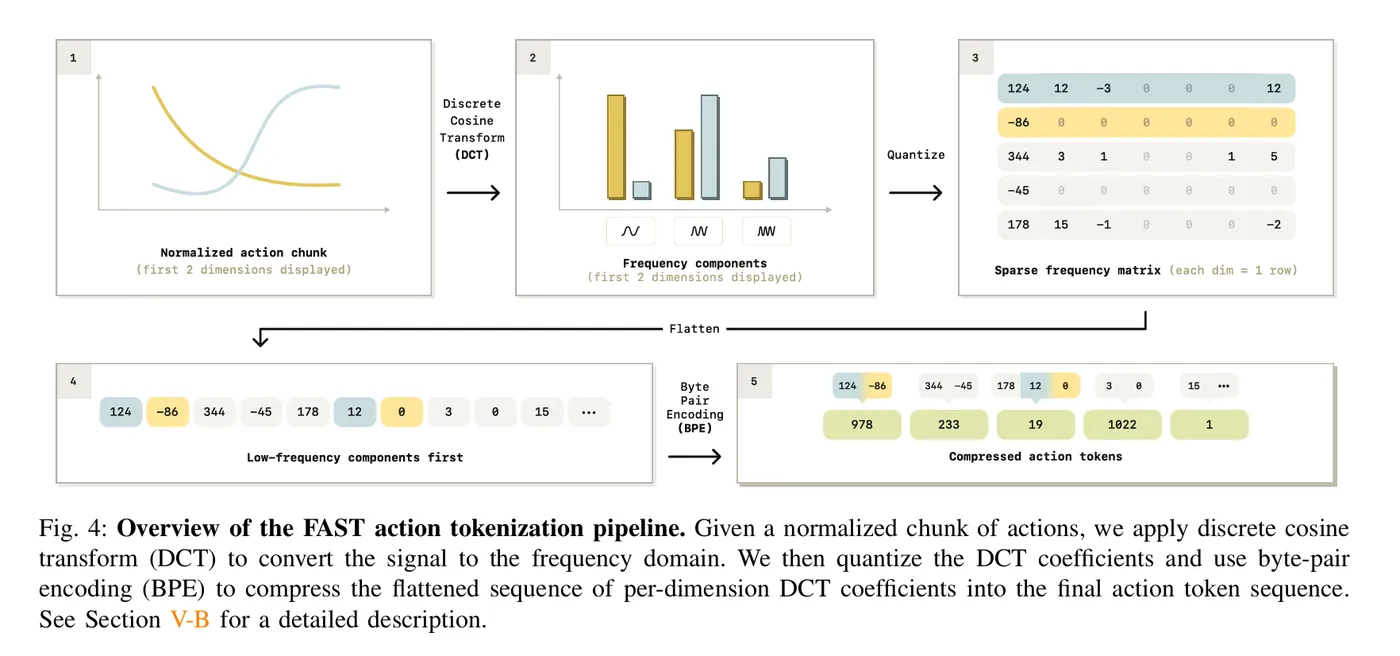
整个流程只有两个超参数——伽马和词表大小,而且每一步都是可逆的,所以预测出来的 token 可以很快解码回动作。
结果和代价呢? 同样的 π0 骨干,如果把动作头换成自回归加 FAST,在 20 赫兹的收桌子和 50 赫兹的叠 T 恤这两个任务上,用原来那套分桶法训出来的策略成功率接近 0,而用 π-FAST 这种方式训练,成功率能提到 65% 到 85% 左右。 第二条,用 π0 的全部预训练数据训一个 π0-FAST,它在 5 个任务上的平均表现其实和 flow 版的 π0 持平,但训练用的 GPU 数少了 5 倍。代价是推理更慢:它还是串行的 token by token 生成,一秒的动作要一次性串行解码出三五十个 token,而且每个 token 都要经过一个 2B 的语言模型。在 4090 上跑一次要 750 毫秒,而 flow 版的 π0 只需要 3 亿参数的 action expert 跑十步去找,大概 10 毫秒左右,两者推理速度差了 7 倍。
到这儿两条路线的优缺点就很清楚了:离散 token 训练快、听指令,但推理慢;action expert 那套 flow 的方式推理快,一步能出 50 个,动作也更细致,但训练特别慢,指令跟随度还不太好。π0.5 的一个创新就是把这两头拼起来——预训练这种大规模训练的时候,用离散的 FAST token 形式;后训练的时候,再接上 flow expert,用少量数据精调。这个后面再展开。
9.3.2 Hi Robot:把复杂指令拆成原子动作
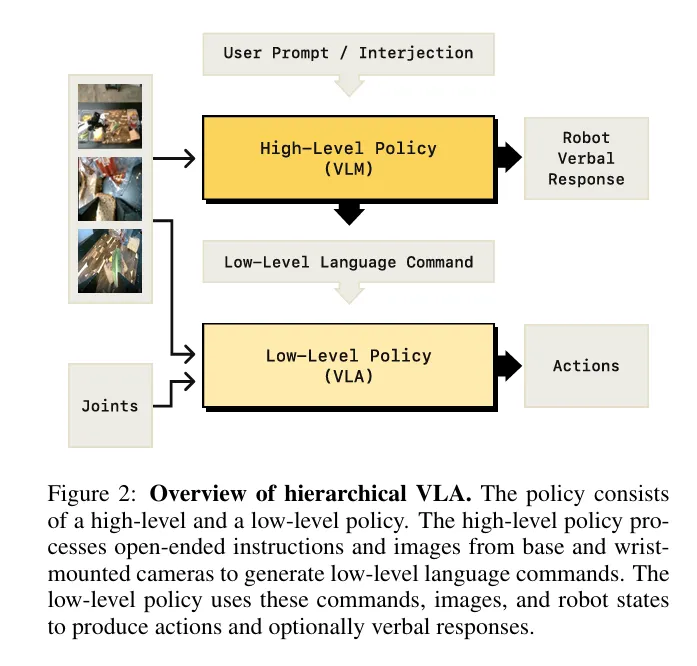
第二篇铺垫工作叫 Hi Robot,也是 PI 跟 Stanford、Berkeley 一起做的,发表在 ICML 2025 上,作者也都差不多。它的系统由两个模型组成,都是 30 亿参数的 PaliGemma 模型。高层输入是相机画面加上用户说的一句话,这句话可以是一开始的任务,比如「给我做个素三明治,不要番茄」,也可以是中途的插话,比如「哎那个不是垃圾」。高层的输出是一系列原子指令。比如你跟它说「给我做个素三明治,不要番茄」,它输出的可能就是「拿起一片生菜」这类细粒度动作,这些动作交给底层的 VLA 模型去直接执行。
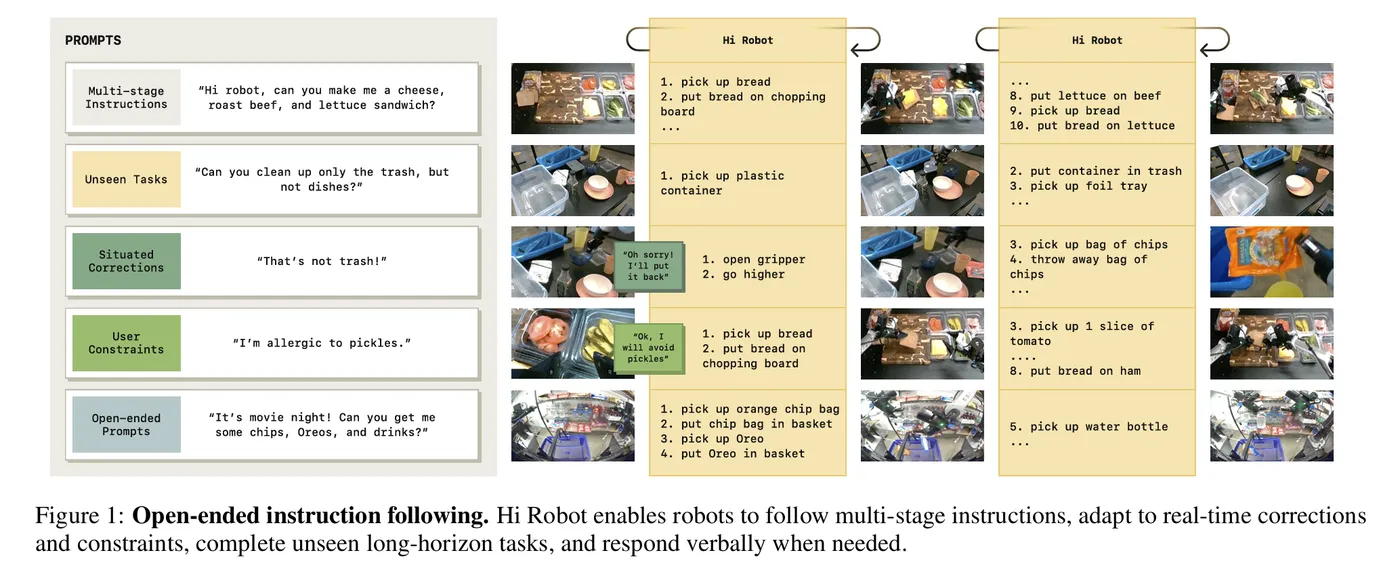
推理的时候,用户先说话转成文字,高层模型先做动作分解,突出指令和回话,再把指令和回话送给低层模型推理,然后让机器人执行。它的问题有两个: 一是高层没有记忆; 二是高层和底层是分开训的,高层并不知道它输出的原子指令底层到底能不能做、做成什么样。π0.5 其实就是冲着解决这个问题来的。
9.4 π0.5 的数据:从一类扩到五类
接下来正式进入 π0.5,还是从数据、架构、训练方式三点来讲。
π0 的数据只有一类,就是动作遥操数据。π0.5 把预训练的数据类型增加到了五类:
第一类是 MM,即使用移动机器人在真实家庭里做家务的数据。这个移动机器人带轮子、双臂,有 4 个相机,还有底盘,可以升降躯干,总共 18 维,是 50 赫兹的双臂机器人,可以直接进你家做复杂家务。这类数据总共 400 个小时、约 100 个家庭,是和测评任务直接对应的数据。不过采集比较贵,所以它只占整个样本的 2.4%。
第二类是 ME,即单臂或双臂的固定机械臂在更多家庭里采的数据。固定臂比移动平台好搬,采集更轻松,能去的家庭更多,场景也更复杂,代价是它能干的事稍微简单一些。
第三类是 CE,即实验室里采的跨本体数据,跟 π0 那一套差不多,只是又扩展了一些,比如加上了开源的 OXE 等。任务像收桌子、叠衣服这些,环境是固定的实验室桌面和加固场景,不太一样。
第四类是 HL,也叫高层标注。作者给前三类里的多阶段任务都细粒度地标注了子任务文本。举个例子,一段清理卧室的数据,会给某一段标成「拿起枕头」,标的时候先标出画面里相关物体的检测框,也就是 bounding box,然后再标子任务。说白了这一步就是给前三类任务补上更细粒度的文本标注和 bounding box 标注。
第五类是 WD,即网页数据,包含大量图片描述、视觉问答、物体检测用的公开数据集,比如 caption、COCO、VQA 等,里面没有任何机器人动作。加它主要是为了提升预训练时的泛化性。
后面还会再加一类 VI,也就是用语言去遥操数据 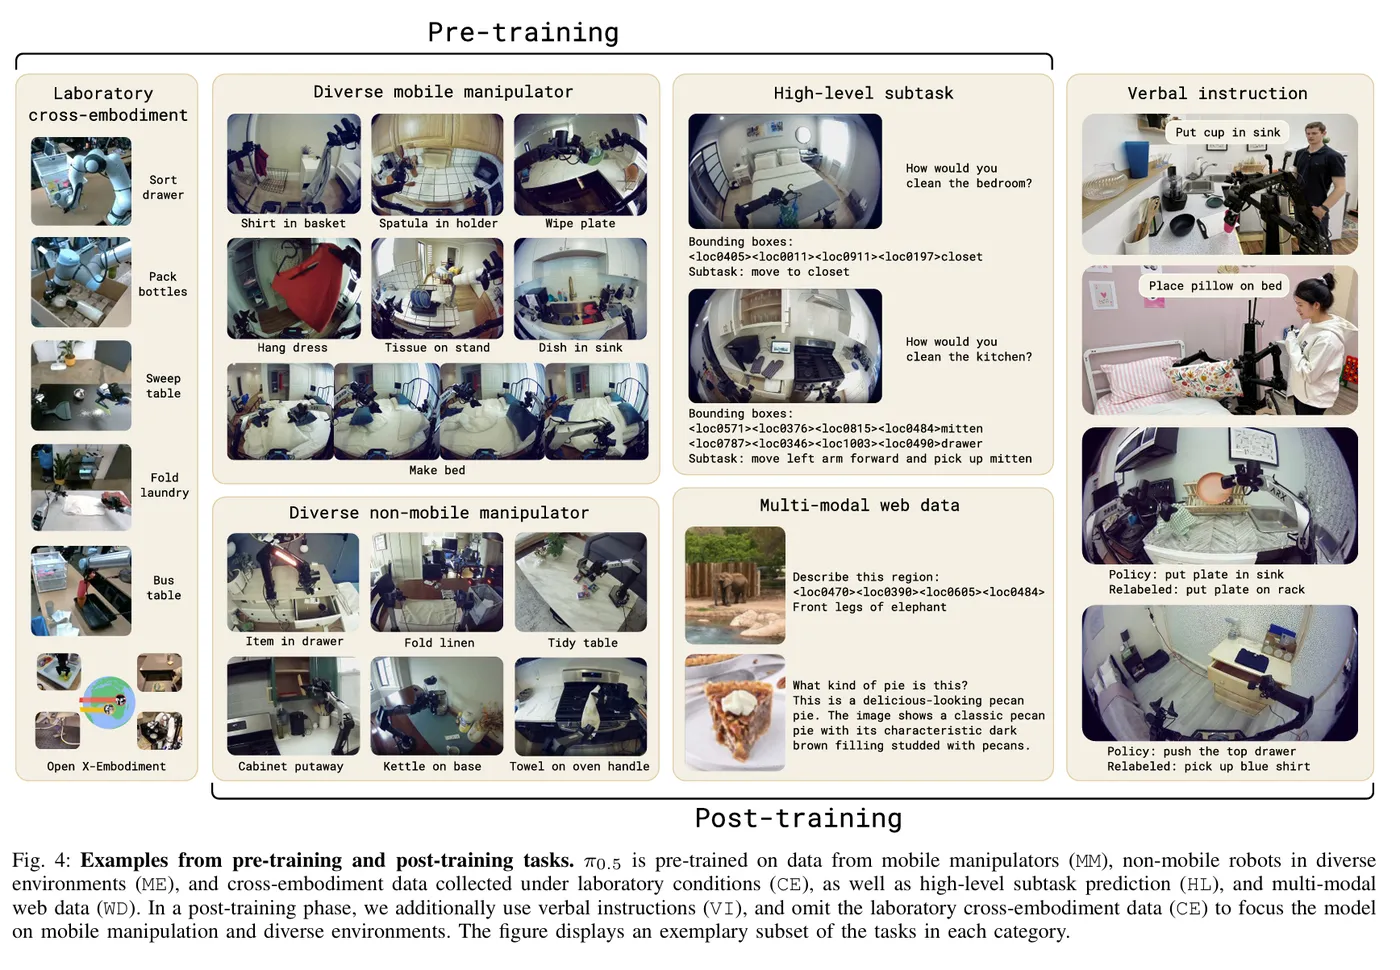
这五类数据能放在一起训,靠的是它们被写成了同一种序列格式——都是 token 化。动作是 token,子任务文本是 token,检测框是 token,视觉问答的答案也是 token。把这些 token 压在一起,直接送给 VLA 模型去学就行。 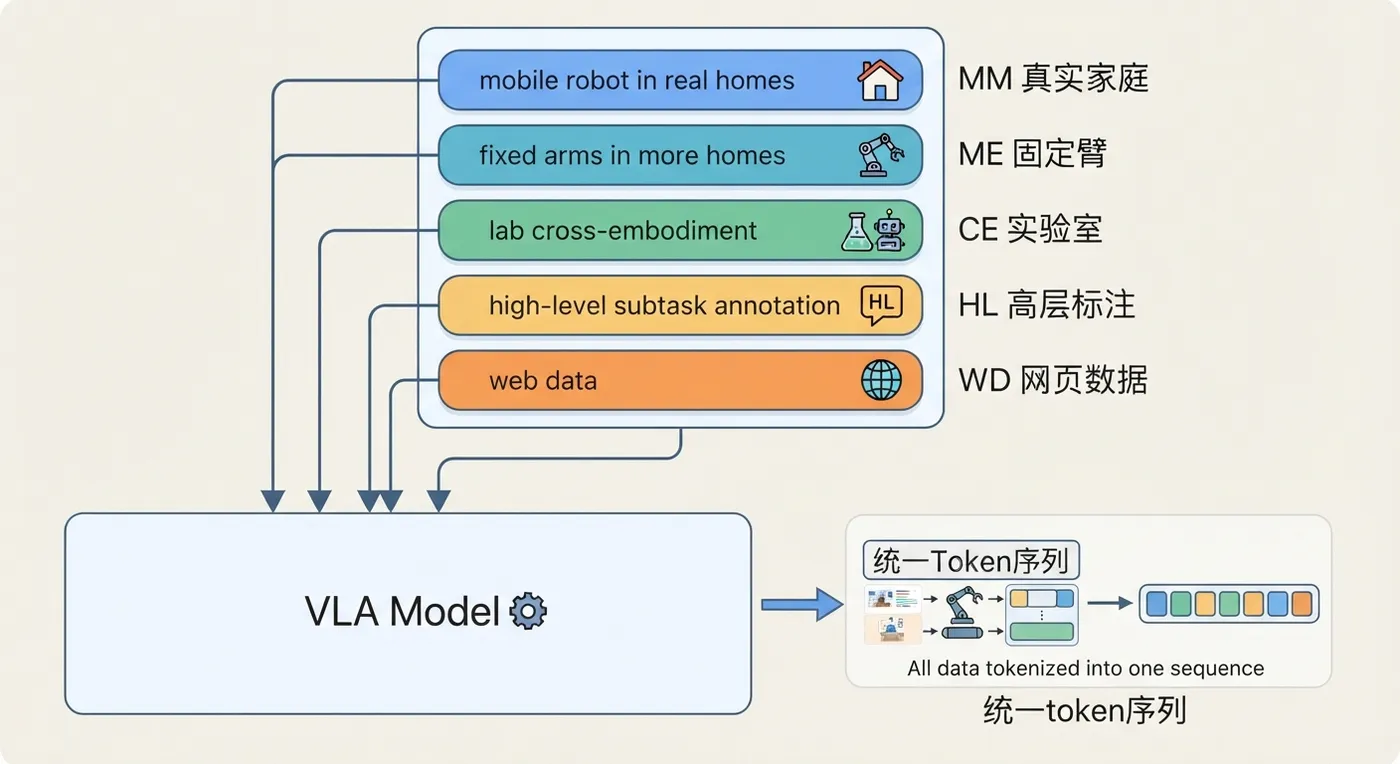
π0.5 把数据从一类扩到五类,靠统一token化格式放进同一个模型一起训练。
9.5 π0.5 的架构:预训练与后训练两阶段
架构分两阶段讲,第一阶段是预训练,第二阶段是后训练和推理。
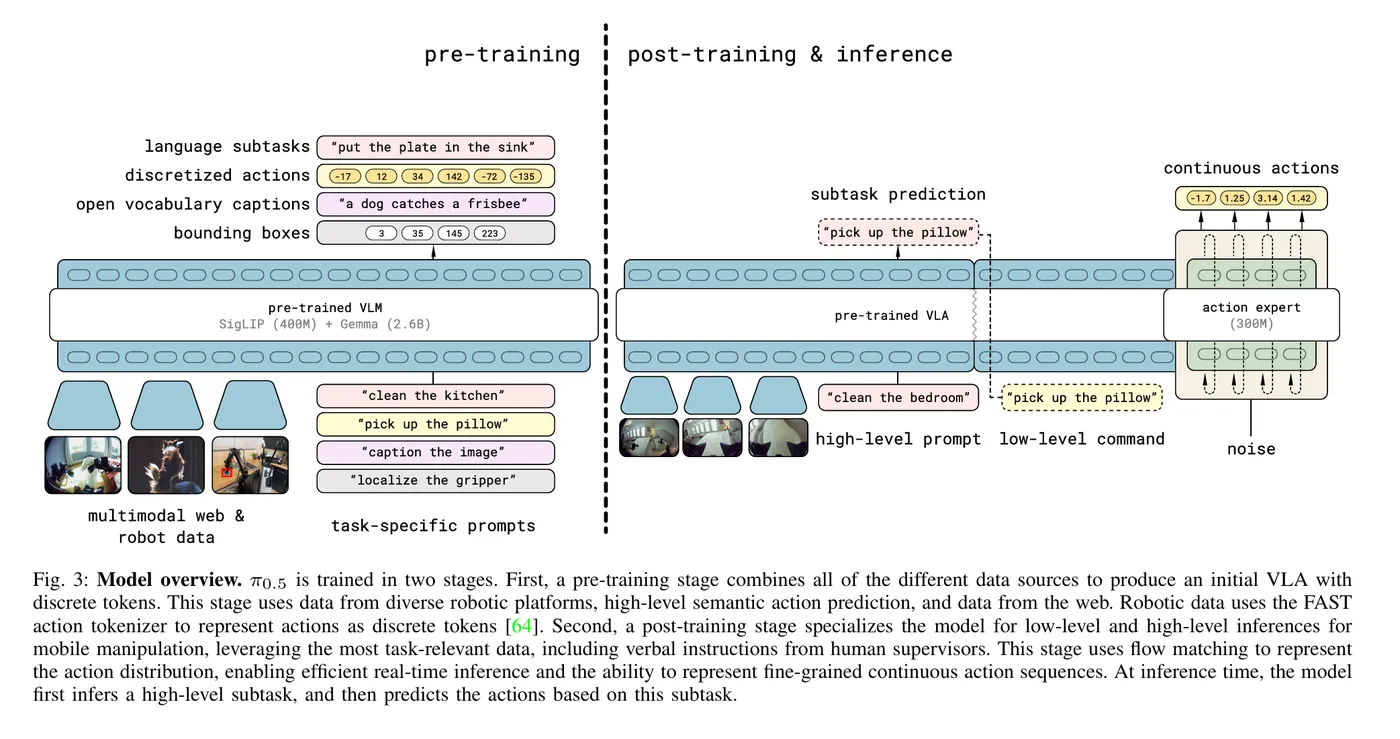
先说不变的部分:模型尺寸和 π0 完全一样,用的都是 PaliGemma 3B,视觉 encoder 也是 SigLIP,action expert 还是 flow matching 那个头,同样 300 兆参数。变的是进出模型的东西。
输入侧变了一处:以前的本体状态——表征当前机器人所在状态的那个量——在 π0 里是线性投影,走 action expert 那一路;现在 π0.5 把它全部离散化成文本 token,也就是一段数字,然后跟图像、指令等一起放进 VLM 里。
输出侧也变了。VLM 现在会输出文本,因为它要做高层任务的原子化,所以能输出子任务、图片描述、检测框等等。第二,VLM 还会输出像 FAST 那种离散动作 token,因为预训练走的就是 π0-FAST 那条路,token by token 输出。而 action expert 的动作和 π0 一样,接 50 个带噪声的动作,token 输出速度长——但这一步要到后训练才用。也就是说,预训练完全变成了一个 LM 范式的、全部 token 化的东西。
逐项对比 π0.5 和 π0 的架构: 骨干完全相同;action expert 也完全相同,只是 action expert 在 π0.5 里是后训练才加入的。 本体状态在 π0 时放在 expert 那一路,在 π0.5 时放在前面,跟 token 一起编码。 输出上,π0 只有连续动作,也就是 flow matching 的输出;π0.5 则有不同种类的输出——文本(包括 VQA、框等)、FAST token(也能表征机器人动作),以及连续动作 action expert(和之前不变)。
9.6 注意力怎么设计:别让 action expert 偷懒
π0.5 的注意力分成三块:图像、指令、状态这些前缀 token 之间是双向的,彼此都能看到。 FAST token 只能看到前缀,它自己内部是因果的,只能做 next token prediction,只看得到前面部分。 action expert 的动作只能看到前缀,也能互相看——但注意,action expert 不能看到 FAST action。因为一旦能看到,它就会偷懒,直接偷学 FAST token,本质上 FAST action token 和 action expert 这两种表征的都是同一段动作序列。所以后训练训 action expert 的时候,必须严格保证它看不到 FAST action token。
另外沿用了 π0 的做法:前面那些 image、state 等,训练时都看不到结果层的 token,也就是看不到 FAST action token 和 action expert 的 token,这样才能保证 PaliGemma 模型的预训练知识完整。因为 PaliGemma 预训练时根本不知道这些机器人动作,强行让它看到反而会破坏训练进度。
推理时分两步。第一步高层先过一遍:模型用相机画面加上总任务,比如 clean the bedroom,像语言模型生成文字一样,自回归地采样出一个子任务,比如 clean bedroom 的子任务可能是 pick up the pillow,把枕头拿起来。第二步才进入底层执行:模型拿三路相机画面加上这句子任务,用 action expert 做十步去噪,出一个 50 步的动作块,让机器人执行。执行完这个动作块再重来一遍。注意动作只依赖子任务,不看总任务——底层并不需要理解「清理卧室」到底是干嘛,它只需要理解「拿起枕头」这个具体动作。
跟上一期讲的 Hi Robot 比,差别就在模型数量:Hi Robot 把高层和底层拆成两个模型,π0.5 其实是同一个模型的两种不同输出模式。这样它们共享一套权重,有助于模型对复杂任务形成统一的理解。
有个实验能证明这个做法:底层全用 π0.5,只换高层,看谁出的任务最好。π0.5 自己出的子任务能达到 78% 左右,人类专家给出的子任务只有 63%,而当时用 GPT-4 做零样本高层只有 57%。这也说明了高层底层合并、共用一个模型的好处。
9.7 训练方式:预训练阶段全是 token
训练分两段。预训练阶段有 28 万步,这一阶段的所有输出都是 token,不管是文本还是动作。动作也用 π-FAST 的方式离散成 token 来预测。损失函数是两项相加:第一项是文本 token 的交叉熵,第二项是 flow matching 的损失,前面可以带一个阿尔法系数。预训练的时候阿尔法等于 0,也就是说 flow 那一项根本不参与训练。
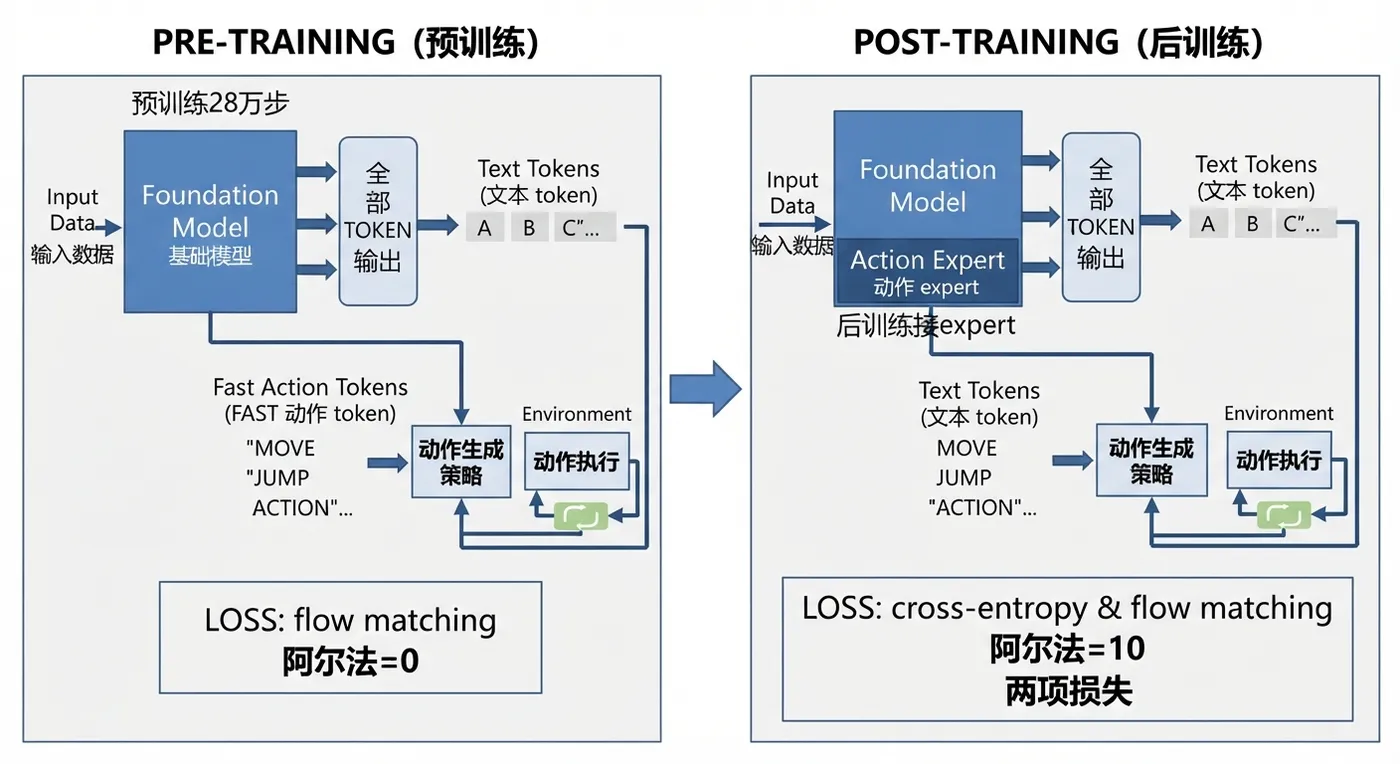
预训练阶段只训token、flow项权重为零,后训练才接入action expert并同时优化两项损失。
9.8 后训练:把 action expert 接上来,两项损失一起算
到了后训练阶段,做法就变了。前面预训练时模型只是在训一个普通的 VLM,只不过词表里多了动作 token。等到后训练跑到 8 万步的时候,才把随机初始化的 action expert 接上来,同时把阿尔法调成 10,让交叉熵和 flow matching 两项一起训。这样一来,模型预测文本的能力保住了,同时也能通过 action expert 输出连续动作。
后训练用的数据也换了:从 MM 和 ME 里挑最成功的、并且长度不超过阈值的那些细粒度标注数据,另外新增了一类语言遥操数据,同时把实验室里的 CE 数据去掉。CE 数据是指在实验室样本里做的那些。也就是说,后训练阶段只用比较高质量的数据。
效果可以看真实家庭里 π0.5 和 π0 的细粒度对比。准确率提升非常明显,比如 dlink 这个任务,完整体的 π0.5 能达到 93% 左右,而 π0 只有 18% 和 42% 左右,基本就是完不成。也正因为这样,π0.5 才能在实际家庭中完成这些复杂任务。
9.9 新引入的 VI 数据:人只动嘴,不动手
后训练新增的那类数据叫 VI 数据,是一种新的监督方式。做法是:让已经训好的底层策略去控制机器人,人不碰遥操手柄,只是盯着场景实时下达子任务。比如“把杯子放进水槽”这个任务,机器人做完这一条,人再给下一条,记录下来的数据就是当时的观测,加上总任务到子任务的配对。这批数据占 MM 高层样本的 11%,但如果把它去掉,平均进度就会从 78% 掉到 60%。这说明这类语言遥操数据其实非常重要。
9.10 主实验:mock 环境与真实家庭
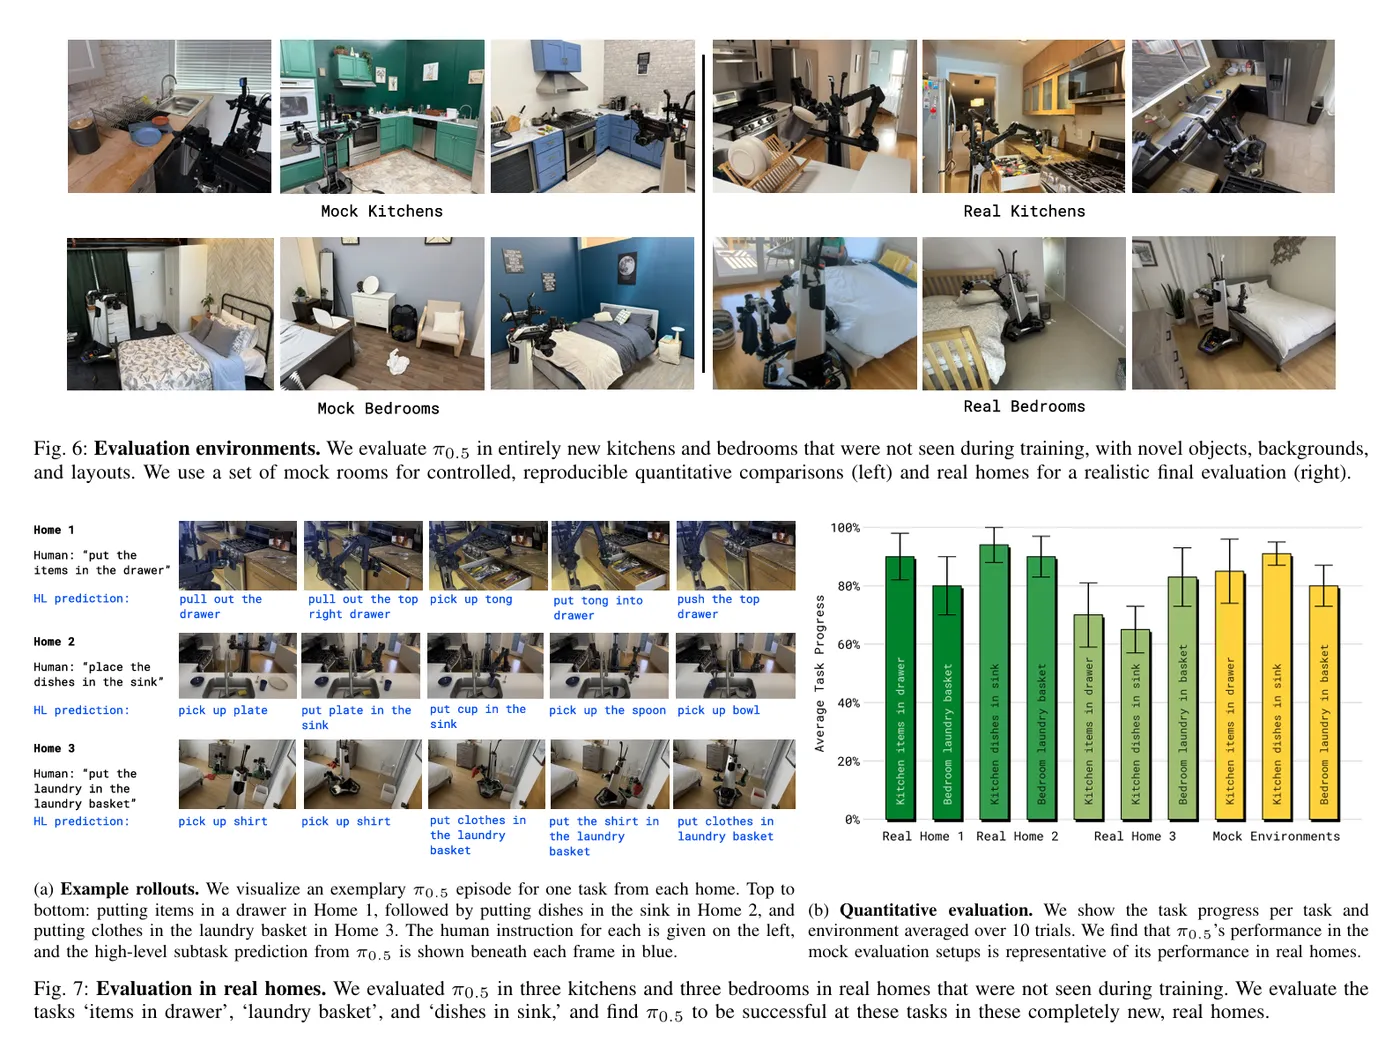
π0.5 的主实验分两种。第一种是自己搭的 mock 厨房和卧室,用来做对照实验,因为场景是自己搭的,方便改动。第二种是真实家庭,用来做最终评测。评测用 4 个任务,每个任务有一张打分表。举个例子,dlink 满分是 8 分:桌上 4 件餐具,每件拿得起得一分,放进水槽得一分,以此类推,会有原子任务的打分。三个真实家庭,每家做一个厨房任务和一个卧室任务。
看结果,第一行蓝字是模型自己预测的子任务,比如拉开抽屉、放进抽屉、推上抽屉等等,各个任务的进度基本都在 65% 到 94% 左右。值得一提的是,这和它自己搭的 mock 环境里水平差不多,所以作者认为 mock 环境很有代表性。这也证明了 π0.5 是第一个可以直接把机器人放在复杂环境、真实家庭里,去完成人类真实需要的复杂动作的模型,所以它是一个非常重要的模型。
9.11 总结 π0.5:数据、架构、训练三方面
数据上,它比 π0 多增加了五类更细粒度的标注,还包括网页数据等等,让它能认识更多陌生物体,进一步提升泛化性。
架构上,模型本身没变,还是 Gamma 加 action expert 那套,但输入方式和输出方式变了。输出包含了文本,另外还增加了离散状态的输出,就像 π0 fast 一样。
训练范式同样是预训练加后训练两步。但预训练的时候不加 action expert,只过 token by token 的训练。好处是预训练速度更快,跟随性更好。到了后训练,再用一批高质量数据去反吞 action expert,保证输出时更快、更精确。
以上就是 π0.5 的介绍。作者说下一期应该会讲强化学习是如何用在 VLA 任务里的,也就是以 π0.6 为例。
在正式进入 π0.6 之前,先把强化学习这件事本身讲清楚。 强化学习(Reinforcement Learning,RL)和前面几代模型用的模仿学习(Imitation Learning)是两条完全不同的训练路线。模仿学习的逻辑很简单:人类把正确的动作演示给机器人看,机器人照着学,学得越像越好。它的上限取决于演示数据的质量——如果演示里没有出现过某种情况,机器人遇到时就只能靠猜。而强化学习的逻辑是:让机器人自己去试,做对了给奖励,做错了给惩罚,通过一次次试错,让机器人自己摸索出最优的动作策略。它不依赖人类演示,而是依赖「奖励信号」来引导学习方向。
这两条路线的差别,在真实场景里会体现得非常明显。模仿学习训练出来的机器人,在训练时见过的环境里表现很好,但一旦环境变了——比如桌子换了个位置、光线暗了一点、物体换了个颜色——它就可能不知所措。因为它的知识全部来自那批演示数据,数据里没有的,它就学不会。强化学习则不同,它是在与环境不断交互的过程中学习的,每一次交互都是一次新的探索,所以它对环境变化的适应能力更强,也更有可能学会「在没见过的场景里做出合理决策」。
但强化学习也有它自己的难题。最核心的一个是「奖励设计」:你得告诉机器人什么是对的、什么是错的,这个信号怎么定义非常关键。定义得太简单,机器人可能钻空子,找到一个取巧但不符合真实意图的做法;定义得太复杂,又可能让训练变得极其缓慢。另一个难题是「探索与利用的平衡」:机器人既要尝试新的动作(探索),也要坚持已经验证有效的动作(利用),这两者之间的分寸很难拿捏。还有一个现实问题是「样本效率」:强化学习需要机器人大量试错,每一次试错都要在真实机器人上跑,成本非常高。这也是为什么 π0.6 的强化学习不是从零开始,而是建立在 π0.5 已经训练好的模型之上——它不需要重新学基础动作,只需要在已有能力的基础上,通过强化学习把表现再往上推一层。
10. π0.6:用强化学习突破模仿学习的两道天花板
10.1 先看它能做什么
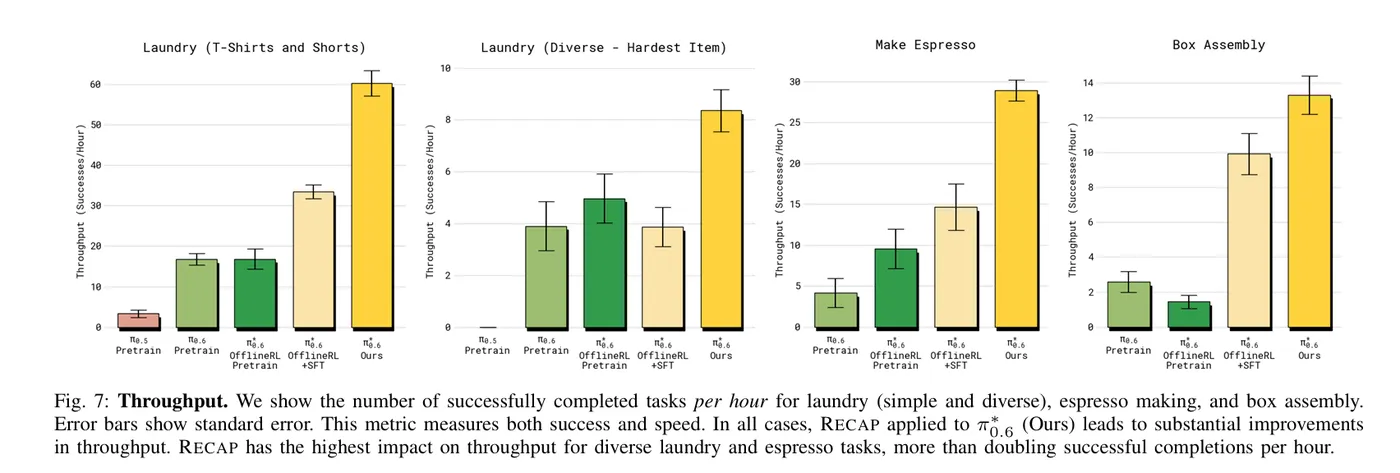
π0.6 论文报了三个结果:一台机器人连续 13 个小时不间断地做浓缩咖啡;它还可以到一个从来没去过的家里,折叠从来没见过的衣服,连续做两个多小时,没有任何人干预;同时它还能进工厂,组装真实用的包装纸箱。而且在最难的几个任务上,它的吞吐量比只用示范训的版本(也就是 π0.5)翻了一倍以上,失败率减少了一半左右。
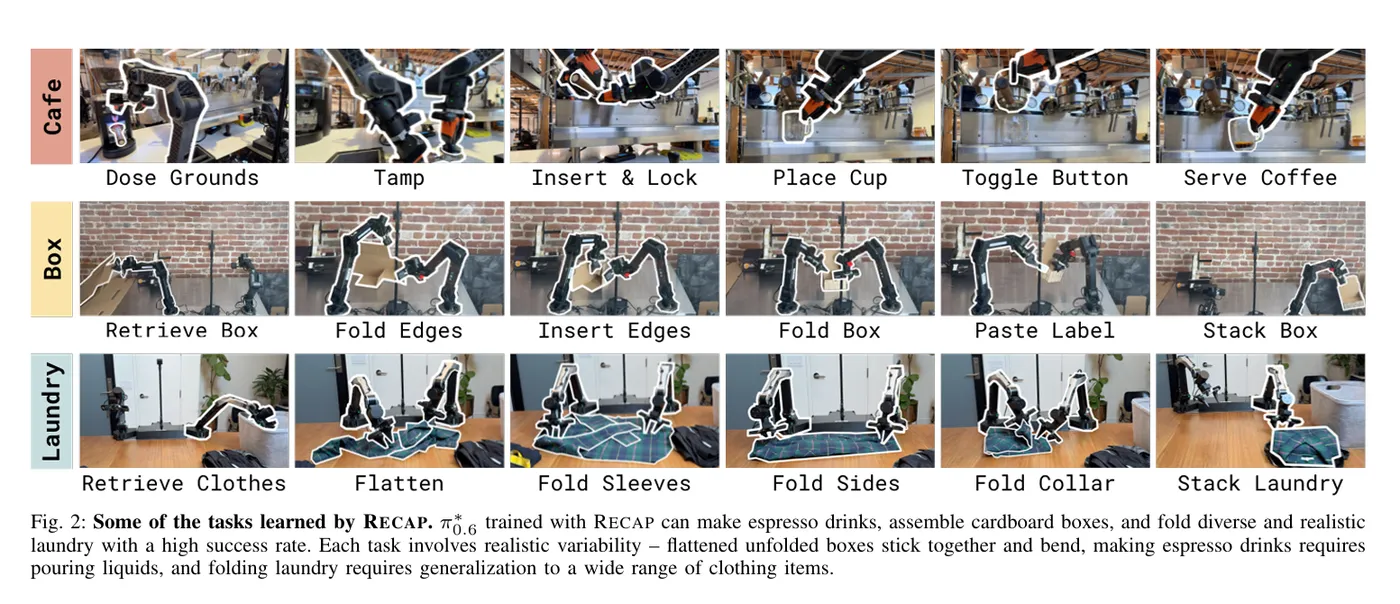
做到这一点需要强大的纠错能力,因为这些复杂任务难免出错,那如何让它有自主的恢复能力?答案就是强化学习。
10.2 模仿学习的两道天花板
先看现在的 VLA 是怎么训的。从 π0 到 π0.5 都是这条路,可以叫模仿学习,其实也就是 SFT。数据来自人的遥操动作,遥操就是人拿着遥控器带着机器人做一遍。训练目标只有一句话:当我看到这个画面,输入人当时做的那个动作,损失就是尽可能去模仿这个 ground truth。
这里有一个很强的隐藏假设:数据里出现的每一个动作都是对的,都值得学,所有样本一律平等。这个假设有两个问题。
第一个问题叫复合误差,也就是 compounding error。假设蓝色的袋子是示范数据所能覆盖的状态,它是一长条;橙色的线是模型当前执行的轨迹。模型自己跑的时候,每一步都会有一点点小误差。前几步误差每偏离一点,可能还在数据分布里面,因为模型见过类似的画面,能揪回来。但误差会累积,到某一步累积起来的状态就开始变得陌生,橙色的线一下就跑出蓝色的条。可能到第 200 步的时候,画面已经是训练数据集里完全没出现过的状态,模型没有任何依据,只能瞎猜,而瞎猜又会制造更大的偏离,模型就走远了。
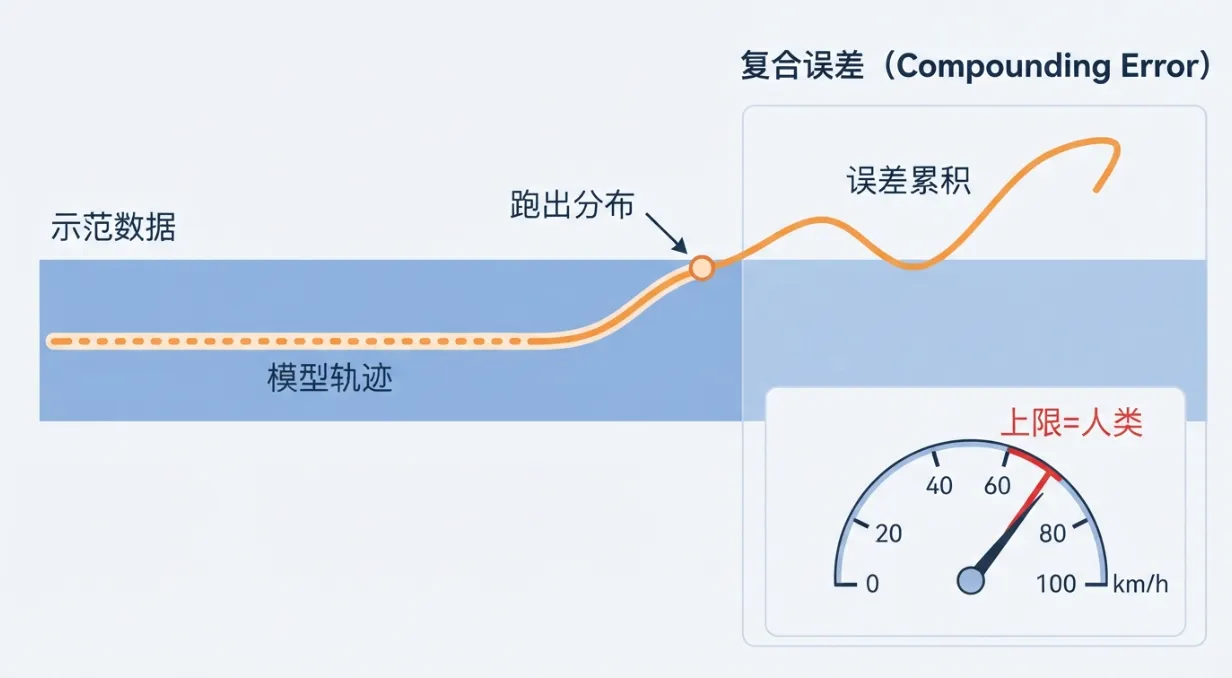
第二个问题很直接:因为模仿学习永远在模仿 ground truth,它的上限就是跟人一样,永远快不过操作员。这不是我们想看到的。
要突破这两个天花板,就需要从模仿 ground truth 的范式转化到强化学习的范式。
小误差累积会让模型跑出示范分布,而模仿ground truth的上限永远只是操作员水平。
10.3 强化学习的四个核心概念
在进入 π0.6 的方法之前,先把强化学习说清楚。它的基本原理和 LM 用的差不多,不管你是不是搞机器人的,都值得学一下。
有一个策略叫 π,输入是当前的观测 O_t,输出是机器人的动作 A。在我们这儿,观测就是相机画面加上关节角。策略产生动作,动作发送给真实环境。对应到机器人,环境就是真实世界,比如机器人加上桌子上的东西。世界会随着动作发生变化,策略就会拿到新一期的观测 O_{t+1},再返回给策略。同时环境还会给到一个奖励 reward,就是一个数字,告诉你这步做得好不好。一条 episode 就是从 O_0 开始,动作和观测交替,一直到结束的 O_T。
另外还有四个重要的物理量。第一个是回报,也就是这一条 episode 里所有奖励加起来的总分。第二个叫价值,记作 V,意思是从当前这个画面出发,照现在的策略做下去,预期还能拿多少回报,相当于对未来的估计,所以叫价值函数。第三个是优势,记作 A,表示在这个画面下实际做了当前这个动作之后拿到的回报,减去价值函数预期的回报。因为价值代表平均水平,所以优势表示的是当前做这个动作会比平均水平好多少:正的话说明比平均好,负的话说明比平均差。第四个就是强化学习的总目标:找一个策略 π,让回报的预期最大。
10.4 用外卖骑手把概念串起来
这四个概念比较抽象,举一个生活里的例子。
假设你是一个外卖骑手,策略就是骑手送外卖。环境就是要送外卖的这座城市,从餐厅取餐开始到送到顾客手上结束,这是一条完整的 episode。骑手每到一个路口,需要决定该怎么走、往哪拐,这就是骑手的 action。
先说奖励,就是每一步的分,每多花一分钟扣一分。这个奖励是扣分制的,理解成负数,它是时间的函数,送到了就不再扣。如果餐撒了、超时了或者被投诉了,会一次性扣一大笔,比如一次减 50 或者减 100。把这一单的分数全部加起来,就是回报,也就是这一单的总分,说白了就是负的用时加上失败惩罚。有了总分之后,我们就找一种跑法,让平均每一单的总分最高,也就是平均用时最短。
问题在于,一单要做几百个路口,最后只拿到一个总分,你可能并不知道具体是哪个路口拐对了、哪个拐错了。所以需要价值和优势来解决。
价值的意思是:从当前这个路口出发,按照现在的跑法,平均还要多久才能送到。这个东西可以理解成导航软件,高德地图就是一个价值函数,它把这一单的总分摊到了每个路口上。有了价值之后,就可以给每一步单独打分,这就是优势。
举个例子:出发的时候导航说要到目的地需要 20 分钟。跑了 5 分钟之后再看导航,导航说只需要 12 分钟就能到达。算一下,20 减 5 减 12,说明你比预期多赚了 3 分钟——本来跑了 5 分钟之后可能需要 15 分钟才能到,但导航说只需 12 分钟,也就是跑到这一步时你比预期多赚了 3 分钟。这 3 分钟就是你的优势。如果导航报的是 18 分钟,说明你跑得比平均导航报的还差,那就是负的优势。
整条路线就是这样:奖励定义目标,价值把目标分摊到每一步,优势给每一步打分,最后期望总奖励越来越大,也就是用时越来越少。
用这个概念可以把两种学法分开。新骑手入职,第一种方法是跟着老骑手把路线都走一遍、照着走,这就是模仿学习,但他可能形成记忆,只会走老骑手走过的路,最快也就和老骑手一样快。第二种是自己去跑单,自己看用时,按照优势来改跑法,自己探索最短路径,这就是强化学习。没有人告诉他真正正确的路线是什么,他只需要每单用时跑多了就能比老骑手还快。
10.5 RECAP:三步循环
有了这四个概念,就可以说 π0.6 大概是怎么做的。π0.6 主推的方法叫 RECAP,分三步循环。
第一步是采数据:把当前的策略部署到真机上跑任务,然后给每个 episode 标一个成功或者失败。
第二步是用这些数据去训练价值函数。这个价值函数就理解成刚刚的导航。因为机器人没有导航,所以需要自己训一个导航函数出来,也就是 V 函数:用到目前为止收集的全部数据,训一个网络来预测“到现在这样还能多久做完这个事儿”。
第三步是用这个 value function 来训主要的策略函数,也就是 VLA 参数。然后用循环的方式训练,把 2 和 3 针对每个子任务重复做,1、2、3 轮再重复地做。通过多轮强化学习,逐步增强 π0.6 的强度。
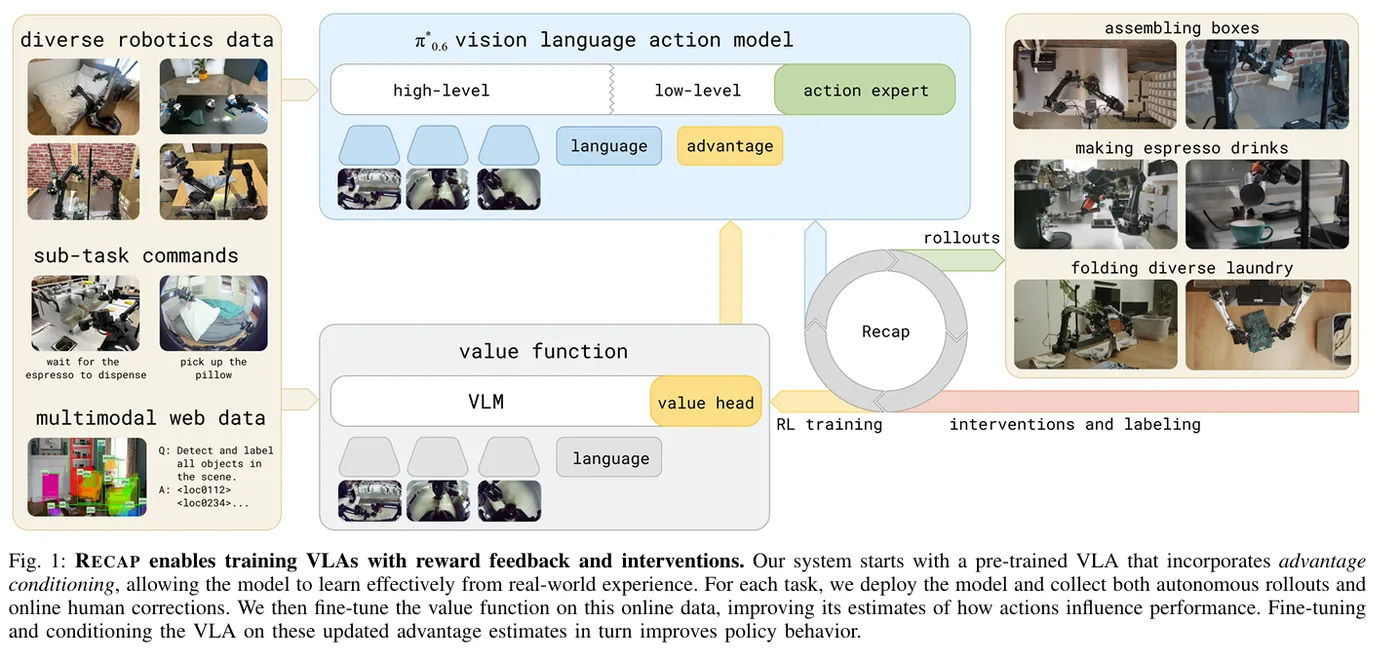
10.6 奖励怎么定义:最后一步的 C 负
第一步先看奖励怎么定义。其实就跟骑手的例子一样,论文定了一个对任何任务都通用的奖励:如果是最后一步并且成功,奖励就是 0;如果最后一步失败,奖励就是一个非常大的 C 负,可能是一个非常大的常数;其余每一步奖励都是 -1,类比成骑手每分钟扣一分,只是单位换成了步。
为什么要这样设计?举个例子,让机器人做一杯浓缩咖啡,一杯成功的浓缩咖啡可能用 120 秒、有 6000 步,那它的回报起点就是 -6000。另一杯 90 秒就搞砸了,如果在离结束 500 步的时候还没有 C 负,它的回报就是 -500,比成功那杯的起点要高得多。这样价值函数就分不清它是快要成功还是快要报废了。假设 C 负取一个很大的数,取 10 万,那这杯失败的咖啡就变成 -100500,这条失败的 episode 就会被压得很低。这有点像你一单快快送到的时候把餐撒了,如果没有那笔大的扣分,他的分反而会比刚出发的单还要高。这就是 C 负的意义。
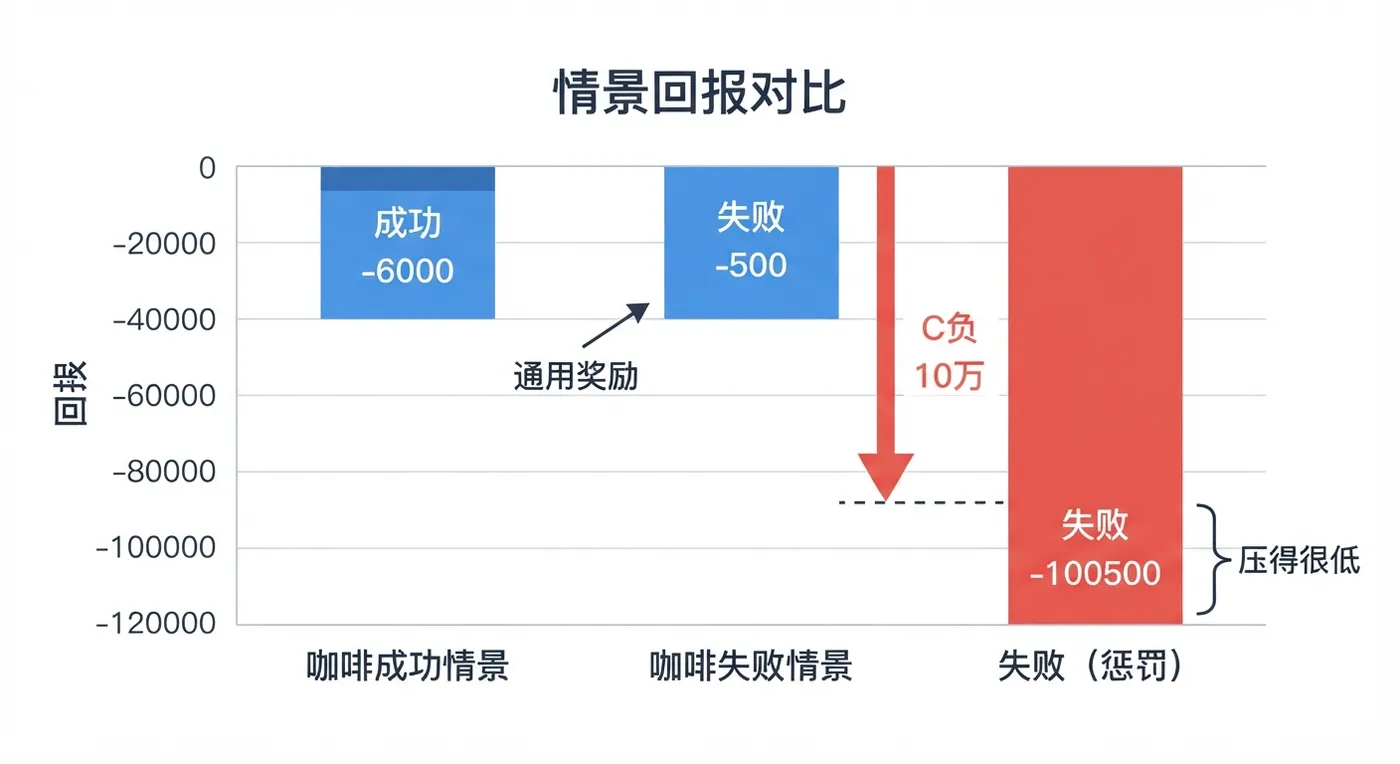
若没有最后一步的大额负奖励,提前失败的episode回报反而高于成功起点,价值函数就分不清好坏。
10.7 价值函数怎么训:本质是个倒计时器
机器人训练里没有导航,所以得自己训一个导航 value 出来。它本质就是一个倒计时器,训练数据就是把成功的录像倒着数帧。
举个例子,有一条 32 秒的折衣服视频,50 赫兹一共 1600 帧。第 0 帧的时候还剩下 1600 帧,所以标签就是 -1600;到第 800 帧的时候还剩 800 帧,标签就是 -800,以此类推。网络看到第 0 帧那张画面,衣服还在框里面,就要输出还剩 1600 帧;看到第 800 帧的时候,衣服可能已经摊平了,两个角已经被捏住了,这时它就要输出还剩 800 帧。逐帧的价值标签是数出来的,人并没有标过。所以训练非常简单,就是一行代码的事儿:把过去每一单的录像倒着记,每个路口标上从这里实际送达还需要几分钟。导航看多了,只看这个路口就能猜出来还剩多久。这就是整套系统能够规模化的根本原因。
具体怎么训?论文并没有让网络直接回归一个数字,而是把它离散化到 201 个桶,让网络做一个 201 类的分类,用交叉熵训。比如还剩 800 帧,按任务最长 1 万帧规划就是 -0.08,它可能就落在 201 个桶里面最靠近零的那一个,网络学的就是把这张画面分到这个桶。要用的时候,再把每个桶的概率乘上桶对应的值,就可以得到一个连续的值。所以价值函数完全是监督学习训出来的,网络同样用了 Gamma 加上 s sleep 这个网络去训,输入同样是当前的三个画面,加上 prompt 和当前的 meta data,输出就是当前画面的 value。
训好之后有一个很有趣的能力:它可以定位失误。比如论文里的图,叠衣服的时候 value 曲线明显平稳上升,但到 100 秒的时候突然骤降,对应的画面就是左臂抡起来的时候不小心把衣服弄皱了;后面绿色回升的那段,是机器人已经自动恢复好了,value 函数就回升了。做咖啡的例子也是一样。所以它有个好处,可以做机器人的监控器。
10.8 优势怎么算:往前看 N 步
第二步得到了一个很好的导航、一个很好的 value 之后,第三步就是给单独的一秒钟动作打分,也就是计算它的 advantage。
微调阶段用的公式是这样:从第 T 步先往前看 N 步,比如 N 等于 50,那就是一秒钟。优势等于这 50 步实际拿到的奖励之和,加上 50 步之后那一帧的价值,再减去当前这一帧的价值。
举一个具体的例子。假如在进这一秒前,价值函数说还需要 84 秒,所以 V at T 就等于 -84。过了这一秒钟,相当于时钟走了一秒,这 50 步的奖励之和就是 -1 秒——因为 reward 就是时间,是 -1 秒。现在价值函数说,过了这一秒钟之后还需要 80 秒就能做完,所以 V at T+N 就是 -80。算一下 advantage:-1 加上 -80 再减去 -84,正好等于 3 秒。也就是说在这一秒里面,机器人比价值函数预期的多推进了 3 秒钟,做得比平均好,所以这一步就是优势步,advantage 就是正 3。这完全相当于骑手的例子,只是单位从分钟换成了秒。
算出优势以后,论文并没有直接用这个数,而是做了一个二值化,定了一个阈值:大于阈值才算 positive,否则就是 negative。论文规定,预训练阶段只有排在示范数据前 30% 的才能记作 positive。
10.9 优势阈值怎么定:卡前 30% 还是前 40%
微调阶段放宽到 40% 左右才记为 positive。也就是说,只有跑得最快的那 30%、40% 的路径,才会被盖上 positive 的印章。具体操作很简单:先把所有样本的 advantage 算一遍,从大到小排列,然后卡阈值,卡到前 30% 或前 40% 作为分界线。π0.6 这么做是想给自己上点难度——只有真的做得非常好、排进前 30% 的数据,才能被标记为 positive。这等于逼着机器人逐渐学好。
10.10 训练样本长什么样:advantage 作为标签 token 输入
现在有了每一帧的优势,怎么让策略变好?先看一条训练样本长什么样。跟以前最大的区别是,把上一步算出来的优势作为标签 token 输入进去。标签只是输入的一部分,而同一条 episode 里相邻几帧的标签可能不一样。比如第 1000 帧的时候,优势还是正 3 秒;第 1001 帧是正 2.8 秒;到第 1500 帧可能就做错了,优势变成 negative,变成劣势。所有这些标签都会加到训练数据的 token 里,显式地参与训练。
原来的做法叫 AWR 加权回归:好样本权重高,坏样本直接扔掉。但问题是,这些数据是真实机器人花了好多时间跑出来的,非常贵,扔掉就白采了。π0.6 采用的方法是好的坏的都用,只是输入的时候加上不同标签——好的标 advantage positive,坏的同样加入训练,只是标签用 negative。这样模型既见过优势帧长什么样,也见过非优势帧、也就是错误长什么样,有利于模型做错误反馈。比如你做错了,它有利于模型知道怎么调回去。
10.11 模型架构:唯一的变化是多了一个优势标志
四步讲完,回头看看模型架构。尺寸跟以前差不多,还是 Gemma 系列加 SigLIP。输入同样是三张图,还有关节角、任务指令等等,比如“make a double espresso”。骨干会像语言模型一样先输出子任务的文本,比如先压粉,这跟 π0.5 一样;同时输出 FAST 离散动作的 token。然后 action expert 用 flow matching 输出 50 赫兹的连续动作,这些也都跟 π0.5 一样。
第四步训的那个标签 advantage positive,会插在子任务文本之后、动作之前,也就是图里那个小块。这个位置是有讲究的:它在子任务之后、动作之前,所以只有动作那部分的似然会带上这个条件,子任务的预测并不受影响。这有点像骑手先决定下一站去哪儿,然后再决定这一段怎么骑,很合理。架构其实没怎么变,唯一的变化就是输入的 token 多了这个优势标志。
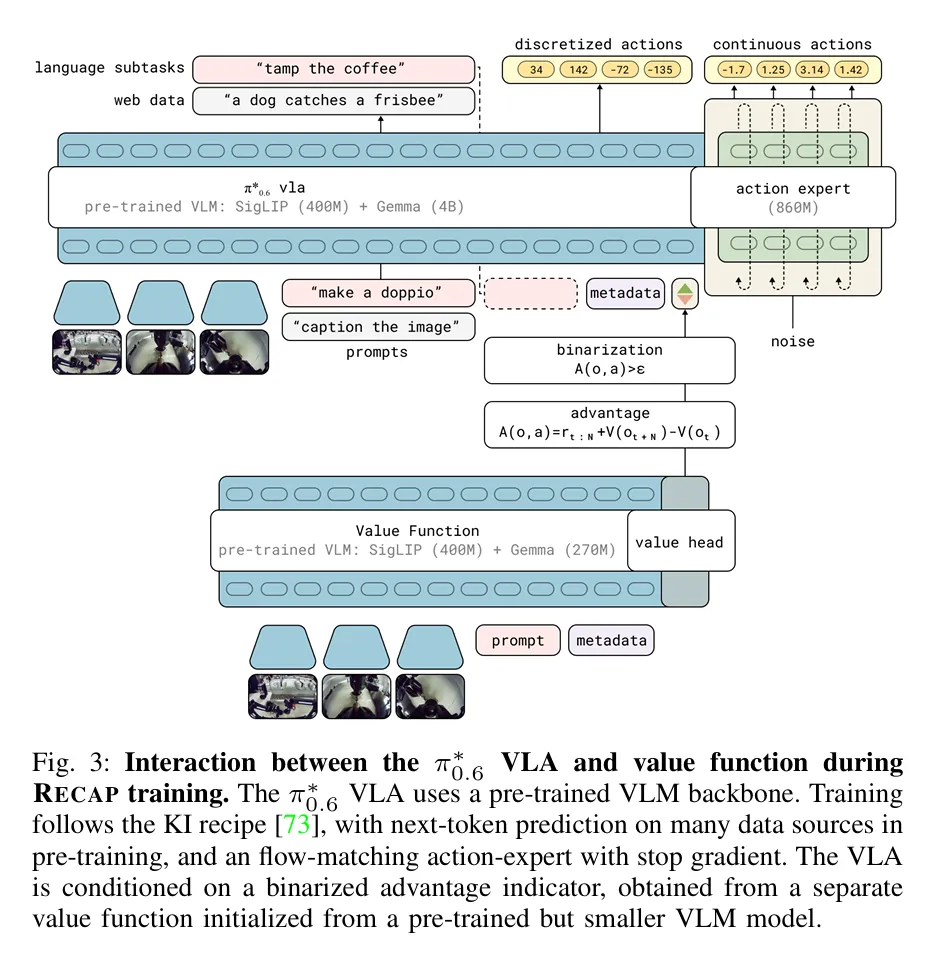
advantage token 放在子任务与动作之间,只影响动作部分的似然,不干扰子任务预测。
10.12 完整训练流程:七个阶段
接下来看完整的 π0.6 是怎么训练的,一共七个阶段。
第一阶段,先有一大堆预训练数据集,数万小时、多机器人的预训练数据。先训练价值函数 V,用监督学习的方式。
第二阶段,训练完价值函数之后,给所有数据用它标注上 advantage,每段一个。然后用这个 advantage 去训练真正的基座,同时把 advantage 加到标签里,训练 π0.6 的基座,这个产物叫 πPE。
第三阶段,用任务的人类示范,在部署的那台机器人上遥操,起点是 πPE。标签全部填 positive,做普通的监督微调。也就是操作员在部署的双臂机器人上遥操这个任务,比如做咖啡,录下来的画面、关节角等等,跟上期讲的模仿学习其实是一样的。但它的出发点是 πPE,是从阶段二预训练来的、带 advantage 接口的 π0.6 基座。训练范式还是固定好,把每条样本标签全部固定成 positive——毕竟是人摇操的数据,肯定都是正的。所以阶段三相当于一个 SFT,得到一个能在真机上跑的策略,这一步叫 π0,是模型级别的。
第四阶段,用刚训练出来的模型在真实场景上跑,让它自主成功、失败或者人工接管,采集一段真机数据。
第五阶段,用这批新数据重新反训价值函数 V,得到 V1,再用 V1 重新算一遍新数据的 advantage。这时候大概 40% 是 positive,干预阶段同样强制为 positive。然后重复二三阶段的过程,得到 π1。之后 π1 上岗,在新的场景下再有人类监督,再重复阶段四的过程。
10.13 阶段四具体在干什么:三种 episode 结局
阶段四就是 π0 在真机上跑,每条 episode 有三种可能。
第一种,纯自主跑完,成功。第二种,纯自主跑完但失败,整条会吃 C4;不过中间如果有一段纠正得好、价值回升,那这一段仍然可以标 positive。第三种,中途人类摇操接管,然后放手让它继续。比如它在手柄的时候卡住了,人类接管过来,再让它重新萃取。接管的过程就是前面说的,强制性地标 positive。
10.14 五个实验任务与结果
实验有五个任务。比如从框里取出 T 恤和短裤,摊平折叠,这是 200 秒的时间,并且要包含多样的衣物——毛巾、衬衫、牛仔裤这些都要有。还有做咖啡的任务,需要磨豆、压粉、锁手柄、萃取出品等等,要求是不打不撒不掉。另外还有一系列工厂任务,比如需要平板、折箱、贴标,再放进货箱里,需要 600 秒。
结果很厉害。先看吞吐量,就是每个小时成功完成多少次任务,这个数越大越好。四张图,每张图最右边是 recap 图,可以看到最终版本比前面几版都好很多,而且每迭代一次准确率都会提升,说明 RL 迭代本身非常有用。成功率也是一样。总之 π0.6 是一个真正可以在很长时间、在具体场景下完成复杂任务的模型。
11. π0.7
11.1 π0.7 能做什么:四种能力
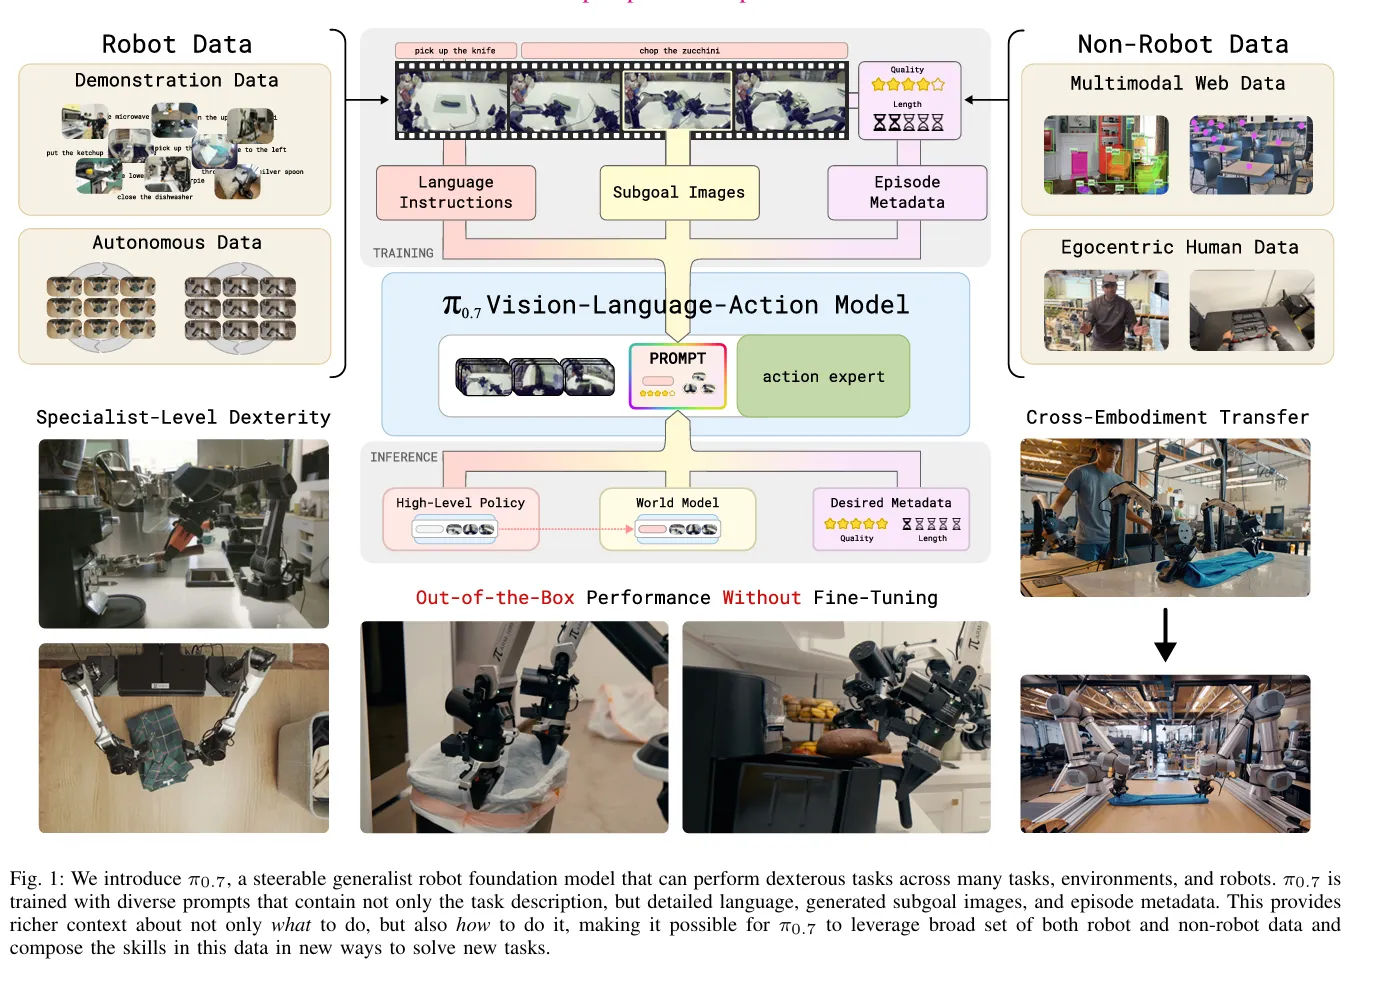
以上就是 π0.6。接下来看这个系列的最后一个模型,也是最强的模型——π0.7。它是 Physical Intelligence 在 2026 年 4 月发布的,基本上能代表当前 VLA 的最高水平之一。
先看 π0.7 能做什么,跟以前的模型相比提升在哪儿。论文引言里列了四种能力。
第一种,开箱即用,并且能完成复杂的灵巧任务。比如做浓缩咖啡,还包括叠衣服、换垃圾袋、削皮等等。可能有人会说这些任务 π0.6 也能做,但注意“开箱即用”这四个字。要让 π0.6 去做烧咖啡的任务,它需要在这个任务上微调 RL 模型,经过好几段微调才可以,做一个专家型的模型。π0.7 完全不用——它是一个通用模型,可以在任何场景下直接泛化去完成复杂任务。这是它和前代模型最大的区别:不再需要 specialist 上的微调。
第二种,指令泛化。π0.7 可以做到人在旁边说一句,比如“你打开左边的抽屉,把胶带放进这个抽屉”,它就会根据语言一条一条地做,指令跟随性非常好。
第三种,跨机器人本体。视频里这个双臂 UR5e 从来没做过折衣服的训练,用了 π0.7 之后,可以在零样本的情况下把叠衬衫的任务做好,而且水平跟专家遥操作员第一次操作这台机器人相当,这非常了不起。
第四种,组合式任务泛化。它用没见过的方式把已有技能组合起来。比如旁边人用语言教它把红薯放进空气炸锅,它之前可能没见过这个任务,但经由模型在海量任务上的原子指令训练,它可以了解到如何把这些原子指令组合起来。这有点像 LLM 里的涌现现象。
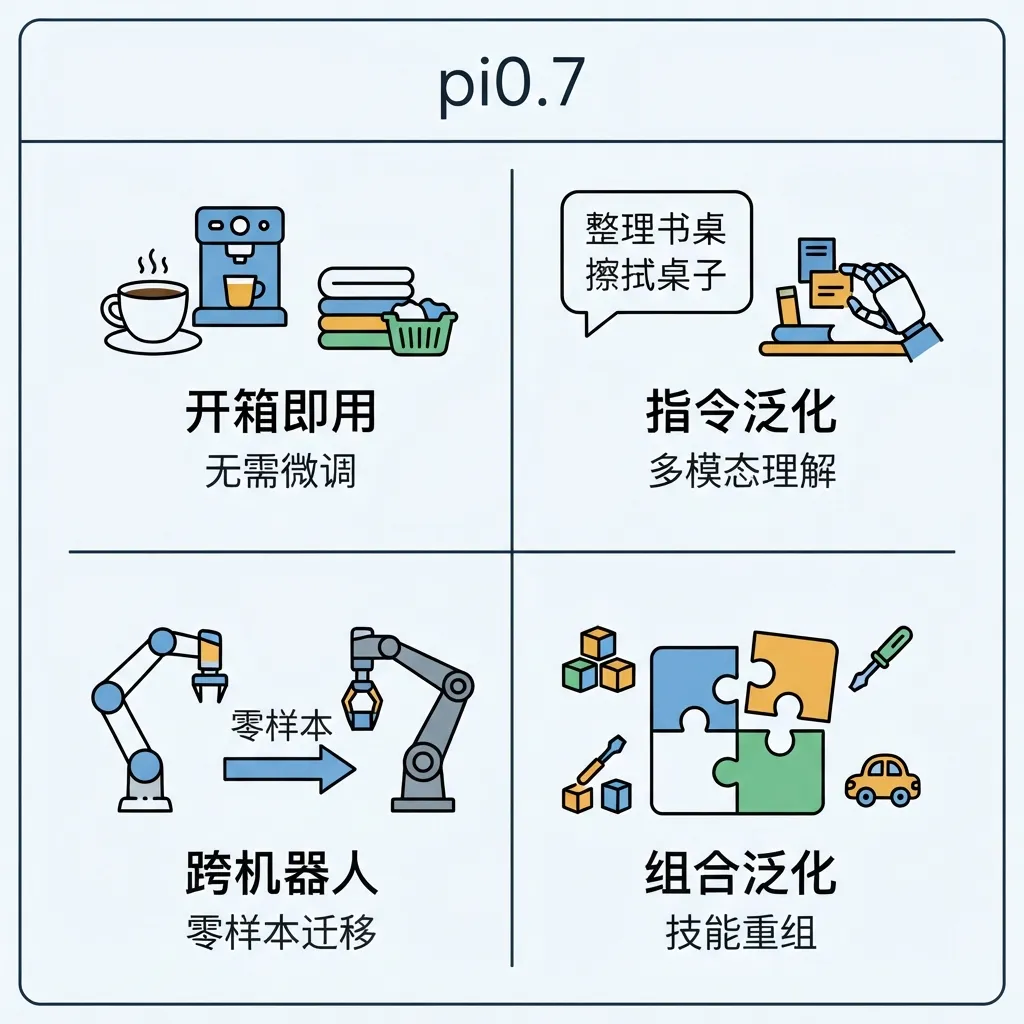
π0.7 无需针对任务微调即可开箱完成灵巧任务,并具备指令、跨本体和组合泛化能力。
11.2 铺垫工作 MEM:给 VLA 装上记忆
介绍 π0.7 之前,先介绍一篇铺垫工作——MEM,全称 My Skill Embodied Memory,多尺度具身记忆。它是 π 和 Stanford、Berkeley、MIT 一起做的,2026 年 3 月发布,紧跟着 4 月就发布了 π0.7。
它解决的问题就是给 VLA 装上记忆。π0、π0.5、π0.6 其实都没有记忆,输入只是当前看到的这一帧画面,做不了需要记住之前发生什么的任务。比如跟之前的模型说“你要去擦 3 块玻璃”,它可能就记不住“这块玻璃已经擦过了”,这非常不利于现实生活的泛化。
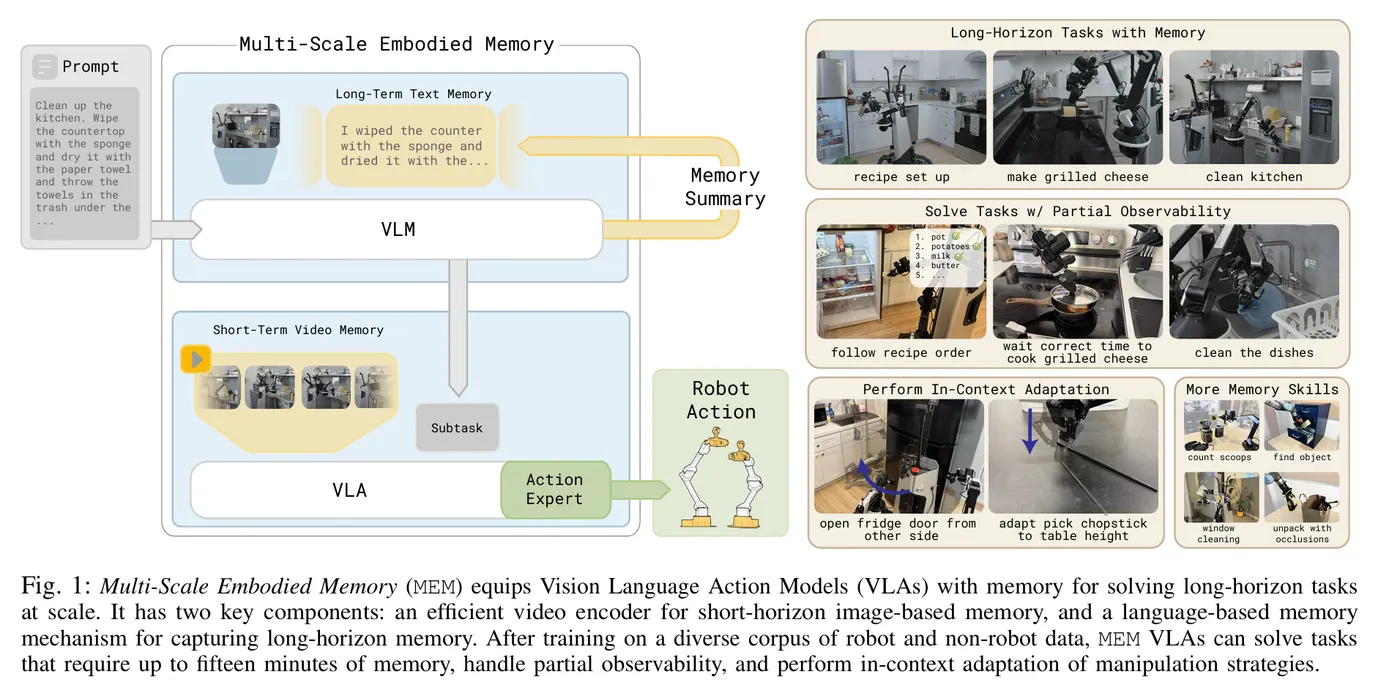
MEM 把 VLA 需要的记忆分成两种。
一种是短期记忆,它是稠密的,是最近几秒的图像画面,用来处理遮挡、判断东西是不是移动过、或者需要换一种抓法等等。这种短期记忆需要大量图像,但不需要很长,几秒钟就够。
另一种是长期的语义记忆。比如告诉一个做饭机器人“这个盐已经加过了”,或者“你这个门还没关”,这类信息量可能只有几个 bit,可能只是一句话,但需要维持几十分钟,让 VLA 模型记住。像这种长期记忆,把所有的历史帧都塞进上下文并不现实。
MEM 的做法是分成两级。短期记忆放在底层,用一个改造过的视觉编码器,把最近几秒的画面压缩进当前帧的表示,有点像 V6 encoder。长期记忆放在高层,具体做法是高层策略除了每一步输出下一条子任务之外,还会输出一段更新过的语言摘要,比如“我已经擦过这个台面了”“我已经放过盐了”。下一步的时候,需要读取这个摘要,并且对摘要进行更新。这样就能保证底层的机器人已经明白“我已经做过这些事了”,维护了一个长期记忆。
底层记忆的部分其实就是 ViT。一般的视觉编码器 ViT 是一帧一帧独立编码的,每一层做的就是帧内部的图像块之间做稠密的 attention。MEM 做的就是每隔四层插一层时间方向的注意力,它可以在相同 token 上看到之前的历史,而且是因果的,只能看到过去看不到未来。好处是不引入新的参数,因为它只加了一个时间上的位置编码,所以历史为零的时候就跟原来的 ViT 完全一样,预训练权重可以复用。原理是:加了这个时间维度的 attention 之后,当前块就有了所有历史帧的信息,它就不代表仅仅是当前帧。所以输到 VLA 模型的时候,其实就隐含地保证了有前面几帧的信息在。π0.7 直接复用了这种视觉编码器,它的 memory 完全沿用了 MEM 这篇的工作。
11.3 π0.7 要解决的问题:组合泛化
π0.7 主要要解决的问题,是大语言模型有一种能力叫组合泛化(compositional generalization)。它不只是记住了训练数据,还能把这些没见过的能力用新的方式组合起来,这就是涌现能力。VLA 目前为止还没有这个能力——当前的 VLA 模型不但做不了新任务,连训练过的任务可能还需要再做一次专属的微调才能流畅执行,π0.6 就是这样。
一个自然的想法是:为了让它出现涌现能力,可不可以学 LM,用更多的数据、不同机器人的数据、不同的策略、包括失败数据等等,一起去训这个模型?但这里有个坑:由于数据质量、做法各不一样,如果直接混在一起学习,模型一视同仁地拟合,很可能学到不同模式的平均值,结果肯定是次优的。所以需要对这些数据进行更细粒度的标注,这就是 π0.7 做的。
11.4 π0.7 的数据构成:自主数据与非机器人数据
看 π0.7 的数据构成.总共两类。
第一类是示范,在实验室、仿真、还有真实的家庭里,用静态、移动、单臂、双臂各个平台的遥操数据,这部分和前面是对齐的。
第二类是重点加进来的自主数据,也就是模型自己跑出来的大量 episode,包括 π0.6 做强化学习时的大样 rollout,其中不乏非常多的失败数据,还有人类中途接管的数据等等。这些数据是 π0.7 的一个亮点。
右边还加了大量的非机器人数据,比如人类的第一视角视频(egocentric),这是相对 π0.5 新加的,还有网页上的数据,比如属性预测、视觉问答。
跟之前的 VLA 训练最不一样的一点,是它使用了大量次优的机器人数据,把 π0.6 在强化学习训练时的数据也加进来了,相当于让 π0.7 去蒸馏那些 RL specialist 的行为,所以这个通用模型继承了所有 specialist 的能力。而且次优数据让每个任务的状态更加多样,鲁棒性更强,有时候还会超越专家模型。
11.5 每条数据长什么样:更细的标注
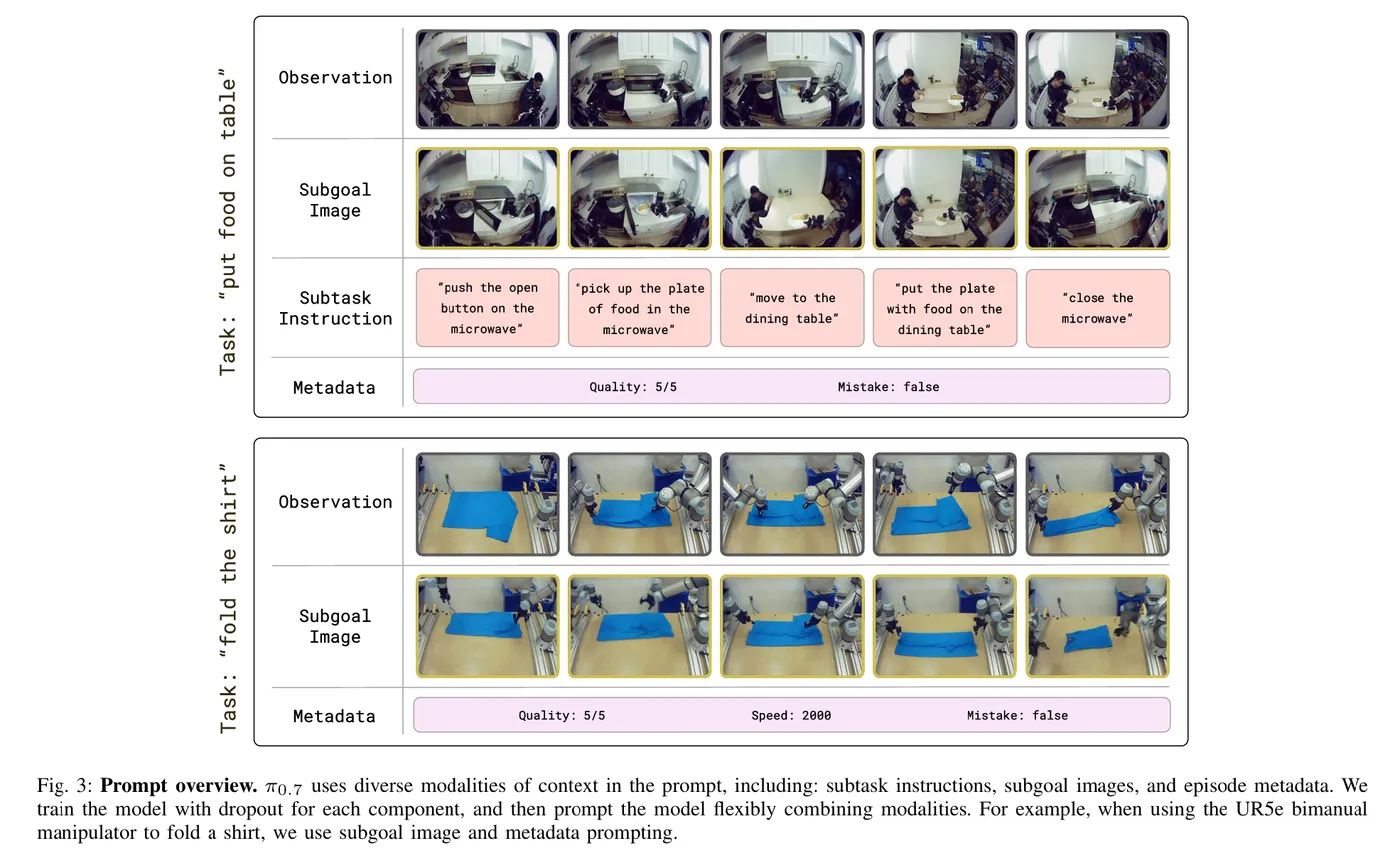
大量的失败数据肯定需要更细致的标注。以“把食物放在桌子上”为例,看 π0.7 里每条数据长什么样。
第一行是当前的相机观测。第二行多了一个子图,这是世界模型的输出,后面会讲,它相当于在预测执行完这个任务之后世界会变成什么样子,作为另外一系列输入。第三行是子任务指令,做法是把 episode 切成一段一段,每段由人工写一句非常详细的标注,这个标注可能比 π0 到 π0.6 更加细粒度。最后一行还有元数据标注,包括这条数据做得怎么样。
π0.7 相对于以前,对数据的标注更细,输入的粒度也更细,还多了子图输入。另外值得一提的是,从 π0.6 开始这一系列工作就不开源了,可能因为它接近于商用机器人的雏形。论文本身对数据部分的描述也非常少,完全没有说数据分布这些信息。
11.6 元数据怎么标:速度、质量、失误、控制模式
元数据的标注是为了能用低质量的数据。π0.7 里加了很多不理想的轨迹,比如失败的示范、成功但失误很多的示范,还有旧模型自己训出来的数据。为了更好地利用这些数据,就得告诉模型这条数据到底怎么样。具体有三项。
第一项是整体的速度,一个 episode 一共用了多少时间步,这个用光流可以算出来。一般来说,快的 episode 通常也是失误比较少的。
第二项是整体的质量,π0.7 给每一条 episode 打了一个 1 到 5 分的分,5 分最高,这个应该是人来标注的。
第三项是有没有失误,标记当前这一段动作里机器人有没有错误,是一个布尔的二值变量。
最后一项是控制模式,是关节控制还是末端控制。说实话这两个词作者也没太搞清,它跟机器人的操控有关系。之前的评论区也有人问,所以这里稍微详细介绍一下控制模式和机器人的一些知识。
什么叫关节控制和末端控制?这两种都是说机器人接下来该怎么动,只不过表示形式不一样。看关节控制,左边这条机械臂有 6 个自由度。6 个自由度的意思是有多少能够独立转动的关节,每个关节里面有一个电机和一个编码器。在关节控制模式下,模型的输出动作就是这 6 个关节各自该旋转到多少度,最多再加一个夹爪的开合,一共是 7 个数,θ1 到 θ6 再加上夹爪。这些数字只描述机械臂自己每个轴的转角,和这台机械臂的臂长、关节是绑死的。
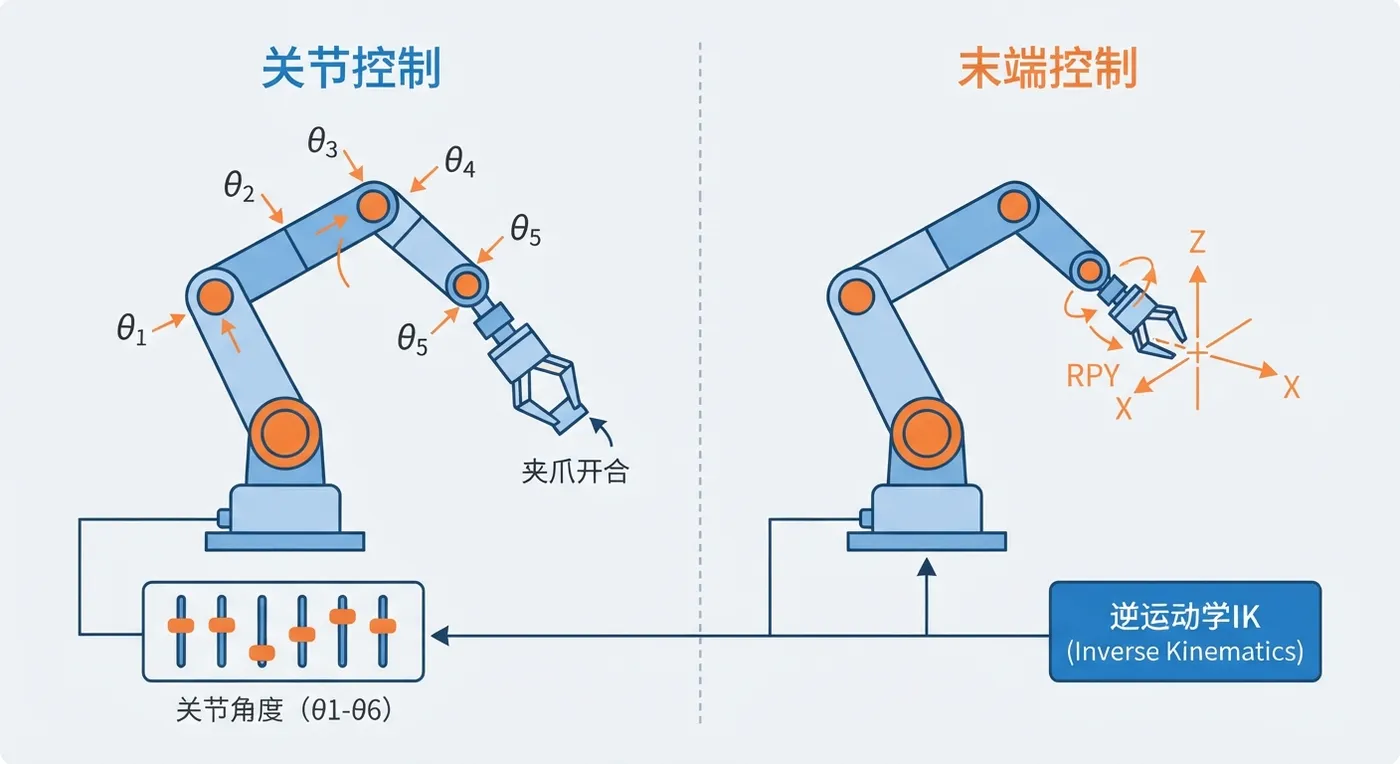
关节控制输出各关节角度与本体绑定,末端控制输出空间位姿并需IK反解成关节角。
11.7 关节角还是末端位姿:两套动作表示的分歧
接着上一节的控制模式标注往下说,得先把这两套表示本身讲清楚,因为 π0.7 之所以要在 prompt 里显式标出控制模式,根子就在这里。
关节控制,输出的是每个关节该转多少度。这个数字跟机械臂本体是绑死的——换一台臂,同样的数字对应的可能就是完全另一个姿势。这也是为什么跨机器人(cross-embodiment)这件事在关节空间里特别难做。
末端控制(end-effector control)走的是另一条路:模型不去管六个关节各自怎么动,只输出夹爪应该运动到空间里的哪个位置、朝哪个方向。一共 6 个数——先是 XYZ 三个空间坐标,再加上朝向,朝向用 RPY(roll、pitch、yaw)三个夹角来表示,然后再加上夹爪本身,合起来是 7 个数。
问题来了:电机只认关节角,它不认识 XYZ 这些坐标。所以末端控制器通常还得配一个翻译器,也就是逆运动学求解器,简称 IK。IK 干的事就是根据末端的目标位置,反推出要让末端到达那里,这 6 个关节各需要转多少度,算完再交给电机。
回头对一下前面讲过的内容:RT-2 那个 8 维动作里,有 6 个数就是末端位置和旋转的增量,说明 RT-2 和 OpenVLA 用的都是末端控制。很多开源数据集也采用这种末端控制的表示。而 π0 到 π0.6,公开的动作全部用的是关节控制的关节角。
那 π0.7 为什么要在 prompt 里显式加入关节控制这个标注?原因在数据量。π0.7 论文里说,末端表示的数据太多了,两种表示混在一起学、又不标出来,同一个画面就会对应两套完全不同的目标值,模型有可能去取平均。所以必须显式标清楚:当前这段数据用的是末端控制,还是关节控制。
11.8 从 π0 到 π0.7:输入 prompt 的演进
顺着这个思路,正好可以把 π0 到 π0.7 的训练输入摆在一起对比,看每一代多加了什么。
π0 最简单:当前观测图片,加上 task,再加上本体状态,就够了。
π0.5 多了一个子任务(subtask)。因为 π0.5 是分两步走的,第一步由高层先出子任务,第二步再做低层控制,所以输入里必须有这个 subtask。
π0.6 在 subtask 的基础上,因为用了强化学习,每段任务都有标注,所以输入里多了一个优势(advantage),标明它是 positive 还是 negative。
π0.7 的标注明显更细:多了一个子目标图(这个后面讲世界模型时会展开),多了对每一段数据的速度、质量(quality)、是否出错的标注,再加上刚说的关节控制,以及本体状态。
把这条线拉直了看,从 π0 到 π0.7,输入的标注力度是一代比一代细的。
11.9 架构总览:两个"小弟"和 coaching 模式
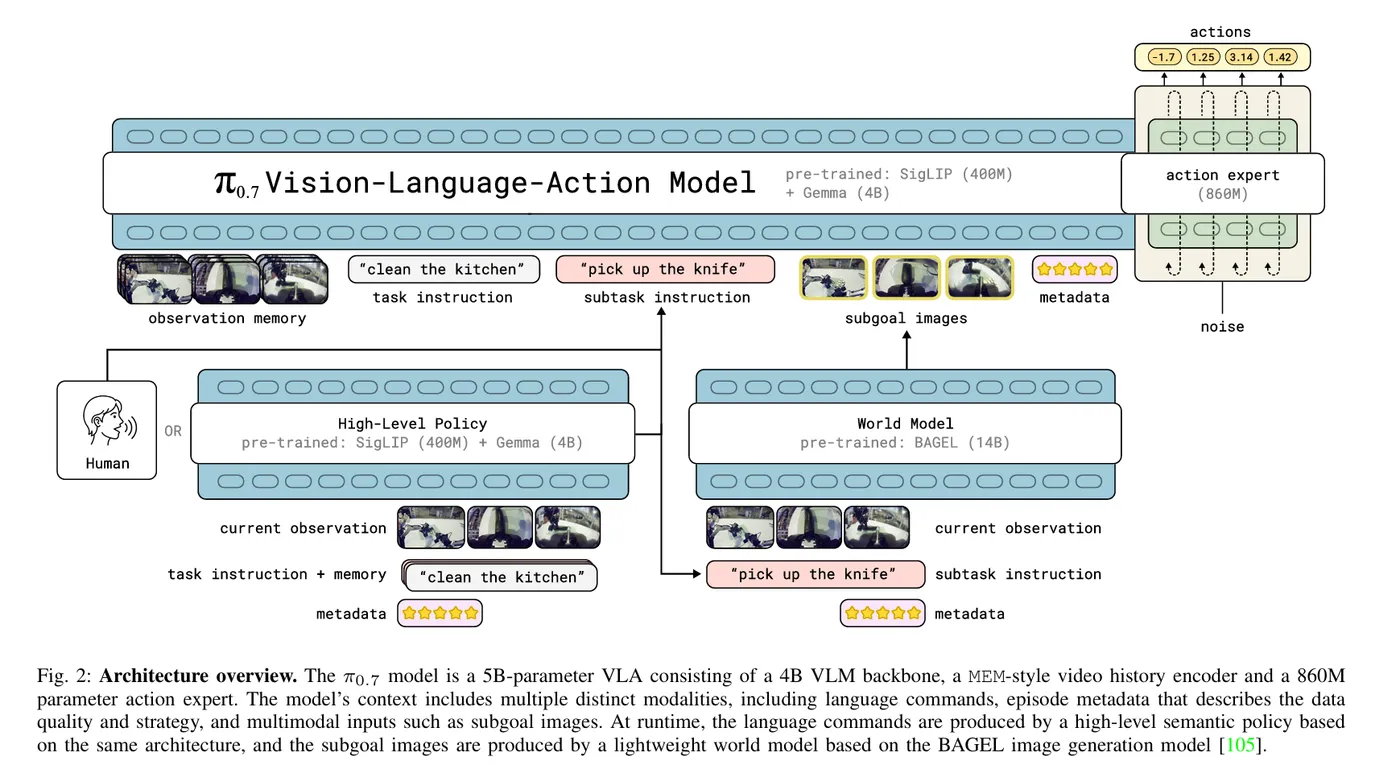
说完数据,看架构总览图。整体结构其实大差不差,还是 Gemini 模型加 action expert 那套骨架,但 π0.7 多了两个"小弟"。
第一个是高层策略(high level policy),负责把一个高层任务分解成不同的子任务。π0.5 的时候这两件事是合在一个模型里的,π0.7 把它拆成了两个模型。虽然拆了,但训练数据肯定有一部分是重叠的。
第二个是视觉模型,负责输出刚才说的子目标图。它的输入是当前已有的帧,输出是机器人执行完这些动作之后、世界将来可能长成的样子。可以把它理解成一个视频生成器,生成的图像就是未来预测的帧。
这两个小弟的输出同时喂给 π0.7,这就是它的总体架构。
除了高层策略,π0.7 还加了一个 coaching 模式:人一步一步地说,在旁边给它发细粒度的指令。看上面那张图,它不光支持文本直接输入,还支持人直接注入子任务。论文里举了个例子——如果直接跟模型说"把红薯放进空气炸锅",它可能会失败;但这时候有人在旁边做 coaching,用人把它一步步拆开,比如说第一步干什么、第二步干什么,它就很快做完了。这是高层策略的一个变化:不只支持模型的输入,还支持人在旁边直接用语音去控制它。
11.10 世界模型与子目标图:π0.7 最大的改动
第二点要单独说,就是世界模型和它生成的子目标图,这是 π0.7 最大的一个改动。
子任务指令说的是意图,但缺乏执行的细节。比如"打开冰箱门",它并没有说清楚具体怎么打开。子目标图补的就是这块:直接用一张图告诉模型,接下来这段动作做完之后,世界应该长成什么样子。这就是世界模型的定义。
它是多视角的。前置相机和两个腕部相机各出一张:前置相机的图适合表达物体和环境该变成什么样,腕部相机的图适合表达手和夹爪该夹到哪里。
说白了,世界模型的输入是当前的一些动作,输出是执行完这个动作之后世界有可能变成的样子,然后把这个子图再输给 π0.7 模型。
这个模型从一个 Bagel 模型、14B 初始化,用 flow matching 训练。论文里说训练数据包含三部分:
- 第一部分是机器人在数据子任务里标注得特别好的一个子集。作者发现分段标注的质量对生成影响非常大,因为视频生成需要高质量的数据。
- 第二部分是人类第一视角(egocentric)的视频。
- 第三部分是开源的图像编辑和视频数据集,用来保住从网页预训练里带来的语义知识。
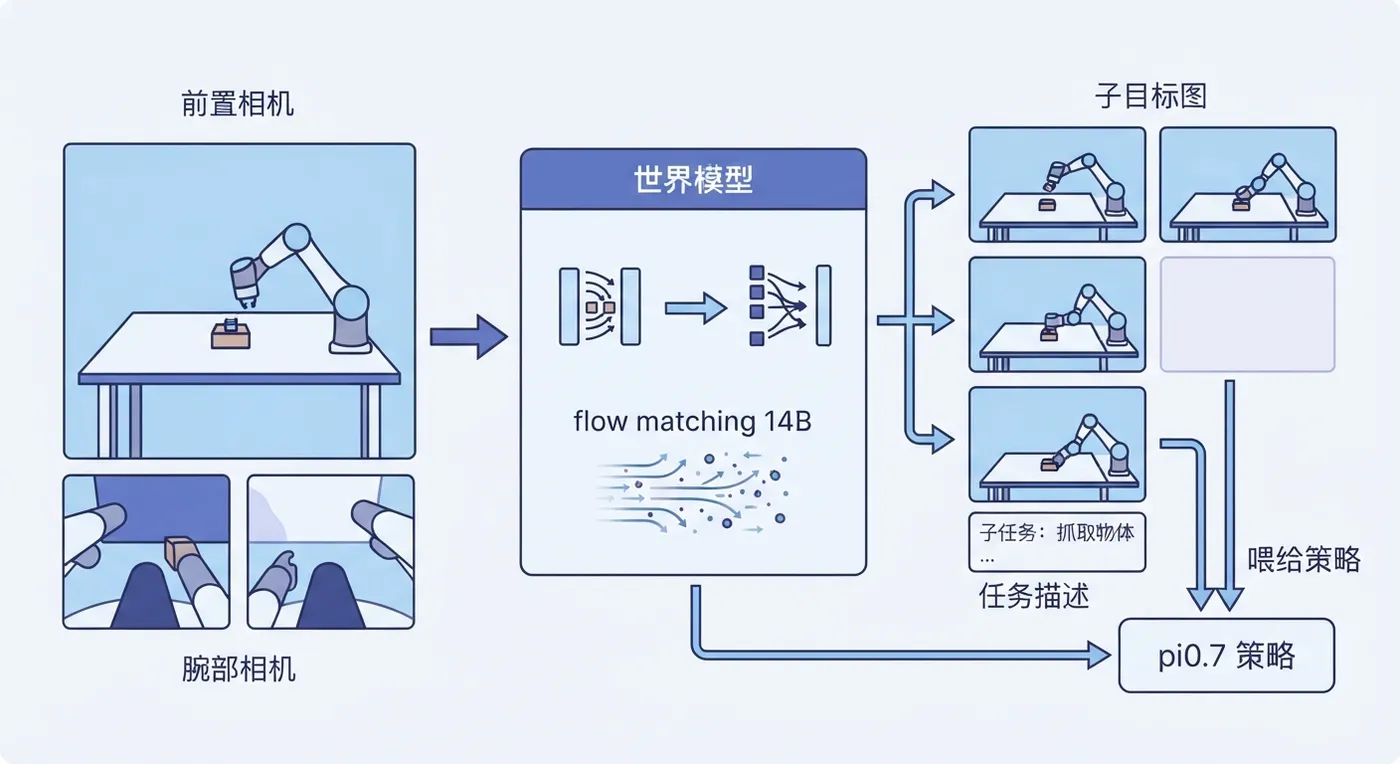
世界模型预测动作执行后世界的样子,用前置与腕部视角的子目标图补足子任务缺失的执行细节。
11.11 训练策略:dropout 与"模型偷懒"
训练部分其实和之前差不多,也是 flow matching、离散 token 那一套。但它有一个重大的策略:dropout。
dropout 就是在训练时随机把上下文的某个成分去掉,这么做有两个目的。第一是保证灵活性——每一样都随机丢过,测试的时候假如某个模态没有了,它也能正常完成任务。第二是防止某种退化。
作者发现,加了世界模型的目标子图之后,模型训练快非常多,快到不太正常。后来查明原因:有了未来的画面,预测动作这件事就退化成了逆动力学——根据画面反推关节角。模型会偷懒,只去学世界模型那部分动作,退化成纯世界模型。这不是想要的结果。
所以训练时保证只有 25% 的样本带目标子图。在这 25% 带子图的样本里,又把其中 30% 的文本随机丢掉。原数据整体还会丢 15%,其他三个分量各再随机丢 5%。也就是训练时随机丢掉一些信息,来提升鲁棒性。
11.12 推理流程与部署成本
推理的时候,三个模型是异步跑的。流程大致是:高层策略或者人先给出子任务指令,世界模型拿到当前观测和这句子任务,生成 3 张子目标图,然后 π0.7 拿观测、子目标图、子任务和原数据输出动作。
速度方面,策略模型本身在单张 H100 上就能推理——前提是不加那两个小弟,也就是只用三路相机加上五步去噪一次性推理,可以达到 38 毫秒。如果把历史编码器、子目标图这些全打开,最坏情况是 127 毫秒,大头在世界模型上,因为它模型很大,序列将近 1 万个 token,需要做四卡张量并行,再加上一些量化才能部署。整套 π0.7 系统想跑起来,至少需要 5 张 H100。
11.13 实验:开箱即用与指令跟随
实验部分的特点就是前面讲的"开箱即用"。同一个 π0.7,不做任何微调,就能做不同的任务:处理多样的衣服、自主换垃圾袋、切西葫芦、把 T 恤叠好再翻面等等。同一个模型干不同的活,这是它最大的亮点。
而且它一个模型还能追平 4 个在 π0.6 阶段用 RL 针对不同场景专门训练的 specialist 的性能,基本可以追平,这是很大的进步。
文章还做了消融:如果去掉一些 π0.6 自己跑出来的自主数据,结果会掉点。
指令跟随的实验是在 14 个没见过的家里做的,指标是所有指令被正确执行的比例。结果是:厨房场景里 π0.5 大概 28%,π0.6 大概 54%,π0.7 到了 87% 左右。
还有一个跨机器人(cross-embodiment)实验,测的是模型能不能在一台完全没有该任务数据的机器人上完成任务。相比前几个模型,它在 UR5E 上做叠衣服这类任务的性能是最好的。
还有一个消融值得记:对于那些低质量数据,如果没有对原数据的标注(quality 为 B 的那些),性能反而会降;但有了这些标注,它就成了训练很好的养分。所以数据可能不是关键,标注才是关键。
11.14 局限性
文章自己也说了局限。在从来没见过的任务上,也就是任务和机器人的组合,成功率只有 60% 到 80% 左右,还有 20% 是不成功的。
另外一点,π0.7 用的数据量太杂,所以也说不清楚是不是真的"没见过"——有可能泛化主要来自重叠的已有技能。这一点文章明确写了。
12. π 系列回顾与下一步
12.1 四代模型各解决了什么
到这儿,VLA 这条线上最重要的一个系列——π 系列——就全部讲完了。回头快速过一遍。
π0 定下了基本形态:拿一个视觉语言模型当骨架,外挂一个 action expert,用 flow matching 一次出一段动作,把速度提上去,并且开源了 open pi。到现在为止它还是大家复现时最重要的基线,是这个领域的标志性工作。
π0.5 在数据上下功夫,从一类的动作数据扩展成五类一起训,同一个模型先出子任务、再出动作,把高层和低层接在了一起。
π0.6 把强化学习加进来,让模型从自己跑出来的数据里学,通过一轮一轮迭代,完成像连续 13 个小时做咖啡、在工厂里装真实用的纸箱这类复杂任务。
π0.7 接上了 MEM 的记忆,数据上把大量次优数据、RL 跑出来的数据、人类视频全部收进来,通过细粒度标注变成输入的一部分;同时接了一个世界模型,生成子目标图和原数据一起给到模型。结果就是一个模型不需要做任何专属微调,就接住了前面所有专家模型干出来的活。
到这一步,它已经算得上一个名副其实的机器人模型了,可能代表了 VLA 这条路线上目前公开能力的上限。可惜没开源。
参考文献
参考文献
- 可 lip.《一口气看懂 VLA:从机械臂关节到 π0.7,具身智能的完整技术脉络》[视频]. 抖音. https://v.douyin.com/mUcgRebkPzQ
- RT-1: Robotics Transformer for Real-World Control at Scale. arXiv:2212.06817, 2022. https://arxiv.org/abs/2212.06817
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control. arXiv:2307.15818, 2023. https://arxiv.org/abs/2307.15818
- OpenVLA: An Open-Source Vision-Language-Action Model. arXiv:2406.09246, 2024. https://arxiv.org/abs/2406.09246
- π0: A Vision-Language-Action Flow Model for General Robot Control. arXiv:2410.24164, 2024. https://arxiv.org/abs/2410.24164
- FAST: Efficient Action Tokenization for Vision-Language-Action Models. arXiv:2501.09747, 2025. https://arxiv.org/abs/2501.09747
- Hi Robot: Open-Ended Instruction Following with Hierarchical Vision-Language-Action Models. arXiv:2502.19417, 2025. https://arxiv.org/abs/2502.19417
- π0.5: a Vision-Language-Action Model with Open-World Generalization. arXiv:2504.16054, 2025. https://arxiv.org/abs/2504.16054
- π*0.6: a VLA That Learns From Experience. arXiv:2511.14759, 2025. https://arxiv.org/abs/2511.14759
- MEM: Multi-Scale Embodied Memory for Vision Language Action Models. arXiv:2603.03596, 2026. https://arxiv.org/abs/2603.03596
- π0.7: a Steerable Generalist Robotic Foundation Model with Emergent Capabilities. arXiv:2604.15483, 2026. https://arxiv.org/abs/2604.15483
- PaLM-E: An Embodied Multimodal Language Model. arXiv:2303.03378, 2023. https://arxiv.org/abs/2303.03378
- Sigmoid Loss for Language Image Pre-Training (SigLIP). arXiv:2303.15343, 2023. https://arxiv.org/abs/2303.15343
- DINOv2: Learning Robust Visual Features without Supervision. arXiv:2304.07193, 2023. https://arxiv.org/abs/2304.07193
- Llama 2: Open Foundation and Fine-Tuned Chat Models. arXiv:2307.09288, 2023. https://arxiv.org/abs/2307.09288
- Gemma: Open Models Based on Gemini Research and Technology. arXiv:2403.08295, 2024. https://arxiv.org/abs/2403.08295
- PaliGemma: A versatile 3B VLM for transfer. arXiv:2407.07726, 2024. https://arxiv.org/abs/2407.07726
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models. arXiv:2310.08864, 2023. https://arxiv.org/abs/2310.08864
- BAGEL: Emerging Properties in Unified Multimodal Pretraining. arXiv:2505.14683, 2025. https://arxiv.org/abs/2505.14683



