
一个反复被观察到的现象:内容投放量翻倍,可见性却没有同步增长;有些项目甚至在加大投放之后,指标不升反降。
直觉上这说不通——发得更多,被看到的概率总该更高。但检索系统不是按"数量"计分的。这篇讲清楚权重分级这件事,以及为什么铺量会走向负收益。
一、信源不是平等的
在检索系统里,不同来源的权重差异是数量级的,而不是百分比级的。
粗略地分层,可以看到这样的结构:
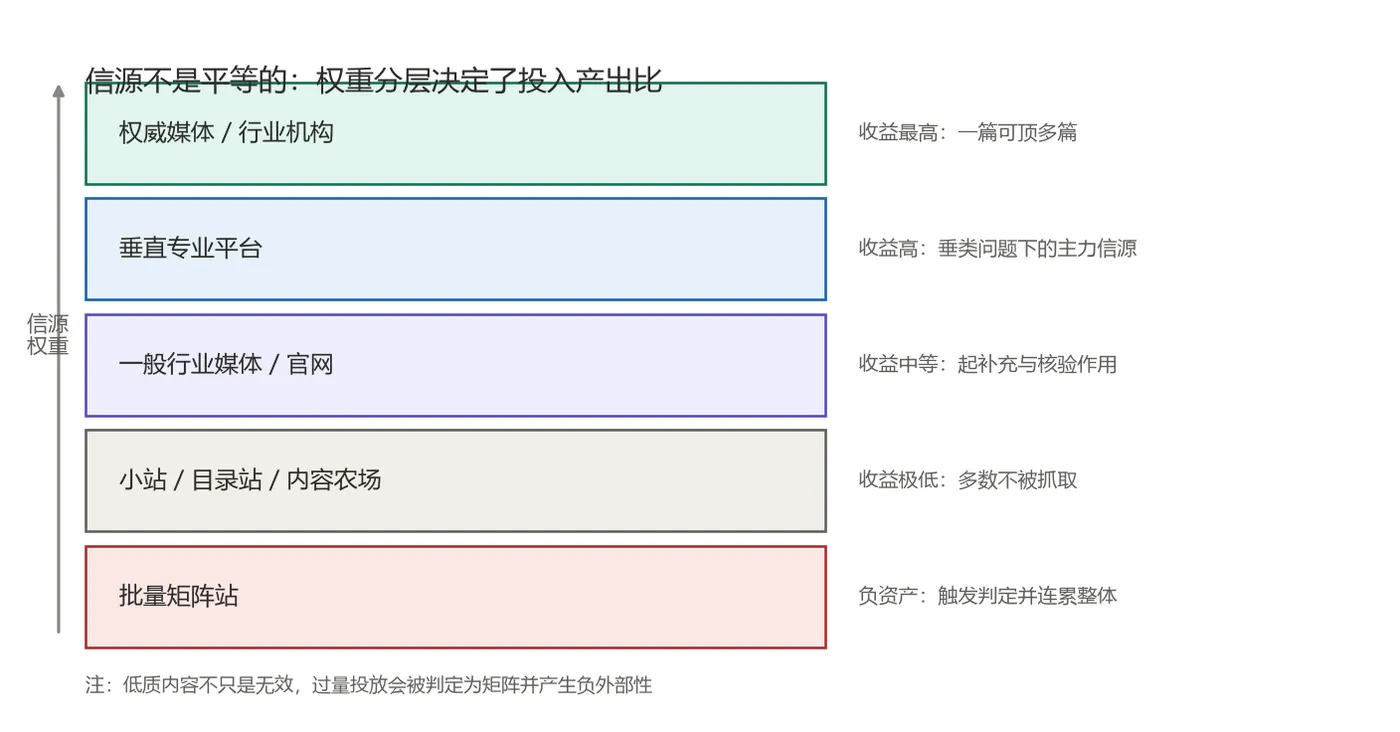
- 权威媒体与行业机构:权重最高,在绝大多数问题里都能稳定进入候选,一篇的效果往往超过普通站点多篇;
- 垂直专业平台:在所属垂类的问题里权重极高——汽车问题里的专业汽车媒体、金融问题里的财经社区,常常是主力信源;
- 一般行业媒体与企业官网:起补充与交叉核验作用,单篇收益中等,但胜在可控;
- 小站、目录站、内容农场:权重极低,多数情况下根本不会被抓取;
- 批量矩阵站:不只是无效,而是负资产。
这个分层的直接推论是:投放的收益不取决于篇数,取决于篇数乘以权重。在低权重层投入一百篇,其期望收益可能还不如在高权重层投入一篇。
理解权重从哪来,比记住分层更重要。粗略地看,它至少由两部分相乘构成:一部分是来源级先验——域名或平台的整体可信度,由历史表现、外部引用、是否被结构化数据源收录等因素共同决定;另一部分是内容级质量分——单篇内容的原创度、信息密度、结构化程度、更新状态。
相乘关系意味着一件事:来源级先验过低时,内容级质量分再高也抬不动总分。这就是"在小站上发精品"几乎必然无效的原因——不是内容不够好,而是它乘上了一个接近零的系数。反过来,高权重来源上的一篇中等质量内容,往往就能稳定进入候选。
二、低质内容不是"无效",是"有害"
很多人默认最坏的结果是"白发了"。实际上还有更糟的一种:过量投放会触发反作弊判定,并连累整体。
检索系统识别营销矩阵并不困难,信号非常明显:不同域名但结构雷同、数据口径高度统一、结尾都指向同一个对象、内容之间缺乏独立信源佐证。当一批内容同时具备这些特征时,系统不是简单地"忽略"它们,而是会给它们打上标记。
麻烦在于这个标记会外溢:它不只让这批内容失效,还会削弱与之关联的实体在整体上的可信度评分。也就是说,在低质层的大规模投放,可能让你在高权重层已经建立的基础一起被降权。这是负外部性,也是铺量最危险的地方。
三、为什么边际收益会转负
把上面两点合起来,可以得到一条和直觉相反的收益曲线:
- 初期:内容稀缺,每增加一篇都能带来可见性提升,此时数量确实有效;
- ** plateau 期**:核心问题已被覆盖,新增内容大多是重复表述,边际收益迅速衰减;
- 负收益期:继续在同一批低权重渠道上加密投放,触发矩阵特征识别,整体权重被下调。
问题在于,很多团队的资源分配仍停留在第一阶段的经验里——用"发了几篇"当工作量指标,用"有没有被提到"当效果指标。这两个指标都无法反映权重结构,于是投入越多、越不知道自己处在曲线的哪一段。
四、正确的分配方式:先归因,再投放
既然收益由权重决定,那么合理顺序应该是:先搞清楚哪些来源真的在起作用,再把资源压上去。
这个"搞清楚"的动作,就是信源归因。它的做法是拆解回答的实际引用构成——这次回答引用了哪些域名、哪几篇具体内容、各自占比多少。把多次采样的结果聚合起来,就得到了一份"真正起作用的来源清单"。
有了这份清单,资源分配会发生明显变化:
- 从广撒网转向定点投放。原本分散在一百个渠道的预算,可以集中到真正被反复引用的十来个来源上。省下来的不只是成本,还有被判定为矩阵的风险。
- 区分"被检索到"和"被采信"。这两个数字应当分开统计——前者只是进入候选池,后者才是真正进入回答。两者的差距越大,说明你的内容在可信度筛选这一层损失越严重。
- 用统计量而不是单点结果下结论。生成式回答有随机性,一次查询的结果没有统计意义。可观测的指标应该是提及率、首位率、正负向占比这类比率值,并且必须附带采样方式、样本量与时间窗口。
- 把竞品放进同一张表里。可见性是相对的:你在动,竞品也在动。同一组基线问题下,把竞品的位次变化和它的引用来源一起观测,才能解释"为什么被反超",而不是只知道"被反超了"。
五、一个更根本的转变
铺量失效背后,其实是评价逻辑的迁移:从数量逻辑转向权重逻辑。
在数量逻辑里,核心指标是覆盖面和篇数,优化动作是"多发、多铺、多覆盖";在权重逻辑里,核心指标是"在哪些来源上有位置",优化动作是"定位高权重来源、提高单篇质量、做跨源交叉印证"。
后者对工程团队更友好,因为它可测量、可归因、可迭代——不再依赖对黑盒的猜测,而是回到两个能稳定执行的问题:我的内容在哪些来源上有位置?这些位置的权重是多少?
六、写在最后
如果一个内容项目的可见性长期不随投放量增长,通常不是不够努力,而是资源压在了权重曲线的错误位置。
先做一次归因,看清真正起作用的来源,再决定接下来发什么、发在哪。这比再加一百篇要有效得多。
作者长期关注大模型应用与内容生态,以上为结合公开资料的工程观察,欢迎在评论区交



