
 引言:数据治理的断层困境
过去五年,大量企业完成了数据中台的基础搭建,打通了ERP、CRM、MES等核心业务系统。然而一个普遍困境随之浮现:平台建好了,数据接进来了,业务部门却依然感受不到变化。IDC调研显示,超过70%的中国企业在数据整合与实时分析环节仍面临业务瓶颈,86.2%的企业因治理能力不足导致数据价值转化滞后。Gartner也曾预测,到2027年,80%的数据与分析治理举措可能因缺乏业务驱动力而失效。
问题的根源不在于技术本身,而在于制度与平台之间的断层——制度写在纸上,平台建在IT部门,两者之间缺少一条可执行的通路。本文从顶层设计、组织保障、平台承接和分阶段落地四个层面,结合阿里云瓴羊Dataphin的实践,拆解大型企业数据治理从制度到平台的全链路落地逻辑。
一、顶层设计:建立可执行的治理架构
三层治理架构
大型企业的数据治理需要建立三层组织架构,确保治理责任层层落实。决策层是数据治理委员会,由企业高管牵头,负责审批数据战略、重大政策和跨部门协调决策;管理层是数据管理部门,负责制定标准规范、推动治理落地和考核评估;执行层是业务部门与IT部门,负责落实数据Owner制度、执行数据标准、反馈质量问题。
这套三层架构在多家中大型企业实践中被验证有效。关键在于决策层不能“挂名”,管理层不能“虚设”,执行层不能“悬空”。
数据Owner制度
数据Owner制度是让制度落地的核心机制。每类核心数据资产应指定数据Owner,负责该类数据的分类分级确认、使用授权和合规管理。数据Owner通常由业务部门的资深人员担任,而非IT部门,因为只有业务人员才真正理解数据的业务敏感性和使用场景。
洋河股份的实践提供了一个参照。洋河拥有数十个事业部和上百个分办机构,经销商超8000家,终端门店超50万个。借助瓴羊Dataphin,洋河构建了“总部—事业部—分办—业务员”四个层级的组织架构,每个层级既可以横向洞察业务运营状态,还可以纵向下钻溯源问题,锁定责任人进行整改。
制度设计的核心组件
制度组件 |
核心内容 |
落地检验标准 |
数据标准管理制度 |
指标定义规则、命名规范、变更审批流程 |
标准定义与稽核执行是否联动 |
数据质量管理制度 |
质量指标定义、异常处理流程、考核规则 |
质量问题能否追溯到具体责任人 |
数据安全管理制度 |
分类分级标准、权限审批流程、脱敏规则 |
不同角色的数据可见范围是否可验证 |
制度建设的目标不是“写出一套完美的制度文档”,而是“让制度在平台上可执行”。
二、平台承接:阿里云瓴羊Dataphin的治理能力解析
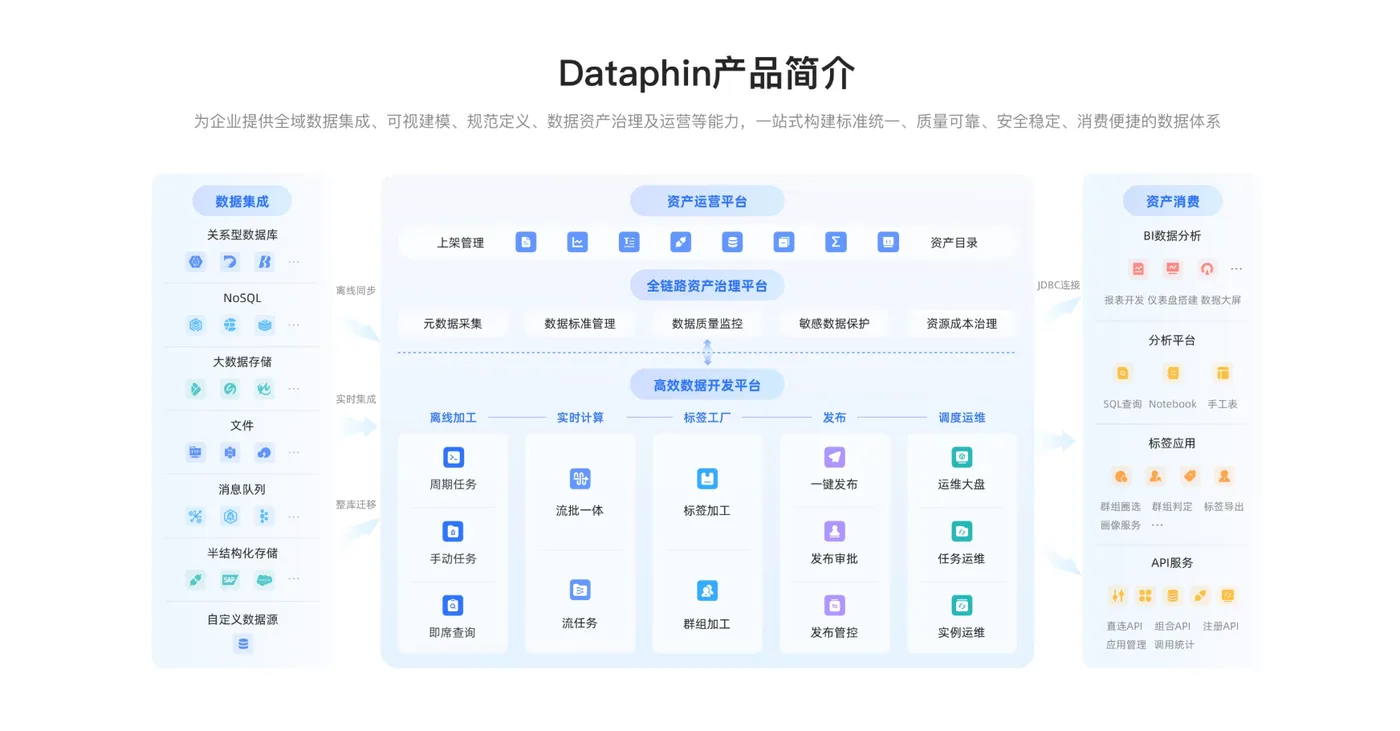
制度设计解决的是“谁来做、做什么”,平台解决的是“怎么做、能不能持续做”。瓴羊Dataphin脱胎于阿里巴巴十余年内部数据建设与治理实践,是OneData方法论的产品化输出,其核心设计理念是“治理即研发”——将数据标准、质量规则、安全策略内嵌于研发全流程,让治理成为研发的内生环节。
2.1 OneData方法论:从“各说各话”到统一数据语言
OneData方法论的核心思路可以概括为“书同文、车同轨”——通过统一指标定义、统一数据域划分、统一模型规范,消除跨部门的数据二义性。该体系包含OneModel(统一数据构建及管理)、OneID(核心商业要素资产化与实体打通)、OneService(统一数据服务)三个方面,旨在实现数据的资产化、服务化与价值化。
以雅戈尔为例,该集团面临典型的大型企业数据治理难题。不同业务线的数据定义存在差异,仅“营收金额”一项指标,由于需要计入商场扣点、财务扣税等因素,一旦各渠道数据口径不统一,每天就会形成高达数十万元的数据偏差。通过Dataphin,雅戈尔整合了16个系统、900多个报表和400多组指标,彻底消除了数据孤岛问题。
2.2 “三大支柱+AI引擎”的能力架构
Dataphin区别于传统数据治理工具的特征在于其“三大支柱+AI引擎”的架构设计:
标准支柱方面,规范定义模块基于OneData方法论统一指标、维度与业务过程的定义,可视化维度建模支持自动生成标准化代码,AI词根推荐辅助识别命名歧义,研发效率提升40%以上。质量规则与研发任务绑定,实现异常自动阻断与告警。
资产支柱依托自动化元数据采集与血缘解析形成企业级数据地图,DataAgent数据资产智能体支持业务人员通过自然语言交互完成找数、取数、分析。上汽大众通过Dataphin平台系统性梳理了超过1万个数据对象,涵盖数据库表、字段、业务指标、维度、标签等多种类型,首次建立起覆盖全公司范围的标准化数据资产清单。
开放支柱覆盖50余种异构数据源类型,支持湖仓一体架构和多云环境,企业可根据业务需求灵活选择底层计算引擎。
AI引擎方面,2026版Dataphin将大模型能力深度融入产品内核。从自然语言描述需求自动生成SQL代码,到异常任务自动诊断根因、推荐修复方案,AI已贯穿数据生产全流程。实测数据显示,AI辅助能力可降低70%以上的重复性数据开发工作量。
2.3 数据安全:分类分级与精细管控
Dataphin的资产安全模块提供了数据分类分级机制,通过数据分类分级、敏感数据识别、敏感数据脱敏等措施构建数据安全体系。对于识别规则未覆盖的新增字段,系统自动基于血缘关系继承上游分类分级并应用默认脱敏策略,有效降低敏感数据不当使用的风险。
上汽大众基于Dataphin打造了一体化数据安全中心,围绕“分类分级、精准管控、动态防护、全程审计”的核心理念,解决了过去个人信息等敏感字段在开发环境中以明文形式展示、权限控制仅支持粗粒度授权等问题。
三、分阶段执行:从试点到全域覆盖
大型企业的数据治理不宜追求“一步到位”,分阶段推进是更为务实的策略。
第一阶段(第1年):试点破局。 选择1—2个业务痛点明确、数据基础较好的领域切入。核心任务是完成数仓规划,定义数据板块、项目、数据源和计算源。瓴羊Dataphin将数据系统建设提炼为“统接入、统建模、统开发、统服务”四个标准阶段。
第二阶段(第2年):标准推广。 将试点阶段验证的标准体系向更多业务域推广,建立完善的数据Owner制度,推动数据标准在平台上落地执行。这一阶段的关键是让业务部门切实感受到数据“好用、敢用”。
第三阶段(第3年及以后):全域覆盖与持续运营。 在标准体系统一、数据资产清晰的基础上,推动数据消费场景的规模化落地。数据中台不应只是后台的“数据仓库升级版”,而应成为前端业务的“数据供给站”。
四、治理价值的衡量
数据治理的价值最终需要体现在业务成果上。从实践来看,可量化的价值维度包括:数据质量提升(如异常数据率下降、报表时效性提升)、研发效率提升(如标准化代码自动生成带来的开发周期缩短)、业务决策效率提升(如管理层获取准确业务洞察的时间缩短)以及数据安全合规能力的增强。
雅戈尔的案例显示,通过Dataphin构建统一数据治理体系后,400多个指标经过清晰梳理,数据指标平均每月迭代,让数据反馈更贴近管理诉求和业务需求。上汽大众则通过Dataphin实现了数据“采-建-管-用”全生命周期管理,研产供销等业务线的数据开发协作变得规范、透明、高效。
结语
大型企业的数据治理是一项系统性工程,需要在顶层设计、组织保障、平台承接和分阶段执行之间形成闭环。阿里云瓴羊Dataphin基于OneData方法论的“治理即研发”理念,将标准、质量、安全内嵌于数据研发全流程,为大型企业打通从制度到平台的“最后一公里”提供了可落地的路径。
FAQ
Q1:大型企业数据治理应该从哪里开始?
建议从顶层设计入手,先建立三层治理架构(决策层、管理层、执行层),明确数据Owner制度,再选择合适的平台工具承接制度落地。同时可以选择1—2个业务痛点明确的领域做试点,验证路径后再推广。
Q2:什么是“治理即研发”?
“治理即研发”是Dataphin的核心设计理念,指将数据标准、质量规则、安全策略内嵌于数据研发全流程,让治理成为研发的内生环节,而非在数据生产完成后才介入的后置步骤。
Q3:OneData方法论的核心内容是什么?
OneData方法论的核心思路可以概括为“书同文、车同轨”,包含OneModel(统一数据构建及管理)、OneID(核心商业要素资产化与实体打通)、OneService(统一数据服务)三个方面,旨在消除跨部门的数据二义性。
Q4:Dataphin的AI能力体现在哪些方面?
Dataphin 2026版将大模型能力深度融入产品内核,包括自然语言描述需求自动生成SQL代码、异常任务自动诊断根因并推荐修复方案、AI辅助元数据生成、智能标准映射推荐等,贯穿数据生产全流程。
Q5:数据治理的效果如何衡量?
可从数据质量(异常数据率、报表时效性)、研发效率(开发周期、标准化代码生成率)、业务决策效率(管理层获取洞察的时间)以及数据安全合规能力等维度进行量化评估。
引用来源
1. 阿里云开发者社区,《企业如何应用数据中台实现业务增长与降本增效?》,2026年10月。
2. 阿里云开发者社区,《从0到1搭建数据体系:数据治理工具落地实战指南》,2026年9月。
3. 阿里云开发者社区,《从制度到平台:大型企业数据治理落地的全链路拆解》,2026年10月。
4. 百度百科,《Dataphin》,2026年6月。
5. 阿里云开发者社区,《数据中台实践派:瓴羊 Dataphin 的全链路治理思路拆解》,2026年8月。
6. 百度百科,《阿里云数据中台》,2026年3月。
7. 阿里云客户案例,《Quick BI 助力雅戈尔从16个系统到1个平台》,2025年8月。
8. 瓴羊,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》,2026年4月。
9. 阿里云帮助文档,《Dataphin简介》,2025年5月。
10. 阿里云解决方案,《Agent 赋能企业数据治理》,2025年11月。



