过去很长一段时间,铁路行业对音视频系统的核心诉求,可以概括为几个关键词:看得到、存得住、调得出、能回放。车站、线路、桥隧、车辆段、机房以及移动作业现场部署了大量视频设备,音视频首先承担安全监控、生产组织、作业监督、应急指挥和事后追溯等作用。
但今天铁路人工智能的发展已经明显跨过了“给摄像机增加几个AI算法”的阶段。2025年12月,国铁集团围绕客货运输、基础设施、移动装备、工程建设、安全管理、综合管理等方向系统推进“人工智能+”;2026年3月,铁科院集团进一步提出“1-3-4-6-N”人工智能研发应用总体架构,并规划首批14项人工智能应用场景。《中国铁路》2026年第9期“铁路人工智能创新应用”专刊,则按照“总体牵引、场景落地、全域覆盖”的思路,从综合技术、客货运输、机车车辆、基础设施、工程建设和安全管理六个板块系统呈现铁路AI的发展路径。
这些变化意味着,铁路AI正在从“单点算法应用”进入算力、数据、模型、场景和业务体系协同建设的新阶段。对应到音视频行业,视频的角色也必然发生变化:过去它主要是一种监控和证据数据,未来则会越来越多地承担实时感知入口、高质量数据源、AI推理输入、事件验证手段和业务闭环载体。
站在大牛直播SDK(SmartMediaKit)的视角看,这种变化并不要求重新发明一套铁路AI平台,而是提出了一个更基础的问题:如何让来自存量摄像机、移动终端、无人机、智能装备和新型传感设备的音视频,稳定、实时、可追溯地进入人、AI模型和铁路业务系统。
一、铁路正在从“局部智能”走向“体系智能”
铁路人工智能过去更多表现为单个项目:一个客流识别算法、一个故障诊断模型、一个异物侵限系统。但从当前官方技术路线看,重点已经明显从“有没有一个模型”转向“有没有完整体系”。
《中国铁路》人工智能创新应用专刊的结构本身就很有代表性。综合技术板块关注顶层设计、总体架构和标准体系;客货运输覆盖12306、95306智能体以及运行图智能编制;机车车辆关注动车组故障诊断、机车智能镟修和货车360°智能检测;基础设施强调工、电、供设备和环境全域感知、智能运维决策、作业过程管控和装备数智升级;工程建设已经延伸到工程规范问答、质量检验大模型和隧道围岩智能监测;安全管理则包含无人机巡检、异物侵限智能推理等方向。
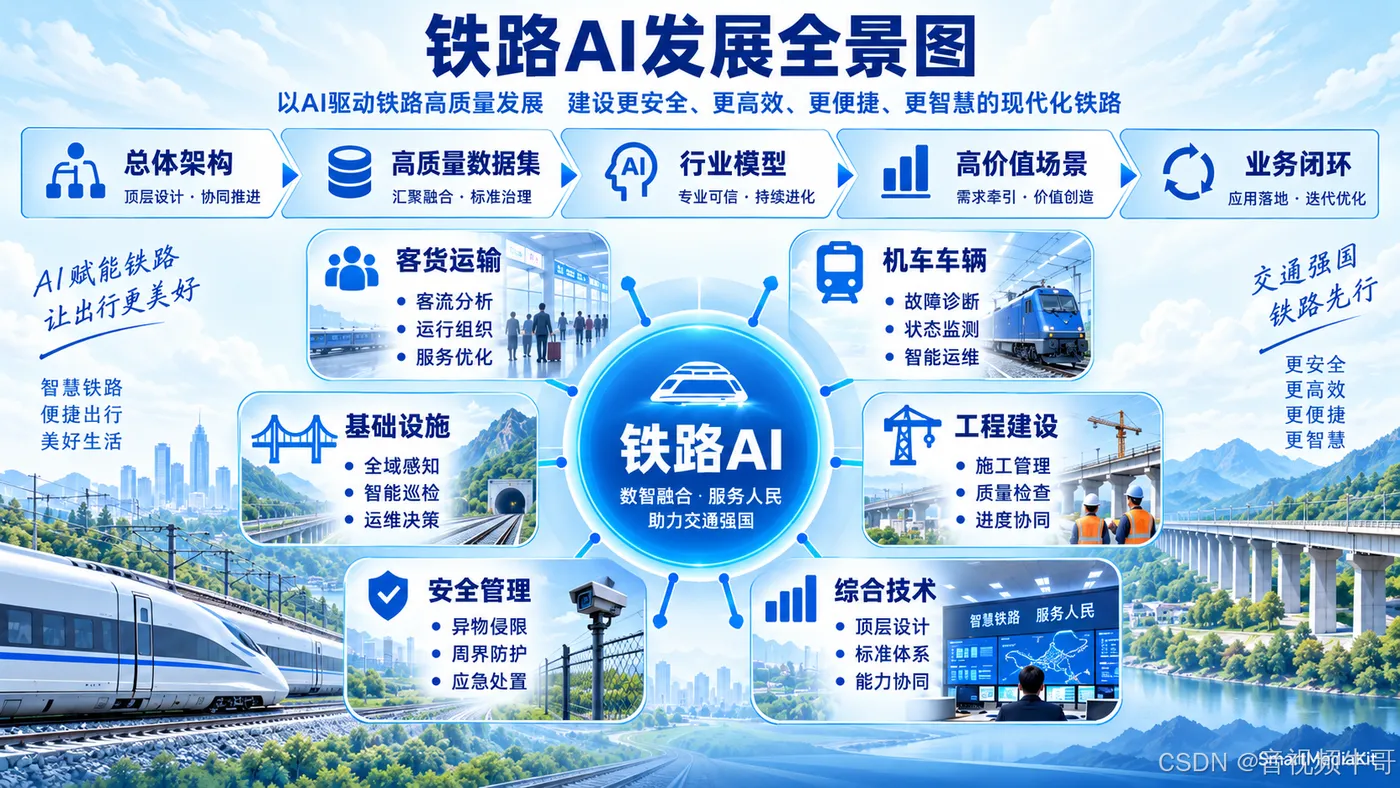
这背后反映出一个很重要的趋势:铁路AI正在从“识别一个目标”升级到“理解一个业务过程”。
音视频在这里的价值也随之改变。过去摄像机更多回答“现场发生了什么”,未来视频需要进一步和列车运行状态、设备状态、作业任务、人员身份、空间位置和AI结果进行关联。
例如一次线路异物侵限,不应该只是AI产生一条告警,而应该形成完整信息链:
视频证据 → 目标识别 → 空间位置 → 风险判断 → 人工复核 → 调度/处置 → 结果回填。
这意味着未来铁路音视频系统不能再孤立存在,而必须成为铁路AI总体架构中的实时数据层。
二、六大业务方向背后,其实对应六种完全不同的音视频需求
铁路AI覆盖客货运输、机车车辆、基础设施、工程建设、安全管理等多个领域,而每类场景对视频的要求并不相同。
客运场景更关注站台安全、人流密度、重点区域异常、服务过程和应急指挥;货运可能涉及货场、装卸、货检和周界监控;机车车辆领域存在车底、车侧、受电弓、转向架和轮对等高精度视觉检测;工务、电务、供电等基础设施领域需要面向线路、桥隧、接触网、设备机房进行持续观察和巡检;工程建设则需要移动视频、现场作业记录以及智能质量检查;安全管理又会进一步延伸到无人机巡检、铁路外部环境和异物侵限。
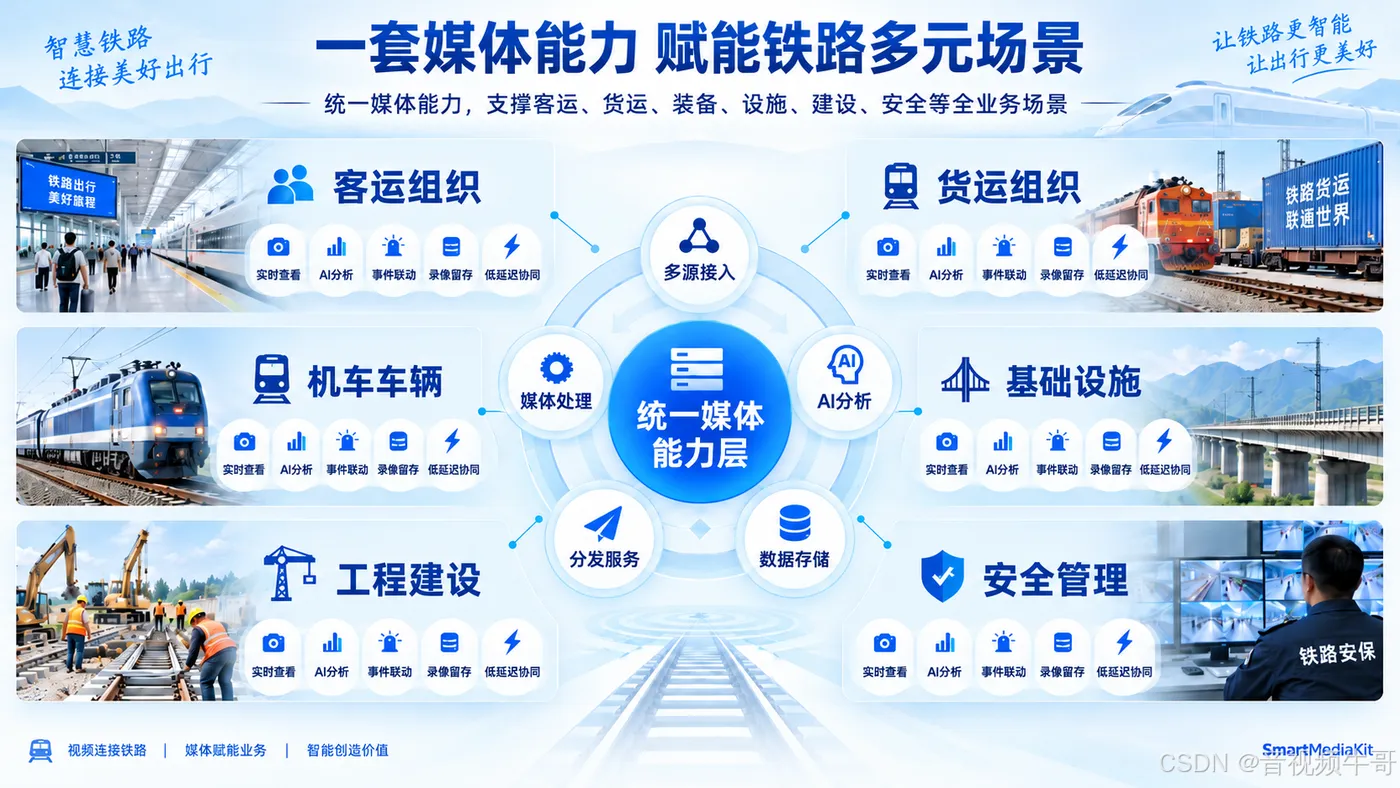
因此铁路视频会越来越明显地分成三类:持续监视型、AI分析型和实时协同型。 前者强调7×24小时、多路并发和录像完整;AI分析型强调原始图像质量、时间戳、数据输出和算法吞吐;实时协同型则强调低延迟、移动网络、双向音频和快速恢复。
这意味着未来很难继续用“所有视频统一进入一个中心平台、统一参数处理”的方式解决全部需求。同一路摄像机甚至可能同时产生录像流、预览流和AI分析流,而移动现场、无人机或者机器人视频又可能采用完全不同的实时链路。
所以真正成熟的铁路媒体系统应该具备的不是“统一协议”,而是:
多源接入、统一媒体抽象、按业务需求输出。
三、高质量数据集已经成为官方重点,视频不能再只是“录像文件”
2026年铁路AI领域一个非常重要的信号,是高质量数据集已经进入体系化建设阶段。铁科院首批通过权威测评的数据集,已经覆盖安检禁限品X光图像、铁路客站站台工作人员图像、铁路线路危情图像、铁路信号典型场景图像、动车组智能运维知识库,以及高速铁路轨道检测多模态时序数据。
这说明铁路AI的数据建设正在从“有数据”转向完整性、准确性、及时性、一致性、多样性和模型应用效果都可评估的数据资产。
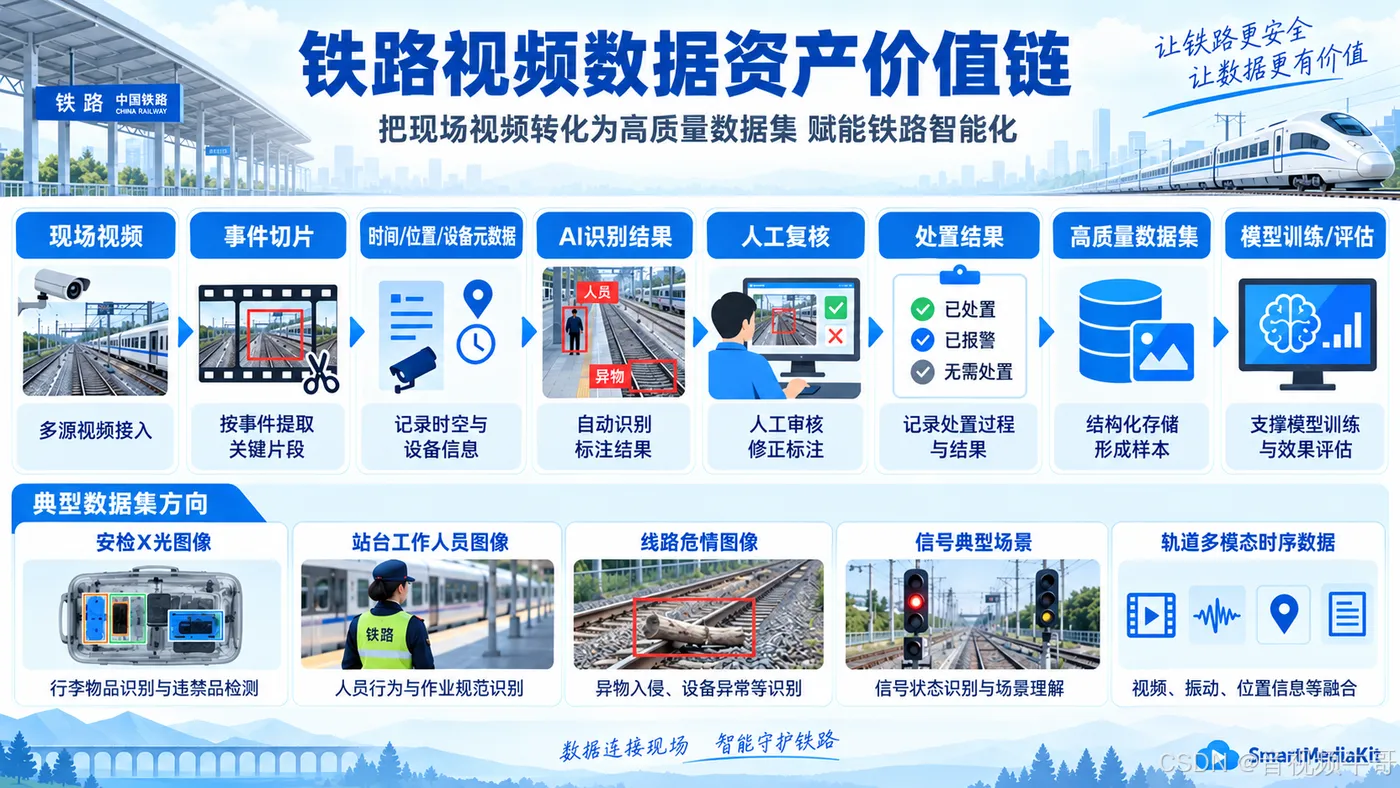
对应到音视频领域,未来真正有价值的数据单元不再只是一个MP4文件,而更可能是:
视频片段 + 时间 + 位置 + 摄像机/设备 + 作业任务 + AI结果 + 人工结论 + 最终处置结果。
例如AI检测到一次线路异常,如果录像能够关联模型版本、置信度、杆塔位置、人工复核结果和最终处置结论,这段视频就不仅可以用于事后回放,还可以进入后续模型训练和评估。
于是视频系统会逐渐形成一个数据闭环:
实时视频
→ AI发现异常
→ 保留事件前后媒体
→ 人工复核
→ 业务处置
→ 结果回填
→ 形成高质量训练样本。
这与铁路正在建设高质量数据集的官方方向实际上高度一致。未来铁路AI真正的竞争力,不会只来自一次性训练出来的大模型,而会来自这种持续运行的数据飞轮。
四、行业模型和多模态AI的发展,会让视频从“识别输入”变成“上下文输入”
过去铁路视频AI主要以传统CV为主:目标检测、分类、分割、OCR,一帧图片进去,一个检测框或者分类结果出来。但铁路正在推进的方向已经逐渐扩展到行业垂域模型、大模型智能体和多模态能力。铁科院当前人工智能总体建设也明确把铁路行业垂域大模型作为基础能力之一。
这会改变视频进入AI的方式。
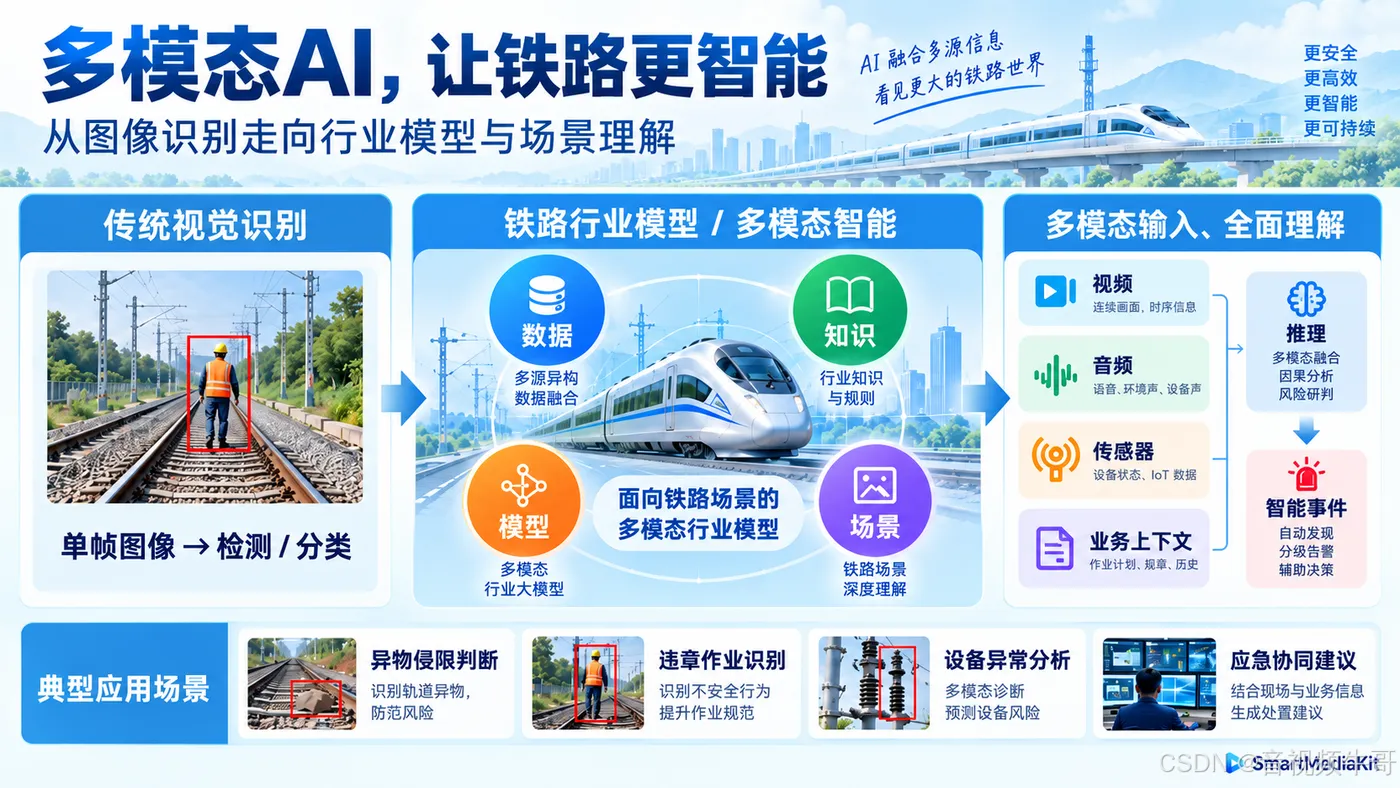
传统模型可能只需要一张图片判断“有没有人侵入线路”,而多模态模型可能需要结合连续视频、语音、设备状态、历史记录和自然语言任务进行综合理解。例如:
“判断该人员是否属于正常检修作业?”
仅靠目标检测显然不够。系统还需要知道作业计划、人员位置、作业时段甚至现场行为过程。
因此未来视频AI会从:
Frame → Detection
逐渐扩展成:
Video + Audio + Sensor + Business Context → Reasoning → Event
音视频系统也因此不只是向算法输出YUV/RGB帧,而需要尽可能保留可靠时间戳、流身份、设备信息以及事件上下文。
这也是为什么实时媒体和AI的边界正在发生变化:媒体层不负责做业务判断,但必须保证AI得到的数据真实、连续、来源清楚、时间可信。
五、基础设施“全域感知”意味着铁路媒体架构必然走向端—边—中心协同
《中国铁路》专刊在基础设施方向明确提出设备和环境全域感知、智能运维决策、作业过程管控、装备数智升级等技术路径。
全域感知并不意味着所有摄像机、无人机和传感器都应该把完整高清数据持续上传到中心。铁路本身就是一个超大规模、长距离、网络条件差异明显的分布式系统,如果全部数据集中处理,很快会遇到带宽、存储和实时性压力。
更现实的架构会逐渐走向:
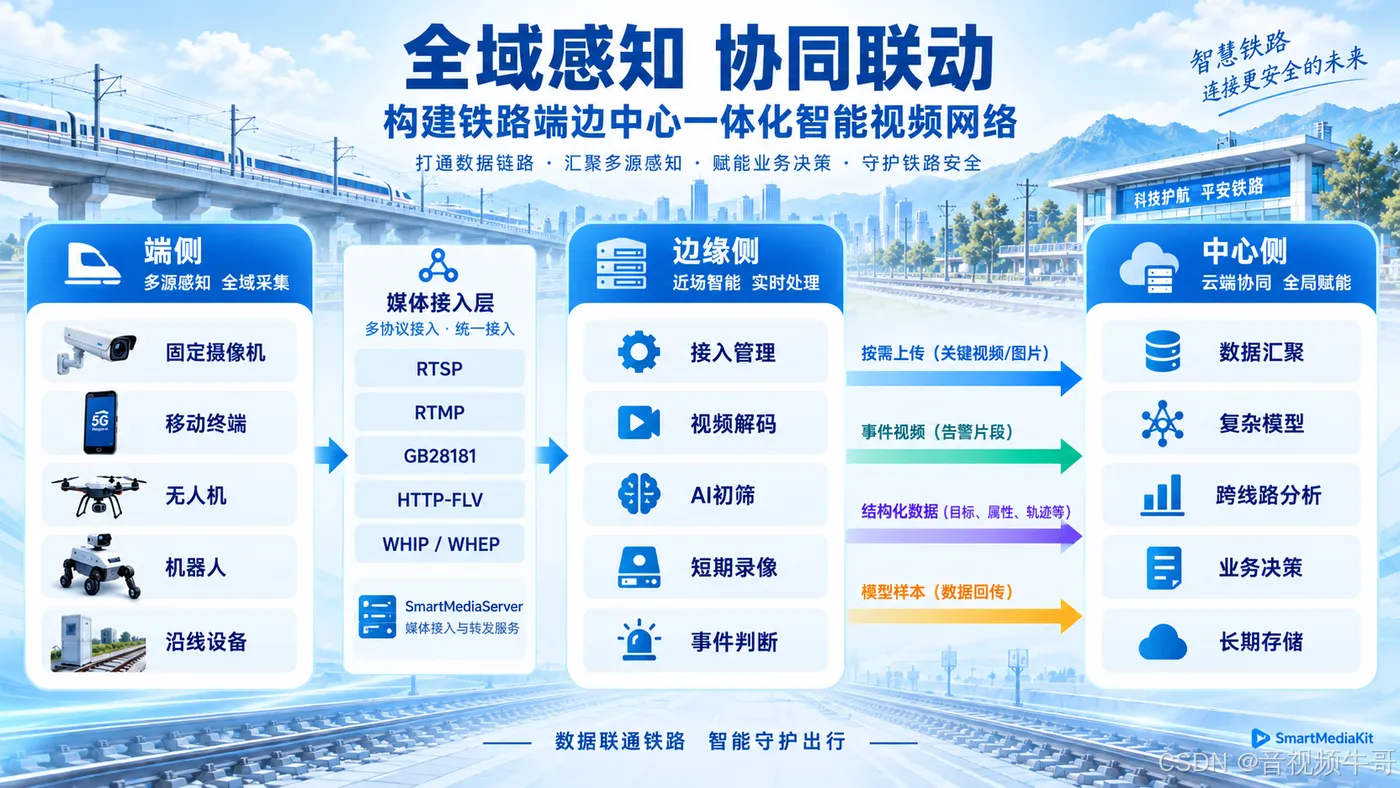
端侧采集 → 边缘处理 → 区域协同 → 中心智能。
边缘节点负责视频接入、解码、AI初筛、短期录像和事件判断,中心侧负责跨线路分析、复杂模型、数据汇聚和业务决策。没有事件时,不一定需要持续上传全部高清媒体;出现异常或者人工调阅时,再按需建立高质量媒体路径。
在这样的体系中,RTSP、RTMP、GB28181、HTTP-FLV以及WHIP/WHEP等协议只是不同设备和业务场景的媒体互联方式。真正需要统一的是背后的媒体Source、Reader、录像、AI数据出口和生命周期管理。
这也是SmartMediaServer可以切入的位置:将SmartMediaKit既有的端侧媒体能力逐渐扩展到边缘和服务端,形成统一的视频汇聚、按需拉流、实时输出、录像和AI数据出口,而不是让每个铁路AI应用重复建设媒体基础设施。
六、铁路AI真正难的仍然是工程:高可靠、实时性和复杂环境
官方AI路线强调高价值场景和规模化应用,这意味着最终评价铁路人工智能的,不可能只是实验室准确率,而是实际生产环境中能不能稳定使用。
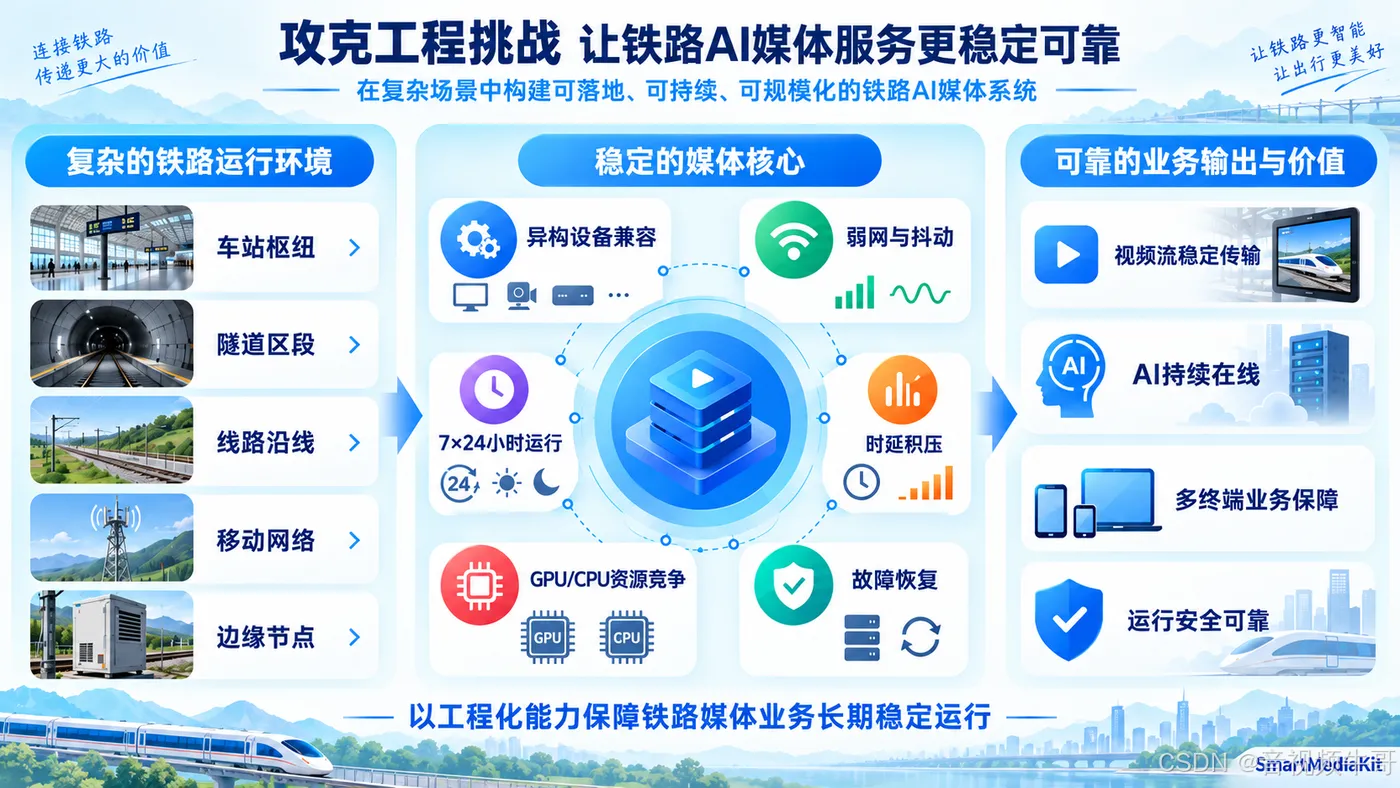
铁路视频首先面临设备异构问题。不同厂家、不同建设年代、不同编码参数和不同平台行为长期共存,AI系统如果只能处理理想视频源,很难真正规模部署。其次是网络问题,区间、隧道、移动终端和无线链路都可能出现抖动、断流和带宽下降。
第三是7×24小时稳定运行。几十路、几百路媒体同时播放、录像、转发和AI推理以后,真正决定系统可靠性的往往不是模型,而是CPU、GPU、内存、线程、Socket和存储资源是否存在明确边界。
第四是实时性。铁路AI以后会越来越关注一个过去视频监控里不那么突出的概念:
AI看到的画面究竟有多旧?
采集、编码、网络、Jitter Buffer、解码和推理任何一层持续排队,都可能让系统形成“画面仍然流畅,但已经不是当前现场”的状态。对于普通录像影响不大,对于实时告警、无人机、机器人和应急协同就可能直接影响结果。
所以铁路AI工程化真正需要建立的是:
AI可以变慢,但媒体不能无限积压;网络可以异常,但系统必须恢复;单路设备可以故障,但不能拖垮整个节点。
这才是铁路AI从科研成果走向生产系统最核心的工程门槛之一。
七、音视频作为铁路AI架构中的公共基础能力
按照铁路官方“总体牵引、场景落地、全域覆盖”的路线,音视频更适合被建设成跨场景公共能力,而不是每一个AI项目单独搭建一套媒体链路。
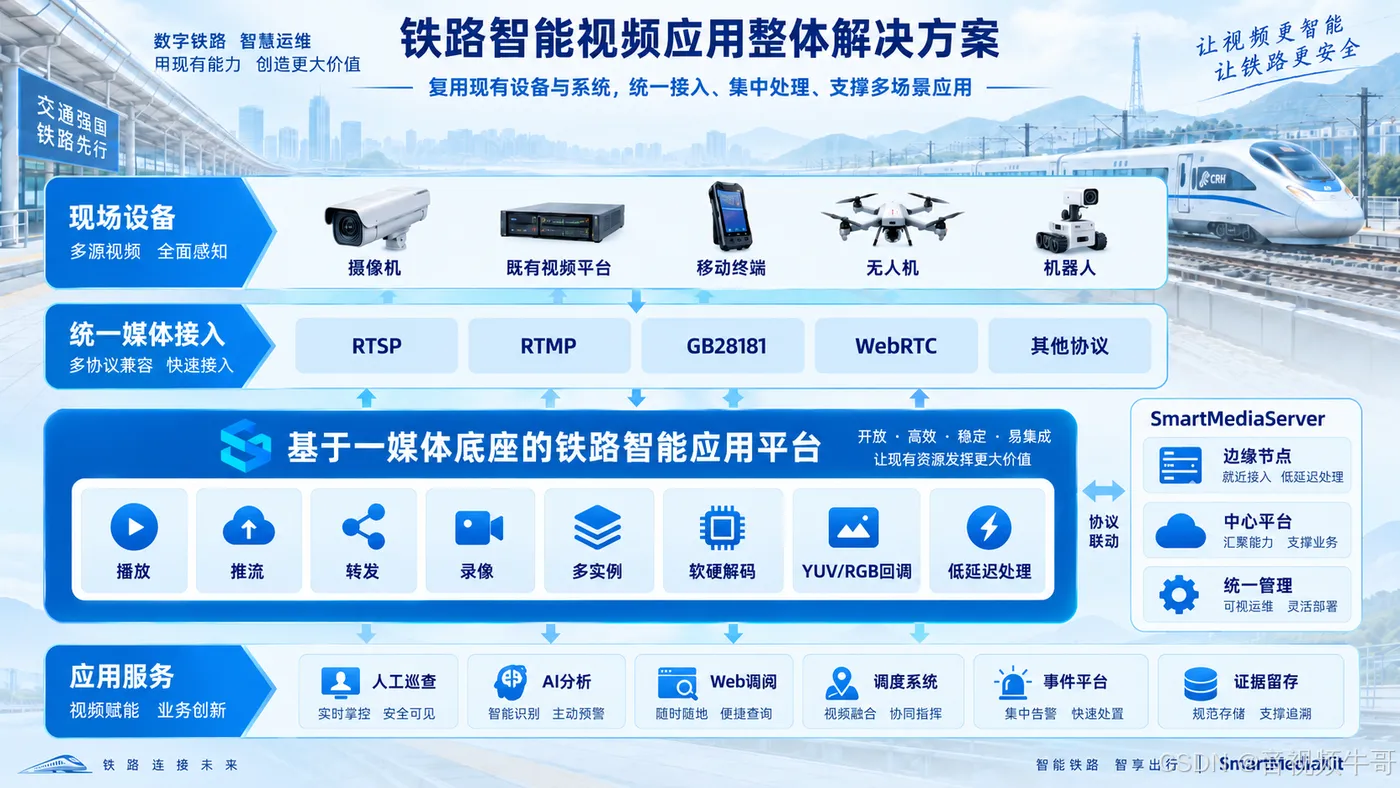
一个更合理的体系可以拆成几层。
最底层是多源媒体接入,对接存量IPC、既有视频平台、移动终端、无人机、机器人以及其他智能设备,通过RTSP、RTMP、GB28181以及WebRTC等不同方式进入统一媒体层。
中间是实时媒体处理,负责H.264/H.265等码流处理、软硬解码、音视频同步、多路并发、异常恢复、原始YUV/RGB数据输出和媒体转发。上层AI只需要获取稳定的视频帧,而不需要重复实现各种协议和设备兼容逻辑。
再往上是分发和录像能力。传统监控、浏览器低延迟调阅、移动现场回传和AI分析可以根据场景选择不同的媒体路径;录像则和任务ID、告警、AI结果以及人工确认信息结合,逐渐形成铁路AI高质量数据的一部分。
在服务端和边缘节点,SmartMediaServer可以进一步承担媒体Source统一管理、按需拉流、多协议输出、录像和AI数据出口,使现有SmartMediaKit从端侧SDK逐步延伸到“端—边—中心”的实时媒体体系。
完整逻辑可以概括为:
现场设备
→ 统一媒体接入
→ 实时媒体核心
→ 人工监看 / AI模型 / 录像 / Web调阅
→ 结构化事件
→ 铁路业务系统。
这种架构最重要的意义不是采用了多少协议,而是铁路不同AI场景能够共享一套成熟媒体基础能力。
八、铁路AI下一阶段真正需要的是“感知—模型—业务”的闭环
从目前官方技术脉络来看,铁路人工智能的发展路线已经非常明确:上层需要总体架构和标准体系,中间需要铁路行业模型和高价值场景,底层则离不开科研算力和高质量数据集。与此同时,应用范围已经覆盖客货运输、机车车辆、基础设施、工程建设和安全管理等铁路核心业务。
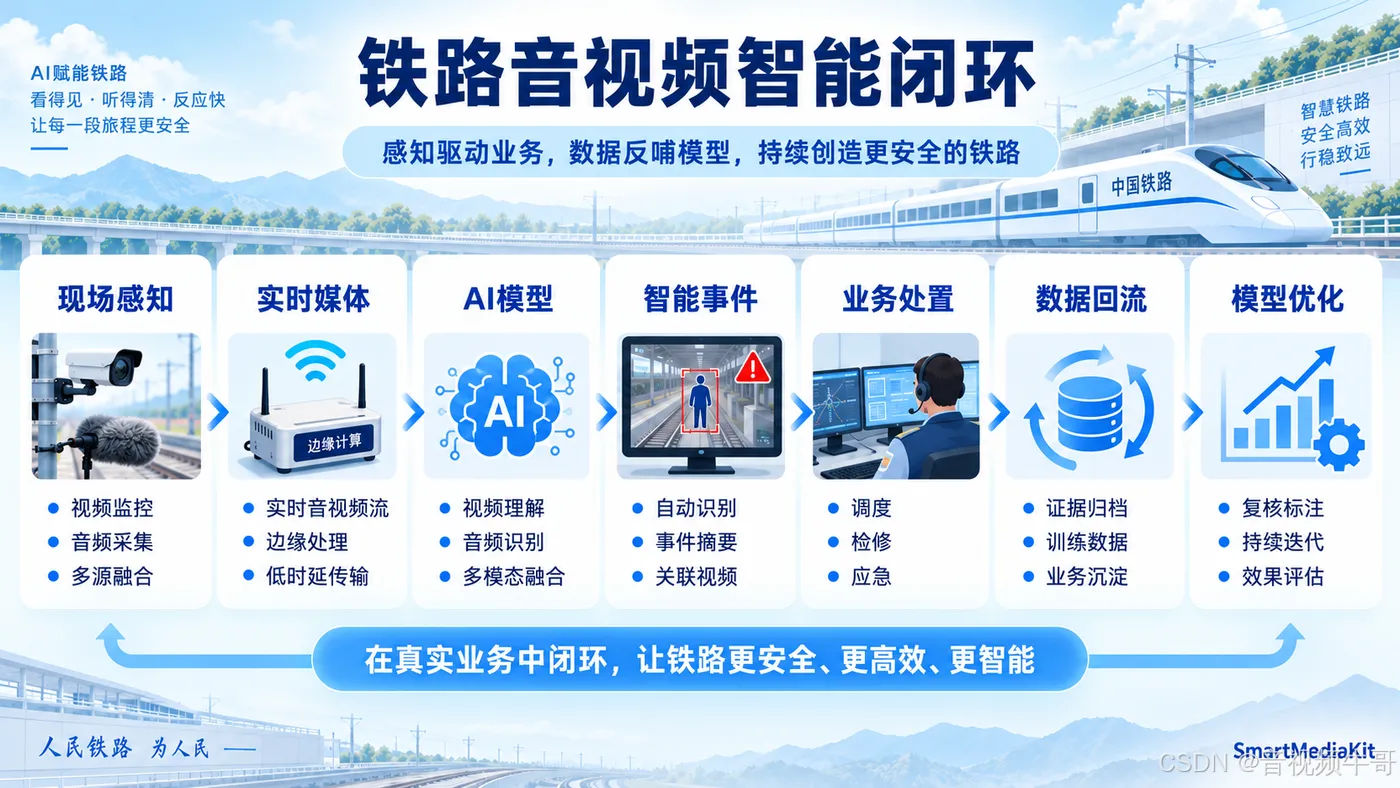
对应到音视频领域,可以把未来演进分成四个阶段。
第一阶段是视频数字化:让现场能够被看见、传输和录像;第二阶段是视频结构化:AI开始知道画面里有什么;第三阶段是事件智能化:模型能够结合连续视频和业务上下文判断哪些变化真正值得关注;第四阶段则是业务闭环化:异常自动进入检修、调度、应急和生产流程,最终结果继续反哺数据集和模型。
于是铁路AI真正形成的是:
现场感知 → 实时媒体 → AI模型 → 智能事件 → 业务处置 → 数据回流。
音视频位于这条链路的最前端,同时贯穿事件验证和数据沉淀全过程。
这也是为什么未来铁路音视频真正值得持续建设的,不只是更多摄像机和更高分辨率,而是四个能力:
实时、统一、可计算、可追溯。
从SmartMediaKit这样的基础媒体能力角度看,最适合承担的角色也很清晰:继续把多协议接入、低延迟处理、软硬解码、弱网恢复、多实例、录像、转发、原始数据回调和跨平台能力做深,并通过的SmartMediaServer逐步形成边缘和中心媒体服务能力。
因为无论铁路最终采用传统CV、视觉大模型、多模态模型、行业垂域大模型还是智能体,一个前提始终不会改变:
AI首先必须获得真实、及时、连续而且可以解释的铁路现场数据。
过去铁路音视频解决的是:
让人看到现场。
铁路人工智能下一阶段真正要解决的是:
让现场能够被机器理解,让模型判断能够被业务验证,让业务结果能够继续沉淀成高质量数据。
从“视频监控”走向“实时感知基础设施”,这才是人工智能持续推进以后,铁路行业音视频需求最本质的一次迭代。