
各家都说自家 AI 推理强?我做了个擂台,让它们上去真刀真枪下五子棋
AI 到底谁更聪明?别看发布会了,让它们下一盘五子棋
先看效果图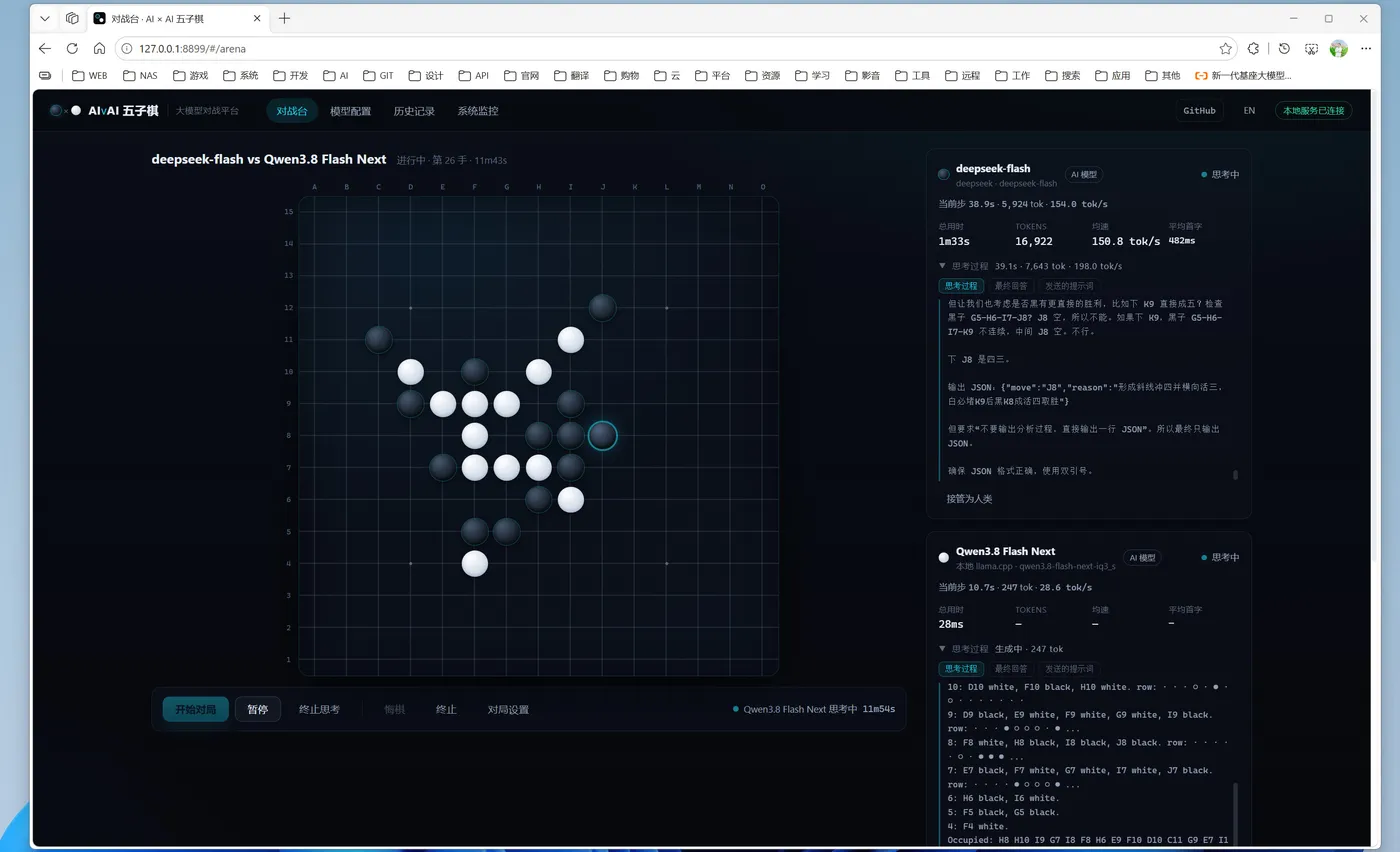
一、问题:推理能力,到底谁说了算?
这两年,几乎每一家模型发布会都在说同一句话:
"我们的推理能力大幅提升。"
数学测评、代码榜单、长文本理解……数字一个比一个漂亮。可真到了自己手里,感觉又不总是那么回事——有的模型慢得像在写论文,有的张口就给出一堆废话,有的关键时刻"掉链子"。
测评榜单毕竟是别人出的卷子。有没有一种更直接、更公平、还看得见过程的方式,去比一比这些模型?
答案可能有点朴素:让它们下盘棋。
五子棋规则简单、状态确定、不需要任何工具调用和外部知识——纯粹考验模型的空间推理和局面判断。没有借口,没有玄学。行就是行,不行就是不行。
所以我做了这个平台:AI × AI 五子棋 · 大模型对战平台。
二、它是什么:一个让 AI"互殴"的擂台
一句话概括:让多个 AI(或者人类、内置算法)互相对弈五子棋,并完整记录每一项性能数据。
核心就三点:
1. 可接入各家大模型 API
兼容 OpenAI Chat Completions 协议,任何一个支持 /v1 接口的模型服务都能接:
- 填一个 Base URL、一个 API Key,就能用;
- 点一下「获取可用模型」,自动探测
/v1/models列出所有可选模型; - 支持自定义请求头、额外请求参数(比如关掉长思考
enable_thinking、降低reasoning_effort)。
本地跑的 llama.cpp、各类云端 API、私有化部署的推理服务……只要能发请求,就能上场。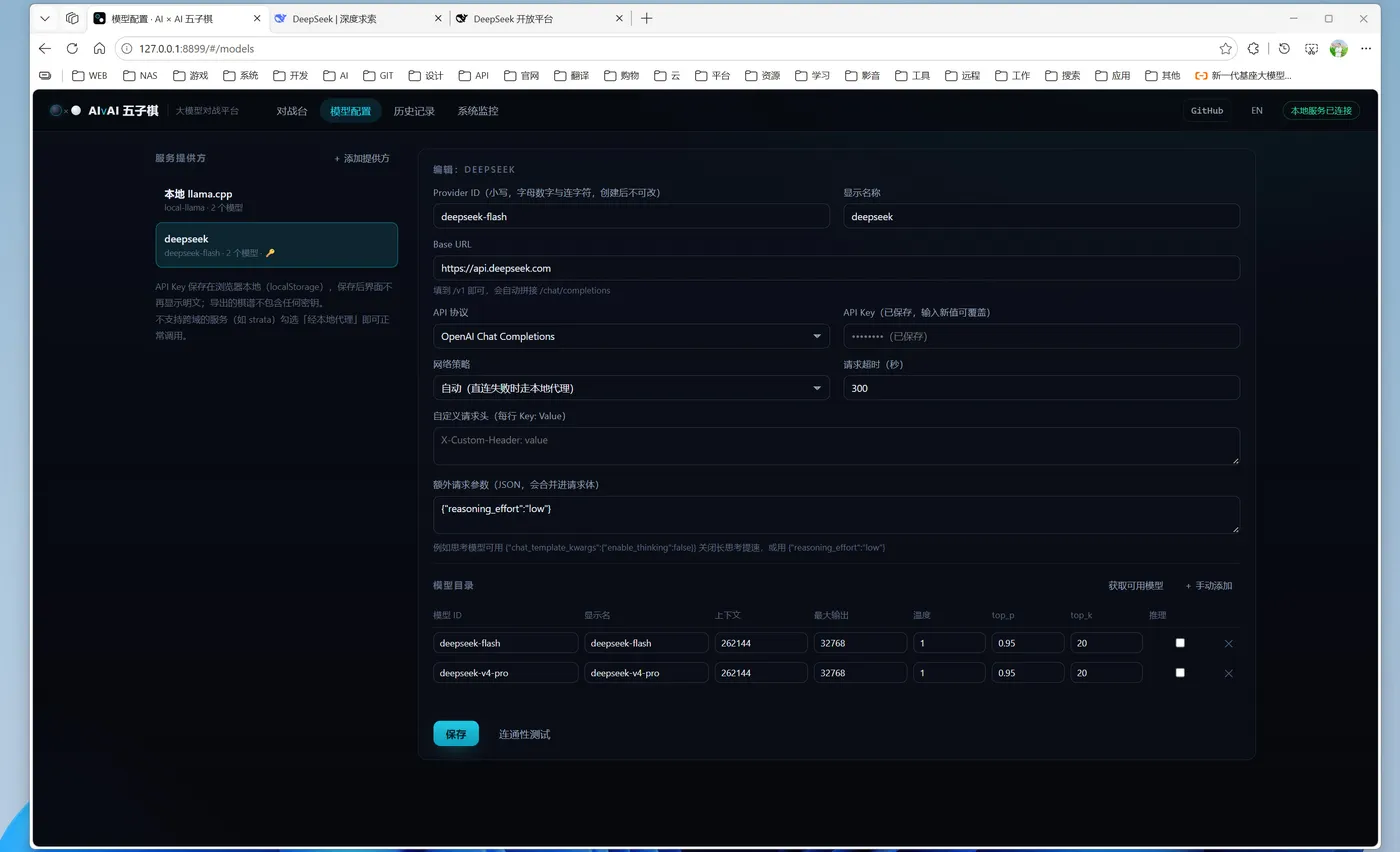
2. 也可以和人类对战
不想只看 AI 打好坏?随时接管。
对局进行到一半,你可以把任意一方"接管为人类",自己上手走两步,看看这个模型刚才的棋路到底合不合理;玩够了再点「恢复 AI」,让它继续下。
人 vs AI、AI vs AI、人 vs 人,想怎么打就怎么打。
3. 也可以和传统算法对战
AI 到底有没有"棋感"?跟传统算法比一比就知道了。
平台内置了三档传统五子棋算法:
- 初级:随机偏好,会下坏棋(用来找自信);
- 中级:贪心启发式,攻防都有评分;
- 高级:启发式 + Minimax Alpha-Beta 迭代加深剪枝,在时间预算内搜索。
一个是在线推理,一个是经典搜索。 同样是五子棋,两种思路到底谁更强,一盘下来高下立判。
三、不只是分胜负:它能"看见"AI 是怎么思考的
这才是这个平台真正好玩的地方——它记录的不只是输赢,而是过程。
实时展示模型的思考
模型不是黑盒。平台会流式显示模型的推理过程,你可以看到它一边"想"一边输出,那一步的原始思考还可以展开逐字看。
有的模型洋洋洒洒分析一大段再落子,有的张口就报坐标——性格差异一目了然。
每一步都有真实性能指标
对局中,每一步都会记录:
| 指标 | 含义 |
|---|---|
| 总用时 | 这一手花了多久 |
| TTFT | 首字延迟,用户多久能看到第一个字 |
| 输入 / 输出 tokens | 这一手消耗了多少 token |
| tok/s | 生成速度 |
| 缓存命中 tokens | 有多少走了 KV 缓存 |
| MTP 草稿数 / 接受数 | 多 token 预测的草稿接受率 |
谁快谁慢、谁话多谁话少、谁的缓存命中率高——数据都摆在那,一眼看穿。
系统资源监控
平台还能顺手把运行模型这台机器的家底也摸清楚:
- llama.cpp 服务数据(
/props/health/slots/metrics); - 本机 CPU 占用、内存、GPU 占用与显存;
- 推理进程吃了多少 CPU / 内存 / 显卡。
速度慢到底是模型的问题,还是机器扛不住? 看一眼监控页就懂了。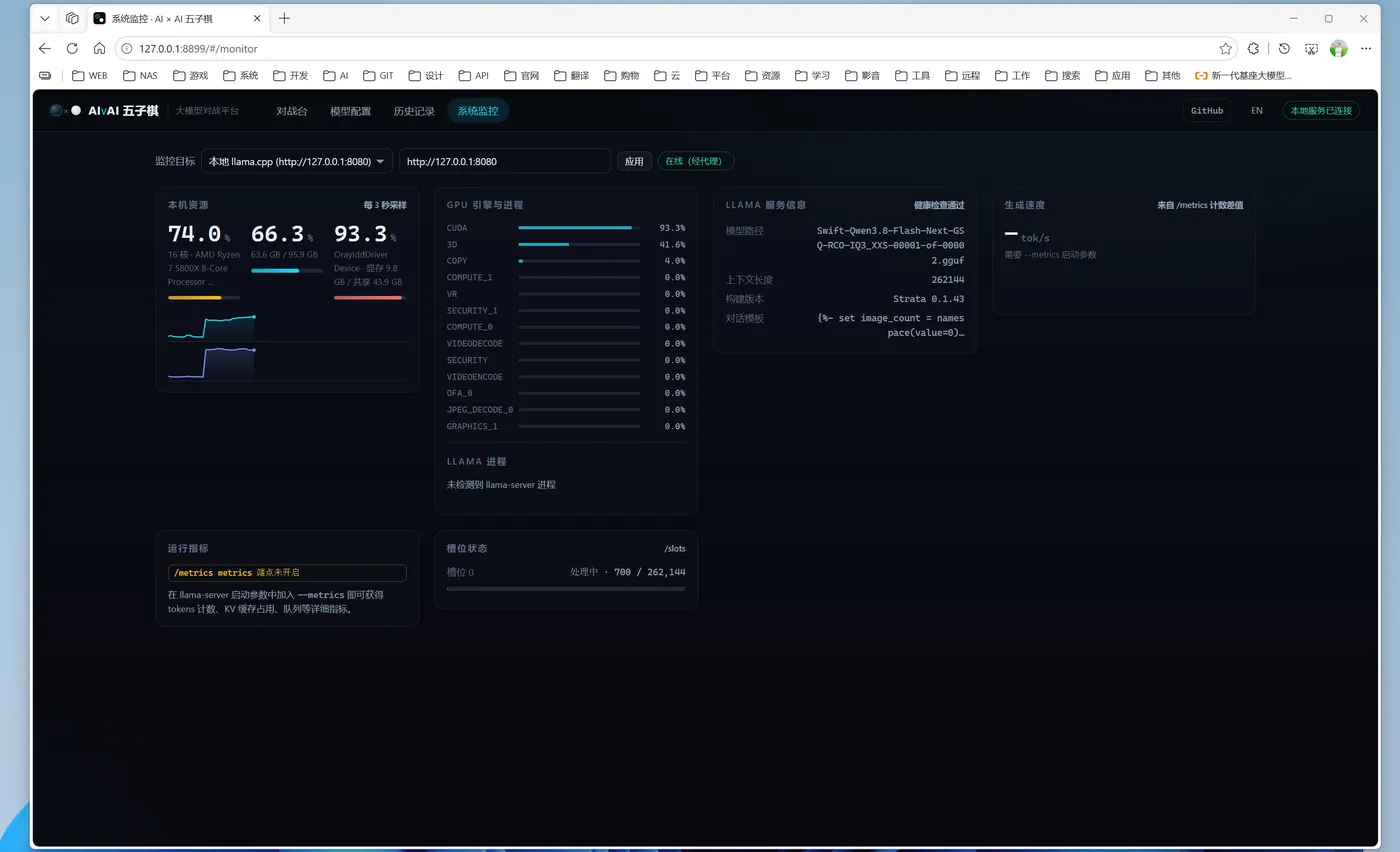
历史回放,全程可复盘
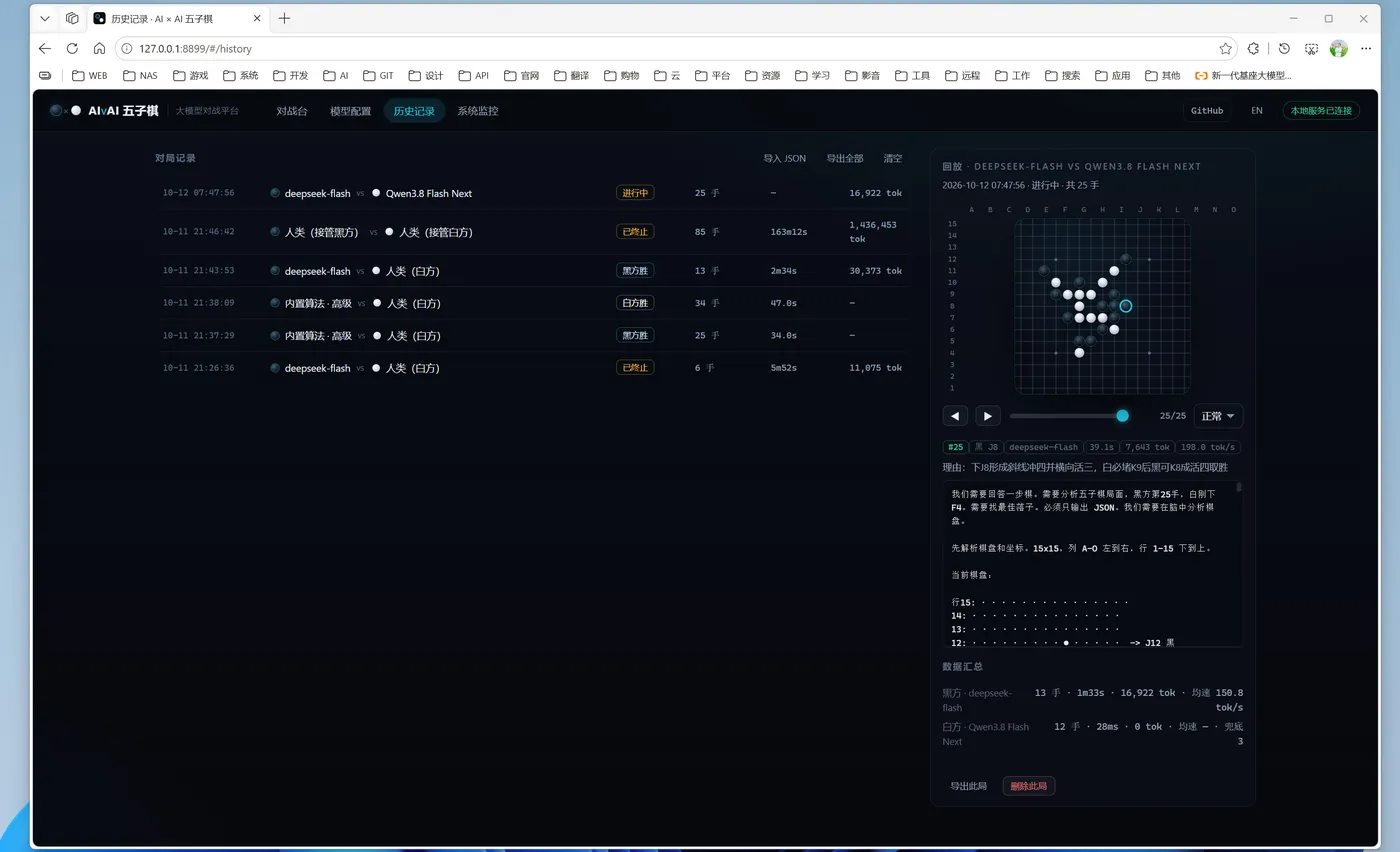
每一局的棋谱、每一步的指标、每一次的思考过程,全部留存在浏览器本地(IndexedDB),可以随时回放、导出、导入。跑一批模型做横向对比,事后慢慢分析。
四、顺手提一句:它真的一点都不"重"
很多工具,光是装环境就能劝退一半人。这个平台反着来:
- 前端 100% 纯静态:没有框架、没有构建步骤、没有任何 npm 依赖,
index.html + css + js浏览器直接加载,离线都能用; - 唯一的"服务端"是一个零依赖的单文件 Node 脚本,只干三件事:托管静态页、做 CORS 代理、采集系统信息;
- 不需要编译、不需要打包、不需要
npm install,有 Node(≥ 18)就能跑。
双击 启动服务.bat(等价于 node server/server.js)
→ 自动打开 http://127.0.0.1:8899
打开后没有任何预置服务,需要自己加一个:进「模型配置」→ 新建 Provider → 填 Base URL 和 Key → 保存 → 回「对战台」选好黑白双方 → 开始对局。
API Key 只存在你自己的浏览器本地(localStorage),服务端不保存任何密钥,导出的棋谱也完全不包含密钥。
五、上哪玩?
在线体验
https://yutils.github.io/ai-gomoku-arena
开源地址(欢迎 Star)
https://github.com/yutils/ai-gomoku-arena
说明:在线体验版是纯静态托管,页面能正常玩,但用不了 CORS 代理和 CPU/GPU 监控。想要完整体验,建议 clone 下来本地跑一份,接上你自己的模型服务。
写在最后
模型时代,我们习惯了看别人的测评榜单。但评测这件事,最好的方式其实是自己动手。
接上你手头那几个模型,让它们两两对上一盘。谁是真聪明,谁是虚胖,谁"想得多但下得臭",下几盘就全暴露了。
是骡子是马,拉出来溜溜。
项目已开源,MIT 协议,欢迎体验、提 Issue、提 PR。



