阿里云代理商:大模型多卡训练为何没有线性提速?GPU集群瓶颈解析
✅本文由 ➡️国内云代理商『聚搜云 JuSouYunClouD -服务器服务商•撰写』如需转载请注明!
从一张GPU扩到多张,训练速度没有按卡数增长,并不一定意味着硬件异常。梯度同步、数据读取和无法并行的程序部分,都会消耗时间。阿里云GPU集群的排查应从可比较的训练记录开始:模型与精度是否一致,总批次是否改变,记录的是单步耗时、样本吞吐,还是达到目标质量的总时间。比较口径不同,很容易把正常开销看成故障。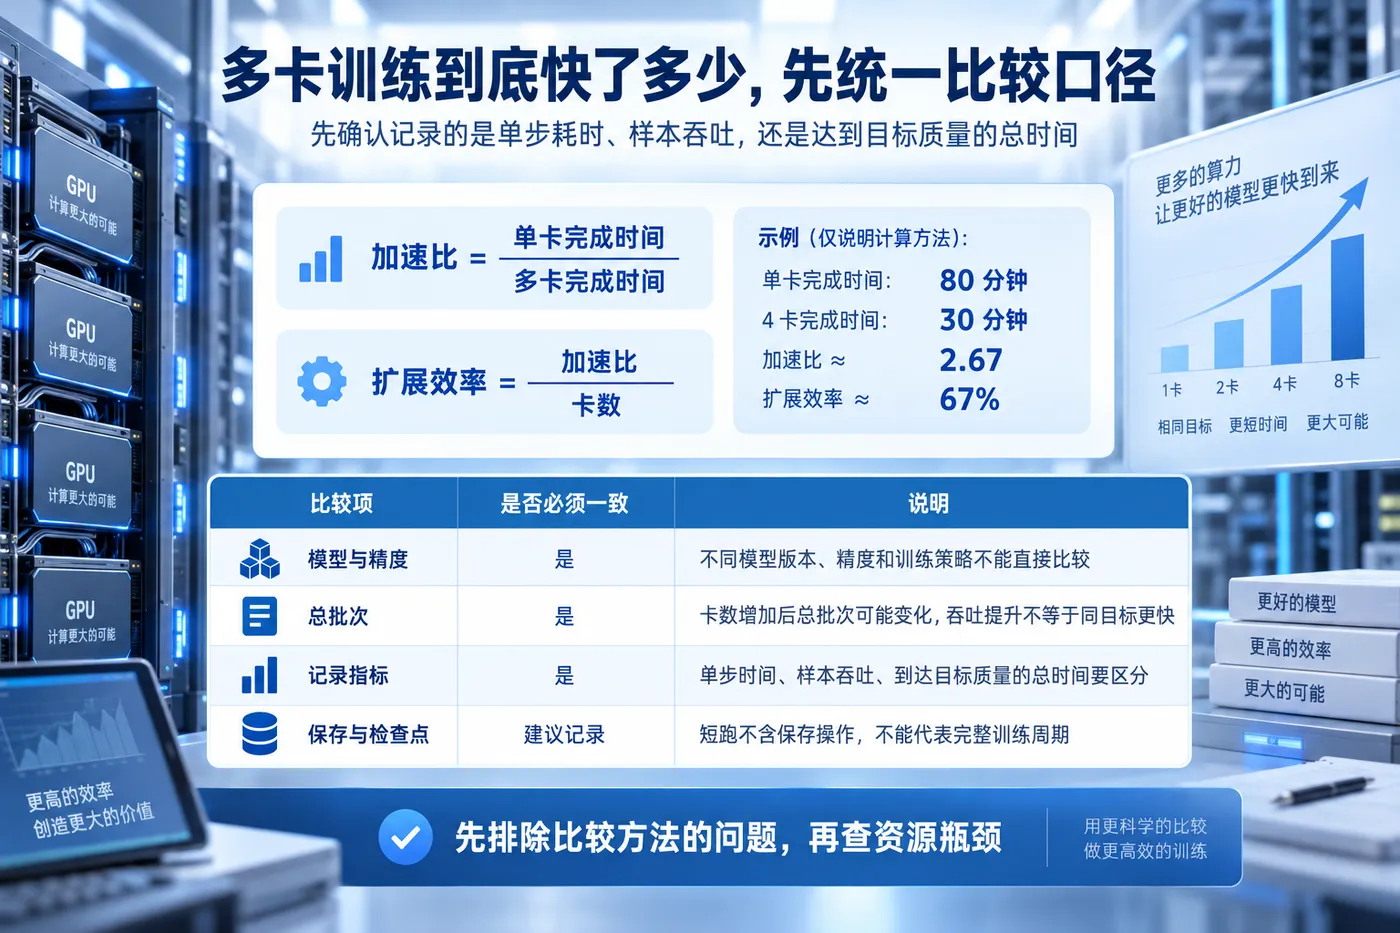
一、阿里云多卡训练,先确认“快了多少”怎么算
固定工作量时,可以用单卡完成时间除以多卡完成时间计算加速比,再除以卡数计算扩展效率。例如,假设相同任务单卡耗时80分钟,4卡耗时30分钟,加速比约2.67,扩展效率约67%。这是说明计算方法的假设,不是某款阿里云实例的测试结果。
如果单卡无法装下模型,就从最小可运行配置开始比较,并在计算中使用相对增加的卡数。另一个常见误差是总批次改变:每卡批次相同,卡数增加后总批次也可能增加。这可以用于吞吐测试,却不能直接证明完成相同训练目标更快,还需检查训练策略与质量结果。
先排除比较方法的问题,再查资源瓶颈。测试阶段同时记录每步时间、数据等待和保存检查点的耗时,避免用一段不含保存操作的短运行代表整个训练周期。偶发慢步与每步持续偏慢,通常需要不同排查路径。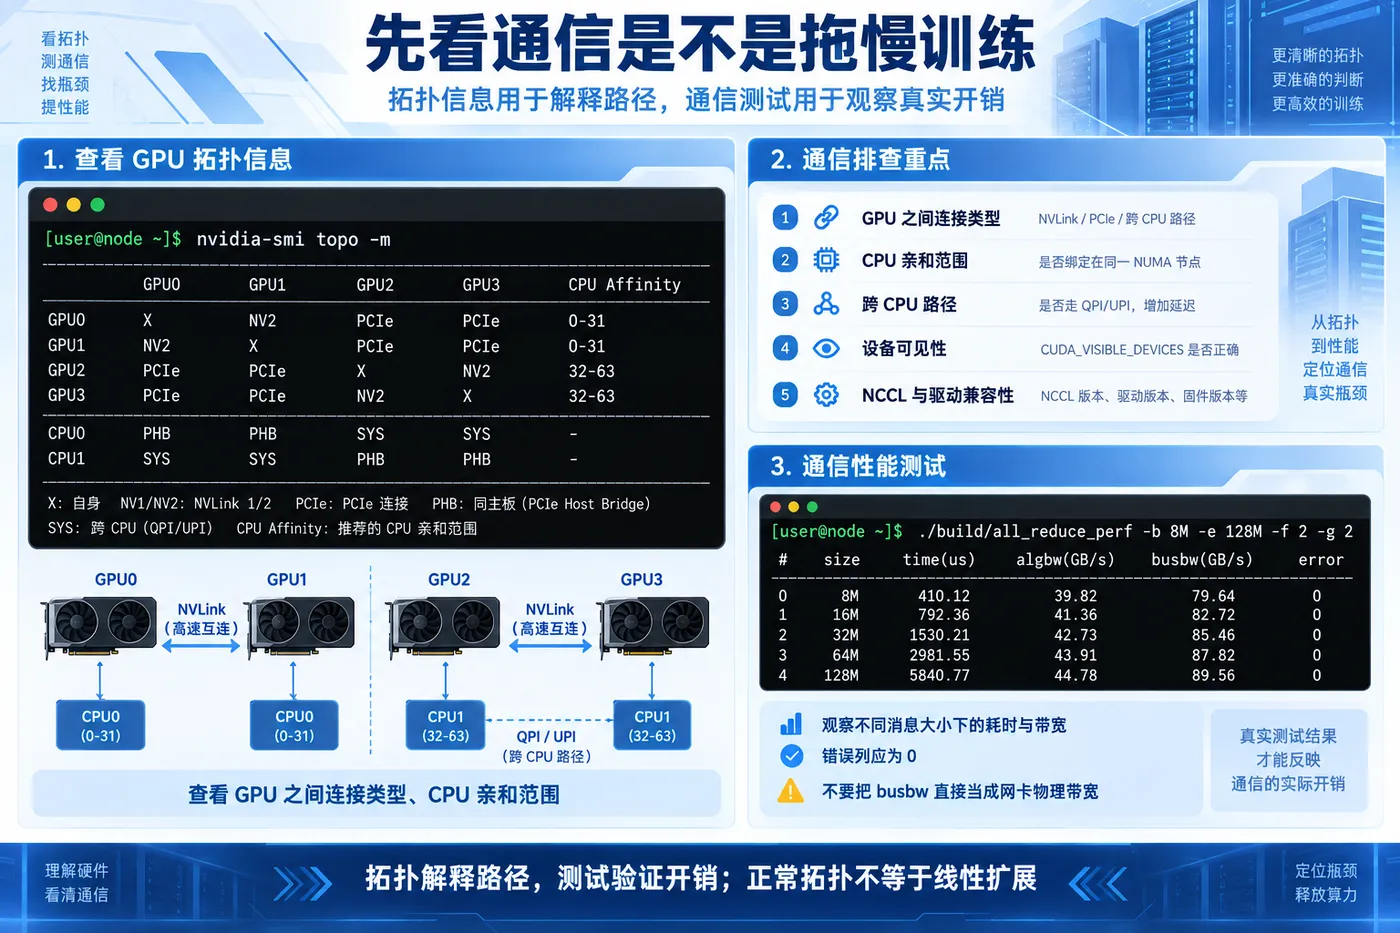
二、阿里云GPU通信,是不是拖慢训练的环节
先在测试实例查看卡间拓扑。命令只读取信息;不同硬件或虚拟化环境可能无法显示全部连接信息,缺少某项展示不能单独证明链路故障。
nvidia-smi topo -m
关注GPU之间的连接类型以及CPU亲和范围,再与所购规格的连接能力核对。出现跨CPU互联路径时,应进一步检查进程和数据位置是否合理;看到NVLink相关标识也不能据此认定训练必然线性扩展。拓扑用于解释通信路径,真实开销仍需要测试。
在已按NVIDIA说明编译好nccl-tests、拥有两张可用GPU的独占测试环境中,可以运行下面的单机双卡集合通信测试。它会占用GPU并产生通信负载,不应与生产训练同时执行;测试不修改模型或数据文件。
./build/all_reduce_perf -b 8M -e 128M -f 2 -g 2
观察不同消息大小下的耗时与带宽,并检查正确性错误列是否为零。不要将busbw直接当成网卡物理带宽,也不要把一次正常测试视为跨机网络全部正常。若测试报错、挂起或同环境重复结果波动很大,再检查驱动与NCCL兼容性、设备可见性和相关日志。
(一)阿里云跨机训练,还要核对实际使用的网络
支持eRDMA的规格仍需要匹配的网卡、驱动和通信配置,购买了相关实例不代表训练进程已经走上预期路径。应按对应规格的官方文档核对,不能从其他机型复制整套环境变量。更改通信参数前保留原配置,在独立任务中验证,避免为排查一项性能问题影响现有集群。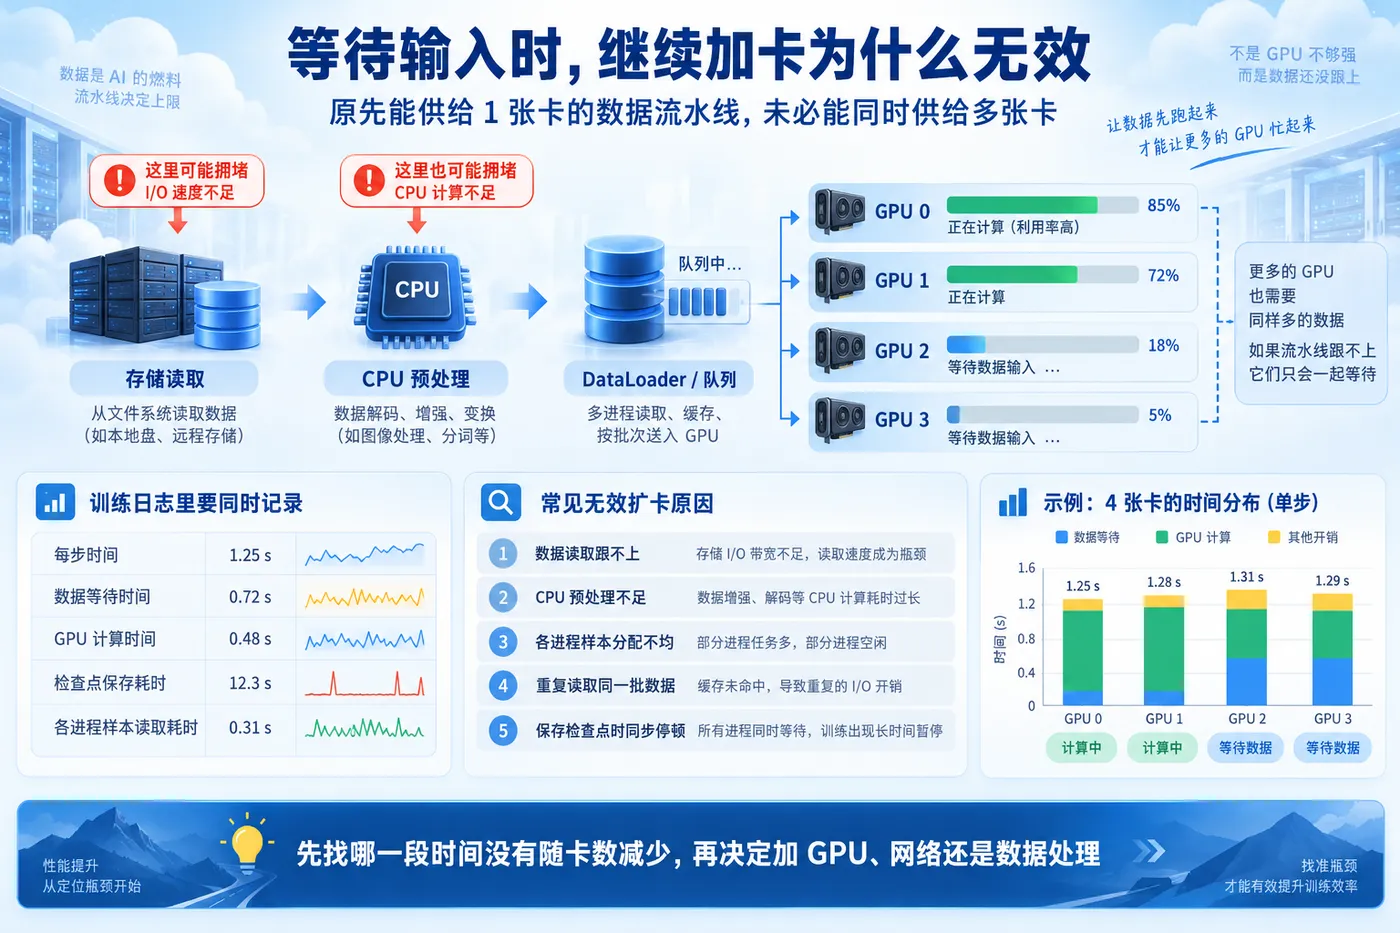
三、阿里云GPU等待输入时,继续加卡为什么无效
如果通信测试表现稳定,而训练日志显示大量时间在等待下一批数据,应转向数据加载。增加卡数之后,存储读取和CPU预处理也需要扩展;原先能供给一张卡的流水线,未必能同时供给多张卡。还要检查各进程是否正确分配样本,避免重复读取同一批数据却误以为有效吞吐提高。
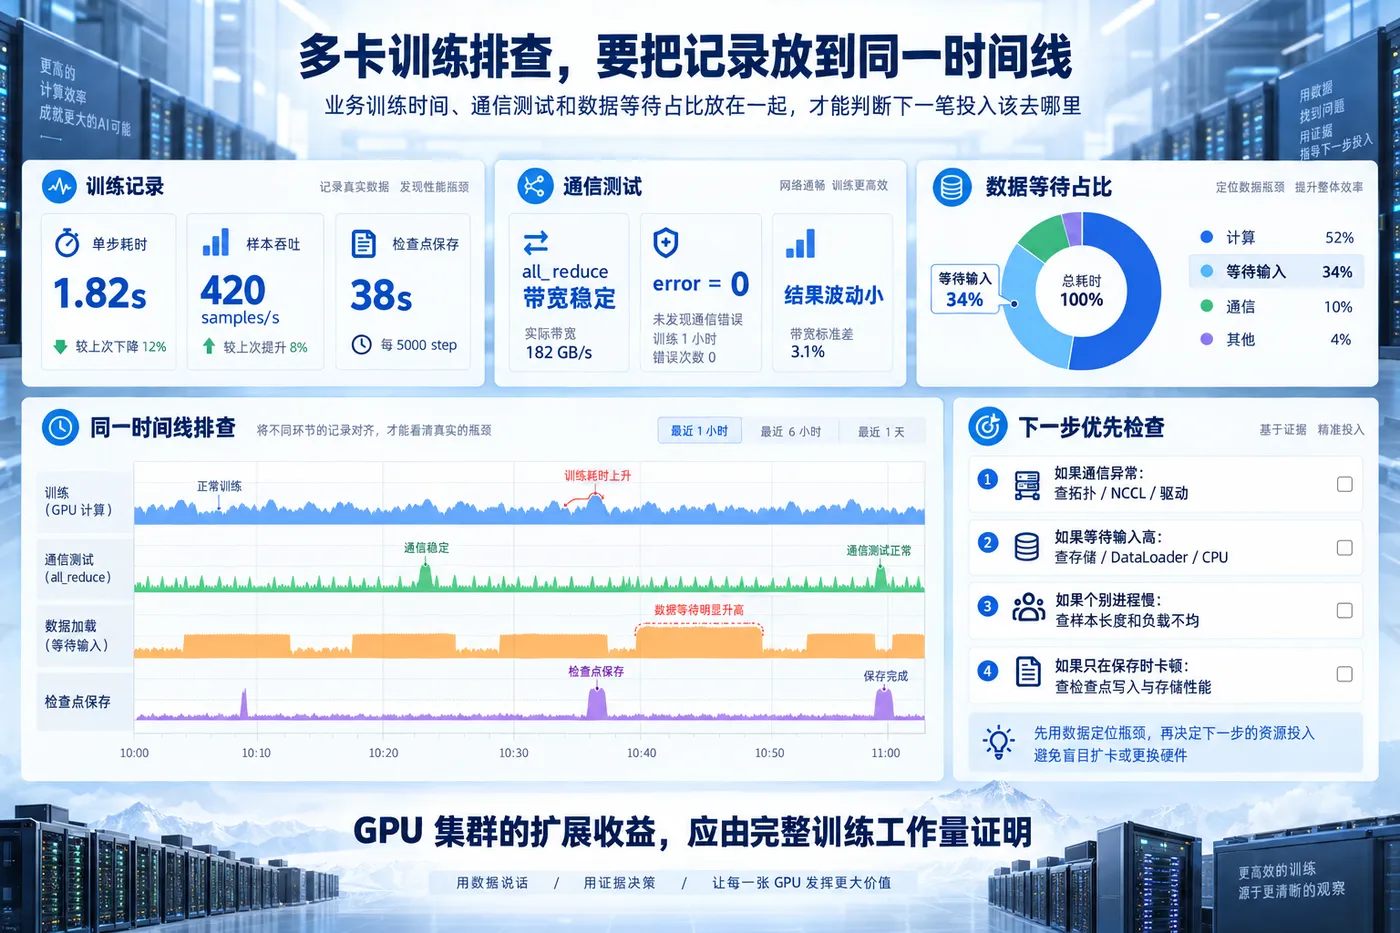
聚搜云的集群选型服务可以把扩容依据整理成三份记录:业务训练时间、通信测试和数据等待占比。三者放在同一时间线中,才能判断下一笔投入该用于GPU、网络还是数据处理。只用GPU利用率截图解释整个集群,往往看不到等待发生在哪一层。
若某个进程总是比其他进程慢,同步训练可能被这个慢进程牵制。应比较各进程的样本长度与读取耗时,检查是否存在负载不均,尤其是变长文本或不同分辨率图片。若只在保存时出现同步停顿,则评估检查点写入方式和存储性能,而不是先改通信算法。
多卡训练速度没有线性提升时,最终需要回答的是哪一段时间没有随卡数减少。找到持续等待的环节后,再做单项调整并复测。GPU集群的扩展收益,应由完整训练工作量证明,不能只靠更多设备同时出现在控制台中。