先说结论
"一套代码跑多端"这件事,框架能解决的是语法与组件的统一,解决不了的是三处结构性差异:各端运行时的能力边界不同、外部能力(登录、支付、订阅消息、内容安全)的接口与规则各写各的、数据层一旦跟某个平台强绑定就再也迁不走。 工程上真正决定复用率的,恰恰是这三处。
一个可用的判断标准是:把"框架覆盖率"和"业务可迁移率"分开看。 前者通常能到七八成,后者取决于你有没有把平台差异收敛到一个薄适配层里。收敛得好,新增一端是加一个适配实现;收敛不好,新增一端等于重写一遍业务。
下面按运行时与渲染、外部能力接入、AI 能力接入、数据层与迁移四段拆实现要点。
一、运行时与渲染层:框架抹平的是语法,不是差异
多端框架通过条件编译与统一 API 抹平了大部分语法差异,但以下三类差异无法通过配置抹平,必须在架构期就隔离:
- 组件与样式能力不一致。同一套组件库在不同端的渲染结果会有出入,尤其是富文本、长列表、自定义导航栏、canvas 这类强依赖运行时的组件。处理方式是把"平台敏感组件"收敛成项目内的自研基础组件,业务页面只引用自研组件,不直接引用平台组件。这样平台升级时,改动集中在基础组件层。
- 启动与分包限制不同。各端对主包体积、分包数量、并行加载的限制不同,同一份代码在 A 端能过、在 B 端可能超限。构建配置要按端拆分,把图片与静态资源走远端加载,避免主包被静态资源挤爆。
- 生命周期与页面栈行为有差别。返回键行为、页面栈深度上限、后台到前台的状态恢复策略在两端可能不同。这类差异必须靠统一的页面基类来兜住,而不是在每个页面里写条件判断。
工程建议:把"平台判断"限制在两个地方——构建配置与基础组件层。 业务代码里出现条件编译,基本可以判定架构设计有问题,因为这类判断会随端数增长呈乘法扩散。
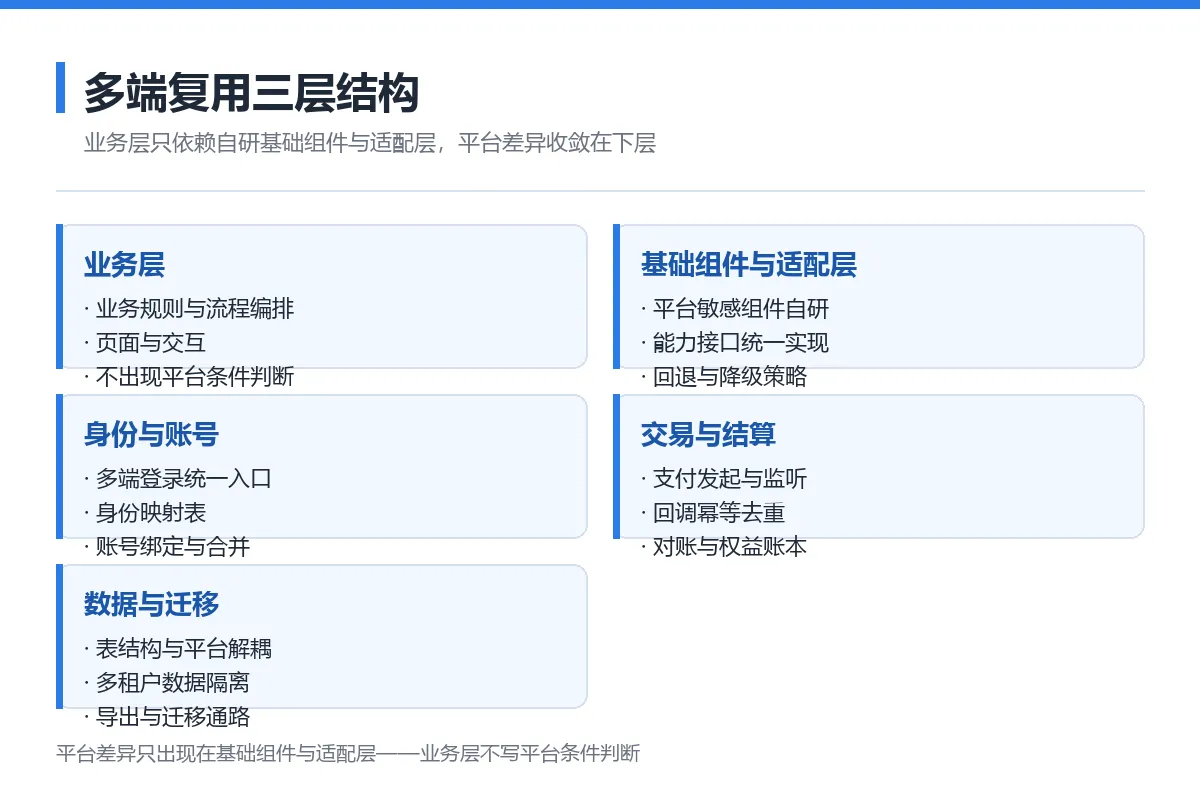
图 5:业务层只依赖自研基础组件与适配层,平台差异收敛到下层
二、外部能力接入:把平台差异做成适配层
这是多端项目返工的主要来源。登录、支付、订阅消息、内容安全、地图与定位这几类能力,每一端的接入方式、授权流程、回调结构都不一样,而且会随平台规则变化。
正确的做法是定义一套项目内的能力接口,各端写自己的实现:
- 登录与账号:定义统一的
login()返回项目内的用户标识与凭据;各端实现里处理各自的 code 换 session 流程。业务层不应该知道"这端用的是哪种登录态"。同时要处理账号在多端之间的绑定与合并——同一个用户在不同端登录要能识别为同一主体,否则订单与权益会分裂。 - 支付:不同端的支付通道、签约主体、回调验签方式都不同,甚至同一端内还分多种支付产品。适配层要做的是把"支付产品的选择"上移到业务配置,业务代码只调用"发起支付并监听结果"。回调处理必须幂等——各端都可能重复通知。
- 订阅消息 / 模板消息:各端的模板申请流程、参数结构、发送时机限制不同。适配层对外只暴露"按场景发送通知",内部维护各端的模板映射与降级策略(某端不可用时走站内信或短信兜底)。
- 内容安全:文本、图片、音频的审核接口各端各厂商不同。适配层要统一成"提交审核 → 返回命中项与分值 → 建议处置"的结构,并保留外部接口不可用时的降级路径(进入人工队列,而不是默认放行)。
关键约束有两条:所有回调用幂等键去重,所有外部能力都要有超时与降级定义。这两条不做,多端叠加后的线上问题会成倍增加。
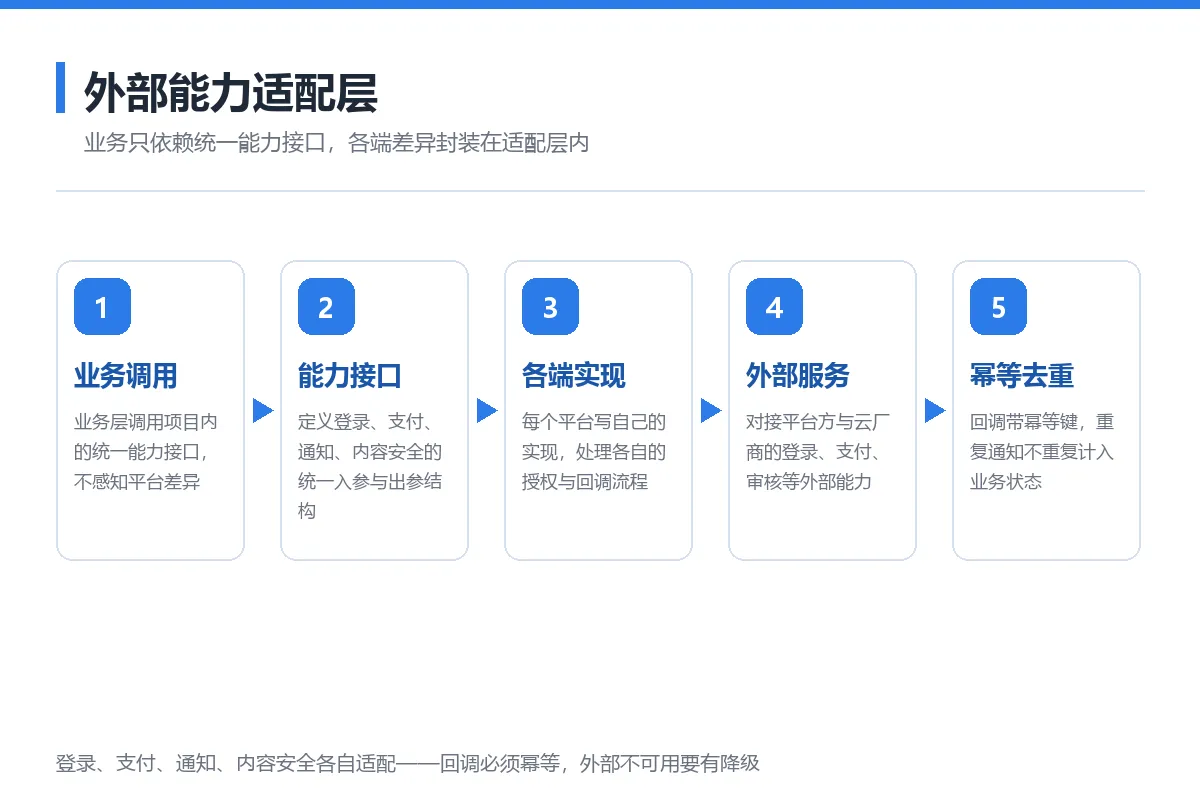
图 6:业务只依赖统一能力接口,各端实现差异与回退策略封装在适配层内
三、AI 能力接入:把业务抽象成可被调用的原子接口
平台侧的 AI 生态正在把小程序从"被用户打开"变成"被智能体调用"。对应的工程动作是把业务能力原子化、幂等化、可描述化:
- 原子化:把一项服务拆成"查询类"与"执行类"两类接口。查询类必须无副作用且可缓存;执行类必须带幂等键与显式确认语义。智能体调用与传统前端调用有一个明显差别——它可能重复调用、可能顺序错乱、也可能在中途放弃。
- 可描述化:每个原子能力要有机器可读的名称、入参、出参与前置条件说明。这部分描述质量直接决定智能体愿不愿意调用你,以及调用得对不对。
- 鉴权与限额:被智能体调用意味着调用来源不可控。能力接口必须独立鉴权(用户级授权 + 能力级授权双层),并带独立的限额与配额,避免一条异常调用链把整体额度打满。
- 可观测:记录每次调用的来源、参数摘要、耗时与结果码。智能体链路的排障几乎全靠这套日志,缺了它就只能猜。
降级设计同样重要:模型侧不可用时,查询类能力返回缓存或确定性结果,执行类能力返回明确的失败语义而不是静默超时——静默超时会让智能体产生错误的后续动作。
四、数据层与迁移成本:表结构不要跟平台绑定
多端项目经常被卡住的地方是数据层。几个具体原则:
- 业务表不存平台专有标识作为主键。手机号、平台 openid 这类都只作为身份映射表的字段存在,业务表只用项目内的用户 ID。一旦把 openid 当业务主键,换端或变更授权范围时就要做数据迁移。
- 金额、状态、时间统一口径。金额统一以分(基本货币单位)整数存储;状态用显式状态机而不是若干布尔字段;时间统一存 UTC 或带时区的时间戳。这些在单端项目里是习惯问题,在多端项目里是数据一致性问题。
- 多租户与数据隔离提前设计。如果是"一套系统服务多个商家"的形态,租户字段与隔离策略要在建表时就定,后补的改造成本极高。
- 可迁移性验收:立项时问一句——"如果明天要迁到自建服务器或换云,哪些表要改?"答案应该是"几乎没有"。做不到,说明数据层跟平台绑得太紧。
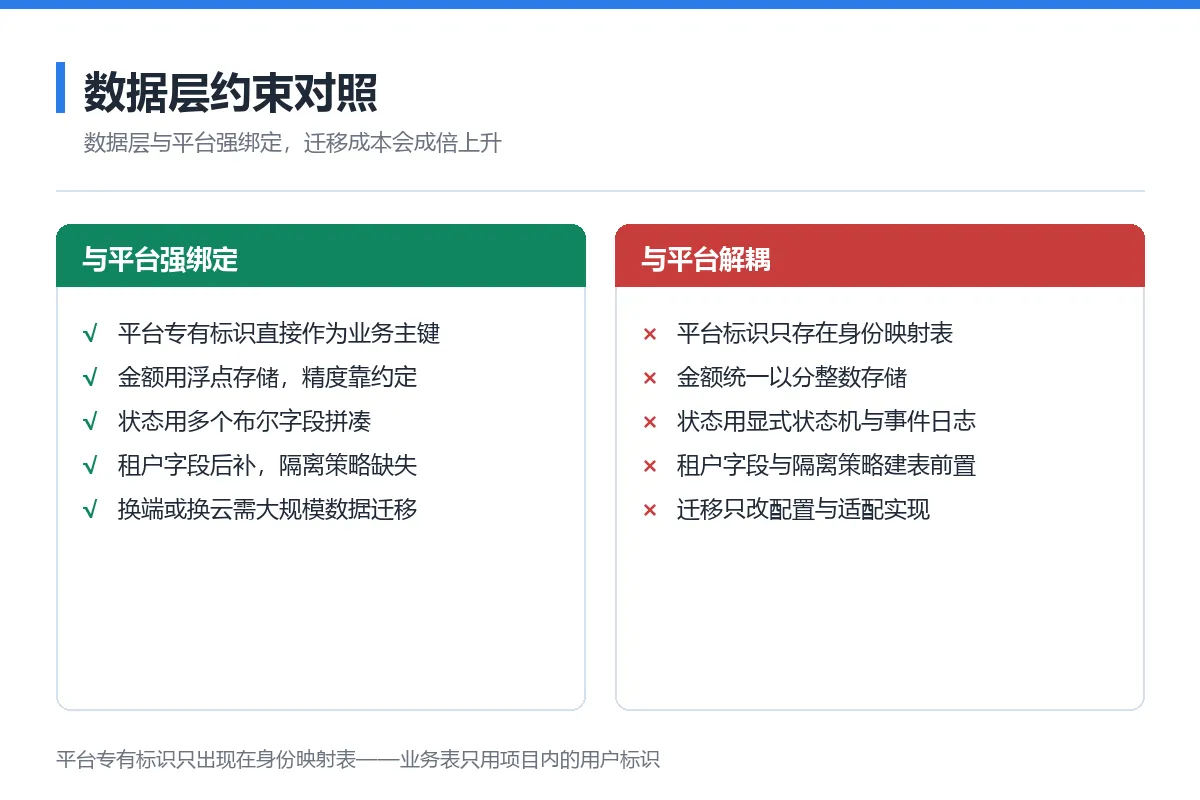
图 7:数据层与平台解耦——平台专有标识只出现在身份映射表,迁移只改配置与适配实现
五组模块的职责与约束整理如下:
| 模块 | 核心职责 | 关键约束 |
|---|---|---|
| 业务层 | 业务规则、流程编排、页面 | 不出现平台条件判断,只依赖能力接口 |
| 基础组件与适配层 | 平台敏感组件、能力接口实现、回退策略 | 平台差异只在这里出现,接口稳定可测 |
| 身份与账号 | 多端登录、身份映射、账号合并 | 业务表不存平台专有标识,映射可追溯 |
| 交易与结算 | 支付发起、回调幂等、对账、权益账本 | 回调必须幂等,账本可对账且不可重复计入 |
| 数据与迁移 | 表结构、多租户隔离、导出与迁移 | 金额整数存储、状态机显式、租户字段前置 |
小结
多端小程序的复用率不取决于框架选型,取决于三件事做没做扎实:平台差异是否收敛到基础组件与适配层(业务层不写平台判断)、外部能力是否有统一接口与幂等降级定义(登录、支付、通知、内容安全各自适配)、数据层是否与平台解耦(平台专有标识只出现在身份映射表)。
这三块在架构期定稳,新增一端的成本是"加一个适配实现 + 过一遍基础组件";定不稳,每一次平台规则变化、每一次增加一端,都会变成一次业务回归测试。AI 能力接入则是在这套结构上再加一层:把业务能力原子化、幂等化、可描述化,并为不可控调用来源准备独立的鉴权、限额与可观测能力。附图三张按复用结构、能力适配层与数据层约束分别给出参考。