
Java里的switch,你能匹配什么?——基本类型、字符串、枚举。而且每个case要记得break,否则穿透;只能做"值等于哪个常量"的判断。
Scala的match看起来像switch,但它做的事情完全不是一个量级。
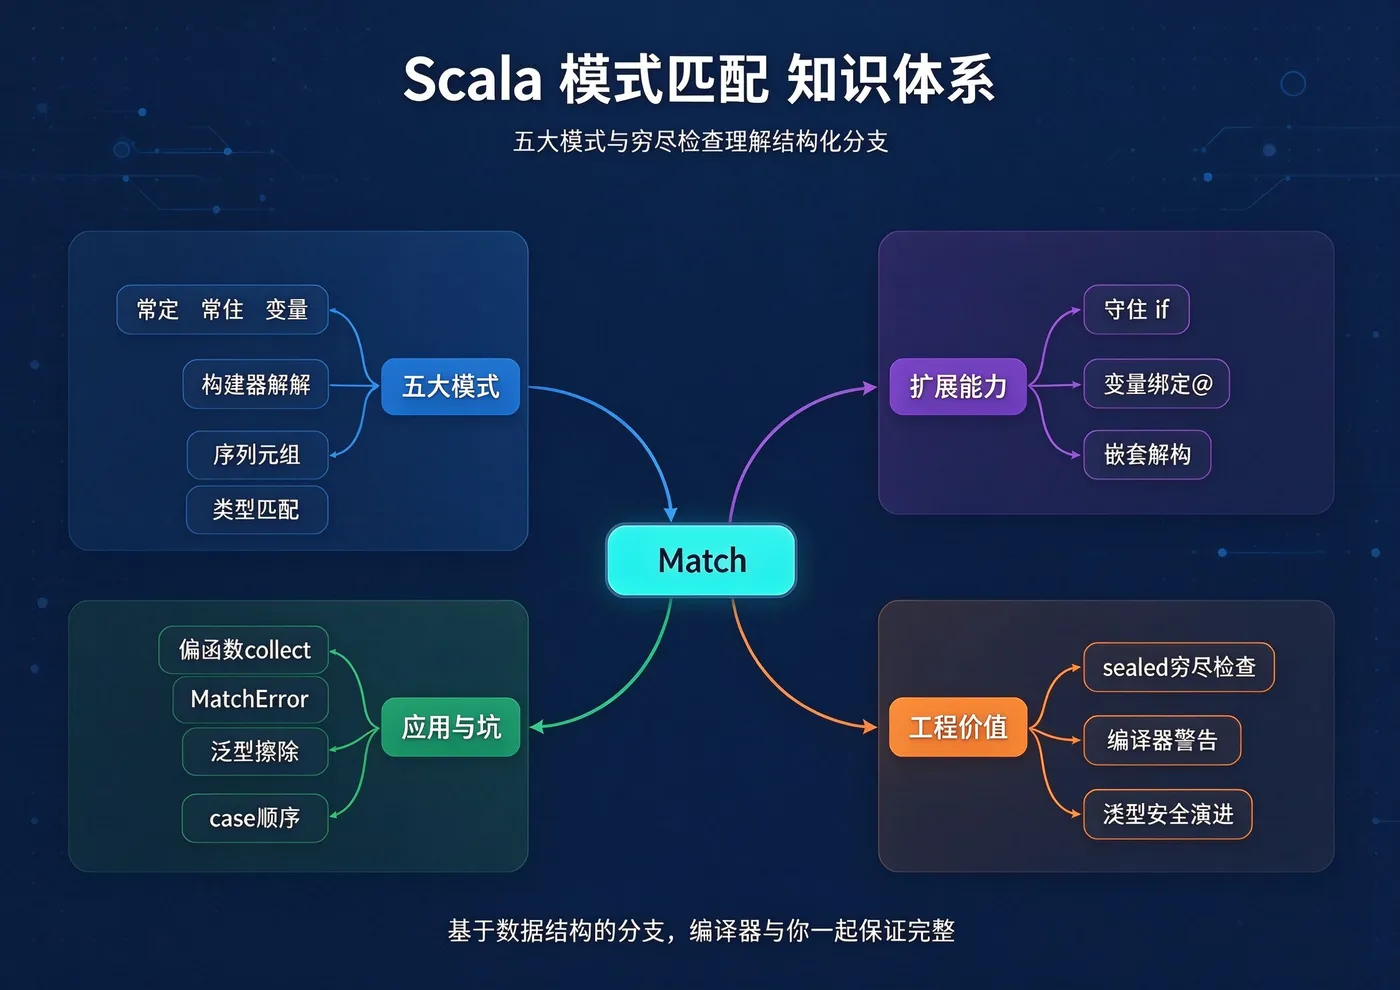
它能匹配:常量、变量、类型、元组、集合、样例类的内部结构;还能加守卫条件、嵌套解构、绑定变量。它不是在判断"这个值等于哪个常量",而是在回答:"这个数据的结构长什么样,里面装了什么?"
这篇文章讲透:match有哪些匹配模式?它背后靠什么工作(unapply)?密封类为什么能让编译器帮你检查漏没漏case?
基本形态:match是表达式,没有break
val day = "MON"

val result = day match {
  case "MON" => "周一"
  case "TUE" => "周二"
  case _     => "其他"   // 通配,相当于default
}
和switch相比,三个根本差异:
- match是表达式,有返回值——可以直接赋值给变量
- 没有break,不会意外穿透——每个case自动结束
case _是通配兜底——不写兜底又没匹配上,会抛MatchError
模式一:常量匹配与变量匹配
val target = 100

def classify(x: Int): String = x match {
  case 0       => "零"
  case `target` => "等于目标值"   // 反引号引用外部常量
  case other   => s"其他值:$other"  // 小写变量名,捕获匹配值
}
这里有个关键细节:case后面小写开头的标识符会被当成"变量模式"——它捕获被匹配的值,而不是去比较同名变量。 想匹配一个已有的常量,要么用反引号`target` ,要么常量名用大写开头。这是新手常踩的坑。
模式二:构造器模式——直接解构样例类
这是模式匹配最强大的用法。你不仅能判断"是不是某个类",还能直接把它内部的字段提取出来:
case class Point(x: Int, y: Int)

def describe(p: Point): String = p match {
  case Point(0, 0)       => "原点"
  case Point(x, 0)       => s"在X轴上,x=$x"
  case Point(0, y)       => s"在Y轴上,y=$y"
  case Point(x, y)       => s"普通点($x, $y)"
}
case Point(0, 0)这一行,编译器调用了Point.unapply把对象拆开,然后逐字段匹配。还可以嵌套解构:
case class Employee(name: String, manager: Point)

e match {
  case Employee(name, Point(x, y)) => println(s"$name 在 ($x,$y)")
}
这种"按结构深入匹配"的能力,是switch完全无法想象的——你在描述数据应该长什么样,而不是写一连串if去取值、比较。
模式三:序列与元组匹配
// 匹配List结构
def listInfo(lst: List[Int]): String = lst match {
  case Nil          => "空列表"
  case head :: Nil  => s"只有一个元素:$head"
  case head :: tail => s"首元素$head,剩余$tail"
}

// 匹配元组
def coord(c: Any): String = c match {
  case (x, y)    => s"二维:($x, $y)"
  case (x, y, z) => s"三维:($x, $y, $z)"
  case _         => "未知"
}
head :: tail利用了::这个样例类的结构来匹配列表——首元素和剩余部分一次拆开。处理递归数据结构时,这让代码异常清晰。
模式四:类型匹配——替代繁琐的instanceof+强转
def process(obj: Any): String = obj match {
  case s: String    => s"字符串,长度${s.length}"
  case n: Int       => s"整数:${n * 2}"
  case l: List[_]   => s"列表,大小${l.size}"
  case _            => "其他类型"
}
Java里要先instanceof判断、再手动强转、才能调用方法。Scala匹配类型后,变量自动按该类型处理,无需强转——编译器替你做了。
注意泛型擦除:case l: List[String]里的String在运行时是擦除的,只能写成List[_];但数组例外,数组元素类型运行时保留。
模式五:守卫与变量绑定
守卫(guard)——给case加if条件
def grade(score: Int): String = score match {
  case s if s >= 90 => "优秀"
  case s if s >= 60 => "及格"
  case _            => "不及格"
}
守卫让你在结构匹配之外,再叠加任意布尔条件,处理范围判断。
变量绑定——既想匹配结构,又想保留整个对象
case class Company(boss: Employee)

c match {
  case Company(boss @ Employee(name, _)) =>
    println(s"老板整体:$boss,名字:$name")
}
@前面绑定整个匹配到的对象,后面继续解构它的内部。
密封类:让编译器替你检查case是否穷尽
这是模式匹配在工程上最有价值的特性。
当你匹配一个sealed(密封)类型时,编译器知道它所有可能的子类型——因为sealed要求子类型必须定义在同一个文件里。于是如果你漏写了某个case,编译器会警告:
sealed trait Shape
case class Circle(r: Double) extends Shape
case class Square(side: Double) extends Shape
case class Triangle(a: Double, b: Double, c: Double) extends Shape

def area(s: Shape): Double = s match {
  case Circle(r)       => math.Pi * r * r
  case Square(side)    => side * side
  // 漏了Triangle——编译器立刻警告"match may not be exhaustive"
}
这个警告的价值极大:以后你给Shape新增一个子类型,所有对它做match的地方都会被编译器标红,逼着你补上处理逻辑。这等于让"分支是否覆盖完整"从运行时bug变成编译期检查。
这也是为什么Scala里用sealed trait + case class建模消息、状态、事件如此普遍——配合match,整个体系是类型安全、可穷尽、可演进的。
模式匹配与偏函数
你在集合上写的collect,本质就是一个只对部分输入生效的模式匹配:
val mixed = List(1, "a", 2, "b", 3)

mixed.collect {
  case i: Int => i * 10
}
// List(10, 20, 30)——只匹配整数,字符串被跳过
{ case ... }这种没有match关键字的写法,是一个偏函数(PartialFunction)——它只对能匹配上的输入有定义。Spark/Flink里大量算子(如map { case ... }、Akka的消息处理receive)都建立在这个机制上。
几个常见的坑
坑1:漏写兜底导致MatchError
匹配一个非sealed类型(如Any)时,编译器无法保证穷尽,运行时遇到没覆盖的情况直接抛MatchError。要么写case _,要么确保逻辑上一定覆盖。
坑2:变量模式误捕获
前面说的,小写变量名会捕获值而不是比较常量。匹配常量用大写命名或反引号。
坑3:泛型类型匹配被擦除
case m: Map[String, Int]运行时拿不到类型参数,写成Map[_, _],需要的话再单独检查元素。
坑4:case顺序影响结果
Scala按书写顺序匹配,更具体的case要放在更通用的前面。case Point(0,0)必须在case Point(x,y)之前,否则永远走不到。
坑5:别在match里写副作用当if-else用
match最适合"按数据结构分支"。纯粹的布尔条件判断,用if更清晰;match的威力在于解构和穷尽检查。
写在最后
switch和match的差距,表面上是"能匹配的东西更多了",本质上是两种完全不同的分支观:
- switch是基于值的分支——这个标量等于哪个常量
- match是基于结构的分支——这个数据是什么形状、由什么组成
后者之所以强大,是因为它和代数数据类型(sealed + case class)、提取器(unapply)构成了一套闭环:你用样例类把数据"合"起来,用match把数据"拆"开并按结构处理,编译器还能在数据类型增加时,提醒你所有需要改动的分支位置。
于是一类很容易出错的代码——"根据对象的不同类型和内容走不同逻辑"——从需要层层if、instanceof、强转、还可能漏分支的手工活,变成了声明式、可穷尽、编译器护航的结构化表达。
这也是为什么在Spark里处理不同类型的Row、在Flink/Akka里处理不同消息、在业务代码里处理不同状态和事件时,有经验的Scala开发者会本能地选择sealed + case class + match这一套组合。它让"正确处理所有情况"成为编译器和你一起保证的事,而不是靠你每次都记得。
当你开始用数据结构的视角而不是值的视角去组织分支,当你信任编译器的穷尽警告并享受新增类型时它帮你找出所有待补逻辑,你才算真正用上了Scala模式匹配的威力。



