目录
2. required_evidence 和 pass_condition 不能混为一谈
3.1 criterion、description 与 pass_condition
5. 一次真实代码追踪:要求 CI 验收,为什么却无法进入 CI 直判?
摘要:前两篇文章我们分别讨论了 Agent 交付物验收的四道闸门流程,以及 Evidence 证据采集的工程实现。但验收体系的源头,验收标准本身怎么设计,同样容易出问题。写出一条需求并不难,难的是把它变成真正能够被系统检查的验收规则。字段写在模型里不代表代码真的会读取,配置看起来合理,不代表能正常进入评审流程。
本文结合 AI Tutor Engine (信科院智能助手 · INFO SYSTEM) 的真实生产代码,拆解 Rubric 的字段设计、证据门槛、评价角色与最终聚合逻辑,并通过一次完整的代码追踪,展示「配置合理、实际却无法生效」的典型问题。同时区分已经实现的功能、仅由 Prompt 约束的规则,以及尚未解决的问题。
所有测试结论均来自本地测试环境,不代表已经在生产环境中验证。
1. 一条验收标准,至少要回答几个问题?
先看一个真实的 Rubric 定义,来自项目的 course03_data.py:
Rubric(
    id="rb_c3t06_2",
    task_id="c3_t06",
    criterion="工具说明清晰可用",
    description="每个工具有明确的用途说明,能据以判断何时调用",
    required_evidence=["code"],
    pass_condition="每个工具的说明写明「做什么 + 何时用」,不是空描述",
    weight=2
)
这条规则已经包含了验收需要的几个关键信息,每个字段的作用与生效环节并不相同:
| 字段 | 作用 | 生效环节 |
|---|---|---|
| criterion | 指出要检查什么 | LLM 语义评审 |
| description | 进一步说明检查目标 | LLM 语义评审 |
| required_evidence | 声明判定前需要哪些证据 | 代码层证据预检 |
| pass_condition | 描述满足什么条件才应当通过 | LLM 语义评审 |
| weight | 决定该标准在总分中的权重 | 代码层分数计算 |
| evaluation_role | 决定该标准是否能影响整体验收状态 | 代码层结果聚合 |
注:上述 Rubric 没有填写 evaluation_role,根据当前数据模型,它默认使用 acceptance。
这几个字段并不是重复描述同一件事。以这个例子来说:
- criterion 告诉评估器检查工具说明是否清晰
- required_evidence=["code"] 声明需要代码证据
- pass_condition 描述工具说明应当包含哪些信息
- weight=2 决定它在交付评分中的权重
但字段定义本身并不能说明它们在运行时一定会生效。要判断实际行为,还需要沿着生产代码追踪。
2. required_evidence 和 pass_condition 不能混为一谈
这是设计 Rubric 最容易混淆的地方:一个管有没有证据,一个管证据够不够,两者执行机制完全不同。假设某条标准要求 required_evidence = ["code"],它只说明评估器需要代码证据,并没有说明代码必须实现什么,也没有说明怎样才算实现成功。这些要求由 pass_condition 描述。
因此,评估过程实际上包含两个独立的步骤:
- 有没有必要的证据? → 代码层证据预检
- 已有证据是否满足验收条件? → LLM 层语义判断
当前 AI Tutor Engine 的实现也是按照这两个层次处理的,但两者使用的机制并不相同:
- required_evidence 会参与代码层的证据预检
- pass_condition 则被拼入 Reviewer Prompt,由 LLM 根据证据进行语义判断
目前没有独立的程序化规则解析器去执行 pass_condition。 比如
pass_condition = "项目运行正常"
这句话本身并没有定义什么叫正常,不同模型可能对它作出不同理解。 相比之下,pass_condition = "GitHub Actions 中对应测试工作流的 conclusion 为 success" 给出了更明确的验证目标,也更容易与已有的 CI 结论对应。
不过,描述得足够具体仍不等于已经实现了确定性校验。当前系统只有在代码里真正编写了相应检查逻辑时,才能保证该条件由程序强制执行。
所以设计 Rubric 时,不仅要考虑标准是否清晰,还要确认:这条标准最终由谁、通过什么机制验证
3. Rubric 的字段到底在哪里生效?
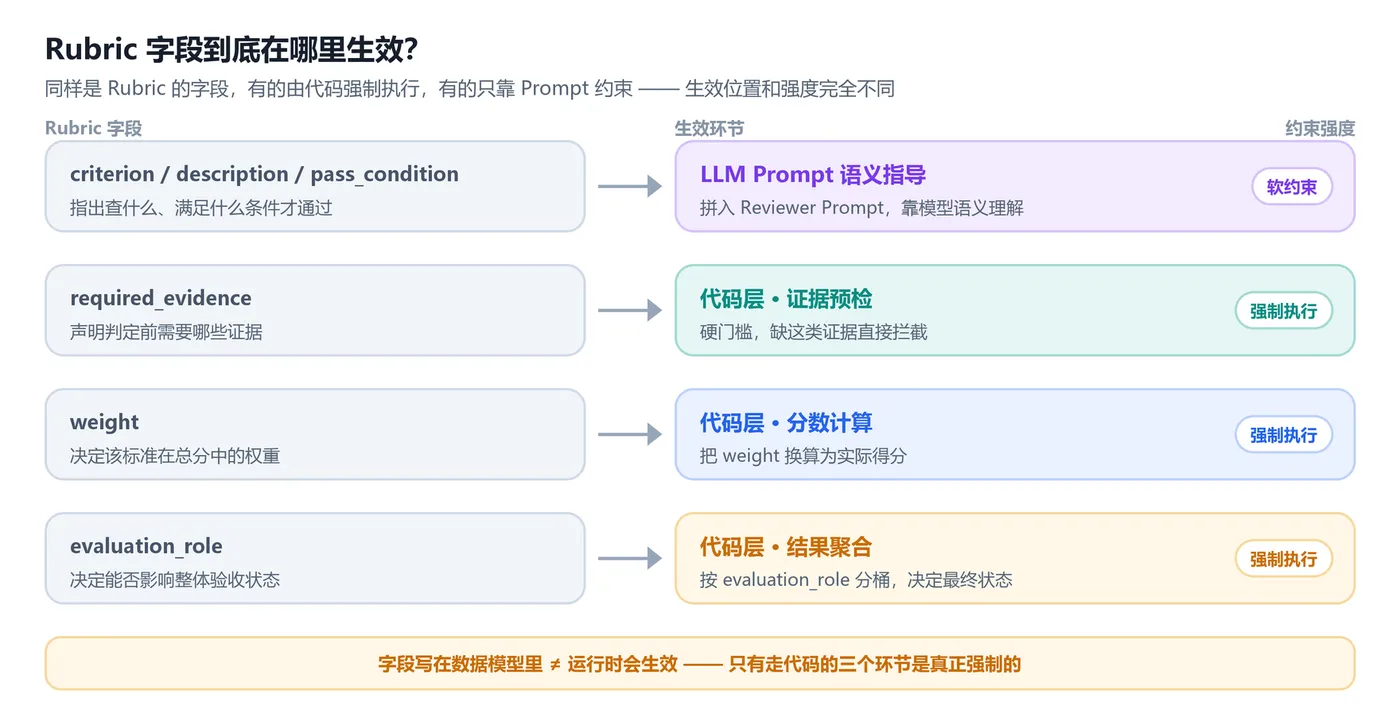
图 1 Rubric 字段到底在哪里生效:三条走代码强制,一条只靠 Prompt 约束
3.1 criterion、description 与 pass_condition
在 review.py 的 build_review_system_prompt() 中,系统会把 Rubric 的主要信息组织成 Reviewer 可以理解的文本,包括检查目标、描述、所需证据、通过条件和权重。
这些字段主要用于指导 LLM 判断。但 Prompt 中出现了某个字段,不等于系统已经对它实施了程序化强制校验。 例如,当前代码不会解析 pass_condition 中的自然语言,也不会自动将其中每个条件转化为 Python 断言。
3.2 weight 由代码参与计算
与 pass_condition 不同,weight 会直接影响最终得分。
当前 compute_evaluation() 会将权重转换为非负数:
weight_of = {

    r.id: max(int(r.weight), 0)
    for r in rubrics
}
随后根据通过项的权重计算得分:
score = round(passed / total * 100) if total > 0 else 0
这里存在一个值得注意的边界:数据模型没有为 weight 设置 >=1 这样的运行时约束。 因此,负权重在计算时会被归零,而不是在 Rubric 构造阶段直接拒绝。如果所有参与计算的权重都是 0,最终得分也会是 0。
项目中的 _test_phase8.py 会检查课程数据里的权重是否合法,但这与生产运行时自动校验是两回事。
3.3 evaluation_role 决定这条标准阻断权
当前项目将评价角色分成三类:acceptance、theory、reflection,它们会影响后续的结果聚合。这个分桶逻辑我们在第一篇已经详细介绍过,核心就是:
- acceptance:参与交付评分,可以影响最终验收状态
- theory:不计入交付分数,未通过项进入 learning_gaps
- reflection:进入复盘信息,不直接影响交付状态
简单说:理论题答错 ≠ 项目交付失败。如果把理论问答和交付要求全部放进同一个通过条件,理论题就可能阻断整个项目,这未必符合任务本身的目的。
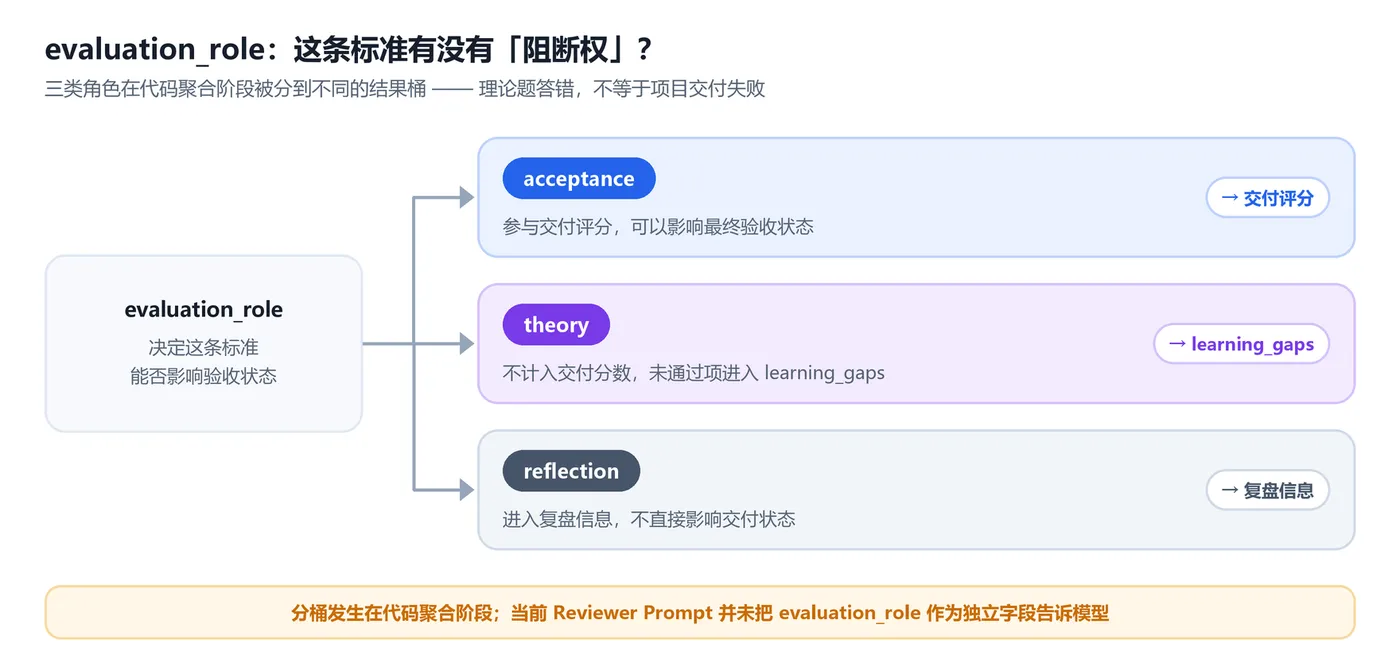
图 2 evaluation_role 三类角色与结果去向:理论题答错不等于项目交付失败
4. 证据预检到底检查什么?
证据预检只判断「能不能进入后续评审」,不判断「交付物达不达标」;且不是所有 required_evidence 类型都是硬门槛。
当前的 evidence_precheck() 会先处理缺少必要证据的 acceptance Rubric,核心逻辑如下:
optional_bonus = {

    "deployment",
    "visual",
    "report",
    "issue"
}

for r in rubrics:
    if _role(r) != EvaluationRole.acceptance:
        passable.append(r)
        continue

    needed = set(r.required_evidence) - optional_bonus
    if not needed:
        passable.append(r)
        continue

    missing = needed - present
    missing_real = {

        m for m in missing
        if m != "description"
    }

    if missing_real:
        forced.append({

            "rubric_id": r.id,
            "missing": sorted(missing_real),
            "reason": "缺少必要证据,无法自动判定"
        })
    else:
        passable.append(r)
这里必须准确说明,当前实现不会把 required_evidence 中的所有类型都视为硬门槛。 代码会先从所需证据集合中排除 deployment、visual、report 和 issue,再检查剩余类型是否齐全。description 也不会被当作满足硬证据要求的依据。
这意味着,如果一条 Rubric 的 required_evidence 只有 report,它不会因为缺少报告就被这道预检直接拦截,而是会进入后续评审流程。
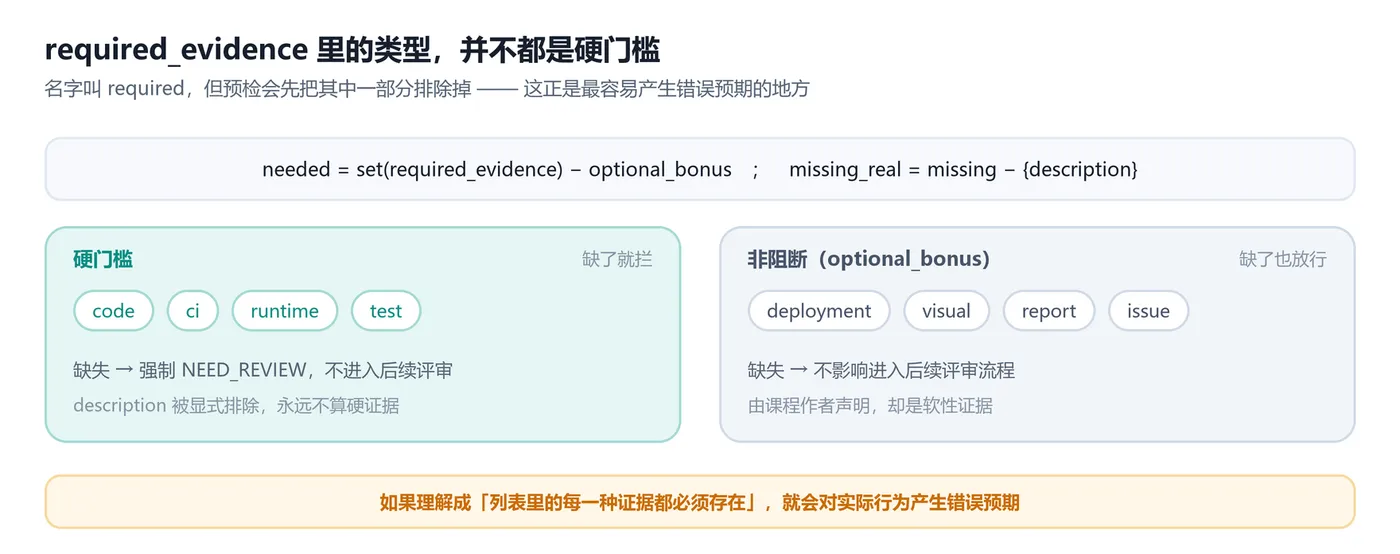
图 3 required_evidence 里的类型并不都是硬门槛
这里存在一个值得讨论的设计问题:字段名叫 required_evidence,但部分类型在预检中被当作非阻断证据。如果开发者理解成 “列表中的每一种证据都必须存在” ,就会对实际行为产生错误预期。
所以更好的做法是明确区分硬性必需证据和可选补充证据,或者在数据模型及校验逻辑中明确声明哪些类型能够作为硬门槛。当前实现还没有完全解决这一语义问题。
证据齐全是开始判断的前提,不是 PASS 的充分条件。
5. 真实代码追踪:要求 CI 验收,为什么却无法进入 CI 直判?
配置看起来完全合理的 Rubric,可能因为证据类型定义与采集、预检、CI 映射链路不对齐,永远走不到预期的判定分支。
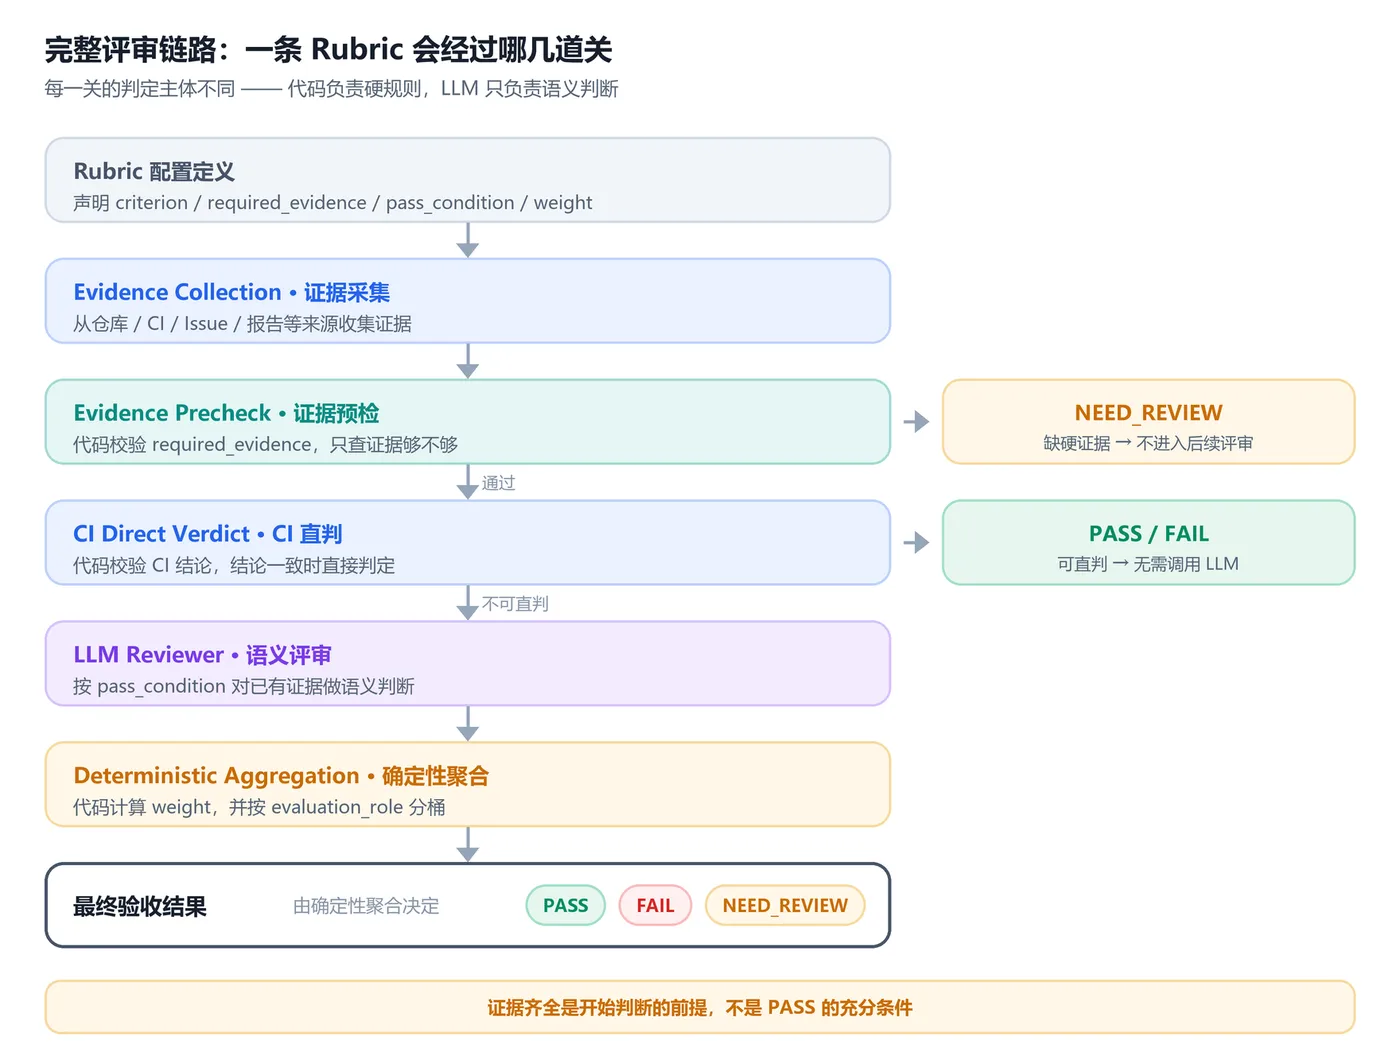
图 4 完整评审链路:一条 Rubric 会经过哪几道关
5.1 配置预期
在 course03_data.py 中,有这样一条标准:
Rubric(
    id="rb_c3t11_3",
    task_id="c3_t11",
    criterion="回归通过",
    description="修复后全部测试通过,没有引入新问题",
    required_evidence=["ci", "runtime"],
    pass_condition="GitHub Actions 结论为成功;没有 CI 时给出完整本地测试输出",
    weight=2
)
从配置意图来看,它需要 CI 和运行方面的证据,预期 CI 成功时可以直接判定通过。
5.2 路径追踪
但沿着真实执行路径追踪后,会发现这条 Rubric 存在一个无法满足的证据要求。
第一,collect_evidence() 没有产生 ci 这个键 当前系统将普通证据保存为 available 字典,其中包括 code、runtime、test、report、issue、description 等信息。 GitHub Actions 的结论则通过独立的 ci_workflows 参数传递,不会同时写入 available["ci"]。
因此,这两份数据实际是分开存储的:
available          ci_workflows
├── code           └── GitHub Actions 工作流及其结论
├── runtime
├── test
├── report
├── issue
└── ...
第二,证据预检先把它拦截了 这条 Rubric 声明 required_evidence = ["ci", "runtime"],假设当前已经拿到了代码和运行说明:
available = {

    "code": "...",
    "runtime": "..."
}
由于 ci 并不在 available 的键集合中,预检仍会发现缺少 ci。 在本地代码验证中,针对 c3_t11 的 Rubric 列表执行 evidence_precheck(),得到了以下代表性结果:
rubric_id: rb_c3t11_3 status: FORCED NEED_REVIEW missing: ["ci"] reason: 缺少必要证据类型:ci,无法自动判定
更关键的是,后续 CI 直判只处理通过预检的 Rubric。已经进入强制 NEED_REVIEW 列表的这条标准,不会再进入 CI 直判。
第三,CI 直判的映射也没有 ci 继续查看 review.py 中的 _CI_DIM_TO_EVIDENCE,可以看到当前使用的是 build、test 和 runtime 等维度映射,没有通用的 ci 键。 所以即使单独将这条 Rubric 传给 ci_direct_verdict(),它也无法根据 ci 这个类型完成直接判定。
5.3 问题定位
问题不在于 LLM 不够聪明,而是证据类型的定义与证据收集、预检和 CI 映射之间没有对齐。 配置层写的是 ci,但采集层不产出、预检层不识别、直判层不映射,整条链路在第一个关口就断了。
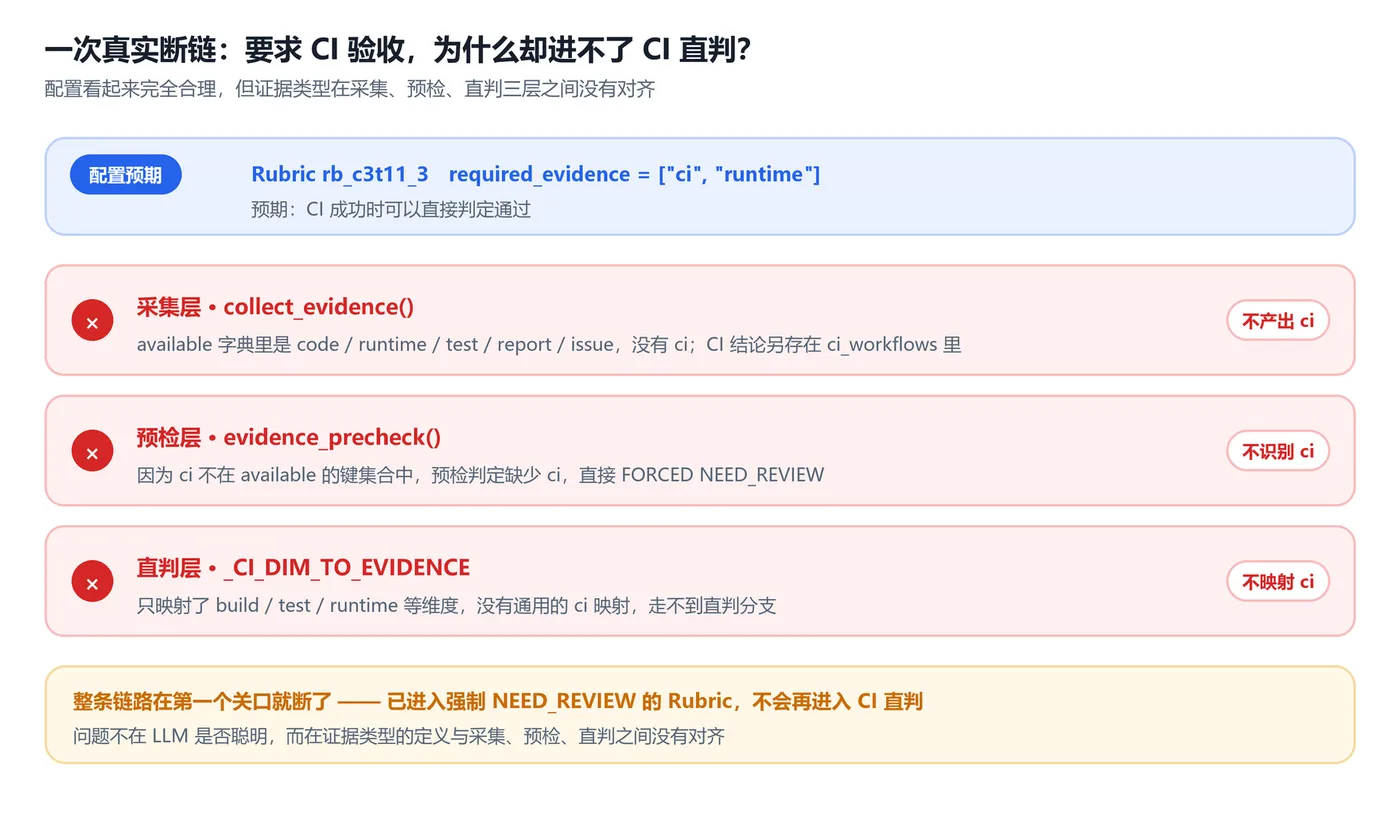
图 5 一次真实断链:要求 CI 验收,为什么却进不了 CI 直判
5.4 修复方向
可以考虑两种方向。 一种是统一证据类型,让课程数据使用系统实际支持的类型,并确保它与 CI 维度能够匹配。 另一种是调整证据接口,让 CI 结论作为明确的证据类型参与预检和后续判断,而不只是通过独立参数传递。
不论选择哪一种,都应该补充端到端回归测试,确认:
- CI 结果存在时,预检不会错误地拦截 Rubric
- CI 结论满足条件时,能够得到预期的 PASS 或 FAIL
- CI 缺失、混合或异常时,能够进入预定的后续分支
核对时,这个问题尚未修复。因此,本文将其作为当前实现的真实缺陷记录,而不是已实现的能力。
6. 字段存在,不等于字段生效
数据模型里定义了字段、课程数据里填了值,都不代表它真的会影响最终评审结果。
6.1 未被消费的遗留字段
另一个容易被忽略的问题是 Task.evidence_required。 在当前数据模型中,Task 有这个字段,课程数据里也有相应填写。但经过生产代码检索,它没有被任何生产函数读取。
实际参与预检的是 r.required_evidence,也就是 Rubric 自己的证据要求。 这意味着:
- Task.evidence_required → 已定义,但当前不影响评审
- Rubric.required_evidence → 实际参与评审
如果开发者以为自己已经在 Task 上设置了验收证据要求,实际运行结果却不会按照该字段变化。
这种问题并不罕见:数据模型中的字段可能是设计早期的遗留,也可能原本准备驱动其他功能,但后来没有接入生产代码。 对此,合理的处理方式包括删除无实际作用的字段、将它接入预期功能,或者明确标注它只是辅助信息。
6.2 类型校验的缺失
required_evidence 的运行时校验也有类似问题。 目前 required_evidence 的元素类型是 list[str]。它可以限制整体类型,却不会自动拒绝任意未知字符串。
例如 required_evidence = ["coded"],如果 coded 不是系统认识的证据类型,它可能被当成一个硬性要求,最终导致 Rubric 一直缺证据。
项目中的 _test_phase8.py 会检查课程数据里的证据类型白名单,但这只证明相关测试能够检查当前数据,并不等于生产运行时具备同等强度的校验。
如果希望保证字段合法性,应该在 Rubric 模型上增加运行时校验,例如对 required_evidence 中的每一个元素检查白名单,并为 weight 增加明确的数值约束。这样即使未来修改数据,也不必完全依赖开发者记得运行某个专项测试。
7. 怎样验证 Rubric 规则真的生效了?
验证 Rubric 不能只测单个函数的返回值,还需要确认从课程配置、证据采集到最终判定的完整执行链路。且测试用例本身也会过期,需要跟着实现同步维护。
以下内容基于项目AI Tutor Engine (信科院智能助手 · INFO SYSTEM) 的真实生产代码,仅作为实践参考与分享,本次核查使用的是本地离线测试环境,版本为 Python 3.12.7、Pydantic 2.11.7。
| 测试脚本 | 实际结果 | 核心影响 |
|---|---|---|
| _test_v11_fix.py | 13 项通过 | 覆盖非法 rubric_id、空判定、缺少证据和遗漏 Rubric 等校验 |
| _test_phase8.py | 62 项通过 | 覆盖课程字段合法性检查 |
| _test_p5.py | 全部通过 | Learner State 相关测试 |
| _test_p6.py | 全部通过 | 后续状态相关测试 |
| _test_phase1.py | 3 项断言不符合预期,随后崩溃 | 旧的分数预期和已移除的缓存接口没有同步更新 |
| _test_p4.py | 断言失败:44 与 20 不一致 | 测试中的必做任务数量预期已过期 |
7.1 测试为什么会失败?
_test_phase1.py 失败原因 当前课程数据中,rb_review_4 已经改为 theory 角色,不再进入交付评分的分母。旧测试仍然按照四条 Rubric 全部参与交付评分的逻辑计算分数,因此出现了分值差异。 同时测试末尾还访问了已经移除的 app_mod._REVIEW_CACHE,导致 AttributeError。当前缓存实现已经转为 SQLite 幂等缓存,不再存在这一内存缓存属性。
因此,这些测试失败并不能直接证明生产聚合逻辑本身错误,但说明测试需要同步维护。
_test_p4.py 失败原因 它仍然断言必做任务数量为 20,而当前课程数据中的实际数量是 44。这是课程扩充之后没有同步更新的测试预期。
另外,_test_evidence.py 需要访问 GitHub,因此本次没有在离线环境执行,不能据此声称代码拉取链已经通过完整集成验证。
7.2 后续建议补充的回归测试
- 合法证据类型能够被正确识别,非法类型被拒绝
- 每条 acceptance Rubric 在缺少硬证据时进入预期状态
- theory 和 reflection 不会意外阻断交付
- CI 证据能够正确通过预检并进入直判
- pass_condition 中能够程序化检查的关键要求拥有对应的自动化验证
- 规则、或缓存版本发生变更时,旧评审结果不会被错误复
以上是我的模型建议我优化的地方,也仅作参考,具体开发需要考虑到项目的真实环境和情况,如果有判断为合理的回归测试,可权做查缺补漏,在此提及。
8. 总结
通过这次代码追踪,可以总结出几条值得注意的经验。
第一,证据要求和通过条件必须分开。required_evidence 参与证据预检,而 pass_condition 当前主要依赖 LLM 进行语义判断,两者不能混为一谈。
第二,字段是否生效,要看生产代码是否消费它。字段定义在 Pydantic 模型里、填写在数据中,都不代表它一定影响评审结果。
第三,评价标准的阻断权应当显式建模。交付、理论与复盘不应该在所有场景下使用完全相同的状态和分数计算规则。
第四,字段合法性不能完全依赖人工检查。运行时校验与测试都应该存在,而不是只依赖其中一种。
第五,测试必须跟着实现一起维护。旧断言失效、缓存接口移除后没有更新,都会降低测试对系统行为的保障能力。
Rubric 的价值不只是把需求整理成几个字段。 真正重要的是:每一条验收标准都应该能追溯到明确的输入、实际执行的判断逻辑,以及可以验证的最终结果。