目录
10.2 证据快照:为什么要给 Evidence 做 Hash?
摘要 上一篇文章我们讨论了 Agent 任务验收的核心逻辑:不能让 LLM 仅凭文本回复打分,要基于可核验的交付物证据做判断。但新的问题随之而来:这些证据从哪里来?不同来源的证据可信度一样吗?能不能直接把整个 GitHub 仓库丢给 LLM?本文承接上一篇的四道闸门体系,聚焦 Evidence Collection 证据采集环节的工程实现,讲解如何从 GitHub、CI、Issue、测试报告等多渠道采集证据,为什么要做证据分级,关键文件筛选的取舍逻辑,以及采集器本身可能产生的假证据问题。
文章同样基于 AI Tutor Engine 的真实落地实践(信科院智能助手 · INFO SYSTEM信科院智能助手 · INFO SYSTEM),在此明确当前方案的能力边界:引擎本身不执行被评估项目,运行类结论依赖外部证据。
1. 核心原则:自述描述 ≠ 硬证据
先看一个最基础的场景:任务要求实现一个登录接口,并完成测试,提交者只给出一句说明登录功能已经实现,测试全部通过。
如果评估系统只拿到这段文字,实际上什么都无法确认。我们至少还需要知道:代码在哪里?接口逻辑是否对应需求?测试文件是否存在?测试是否真的执行?CI 有没有通过?有没有实际运行结果?
所以在设计 Evidence Collection 之初,我先定下了一条基础原则:
描述可以作为上下文参考,但不能自动等价于硬证据。
当前系统会把提交者的 description 收集进证据集合,供 Reviewer 理解上下文,但在硬证据预检中会显式排除它。简单说:
- description → 可以看、可以参考
- code / CI / runtime / report → 才可以参与对应的硬证据判断
这一点看起来简单,但如果不在系统层面明确区分,很容易出现 “提交者说完成了 → LLM 觉得描述合理 → 直接 PASS” 的问题,本质上是把自述当成了证据。
2. 证据采集的起点:从 Rubric 定义开始
证据采集不能脱离任务本身凭空采集。任务不是一句标题,而是要落地到具体的 Rubric 验收标准。
例如一个 Rubric 的完整定义:
rubric:
  id: rb_lit01_1
  task_id: lit_t01
  criterion: 脚本能正确统计并输出前 10 名
  required_evidence: [code, runtime]
  pass_condition: 代码中存在读取-计数-排序逻辑;运行输出含至少 10 条「人物 次数」
  weight: 2
  evaluation_role: acceptance
这里包含了两个完全不同的概念,不能混为一谈:
- required_evidence:评估时必须看到哪些类型的证据,是有没有的问题
- pass_condition:满足什么条件才算通过,是够不够的问题
比如 required_evidence = [code, runtime] 只说明必须有代码和运行证据,但没说代码里具体要有什么。具体的验收标准,需要通过 pass_condition 表达。
因此,完整的 Evidence Collection 流程是从 Rubric 开始的,而不是从 GitHub API 开始的——先明确要什么,再去采什么。
3. 为什么不把整个 GitHub 仓库直接丢给 LLM?
拿到 GitHub 仓库地址后,最直接的想法是下载所有代码,全部塞给 LLM 让它自己判断。但工程上这样做并不理想。一个稍具规模的仓库可能包含 .git 目录、依赖包、测试数据、构建产物、锁文件、大量文档和日志,这些内容并不是每次验收都需要。同时,上下文越大,不代表模型看得越仔细,反而可能稀释核心信息。
所以当前实现没有采用全仓库全文送审,而是做了一层关键文件筛选。code_evidence.py 先通过 GitHub Tree API 获取仓库路径,再按优先级选择需要读取的文件。
同时设置了明确的量级限制:
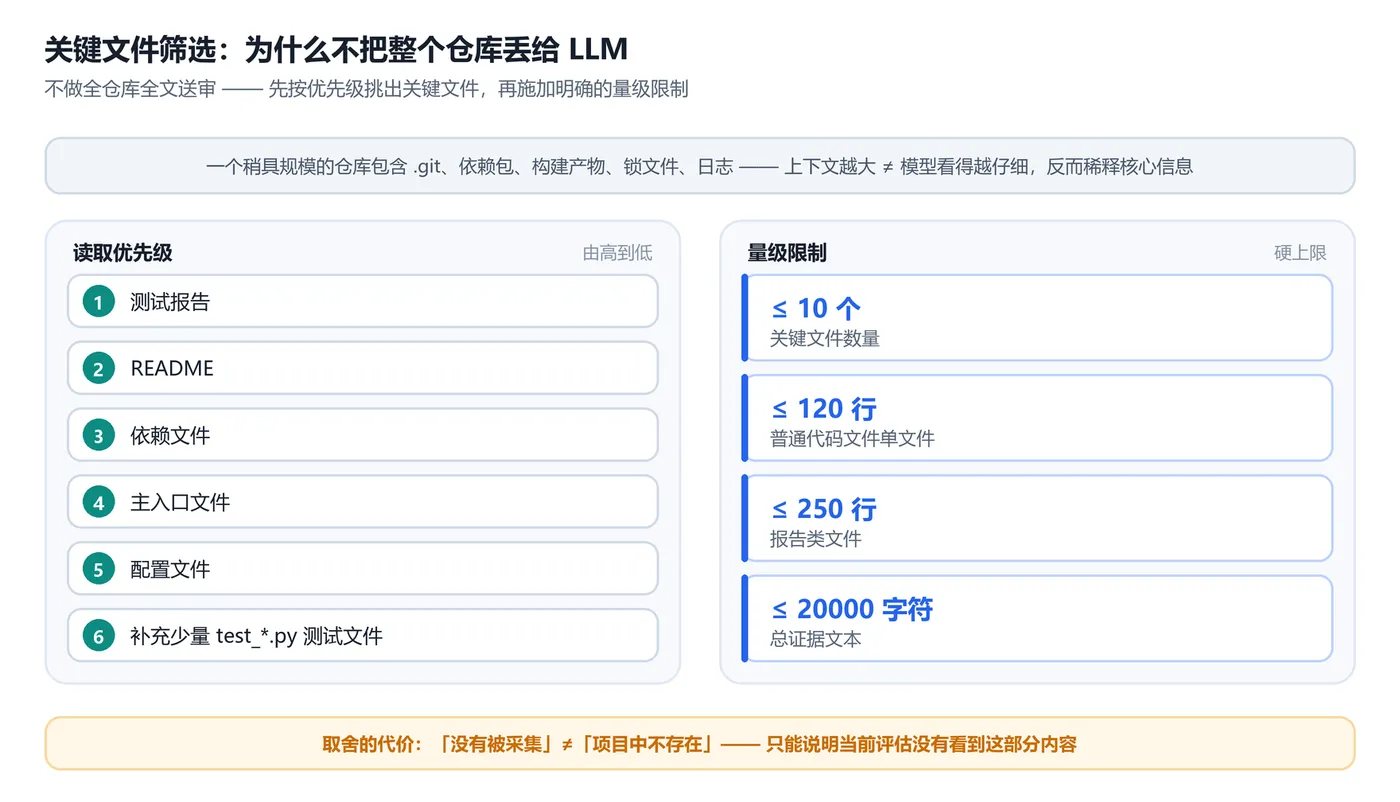
图 1 关键文件筛选:先按优先级挑关键文件,再施加明确的量级限制
这套策略不代表 “前 10 个文件等于整个项目” ,它是一个工程上的取舍:优先让 Reviewer 看到最有可能决定验收结果的核心内容。
4. 证据分级:不同来源的可信度并不相同
证据不能只分有和没有,不同来源的证据,证明力天差地别。
比如提交者说:“我已经测试过了”
和
GitHub Actions 显示 Test → success
显然不能按同一种证据处理。把当前系统中的 7 类证据,按证明力做了明确区分:
| 证据类型 | 主要能证明什么 | 主要不能证明什么 | 证据强度 |
|---|---|---|---|
| CI | 某个自动化检查的执行结论 | 整个项目所有功能都正确 | 强 |
| Code | 代码中存在某种实现逻辑 | 代码一定能成功运行 | 中强 |
| Runtime | 存在实际运行的痕迹与结果 | 所有功能都经过完整验证 | 中 |
| Report | 提交者记录的测试与问题 | 记录的内容一定真实 | 中 |
| Issue | 问题的发现与处理过程 | 问题一定被彻底解决 | 中弱 |
| Deployment | 存在可访问的线上入口 | 所有需求均被满足 | 中弱 |
| Visual | 截图中的可观察事实 | 程序内部逻辑正确 | 弱 |
| Description | 提交者的自述说明 | 自述内容一定真实 | 参考 |
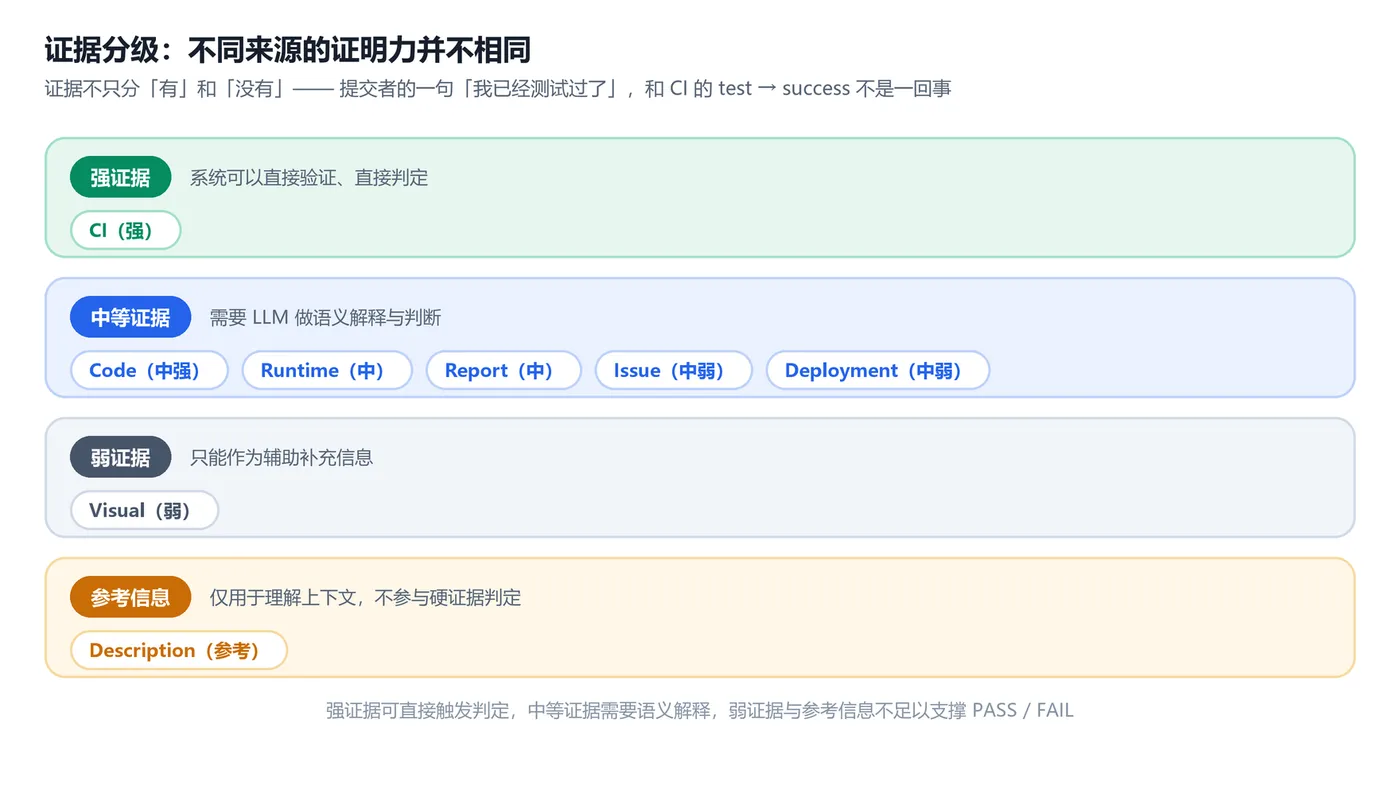
图 2 证据分级:不同来源的证明力并不相同,处理方式也随之不同
对应的处理原则也不同:
- 强证据:系统可以直接验证、直接判定
- 中等证据:需要 LLM 做语义解释与判断
- 弱证据:只能作为辅助补充信息
- 参考信息:仅用于理解上下文,不参与硬证据判定
4.1 测试报告:语义证据,不是系统事实
在所有证据里,测试报告需要特殊对待。README 描述项目怎么运行,代码描述项目怎么实现,而测试报告描述的是项目做过哪些验证。
当前采集逻辑会优先寻找报告类文件,比如 TEST_REPORT.md、test_report.md、bugs.md 等,采集后会专门标记为「测试报告/问题记录」,再提取正文内容。
但这里有一个必须明确的边界:测试报告本身不是绝对可信的!
报告写着 “登录测试:正常” ,只能说明提交者写了一份这样的记录,不能直接证明测试确实执行过。所以报告适合作为语义证据,而不应该自动升级成系统级事实——这也是报告和 CI 在系统里地位不同的核心原因。
4.2 CI 是当前最强的一类证据
如果说代码只能证明这里写了这个逻辑,那么 CI 可以进一步证明某个自动化检查得到了什么结论。
当前系统通过 GitHub Actions 获取 workflow runs,把结果归一化为 name、dimension、conclusion 的统一结构,CI 维度主要对应 build、test、runtime 三类。
在 test → success 这个结论,和提交者说我已经测试过了有本质区别:
前者来自自动化执行的客观结果,后者来自主观自述。
这也是为什么 CI 属于强证据,可以直接触发 PASS / FAIL 判定。
5. Runtime Evidence 的明确边界
这是当前系统最容易被误解的地方。按普遍定性而论,自动验收约等于默认系统会拉取代码、启动项目、自动运行测试、返回结果。
但目前并不是这样。 当前引擎不会执行提交的代码,没有 Docker 沙箱,没有 pytest Runner,没有进程隔离与资源限制,也没有自动启动器。运行类证据目前主要来自三个渠道:
- CI 执行结论
- README 或提交说明中的运行描述
- 部署地址 URL
甚至运行命令的提取,也只是从文本中做关键字匹配。
所以这里必须把两个概念严格分开:
- Execution:实际执行代码
- Execution Evidence:执行产生的证据
当前系统没有自己完成 Execution,但可以收集和验证 Execution Evidence。这也正是上一篇文章中 “代码只能证明‘写了什么” ,不能证明跑没跑通的底层原因。
6. 采集之后:先过证据预检,再交给 LLM
假设最终采集到了 code、ci、runtime、report、issue、description 全套证据,这时候还有一个很容易忽略的步骤:当前任务要求的证据,真的齐了吗?
所以采集完成后,会先经过 Evidence Precheck 证据预检,这部分逻辑我们在上一篇文章中已经详细介绍过,核心就是只做证据完整性检查,不做任何语义评价。
核心逻辑简化为:
needed = set(r.required_evidence) - optional_bonus
missing = needed - present

missing_real = {

    m for m in missing
    if m != "description"
}

if missing_real:
    forced.append({

        "rubric_id": r.id,
        "missing": sorted(missing_real),
        "reason": "缺少必要证据,无法自动判定"
    })
比如要求 code + runtime,实际只有 code,结果直接返回 NEED_REVIEW,不进入 LLM 环节。
6.1为什么缺证据时不应该继续调用 LLM?
因为这时候模型无论怎么判断,都只能靠猜。看到代码写得合理,就很容易说出
“从代码逻辑上看, 应该可以正常运行”
但问题就出在应该。
系统真正需要的是已经证明可以运行,而不是看起来应该可以运行。
所以整个链路的职责划分非常清晰:
- Evidence Precheck → 证据够不够?
- LLM Reviewer → 有了证据,是否满足语义要求?
- Deterministic Aggregation → 最终分数和状态是什么?
这三件事不能混在一起。
7. 采集器本身也会产生“假证据”
这是目前系统里已经发现的一个真实问题,也很有代表性:证据采集本身也可能出错,不能默认采集到的就是真的。
比如 trace 证据目前的判断方式:
if "agent_trace.json" in repo_code_text:
    ev["trace"] = "仓库中包含 agent_trace.json..."
判断看起来很合理,但实际场景中,如果 README 里只是写了一句“本项目未来会生成 agent_trace.json,字符串匹配也会触发这个条件。
于是提到了文件名就被当成了文件存在,这显然是不对的,这说明 Evidence Collection 不能简单等于字符串搜索。更可靠的校验应该是三层:
- 文件是否真实存在
- 文件是否可以正常读取
- 文件内容是否符合预期
这也是当前一个明确的优化点。
8. 描述性文本的定位与潜在风险
这里有一个看起来矛盾的设计,description 会进入证据集合,也会渲染给 Reviewer,但 Evidence Precheck 又明确不把它算作硬证据。
原因很简单:一段自述虽然不能证明这个功能真的完成了,但它可以告诉 Reviewer提交者认为自己做了什么。比如描述里提到 “登录接口使用 JWT,增加了刷新 Token 逻辑” ,这对于理解仓库上下文是有帮助的。
所以当前的策略是:
- description → 可以作为参考上下文
- description → 不能独立作为硬证据
不过这里存在一个结构性风险:它虽然通不过证据预检,但 LLM 仍然看得到它。如果 Rubric 本身没有强硬证据要求,模型理论上可能被一段说服力很强的自述影响。这是当前评估链里一个比较明显的漏洞面。
9. Issue 为什么要纳入证据体系?
项目的代码只能告诉你现在有哪些代码,但 Issue 能提供另外一条时间线:发现问题 → 记录问题 → 尝试修复 → 关闭 Issue。
当前系统会从 GitHub Issues 获取问题记录,过滤掉 Pull Request,同时限制数量和正文长度。这样 Reviewer 看到的就不只是代码快照,还有完整的问题处理过程。
比如:
- Issue #12 登录失败,原因:Token 过期后未刷新
- Issue #15 修复 Token 刷新逻辑
这类证据不能直接说明最终功能一定正确,但对于判断项目有没有真实的开发过程、问题处理过程,会比单纯的代码快照多一层信息。
10. 统一证据字典与证据快照
10.1 多源归一:统一证据字典
不同来源的数据结构都不一样:GitHub API、CI API、Issue API、提交、部署地址、视觉证据。如果让后续逻辑分别处理,很快就会变成一堆特殊判断。
所以当前实现会把所有来源的证据,统一归一化成标准的 Evidence Dictionary:
{

    "code": "...",
    "ci": "...",
    "runtime": "...",
    "report": "...",
    "issue": "...",
    "deployment": "...",
    "visual": "...",
    "description": "..."
}
之后所有评估环节都从这个统一结构读取,采集来源和评估逻辑完全解耦。以后如果增加新的证据来源,比如 MCP、外部测试平台或者其他 CI 系统,只需要扩展采集层,不需要重新设计整个 Reviewer。
完整的采集链路如下:
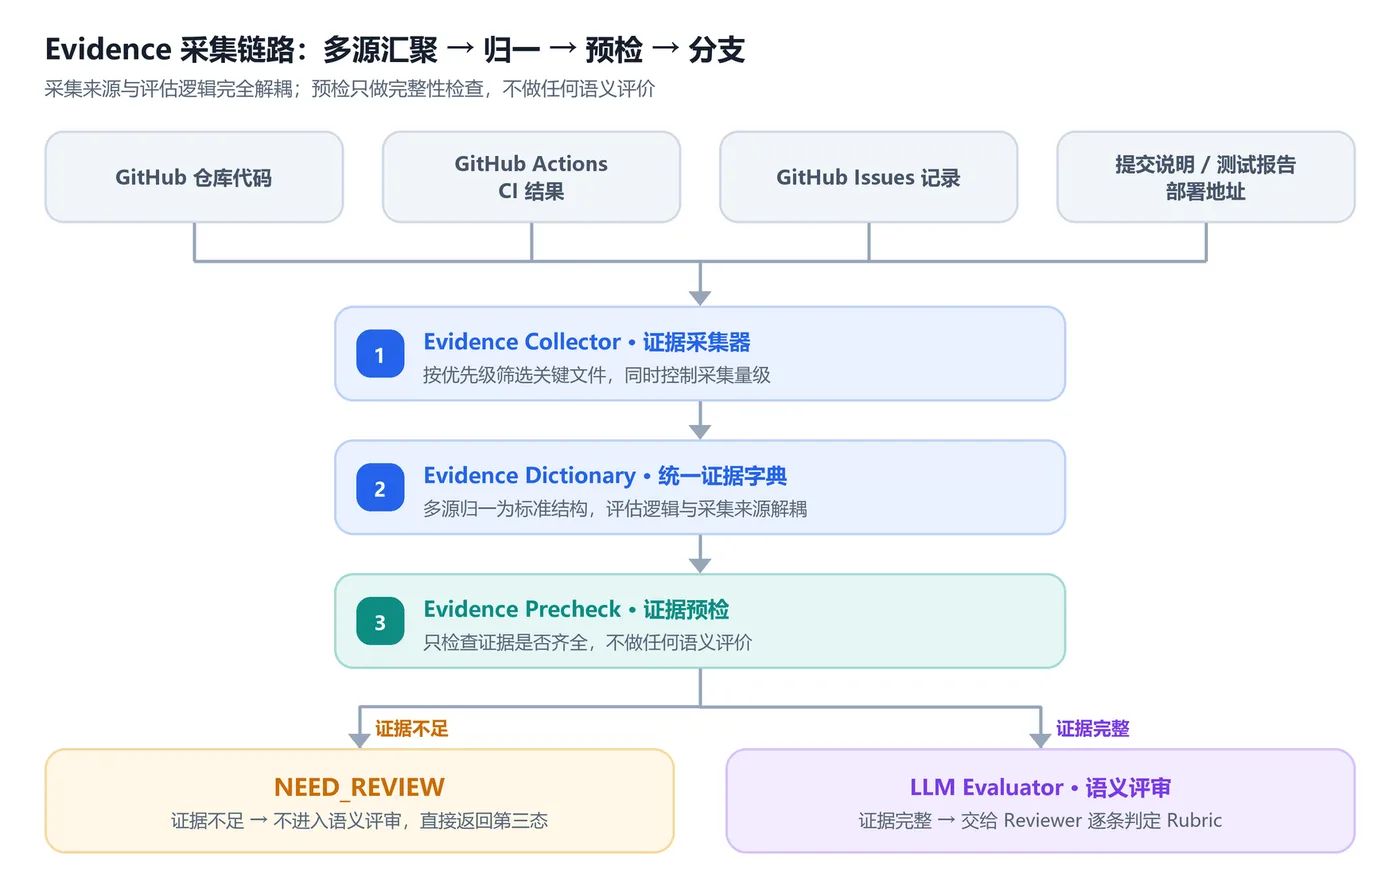
图 3 Evidence 采集链路:多源汇聚 → 归一 → 预检 → 分支
10.2 证据快照:为什么要给 Evidence 做 Hash?
还有一个容易被忽略的问题:如果用户连续提交 5 次同一个任务、同一份代码、同一个 CI、同一份报告,每次都重新调用 LLM,本质上是在重复评估完全相同的信息。
所以当前实现会对 task_id + evidence + ci 做规范化处理,然后计算 SHA-256 生成快照哈希:
canonical = json.dumps({

    "task_id": task_id,
    "evidence": dict(sorted(available.items())),
    "ci": sorted(...)
}, ensure_ascii=False, sort_keys=True)

snapshot_hash = hashlib.sha256(
    canonical.encode("utf-8")
).hexdigest()[:16]
再结合 rubric_version、prompt_version、engine_version、model 一起组成缓存键。
这样做的核心是:同一份 Evidence Snapshot 复用评审结果,而不是同一次请求复用结果。前者围绕系统看到了什么做缓存,后者围绕用户什么时候点击按钮做缓存,两者区别很大。
11. 当前方案的边界与局限
把整个实现跑通以后,也能清晰看到它的能力边界,这里主动列出来:
- 引擎没有真正执行项目 这是最大的限制。如果没有 CI 或外部运行环境提供证据,代码本身无法证明运行成功。
- 关键文件筛选存在信息损失 当前并不是把整个仓库交给 Reviewer。“没有被采集”不等于“项目中不存在”,只能说明当前评估没有看到这部分内容。
- 部分证据存在性检查不够严格 比如字符串匹配判断文件存在的方式,存在“声明即证据”的问题,后续需要优化为真实文件校验。
- 自述仍然可能影响 LLM 虽然 description 不能通过硬证据预检,但 Reviewer 仍然可以看到它,存在主观影响的可能性。
12. 落地:AI Tutor Engine 中的证据体系
前面的所有讨论,都来自我正在开发的 AI Tutor Engine 系统(信科院智能助手 · INFO SYSTEM)的真实实现,这是面向编程类项目制学习场景的系统。
在这个系统里,用户使用 AI 编程工具完成项目,再提交到 GitHub。评估系统不会只读取一句“我已经完成了”,而是尝试采集多维度的证据:
- GitHub 仓库:代码、README、测试文件
- CI 执行结果
- Issue 记录
- 测试报告
- 运行证据、部署地址、视觉证据
然后统一转成标准 Evidence 结构,再进入完整的评审链路:证据预检 → CI 直接判定 → LLM 语义评审 → 确定性聚合。
这套设计的出发点其实不是“让 AI 看更多东西”,恰恰相反:让 AI 只看那些与当前任务验收真正相关、并且能够被解释的东西。
13. 总结
把文章压缩成一句话,这样描述 Evidence Collection:
不是
“把更多数据丢给 LLM”
而是
“把与任务相关、来源明确、作用边界清楚的证据组织给 LLM” 。
整个完整工作流可以归纳为:
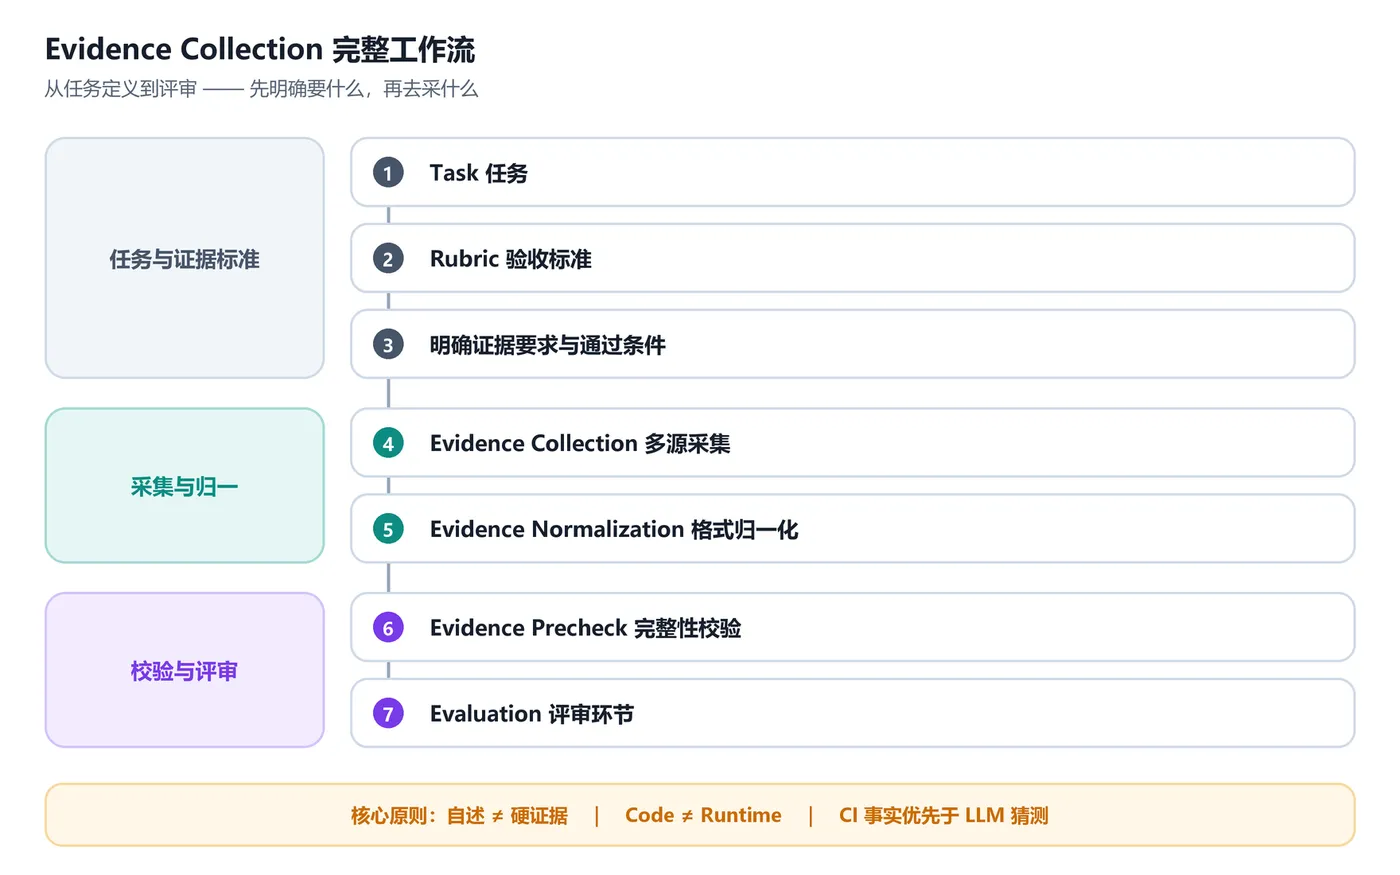
图 5 Evidence Collection 完整工作流:从任务定义到评审
其中最重要的几个原则是:
- 自述 ≠ 硬证据
- Code ≠ Runtime
- CI 事实优先于 LLM 猜测
- 证据不只是“存在/不存在”,还有可信度分级
- 采集器本身也需要防止误判
- 证据不足时,不应该逼 LLM 做二选一
当前这套实现仍然存在不少问题,比如运行环境沙箱、静态分析、证据真实性校验、关键文件筛选粒度、缓存策略优化等。但至少到这里,Agent 的验收过程已经从“LLM,你觉得这个项目做完了吗?”,进化成了更工程化的问题链:任务要求什么? 我拿到了什么证据? 这些证据分别能证明什么? 还缺什么? 哪些地方可以直接判断? 哪些地方才需要 LLM?
而这也是 Evidence Collection 在 Agent Evaluation 里真正应该解决的问题。