摘要 传统 LLM 评估主要关注模型输出本身,判断回答是否正确、相关、遵循指令。但当模型演进为 Agent,任务往往不再以“一段文本”结束,而是会产出代码、文件、测试结果、部署状态等实际交付物。此时若再让 LLM 直接给出“任务完成度分数”,会面临一个核心问题:
模型说自己完成了,不等于任务真的完成了
本文从这个问题出发,将 Agent 任务验收拆解为 Evidence → Verification → Evaluation → Acceptance 四个阶段,介绍一种“确定性规则 + LLM 语义判断”的工程实现方案,同时分享这套方案在 AI Tutor Engine 中的落地实践与当前的能力边界。
1. Agent 的“回答正确”和“任务完成”不是一回事
我们先看一个最简单的例子:给 Coding Agent 下达任务“实现用户登录功能,并补充测试”,Agent 最后返回一句“功能已经完成,测试通过”。
如果把这段回答交给另一个 LLM 直接评分,很容易得到“完成度 90%”的结论。但我们真正需要验证的其实是:
- 代码是否真实存在?
- 登录逻辑是否按需求实现?
- 测试用例是否真的执行?
- CI 流水线是否通过?
- 运行结果是否符合预期?
问题的本质发生了变化: 原来的问题是
“这段回答写得怎么样?”
现在的问题是
“这个任务到底有没有完成?”
这两个问题不应该使用完全相同的评估方式。
2. 从 Response Evaluation 到 Deliverable Evaluation
传统 LLM 应用的结构比较简单,评价对象就是最终输出的文本:
评价维度通常包括:内容是否正确、是否符合上下文、是否遵循指令、是否出现违规内容等。
而 Agent 的执行链路要复杂得多,最终留下的也不只是一段话:
最终产出可能是代码、文件、数据库记录、Git Commit、CI 结果、部署服务、测试报告、Issue 等真实产物。
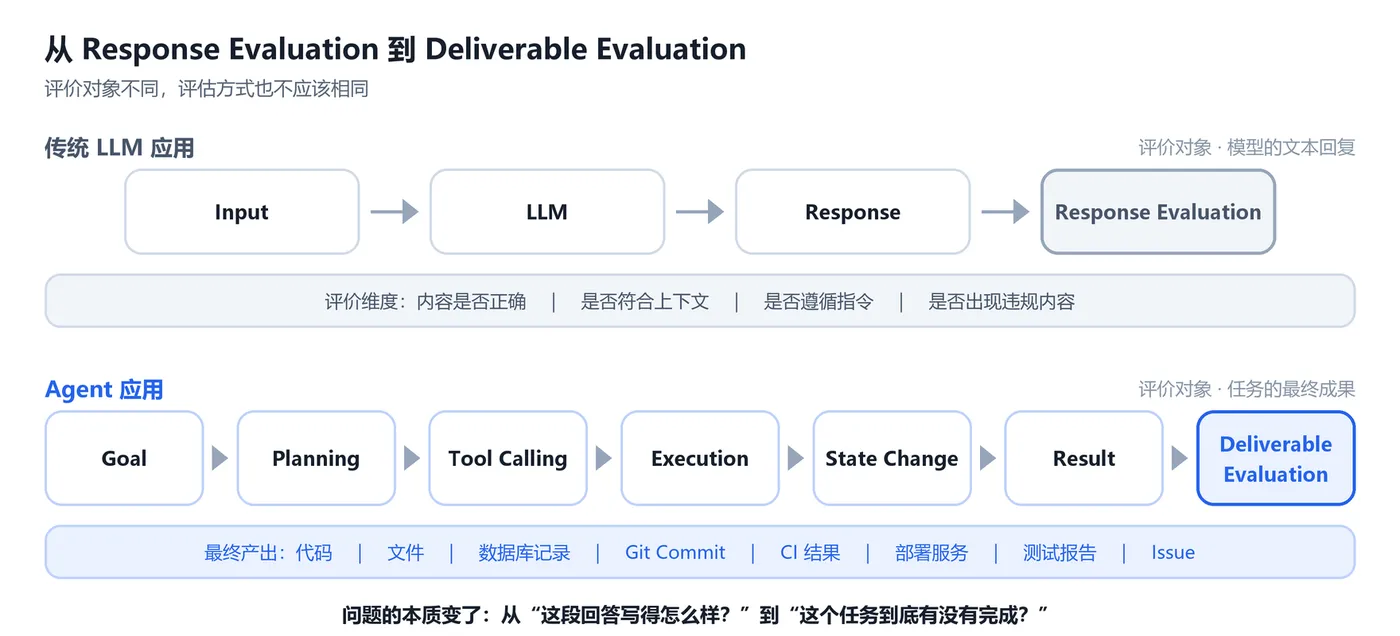
评价对象不同,评估方式也不应该相同:前者评文本,后者评交付物
因此可以把两类评价明确区分开:
| 项目 | Response Evaluation | Deliverable Evaluation |
|---|---|---|
| 评价对象 | 模型的文本回复 | 任务的最终成果 |
| 核心问题 | 说得对不对 | 事情做没做成 |
| 主要证据 | Response 文本 | Code / CI / Runtime / Report 等 |
| 常见场景 | Chatbot、知识问答 | Coding Agent、自动化 Agent |
注:本文中的 Deliverable Evaluation 是为描述这类问题提出的称呼,并非标准化行业术语。真正值得讨论的核心是:当 Agent 开始产生真实交付物以后,评价对象也应该从 Response 向 Deliverable 迁移。
3. 不要一上来就让 LLM 打总分
最直接的验收实现,是把任务直接丢给 LLM,让它输出 PASS / FAIL 或者分数。但这个方案里,模型同时承担了三件事:判断每条标准 + 计算总分 + 决定最终状态。其中至少有两件事,本来就没必要交给模型。
假设一个任务有 5 条权重相同的验收标准,模型判断结果是
A PASS
B PASS
C FAIL
D PASS
E PASS
那么总分就是 4 / 5 × 100 = 80。这一步计算交给Python,比交给 LLM 更稳定、更可复现。
所以在实现里,LLM 的输出契约只有逐条判定,不包含总分:
{

  "criteria": [
    {

      "rubric_id": "rb_xxx",
      "status": "PASS",
      "evidence": "依据的证据",
      "reason": "判定理由"
    }
  ],
  "next_step": "下一步需要补充什么"
}
这里故意没有 score。
最终分数和状态全部由代码计算:
score = round(passed / total * 100) if total > 0 else 0

if has_fail:
    status = ReviewStatus.FAIL
elif has_need_review:
    status = ReviewStatus.NEED_REVIEW
else:
    status = ReviewStatus.PASS
这个设计的核心不是“让模型少做事”,而是把模型无法稳定保证的部分,尽量从模型手里拿回来。
4. 评估之前,先解决一个更基本的问题:证据够不够
假设某条标准要求必须有 code 和 runtime 两类证据,但实际提交的只有一句“功能已经实现,运行正常”。如果只有 PASS / FAIL 两种状态,评估器就只能靠猜。这也是我不喜欢二值验收的原因。
在当前实现里,我增加了第三种状态:
class ReviewStatus(str, Enum):
    PASS = "PASS"
    FAIL = "FAIL"
    NEED_REVIEW = "NEED_REVIEW"
它解决的是证据不足的场景:
- 证据完整 → 给出 PASS / FAIL
- 证据不足 → 返回 NEED_REVIEW
例如:
NEED_REVIEW 缺少必要证据:code、runtime 请补充证据后重新提交。
NEED_REVIEW 不是模糊的“待定”,它明确表达:现有信息不足以负责任地给出 PASS 或 FAIL 结论。对于自动验收系统来说,这是非常必要的中间状态。
5. 当前实现:四道闸门评审流程
实际落地中,我把整个评审流程拆成了四层闸门
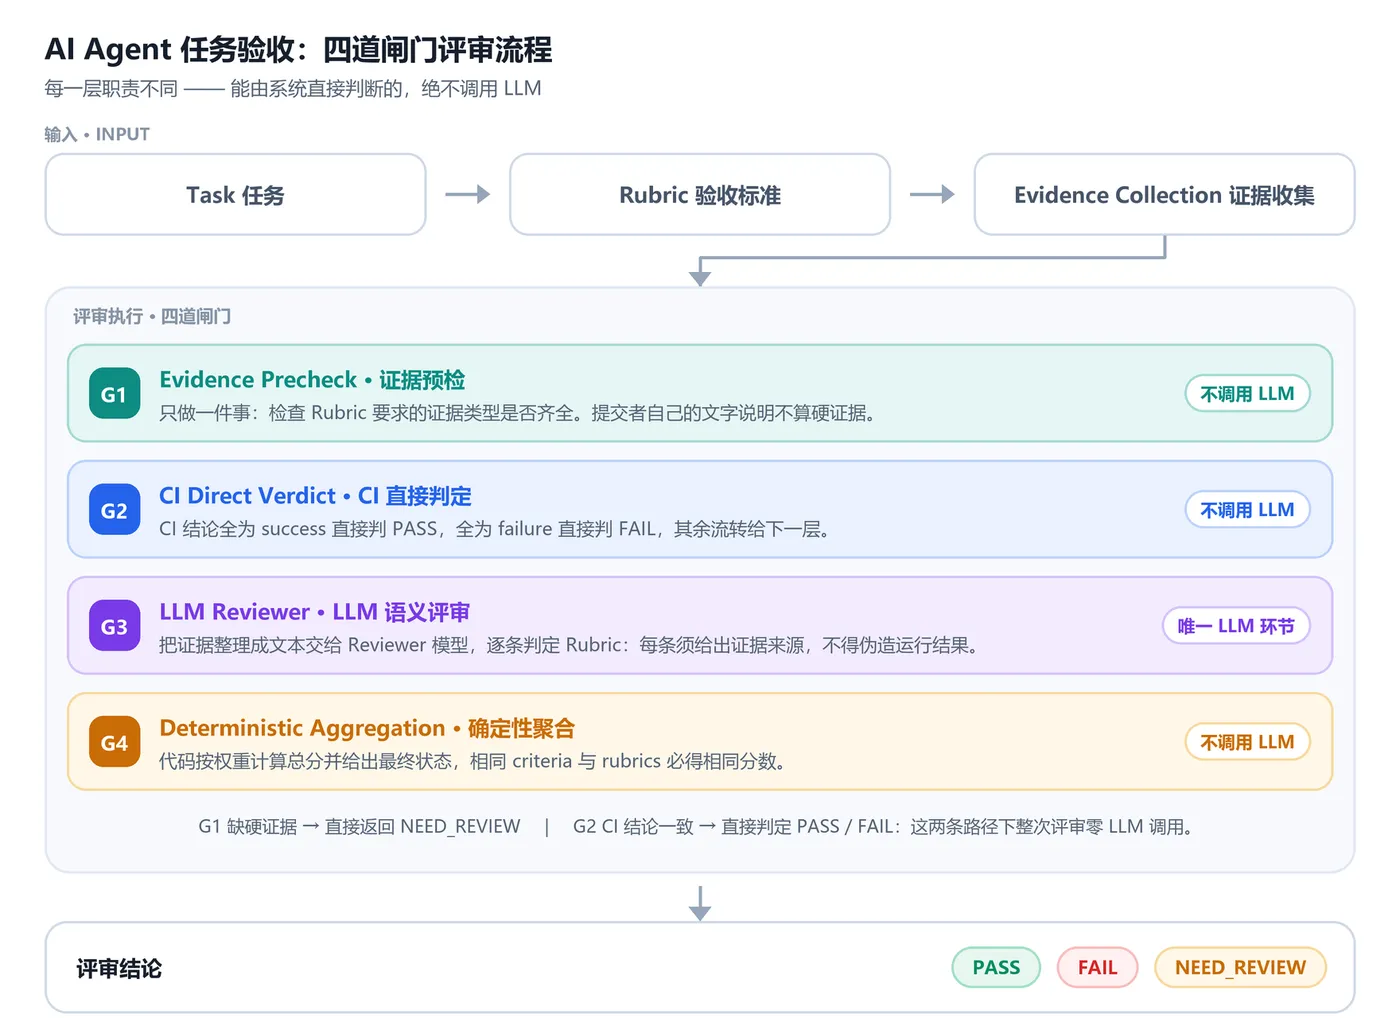
四道闸门评审流程:G1、G2、G4 均为纯规则判定,只有 G3 调用 LLM
5.1 Gate 1:Evidence Precheck(证据预检)
第一层完全不调用 LLM,只做一件事:检查 Rubric 要求的证据类型是否齐全。
核心逻辑可以简化为:
needed = set(r.required_evidence) - optional_bonus
missing = needed - present

missing_real = {

    m for m in missing
    if m != "description"
}

if missing_real:
    forced.append({

        "rubric_id": r.id,
        "missing": sorted(missing_real),
        "reason": "缺少必要证据,无法自动判定"
    })
这里有一个关键细节:任务提交者自己的文字说明(description)不算硬证据。一句“我已经完成了”,不能替代代码、CI、运行结果、测试报告。
这一步的好处很直接:明显缺证据的任务,直接拦截,不需要浪费一次 LLM 调用。
5.2 Gate 2:CI Direct Verdict(CI 直接判定)
有些结果本身就是确定性事实,不需要再交给 LLM 重复判断。
例如一个 Rubric 只要求测试结果,而 GitHub Actions 返回所有 workflow 全部 success,那就可以直接判定通过;全部 failure 就直接判定失败。
当前实现的规则很保守:
if conclusions == {
   "success"}:
    return {

        "status": ReviewStatus.PASS,
        "evidence": "CI 自动验收证据"
    }

if conclusions == {
   "failure"}:
    return {

        "status": ReviewStatus.FAIL
    }

return None
- 全部 success → PASS
- 全部 failure → FAIL
- 混合结果 / cancelled / timeout 等 → 不直判,流转给 LLM
核心原则就是:确定性证据优先于模型判断。有些场景下,整次评审甚至可以零 LLM 调用——比如全部缺必要证据直接返回 NEED_REVIEW,或者全部 Rubric 都能由 CI 直接判定。
6. LLM 真正需要处理的,只是语义判断
通过前两道闸门之后,剩下的才是 LLM 擅长的问题:代码内容是否真的对应需求?
这一层会把所有收集到的证据整理成文本,交给 Reviewer 模型:代码、README、CI 结果、报告、Issue、描述说明等,然后逐条判断 Rubric 是否通过。
但模型的权限仍然受到严格限制,Prompt 里有几条硬约束:
- 每条 Rubric 都必须检查,不能遗漏
- 每条判定都必须给出对应的证据来源
- 没有运行证据时,不能因为代码看起来合理就判断“运行成功”
- 不得伪造运行结果
- 只做客观评价,不负责修改代码
这里有一个非常关键的区别: LLM 可以说“这段代码看起来应该能运行”,但系统会追问“你有运行证据吗?” 没有运行证据,就不能把“看起来可以”直接当作“已经运行成功”。
7. 一个明确的边界:代码只能证明“写了什么”
这件事很容易被高估。比如仓库里存在 def login(username, password): ... 这样的代码,只能证明“项目中确实实现了登录逻辑”,但不能仅凭代码得出“用户真的可以登录”的结论。
实际运行还会受到很多因素影响:依赖版本、环境变量、数据库连接、网络权限、配置文件、部署环境等等。
所以我把这条边界直接写进了评审规则:
代码证据只能证明“写了什么”,不能证明“跑没跑通”。
目前运行类判断主要依赖三类证据:CI 执行结论、运行说明文档、可访问的部署地址。
这里也必须明确一个实现限制:当前引擎本身不执行用户代码,没有内置沙箱,没有测试运行器,也不会直接启动仓库中的程序。
换句话说,这套系统做的是外部执行 + 内部取证 + 自动评估,而不是“引擎自己执行代码再自动验收”。这也是当前最大的技术边界之一。
8. 为什么总分一定放在代码里算?
LLM 完成逐条判定后,会得到类似
A PASS
B PASS
C FAIL
D PASS
E PASS
的结果,然后交给代码做确定性聚合。
这样做主要解决两个问题: 第一,总分不会被语言风格影响。“这个项目基本完成了”和“这个项目已经很好地完成了”,不会改变权重计算的结果。 第二,验收结果可以复现。相同的 criteria 和 rubrics,经过同样的聚合逻辑,得到的分数一定是一样的。
简单说:LLM 负责“这一条过不过?”,代码负责“最后是多少分?”,职责边界非常清晰。
8.1Rubric 不能全部算作同一种标准
在实际的验收场景里,还有一个很重要的设计:并不是所有评价项都有“阻断项目”的资格。
我把 Rubric 按角色分成了三类:
- acceptance:准入项,有阻断权,直接决定交付是否通过
- theory:理论项,用于产生 learning gap,不直接导致项目失败
- reflection:复盘项,用于生成复盘信息,不参与项目状态判定
也就是说,答错 ≠ 项目交付失败。
和“所有题目算进一个总分”的简单模式相比,这种设计能更准确地表达真实业务规则。核心不是三个分类的名字,而是“这条评价标准有没有阻断权”这个字段——如果答案不同,就应该在数据模型中明确表达,而不是全部藏进一个总分公式里。
9. 真正容易出问题的地方,不在主流程
主流程其实并不复杂,实际开发里更费时间的是各种边界异常。
9.1 模型输出截断
之前遇到过一种情况:LLM 输出到一半就结束了,JSON 结构不完整,导致 json.loads 失败,接口直接 500。
后来增加了对 finish_reason = length 的判断,遇到输出截断时,第二次请求会提高输出上限,避免把残缺 JSON 直接往后传。
9.2 JSON 合法,不代表语义合法
比如模型返回的 JSON 结构完全正确,但里面的 rubric_id 根本不属于当前任务。这种问题 Pydantic 的结构校验是检查不出来的。
所以现在除了结构校验,还增加了语义校验:
- rubric_id 必须属于当前送审集合
- evidence 字段不能为空
- reason 字段不能为空
- 所有送审 Rubric 必须逐条覆盖
结构正确,不等于结果正确,这个坑非常典型。
9.3 “出现文件名”不等于“真的有这个文件”
目前证据检查有一个已知的漏洞:通过字符串匹配判断文件是否存在。
if "agent_trace.json" in repo_code_text:
    ev["trace"] = "仓库中包含 agent_trace.json..."
如果 README 里只是写了一句“项目未来会生成 agent_trace.json”,字符串匹配也会认为 trace 证据存在。“出现了文件名”和“真的存在这个文件”显然不是一回事。
后续这里需要改成真正的文件存在性校验、内容可读性校验,而不是简单的字符串匹配。这是一个明确的优化点。
10. 缓存为什么要围绕“证据快照”做?
如果用户连续点 5 次“提交验收”,而代码和证据完全没有变化,没有必要调用 5 次 LLM。
所以当前的缓存不是按请求时间、会话 ID 来做,而是对当前证据做快照,基于快照生成哈希作为缓存键的一部分。
大概逻辑是:
canonical = json.dumps({

    "task_id": task_id,
    "evidence": dict(sorted(available.items())),
    "ci": sorted(...)
}, ensure_ascii=False, sort_keys=True)

snapshot_hash = hashlib.sha256(
    canonical.encode("utf-8")
).hexdigest()[:16]
最终的缓存键由这些字段组成:task_id + snapshot_hash + rubric_version + prompt_version + engine_version + model。这样相同的证据快照,不会重复消耗模型额度。
不过这里也存在一个明确的取舍:当前 head_sha 不直接参与缓存键。 好处是,同一份有效证据不会因为 Commit 标识变化就重新评审;坏处是,如果新的 Commit 只修改了当前证据采集范围之外的内容,可能会命中旧的评审结果。
这是缓存效率和版本敏感性之间的权衡,没有脱离业务场景的“绝对正确答案”,最终需要根据证据采集粒度持续调整。
11. 目前这套方案没有做到什么?
我认为,技术文章里主动说清楚自己的边界,比吹完美方案更有价值。当前这套系统还不具备这些能力:
- 沙箱执行代码
- 自动运行 pytest 等测试
- AST 静态分析
- Lint / 类型检查
- 多 Agent 协作验收
- 自动修复代码
- 正式的评估准确率数据
- 大规模人工评分一致性实验
也没有足够的数据支持 “准确率 95%” “F1 = 0.9” “与人工评分高度一致” 这类结论。
目前比较严谨的表述只能是:这套实现把一部分可以确定的问题交给代码处理,把需要语义理解的问题交给 LLM,并把证据不足的场景单独定义为 NEED_REVIEW。而不能说“这套方案已经证明比人工评价更准确”——目前还没有这样的实验。
关于设计取舍的补充说明 没有做上述能力,并非技术上不可行,而是基于当前项目的定位与成本考量:
- 这套系统的核心定位是验收评估器,而非执行引擎。沙箱运行、自动测试属于执行态能力,纳入核心链路会模糊职责边界。
- 静态分析、代码修复等增强能力,更适合以 MCP 协议或插件的形式扩展,不堆叠到核心验收流程中,避免核心逻辑过重。
- 大规模人工标注与准确率验证需要极高的时间与经济成本,在项目早期阶段优先验证核心流程的可行性,后续逐步补充基准数据。
- 全链路 LLM 调用的 Token 成本也是重要考量,过度堆叠能力会带来不必要的资源消耗。
用更通俗易懂的语言表示就是:多余
12. 这套设计落地在 AI Tutor Engine
前面讨论的是通用的 Agent 任务验收问题,而这套系统最终落地到了我正在开发的项目:AI Tutor Engine(信科院智能助手),一个面向编程类项目制学习的系统。
这个系统的工作流不是“学生问问题 → AI 给答案”,而是完整的项目式学习闭环:
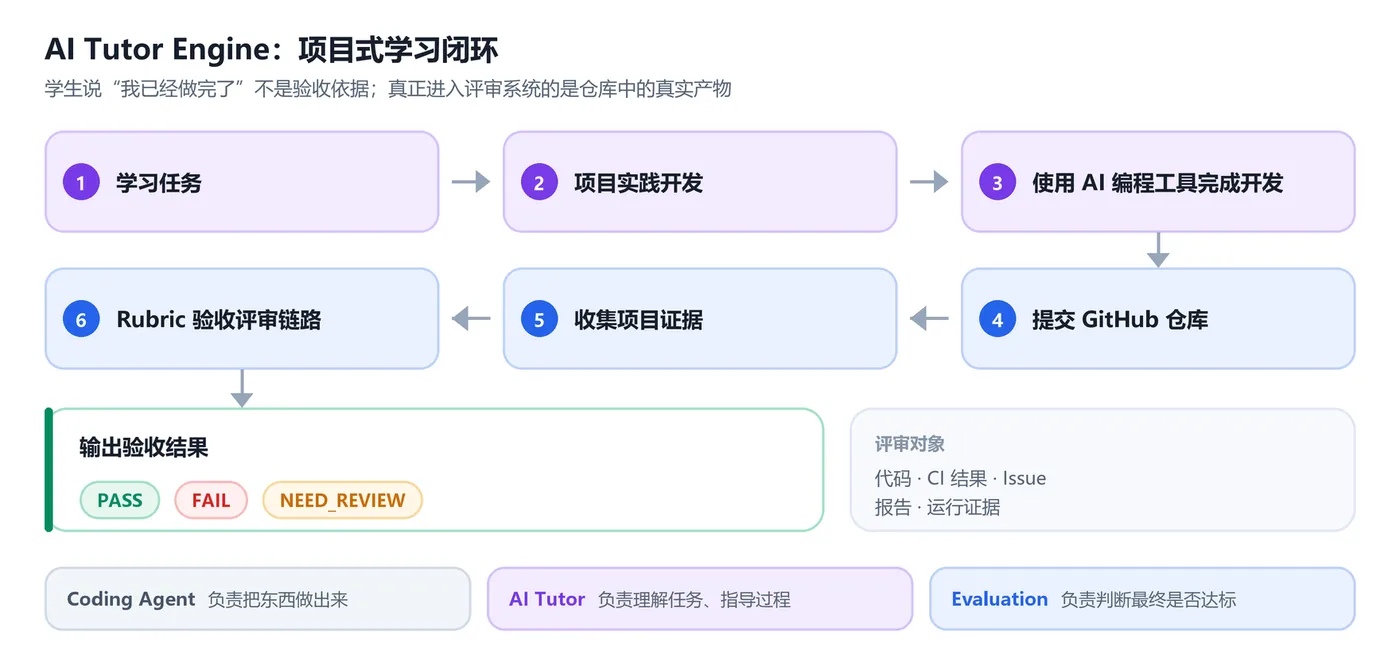
项目式学习闭环:真正进入评审系统的是仓库中的代码、CI 结果、Issue 与运行证据
在这个系统里,学生说“我已经做完了”并不是验收依据,真正进入评审系统的是 GitHub 仓库中的代码、CI 结果、Issue、报告、运行证据等真实产物。
这也解释了为什么这个系统没有往“让 Tutor 自己写代码”的方向发展。它和 Coding Agent 的职责并不相同:
- Coding Agent:负责把东西做出来
- AI Tutor:负责理解任务、指导过程
- Evaluation:负责判断最终是否达标
三个角色可以协作,但没有必要全部塞进同一个 Agent 里。
13. 最后总结
现在回头看,整个问题其实可以压缩成一句话:
不要问 LLM“你觉得这个任务完成了吗”,先问系统“我有什么证据可以证明它完成了”。
整个验收链路可以归纳为:
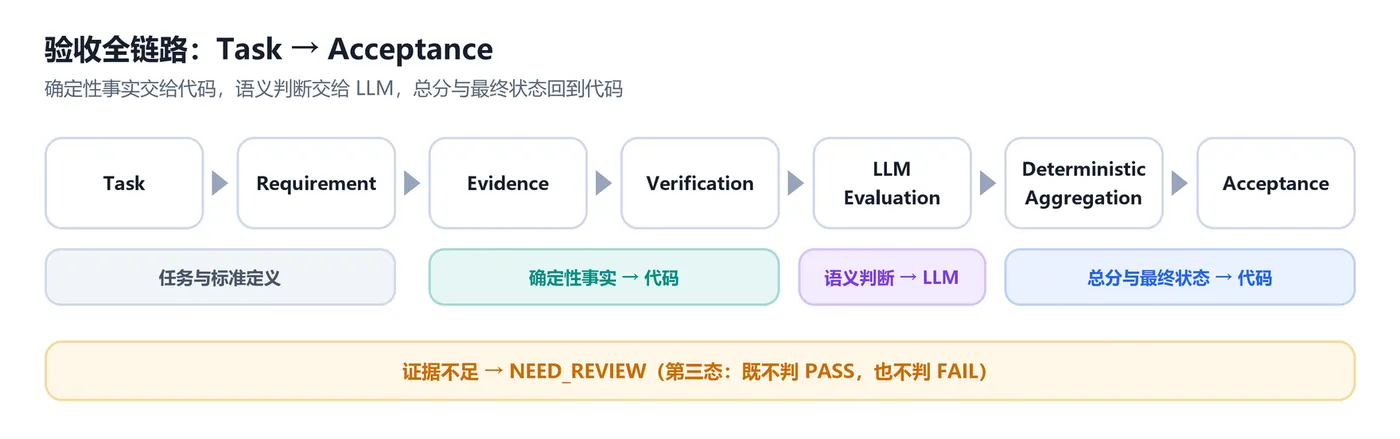
验收全链路与职责分工:确定性事实交给代码,语义判断交给 LLM,总分与最终状态回到代码
对应的职责划分也很明确:
- 确定性事实 → 代码处理
- 语义判断 → LLM 处理
- 总分和最终状态 → 代码处理
- 证据不足 → NEED_REVIEW
目前这套方案还有很多可以持续优化的地方,比如运行环境、静态分析、证据真实性、缓存粒度、评估基准、人工对照实验等等。我不会把它称为一个已经解决了 Agent Evaluation 的方案,它更像是一次具体的工程尝试:
当 Agent 的输出不再只是文字,而是一个需要交付的结果时,评价系统也应该围绕“证据”重新设计。