
一个人、零预算,我们把公司知识库做成了会引用来源的问答系统
从「AI 能不能做」到「能不能上线」,隔着十几个决定。
我给一家做护肤品的公司做了个RAG知识库骨架。需求很朴素:把产品资料、渠道政策、培训话术收进一个能问的东西,给业务同事用。听着是「接个大模型就行」,动手才发现卡住项目的从来不是模型。
先把话说在前面:现在这套东西是一台电脑上能跑起来的骨架,不是上线状态的服务。电脑一关就没人能访问,也没有备份。它的作用是把路走通、把坑标出来。这套骨架暂时不开源:里面挂着真实业务资料、权限规则和合规口径。
01 先别选技术,先攒四样东西
第一个决定是不写代码,先攒一份考卷:把同事真会问的三五十个问题列出来,每题写上正确答案、答案出自哪份文件第几页。有了它,改完跑一遍才知道是变好还是变坏;没有它,只能凭感觉说「好像变好了」。
另外三样同样便宜:资料做减法(先只放二三十篇有代表性的);第一天就给每份资料贴标签——哪个版本、什么时候生效、归哪个部门、能给谁看。标签不埋进去,将来开放给员工时得推倒重来;以及提前定好「查不到时怎么回答」。
考卷里要故意放几道「库里根本没有答案」的题——那才最容易出事故。
02 技术上做了什么,三个比喻
第一步是把资料撕成卡片。不按字数硬切,按章节切:一本员工手册变成一叠小卡片,每张顶部写着属于哪一章。关键是——价格表不能撕成半截。几十行的表被切成两半,剩下那半截只有「1000 以上 900」,谁也看不出是哪个版本。
第二步是两个人同时翻卡片。一个认字:问型号编码、条款号,他找得最准;一个懂事:问「多少钱」「年费怎么算」「价格」,他知道是同一回事。问「某版本 1000 席以上一年多少钱」,认字的把那张价格表排第一,懂事的排第四——语义相近的其他报价卡片更多。两个名字都出现过的卡片才浮到最前面,最后再让一个模型把候选逐条打分,挑出前几段。这就是「关键词那一路」不能省的原因。
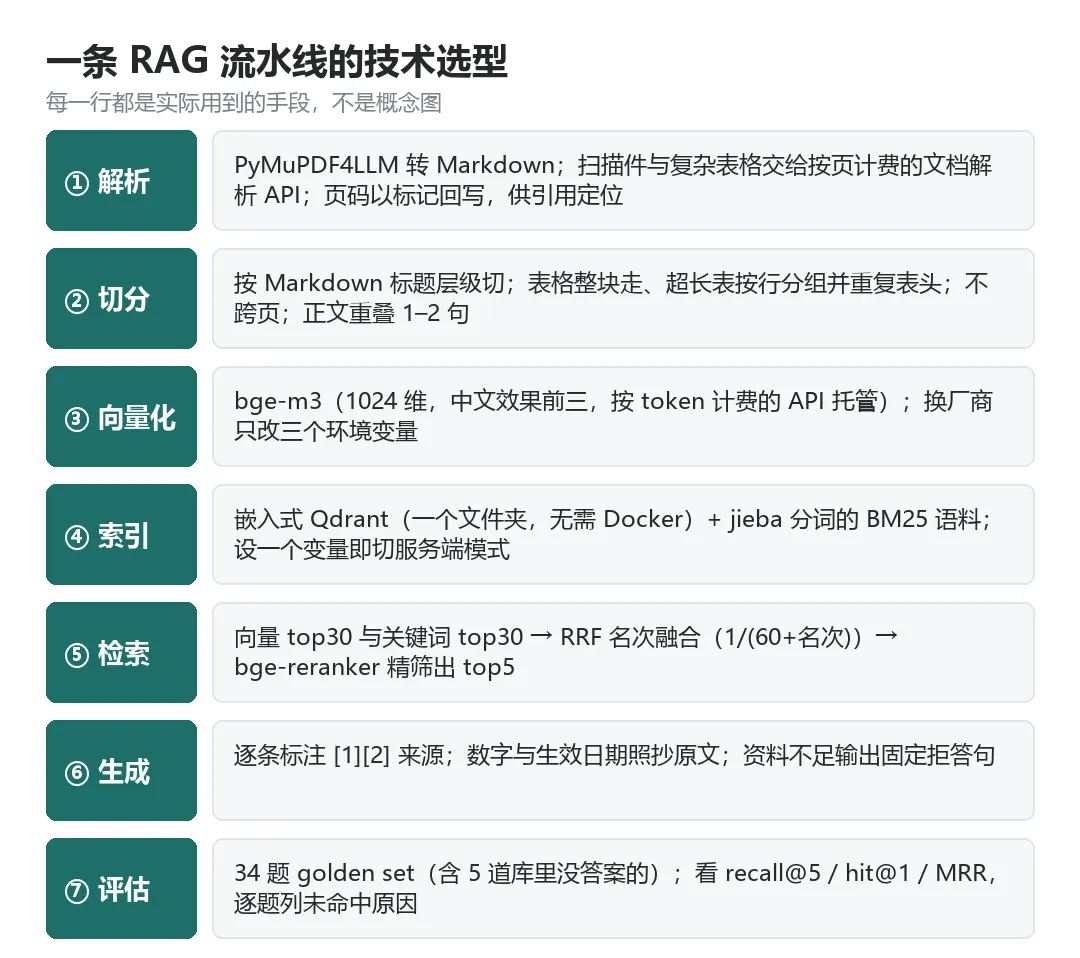
图 1 · 落到工程上是这样
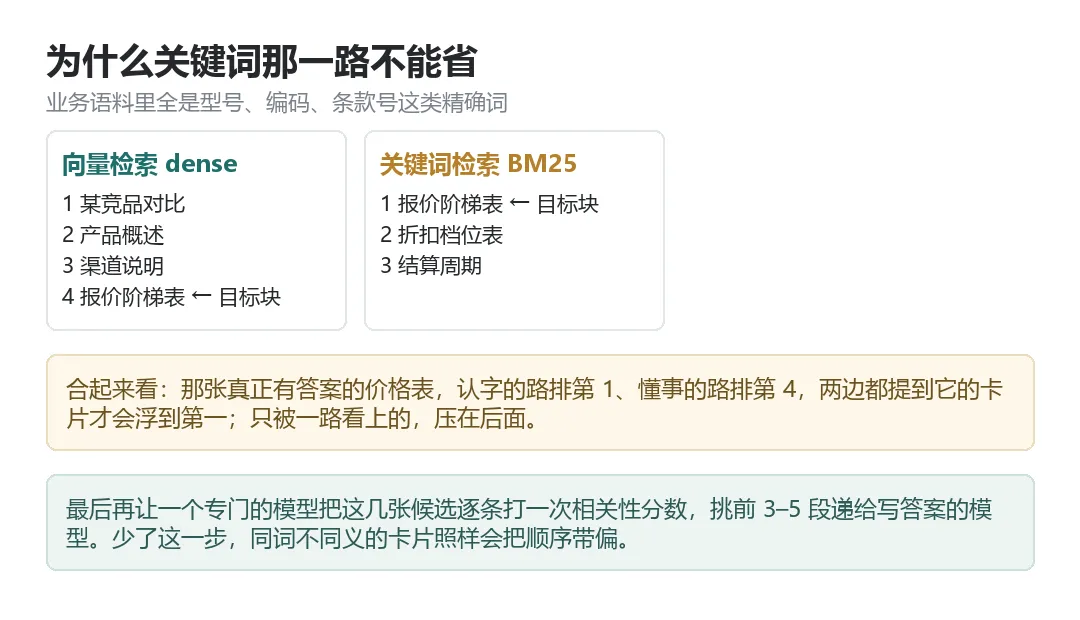
图 2 · 用刚才那道题举例
第三步是只准照着卡片回答。递给模型的就那几段资料,每条结论标是第几张卡片给的,数字和日期照抄不许换算;卡片里没有,就回答「资料里没有」,不许它用自己的记忆补。整条链路是自己写的几百行 Python,没上重型框架——出了问题要能一眼看出是哪一环。
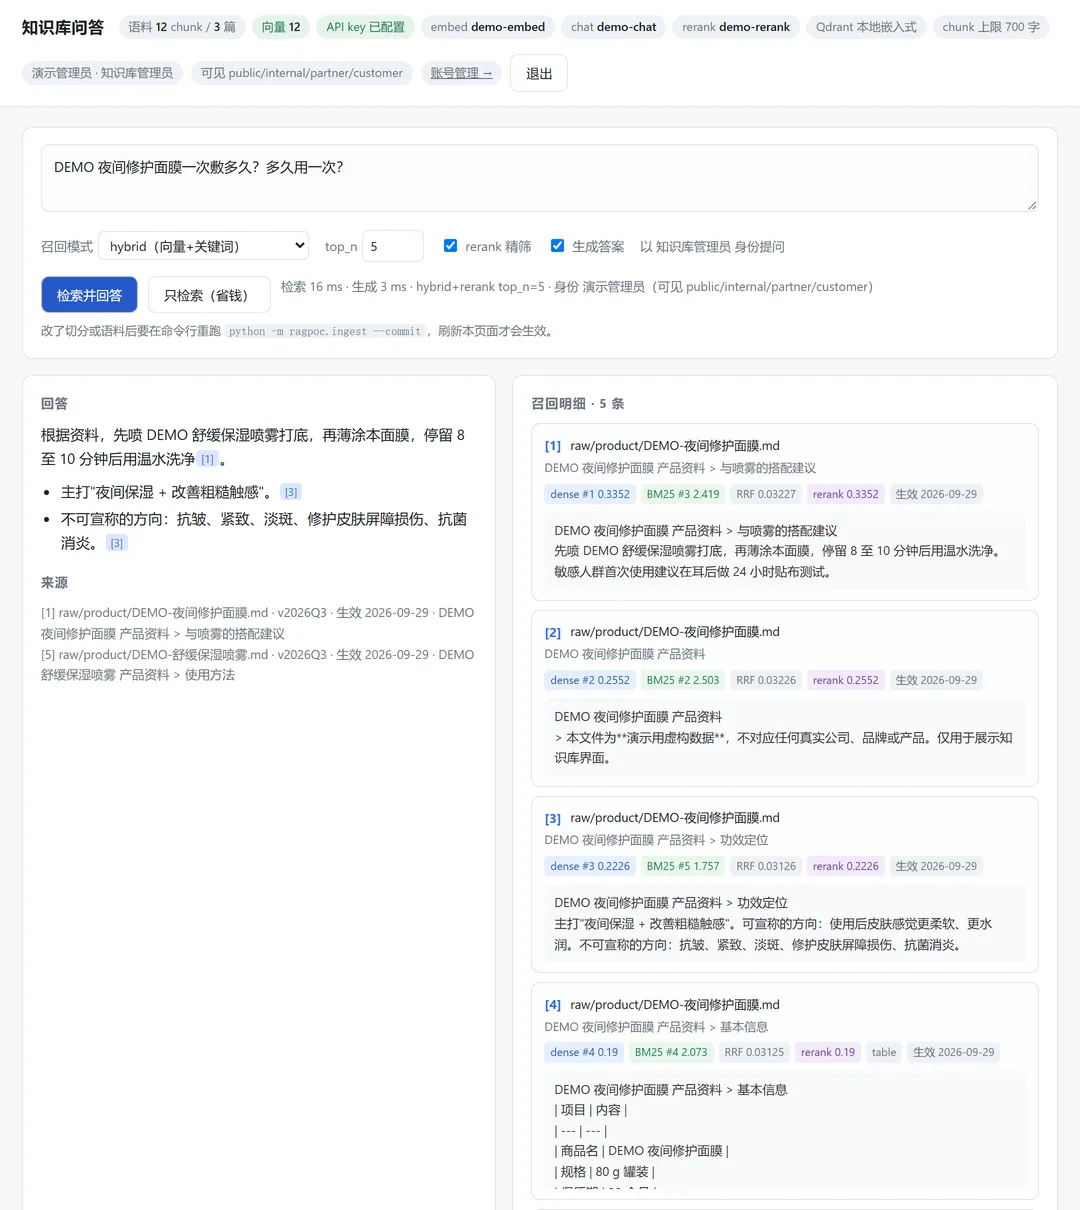
图 3 · 左边带引用的回答,右边两路各自的名次(演示数据)。
03 最难的一环,和最便宜的一环
最难的是读文件。中文 PDF 双栏排版、图片版扫描件、带合并单元格的参数表,处理不好,后面再先进都是垃圾进垃圾出。我们没有独立显卡,就把这段外包给按页计费的解析服务,自己只做「转成 Markdown、把页码标回去」。
最便宜的反而是模型调用:一次性费用个位数人民币量级,一次问答几分钱以下。真实成本全在人身上。
04 谁能问什么,和谁问过什么
门店导购不该看到折扣档位表和渠道政策,这跟「他问不问得到」是两件事。早期版本是页面上自己勾「我要看哪些范围」——等于没有权限。改成账号 → 角色 → 可见范围三层后,请求里自己声明的范围一律无效;管理员点停用的那一刻,对方正在用的会话立刻失效。每次问答还留一条记录:谁问的、命中了哪几张卡片、用的什么模型。
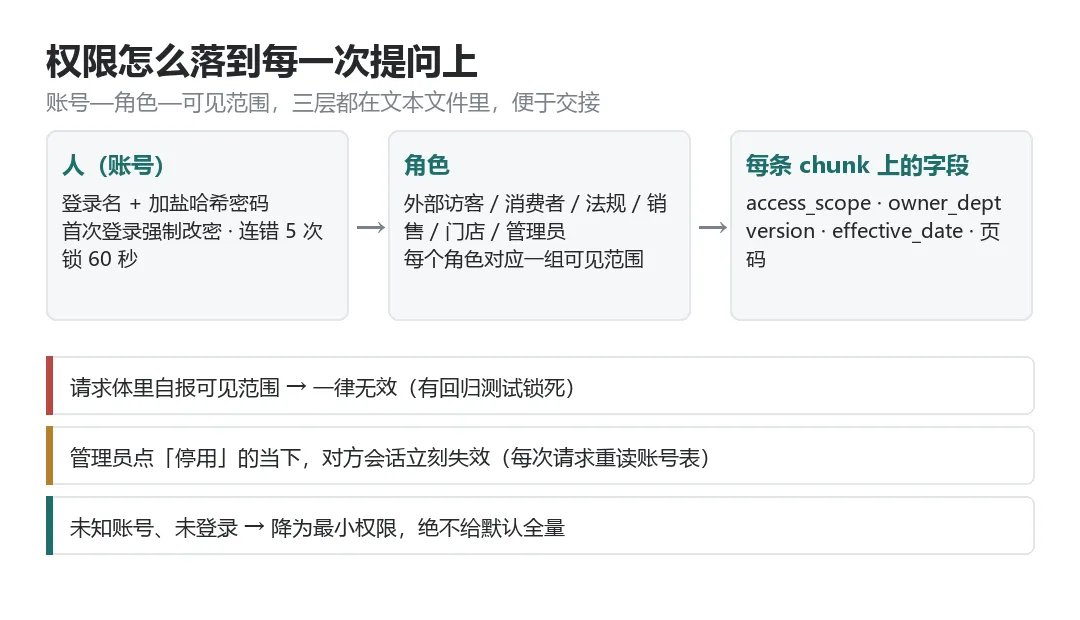
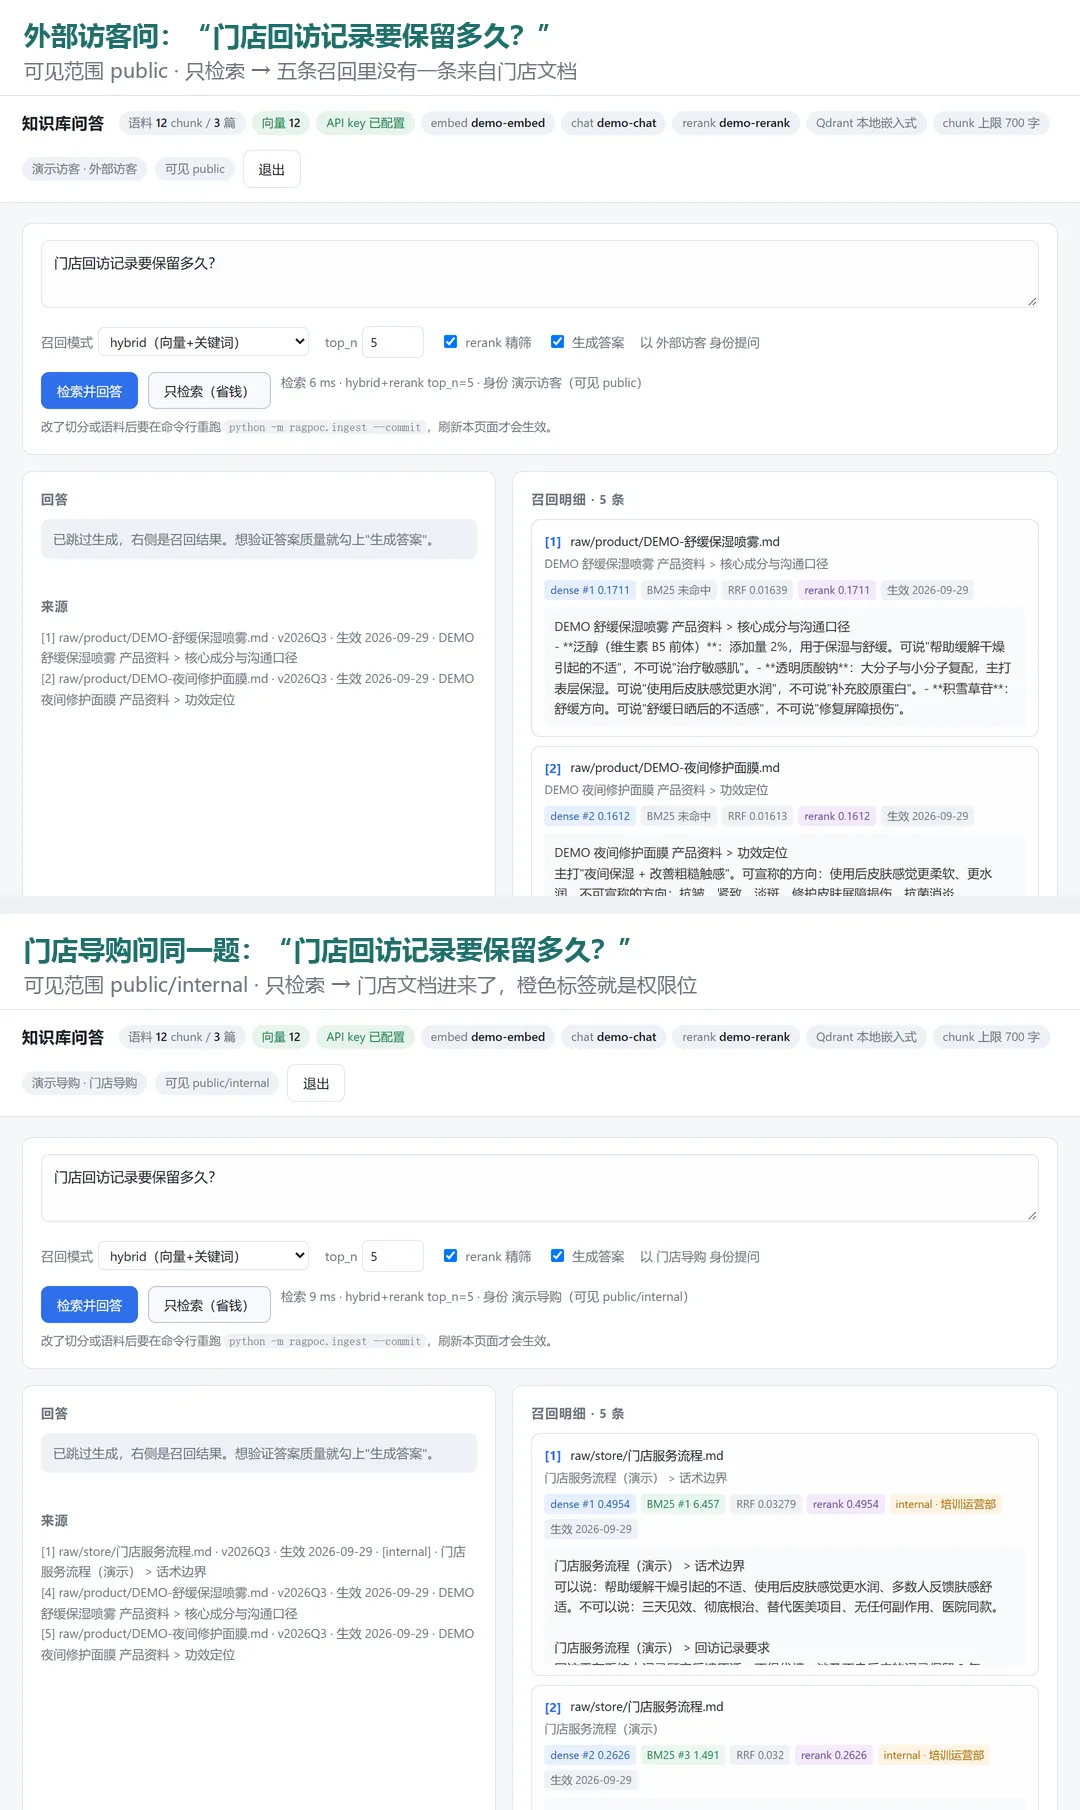
图 4 · 同一道题两种身份各问一遍,橙色标签就是权限位。
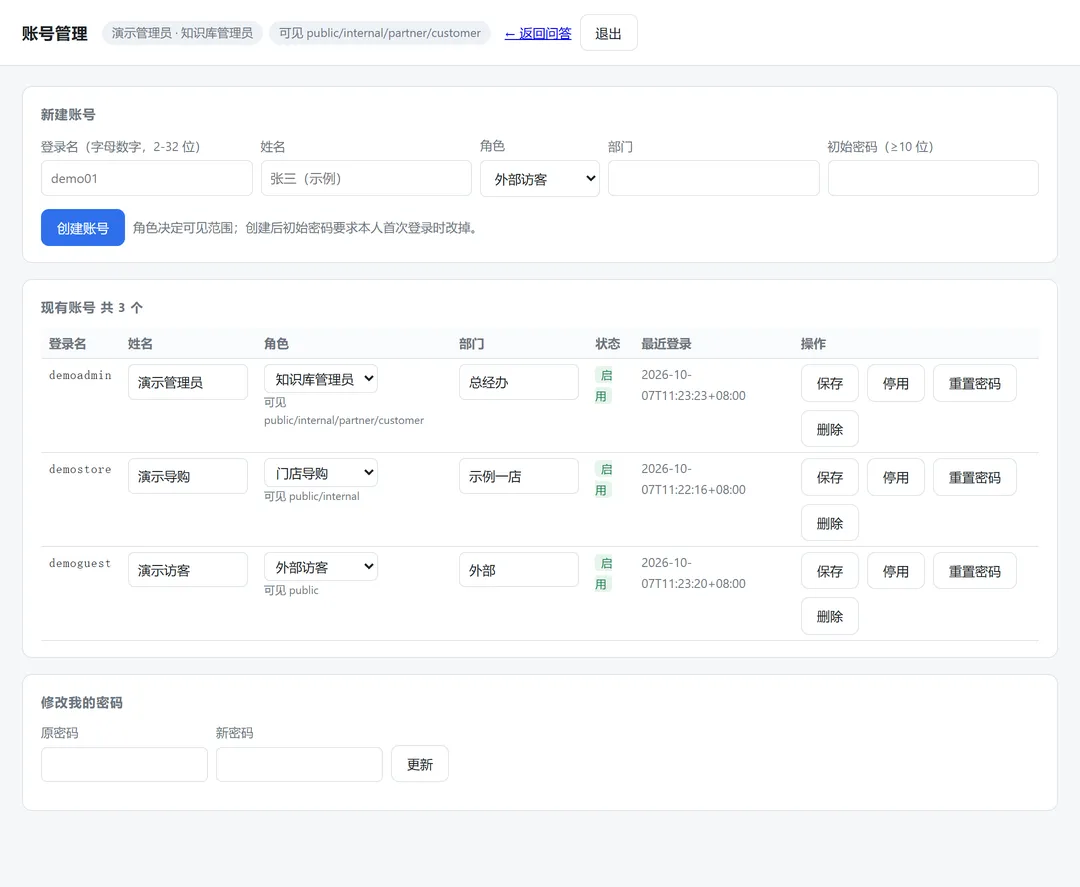
图 5 · 管理员侧:建账号、改角色、停用即刻生效。
05 一个应急决定,暴露五个真问题
中途有段时间密钥没到位,模型跑不了。我做了个应急决定:系统只做检索,把召回结果导出,由人照着卡片作答并判分。分数不难看,值钱的是顺手暴露的五个问题:
① 每份资料开头那句「本文件用于…」在抢第一名。它单独成卡、什么信息都没有,却因为字少总排最前,把真有答案那张挤到第二。
② 大表全挤在一张卡片里。答案在里面,但要模型在十几行几乎一模一样的行里挑对那一行,错一行就是报错价事故。
③ 考卷自己出错了。一道档位判断题,我写的标准答案就是错的档位。教训:每题必须附原文出处,否则考卷本身就会把系统教歪。
④ 格式范例是编造的种子。资料里顺手写了句「编号形如 ××××号」,模型就可能照模板吐一个不存在的编号。缺的字段要么补齐,要么连格式都别给。
⑤ 「没有就说没有」全靠一句提示。最危险的一题是问明年报价,翻出来的全是今年那张表——顺手答错的概率接近百分之百,而当时没有机制拦它。
06 知识库不是堆积文档,是「说得对」
最大的收获反而不在技术上。我们这行对宣传用语有硬性规定:什么功效必须先做正式评价、哪些词一出现就踩线、标签必须写全哪十项。而网上一大堆教程还在引用废止的旧分类——同事脑子里那个答案,本身可能就是错的。所以我把这些边界写进正文,让答案自带刹车;查不到的(价格、编号、渠道政策)一律留白写「待补」——编出来的比空白危险得多。
07 那能上线吗?还不能
模型这一环后来用真实密钥跑通了,问答链路是通的。但「能跑」离「能上线」还差四件事:
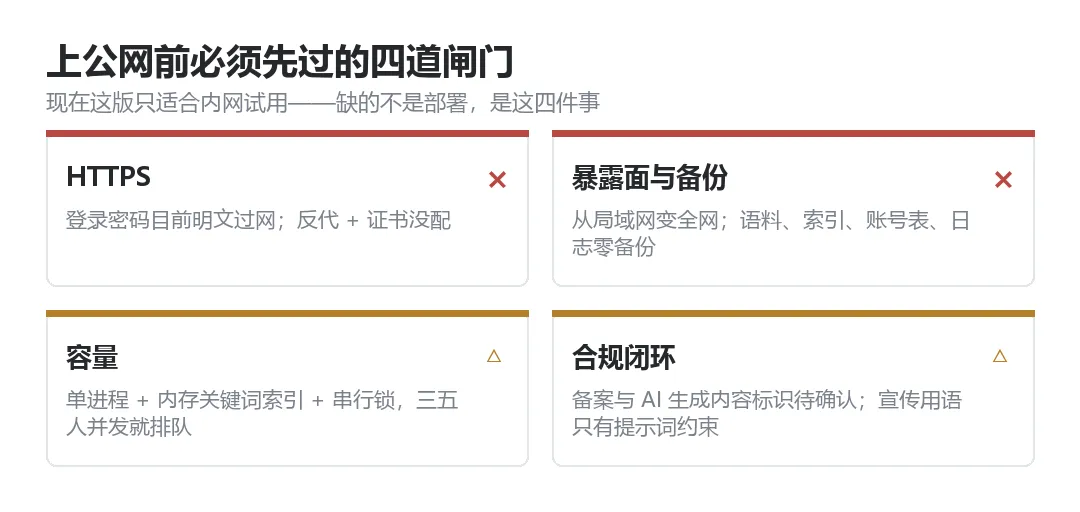
还有一条要诚实说:成体系的评估数字还没沉淀下来。第 05 节那轮是人代模型跑的,判分者就是作答者,还提前看过标准答案、只能算把坑标出来,不算效果证明。下一步是拿这套考卷在真实模型上重跑,得到第一个可信命中率。
08 如果你也在同样的处境里
① 别问「AI 能不能做」,先问「我能不能判断它答对了」——答案是考卷,不是选型。
② 标签第一天贴,权限第一天设,中文资料别省关键词那一路——晚做的代价是重做。
③ 先把中间态做成能看见的界面,再优化模型——看不见过程就只能赌结果。
④ 上不上线不是技术决定,是「我有数字吗」和「我承担得起答错吗」同时有答案那天。
09 后续需求:入口不止一个
对外客户交付必须是网页;内部同事更适合挂在飞书这类 IM 里——身份自带、少记一个密码、答案回到工作流。检索层要按前端分别出接口:网页带会话登录态,IM 走回调、把引用回写成卡片。
文中公司、品牌、产品、价格与业务数据均已脱敏;法规口径以监管部门现行文本为准,本文不构成合规或法律意见。



