
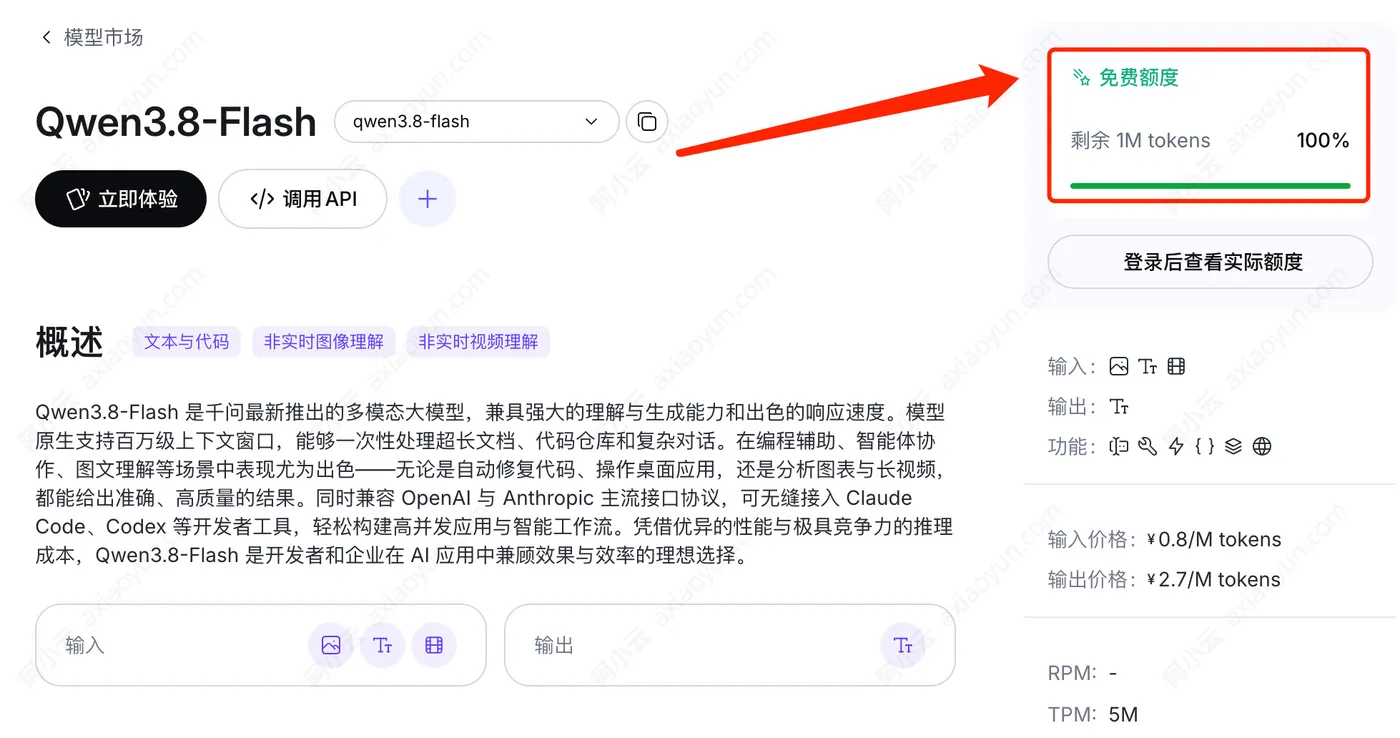
Qwen3.8-Flash是千问最新推出的多模态大模型,兼具强大的理解与生成能力和出色的响应速度。模型原生支持百万级上下文窗口,能够一次性处理超长文档、代码仓库和复杂对话。开通百炼 👉️ https://www.aliyun.com/product/bailian 免费领取Qwen3.8-Flash模型100万Tokens额度,如下图:
Qwen3.8-Flash是什么?
Qwen3.8-Flash 是通义千问推出的多模态大模型,原生支持百万级上下文窗口,可一次性处理超长文档、代码仓库和复杂对话,适用于编程辅助、智能体协作、图文理解等场景。Qwen3.8-Flash在编程辅助、智能体协作、图文理解等场景中表现尤为出色——无论是自动修复代码、操作桌面应用,还是分析图表与长视频,都能给出准确、高质量的结果。同时兼容 OpenAI 与 Anthropic 主流接口协议,可无缝接入 Claude Code、Codex 等开发者工具,轻松构建高并发应用与智能工作流。凭借优异的性能与极具竞争力的推理成本,Qwen3.8-Flash 是开发者和企业在 AI 应用中兼顾效果与效率的理想选择。
支持功能
Qwen3.8-Flash模型支持前缀补全、缓存、批量任务、函数调用、结构化输出、联网搜索功能,如下图: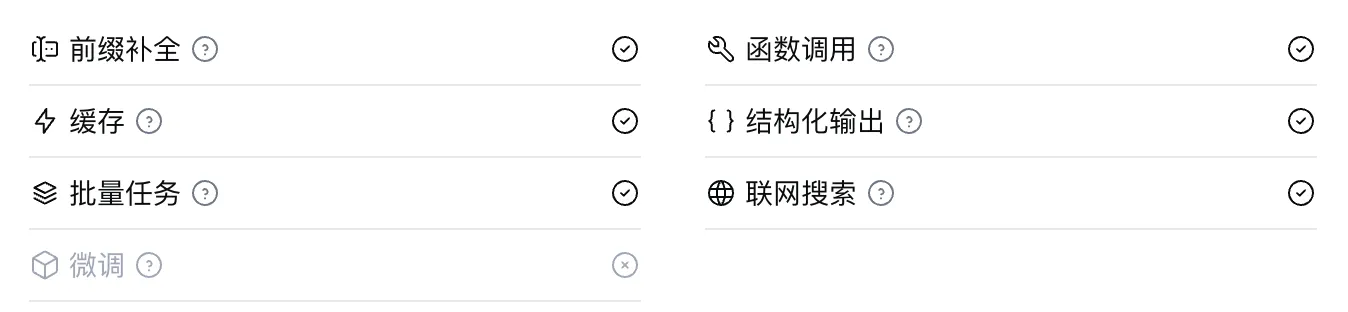
Qwen3.8-Flash模型收费价格
Qwen3.8-Flash 模型计费标准如下图:
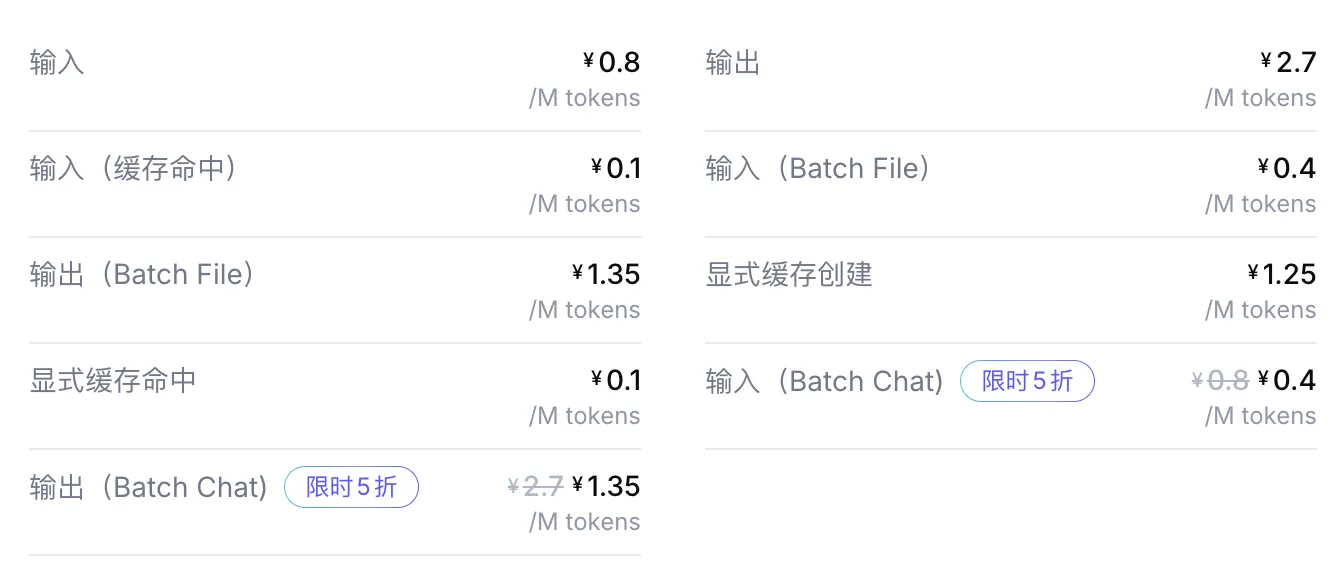
- 常规输入为 0.8 元 / M tokens,常规输出 2.7 元 / M tokens;
- 缓存命中输入仅 0.1 元 / M tokens;
- 批量任务中,Batch File 输入 0.4 元 / M tokens、Batch File 输出 1.35 元 / M tokens;
- 显式缓存创建 1.25 元 / M tokens,显式缓存命中 0.1 元 / M tokens;
- Batch Chat 正在限时 5 折,输入折后 0.4 元 / M tokens,输出折后 1.35 元 / M tokens。
速率限制与上下文
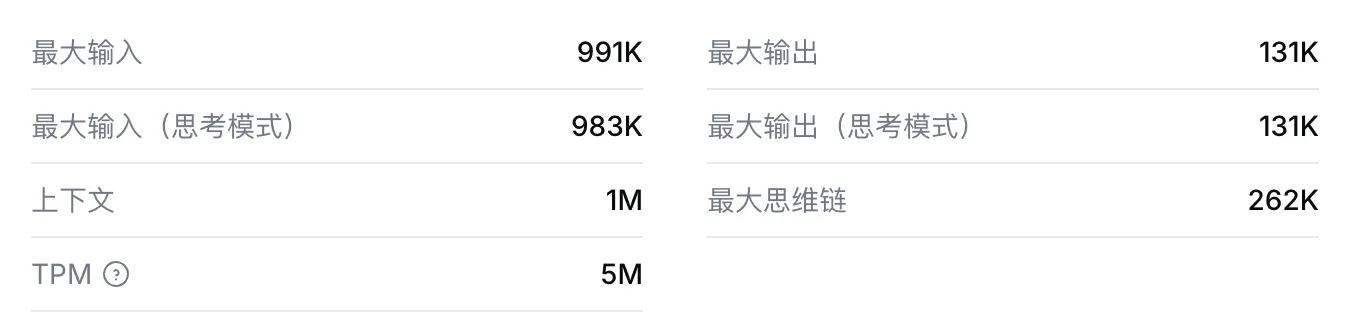
Qwen3.8-Flash 模型的速率限制与上下文参数:上下文总上限为 1M tokens,常规模式下最大输入 991K tokens,最大输出 131K tokens;开启思考模式时,最大输入为 983K tokens,最大输出保持 131K tokens,最大思维链可达 262K tokens,TPM 速率限制为 5M tokens。
内置工具
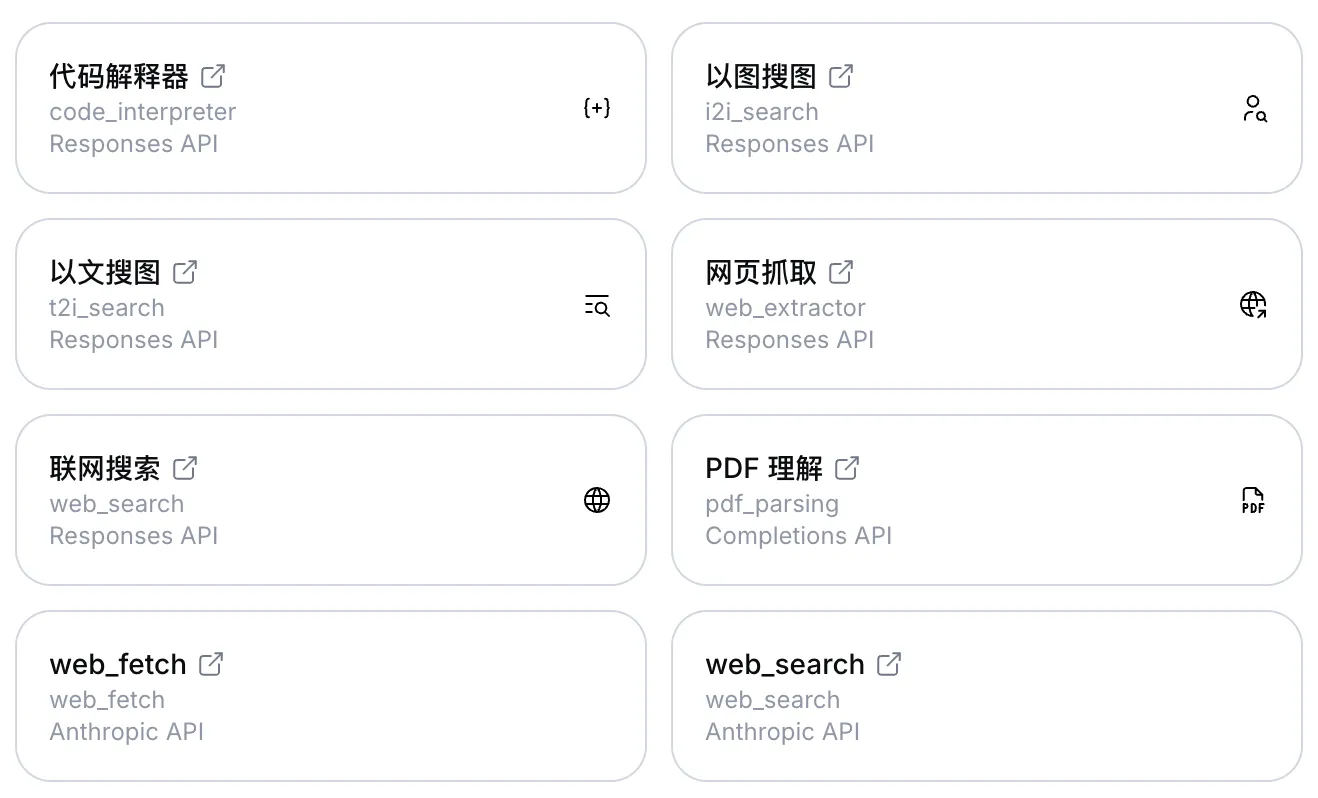
API 参考
以OpenAI标准的Python代码为例:
from openai import OpenAI
import os

client = OpenAI(
    # 如果没有配置环境变量,请用阿里云百炼API Key替换:api_key="sk-xxx"
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://maas.qianwenaiapi.com/compatible-mode/v1",
)

messages = [{"role": "user", "content": "你是谁"}]
completion = client.chat.completions.create(
    model="qwen3.8-flash",  # 您可以按需更换为其它深度思考模型
    messages=messages,
    extra_body={"enable_thinking": True},
    stream=True
)
is_answering = False  # 是否进入回复阶段
print("\n" + "=" * 20 + "思考过程" + "=" * 20)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if hasattr(delta, "reasoning_content") and delta.reasoning_content is not None:
        if not is_answering:
            print(delta.reasoning_content, end="", flush=True)
    if hasattr(delta, "content") and delta.content:
        if not is_answering:
            print("\n" + "=" * 20 + "完整回复" + "=" * 20)
            is_answering = True
        print(delta.content, end="", flush=True)
更多关于Qwen3.8-Flash模型收费价格及实际API调用,请参考:阿里云百炼AI模型平台官网指南。



