
在百炼上做 agent 的同学大概都做过同一个选择:联网能力放在哪一层。放模型侧,用 Responses API 挂内置 web_search;放工具侧,用 CLI/MCP 的 bl search web 把检索结果作为材料注入;放数据侧,用 bl knowledge 把自有文档做成可控索引。三条路不是"哪个更强"的关系,它们的边界、可审计性和失败模式差别很大。
我借一次具体的成本核算,把这三层在同一台机器上跑了一遍,日期都是 2026-10-09。结论对企业场景比对个人更有用:当你的 agent 输出要进决策表或者对外承诺时,检索层交付的是来源,答案留给取到来源的人判断。
一、业务起点:一个"数字要不要写进方案"的问题
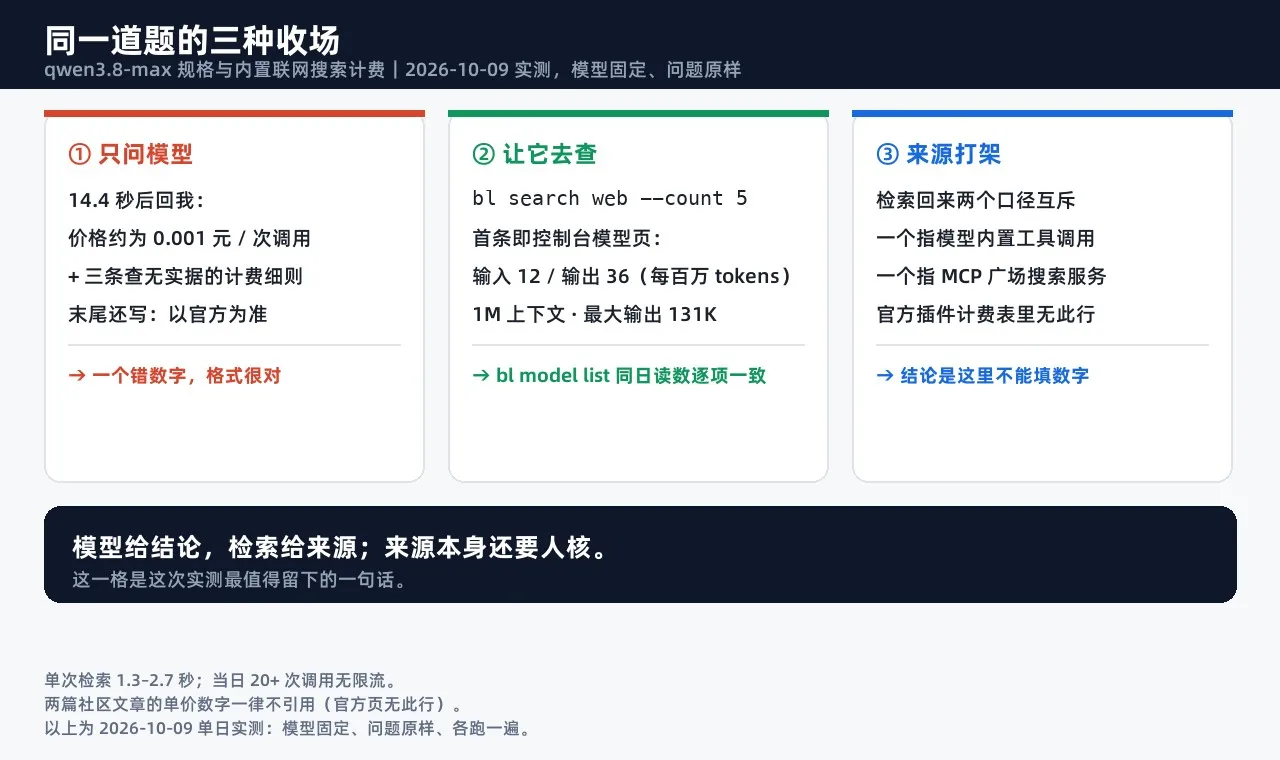
需要确认的规格是百炼内置联网搜索工具按调用的计费口径。我按最常见的做法先问模型,14.4 秒返回:
价格约为:0.001 元 / 次调用(即每 1000 次调用约 1 元)
后面跟了三条补充:只在模型真正触发搜索时计费、与 token 费用分别结算、价格可能调整以官方为准。连核对路径都给全了。
在企业内部,这一类输出最容易被直接抄进方案:格式规整、语气确定、还自带免责句。而它给到小数点后三位这件事本身就是异常信号,只是当时我没停下来想。
答案是我一直没让它去查。这一步在百炼 CLI 里是独立命令:bl search web。
二、检索层的输出形态:它交付的是证据
bl search web --query "阿里云百炼 qwen3.8-max 上下文窗口 价格" --count 5
我第一次跑,第一条命中就是百炼控制台的模型页,摘要带原文:
输入 12 元/每百万tokens 输出 36 元/每百万tokens
2026-09-01  1 M 上下文长度  128 K 最大输出长度
第三条是社区文章,把整张价目表搬回来了:输入 ¥12/M、输出 ¥36/M、缓存命中输入 ¥1.5/M、显式缓存创建 ¥15/M、显式缓存命中 ¥1/M,另有"最大输入:991K 最大输出:131K"。
这一层可以和本机读数直接交叉验证,不需要信任任何博客:
bl model list --model qwen3.8-max --output json
返回 contextWindow: 1000000、maxInputTokens: 991808、maxOutputTokens: 131072、输入 12、输出 36、缓存命中 1.5。检索命中的原文与平台读数逐项一致,包括那个 131072:控制台按 1024 进位写作"128 K",社区文章按 1000 进位写作"131K",同一数值两种口径。
性能与稳定性:单次检索 1.3 至 2.7 秒,一天二十多次调用没有限流。对 agent 流水线来说,这个延迟量级足够在"回答前插一跳检索"。
三、三层对照:同一个问题各自的收场
| 题目 | 模型原生(只问) | 检索层 bl search web |
平台侧核对 |
|---|---|---|---|
| qwen3.8-max 的上下文窗口与每百万 tokens 价格 | 默认旗舰不带参数时跑满 300 秒超时;把 --max-tokens 压到 800 后正常返回,答"我不能负责任地给出确切数字……为避免给你错误数字,我不能编造" |
首条即控制台模型页,摘要含 12/36 与 1M/128K;第三条含完整价目表 | bl model list 同日读数与检索原文逐项一致 |
| 内置联网搜索按调用多少钱 | 14.4 秒给出 0.001 元/次,外加三条查无实据的计费细则 | 命中两篇社区文章,两篇给的口径互相矛盾,而且说的不是同一件事 | 官方内置插件计费表里没有 web_search 这一行 |
| 某仓库当前 star 数 | 快模型这次超时未回(--timeout 120) |
检索页读数不一致,我改走 GitHub API 直读 | 当天两次读数 94,173 → 94,260,跨六小时涨 87 |
第二行是关键。检索回来的两个口径互相打架:一个说的是模型内置的工具调用,一个说的是 MCP 广场上的搜索服务,两者描述的是不同计费主体。具体数字我不在这里引用,都是社区文章的二手来源。再去官方帮助中心核对内置插件计费表,表里根本没有 web_search:联网检索类插件在那张表上叫 quark_search,计费写"限时免费,需申请开通";同一张表里 code_interpreter 标的是"免费"。
于是这道题到今天没有一个能写进方案的数字。所以这篇文章里也不出现任何 web_search 单价。模型给的是一个错数字,检索给的是三个来源,而来源让我知道这件事不能写。对企业来说,第二种输出才是可治理的:它把"未知"当作一种结果传回流程,不会把"未知"平滑成一个可被引用的数。
第一行也要客观:那次旗舰拒绝编造,行为是正确的。bl text chat 默认 --max-tokens 4096,思考型模型在长输出下容易撞 300 秒配置超时,压到 800 即正常返回,属于参数问题。
四、把检索结果接进模型:动线与约束
bl search web --query "阿里云百炼 qwen3.8-max 上下文窗口 价格" --count 5 --output json > evidence.json
bl text chat --system "只依据下面给你的材料回答,材料里没有的就说不知道,并列出你查过的 URL。" --message "$Q
【材料】
$(cat evidence.json)"
--system 那句是这条动线的关键控制。不加,模型会把材料当引子继续发挥;加了,返回里的每个数字都能追溯到一个 URL。做审计留痕时,这就是"结论 → 材料 → 来源"的可追溯链,比事后要求模型"别瞎编"可靠得多。
工程上有个必须知道的细节:--output json 返回的第一层是 MCP 工具的信封,
{"content":[{"type":"text","text":"<内层再嵌一层 JSON 字符串>"}],"isError":false}
内层解开才是 {"pages":[...],"request_id":"...","tools":[...],"status":0},每条 page 字段为 snippet / hostname / hostlogo / title / url。按顶层取 pages 会静默拿到空值。集成到内部平台时要把这层解包写进 SDK 封装,否则上游会把它当成"检索服务无结果"。另外 hostname 可能为空(我这天控制台那条命中就是"无"),来源展示要留 url 兜底。
五、路由:先确认身份,再选检索路径
百炼在 2.1.0 里把联网搜索的判断做成了独立 skill(bailian-web-search,随 bl skill init 一起装)。它只依赖一条无鉴权命令:
bl config show --output json
两个字段决定路径:profile 名是否为 token-plan;base_url 的 host 是否匹配 token-plan.<region>.maas.aliyuncs.com。任一命中即 Token Plan 身份,只能走模型原生工具;两条都不沾走 bl search web。我这台机器 profile 是 image、host 是 dashscope.aliyuncs.com,属默认身份。
host 检查不能省:用户可以在自定义 profile 名下装 Token Plan,只看 profile 名会漏判。Token Plan 的 key 不允许调 bl search web,那类 key 授权不了百炼 MCP 搜索。做多租户或内部网关时,这个判断应该在路由层做掉,不该让每个业务方去抄别人的那条命令。
另外,这条路不需要先去 MCP 广场开通:
bl mcp list --name search   # total: 1,仅 Brave_Search
bl mcp list --name web      # total: 0
bailian_web_search 不在广场清单里,它由 DashScope 侧内置,API Key 直接可调。广场可见性与工具可调性是两套目录,做权限管理时容易混。
六、参数行为:文档与实现之间的漂移要实测
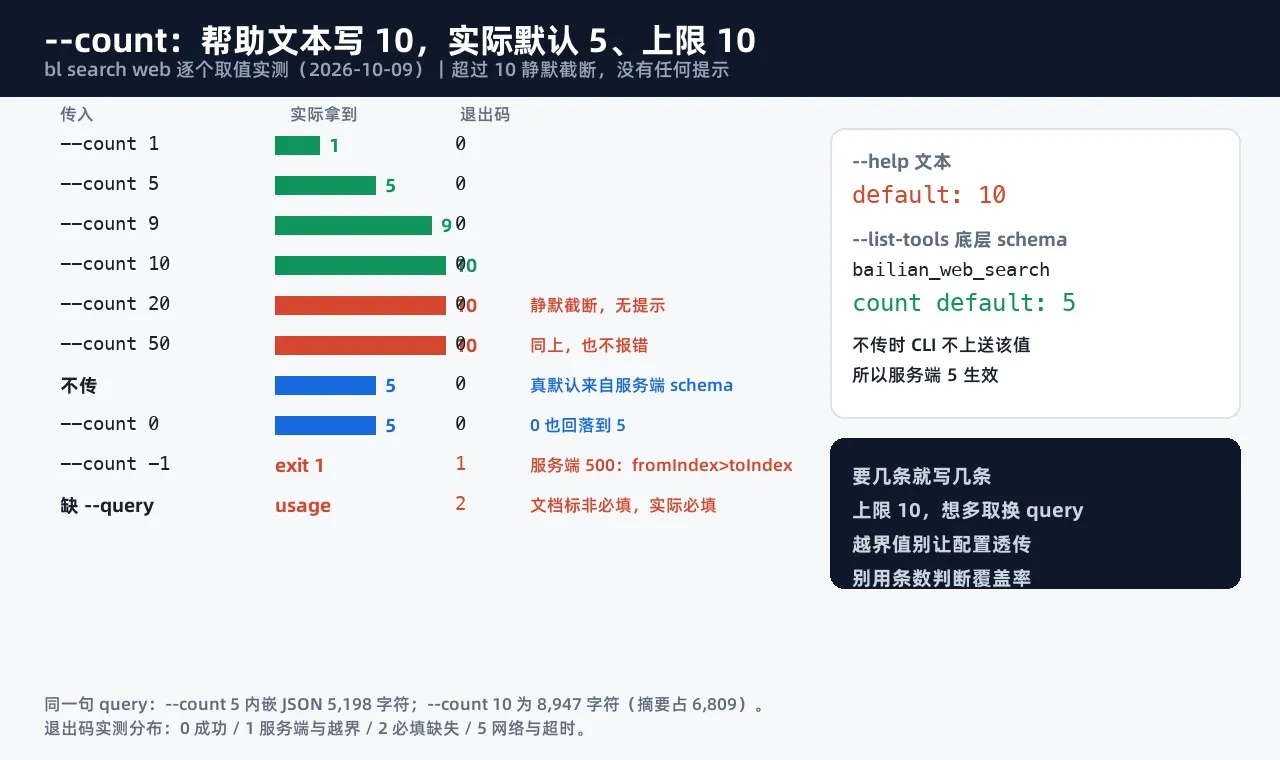
bl search web --help 写的是 --count <n> Number of search results (default: 10)。逐个取值实测:
| 传入 | 退出码 | 实际返回 |
|---|---|---|
| 不传 | 0 | 5 |
| 1 / 5 / 9 / 10 | 0 | 1 / 5 / 9 / 10 |
| 20 / 50 | 0 | 10(静默截断,无提示) |
| 0 | 0 | 5 |
| -1 | 1 | 服务端 500,原文 IllegalArgumentException: fromIndex(0) > toIndex(-1) |
不传 --query |
2 | Missing required flag: --query |
真实默认来自 bl search web --list-tools 打出的底层 schema:工具 bailian_web_search,入参 query(required)、count(default: 5)。不传时 CLI 不上送该值,服务端默认 5 生效。
对写自动化的三点:上限 10 且超限静默截断,做采集量假设时不能靠 --count 50;参数越界会抛服务端异常,-1 这类值必须在网关层做校验,不能从配置透传;--query 在参考文档里标"非必填",实际缺失直接 exit 2。文档层的松比你想象严重,接口约定要自己压一遍。
七、超时:一个控制实验纠正了我的错误结论
这一段我原本要写"百炼 CLI 的超时参数不生效"。差点发出去。
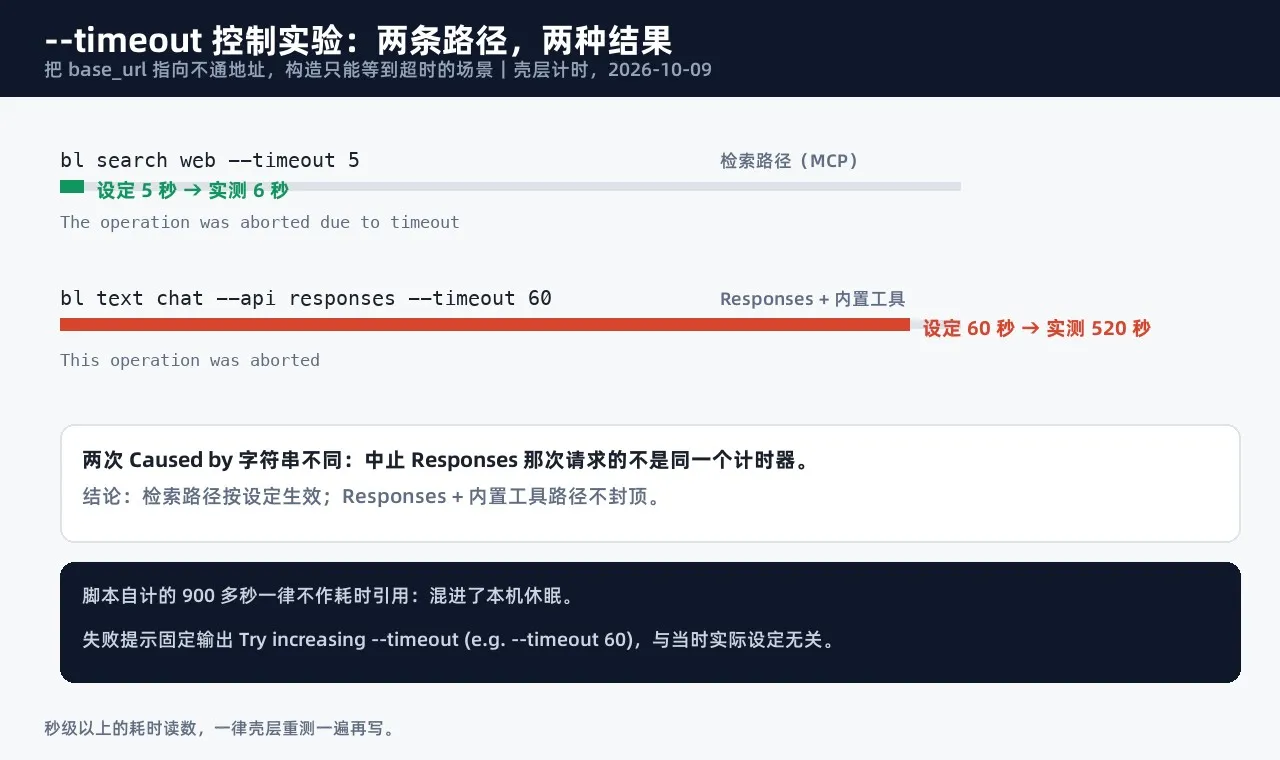
Responses 路径的几次超时,我用脚本自计读到 900 多秒,而当时 --timeout 设的是 150、180。换壳层计时重测后,那些数全部作废(混进了本机休眠)。再补一个控制组,把 base_url 指向不通地址,让它只能等到超时:
bl search web --query "probe" --base-url http://10.255.255.1 --timeout 5
bl text chat --api responses --model qwen3.8-flash --tool '{"type":"web_search"}' --timeout 60 --message "..."
| 路径 | 设定 | 壳层实测 | 错误原因 |
|---|---|---|---|
bl search web |
--timeout 5 |
6 秒中止 | The operation was aborted due to timeout |
| Responses + 内置工具 | --timeout 60 |
520 秒中止 | This operation was aborted |
结论收窄为两条:检索路径上 --timeout 按设定值生效;Responses + 内置工具路径上同一参数不封顶,且两次 Caused by 字符串不同,中止那次请求的并非同一个计时器。
对做 SLA 的团队这条差别很实际:如果你的 agent 走模型原生工具,超时预算不能只靠这个参数兜住。另外失败时 CLI 固定提示 Try increasing --timeout (e.g. --timeout 60),而我当时设的就是 60 或更大。这句是硬编码字符串,不要当作诊断依据。
八、能力边界:什么时候应该选别的路径
不适合做全量采集。上限 10 条、静默截断,它的定位是"快速看一眼公开网页"。企业级抓取是另一套工程(代理、反爬、IP 池),我当天的失败样本可作参照:抓今日头条被 302 到反爬 JS 页,抓 CSDN 拿到 HTTP 521。
私有知识应该走 bl knowledge。需要稳定复现、可控切块、索引可查的场景,知识库那条线才对;search web 命中公开网页,同一句 query 次日可能就是另一批结果。我这里所有读数都标注"2026-10-09 实拉",就是为了让复核有可能。
注意上下文成本。同一句 query:--count 5 时内嵌 JSON 是 5198 字符,--count 10 是 8947 字符(其中摘要 6809 字),单条摘要长度不受调用方控制。批量注入前先做一轮筛选,是我现在的默认做法。
九、这套动线带来的三点改变
- 凡是当天的数字,先检索再问。模型对"今天"没有记忆,只有训练截止日之前的世界观,加上极强的表达自信。
- 检索完不止步。这次它给两个互相矛盾的价格,逼我去翻官方页,才发现那张表里连这一行都没有。如果拿到来源就直接信,只是把编造的责任换了个人承担。
- 默认值一律实测再采信。
--count的 10、参数表里的"非必填"、超时提示里的 60,三个都是跑出来的,不是读到的。
接入与 Key 签发:CLI 安装页、Key 签发页。控制台入口:百炼首页。
npm install -g bailian-cli
bl skill init
bl search web --query "阿里云百炼 qwen3.8-max 上下文窗口 价格" --count 5



