
引言
IPv4定位受限于NAT和地址流转,城市级准确率约87%,区县级仅42%。IPv6结构化分配改变了这一局面:城市级96%,区县级78%,部分运营商已实现街道级。本文对比实测数据,拆解全球ip地址库的维护逻辑变化,并给出IPv6地址查询的代码实操与工程建议。
一、IPv4定位的老毛病,IPv6能治吗?
做过IP定位的都知道,IPv4的定位结果经常让人哭笑不得。人在东莞,IP显示广州;高铁上刷个视频,归属地在北京、天津、山东之间来回跳。这不是故障,是IPv4的架构决定的。
IPv4地址枯竭了,NAT成了标配。一个公网IPv4地址背后可能是成百上千用户,甚至通过CGNAT覆盖整个片区。定位系统没法直接拿到用户位置,只能靠Whois注册信息、BGP路由通告和主动探测做概率推断。推断这东西,准的时候很准,不准的时候差出几百公里。
IPv6不一样。IPv6地址结构自带层次化信息:全球路由前缀(/23)、运营商前缀(/32)、区域前缀(/48)、子网前缀(/64)。运营商在部署IPv6时普遍遵循地域化分配策略——某段/48前缀划归某城市,某段/64前缀对应某接入网。这意味着,对于全球ip地址库而言,IPv6地址本身就是定位线索,不需要全靠猜。
二、实测数据:差距有多大
某商业全球ip地址库2025年的内部测评数据,在排除移动网络场景后:
| 对比维度 | IPv4 | IPv6 |
|---|---|---|
| 城市级准确率 | 约87% | 约96% |
| 区县级准确率 | 约42% | 约78% |
| 街道级 | 不支持 | 部分运营商已实现 |
中国三大运营商的IPv6城市级定位准确率都能做到95%以上,区县级也能到80%左右。相比IPv4那套基于概率推断的算法,IPv6的定位结果更干净。
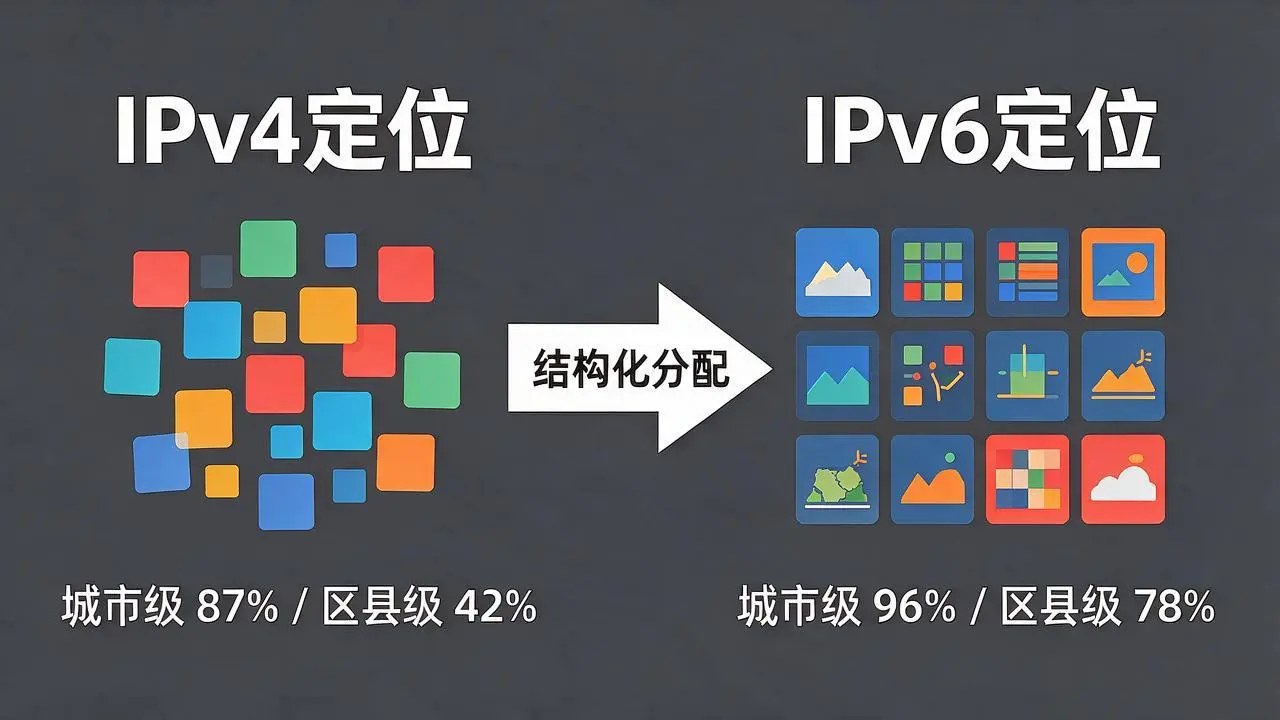
造成这种差异的技术原因有三点:
第一,IPv4地址流转导致信息失真。 地址交易市场活跃,一个原属华北的IPv4段可能被华南运营商采购使用,但Whois库可能五年未更新。业界普遍认为,相当比例的IPv4地址段存在注册信息与实际使用者脱节的情况。
第二,IPv6分配仍处规范期。 国内三大运营商在IPv6规划阶段就明确了地域映射关系。以中国移动为例,其CMNET6骨干网的地址规划文档显示,/48前缀的第三、第四字节直接编码了省份和地市信息。
第三,NAT汇聚模糊了IPv4出口。 即便用户真实位置在县城,流量经市级甚至省级BRAS汇聚后,出口IPv4地址属于汇聚层设备,定位结果自然被拉高到上级城市。IPv6的端到端架构不存在此问题。
三、全球ip地址库的维护逻辑变了
IPv4库的核心工作是“校准”——通过探测数据修正错误的注册信息。主流厂商采用被动探测加主动反馈机制,对存量段进行持续校正,更新周期通常为周级。
IPv6库则依赖实时数据流驱动。IPv6空间太大,被动探测覆盖不了,必须依赖源数据。2025年IAB发布的RFC 9630规范了geofeed格式,运营商可主动发布自己的前缀-位置映射。定位服务商通过订阅这些数据流,实现日级甚至小时级同步。
对于全球ip地址库的维护者而言,IPv6带来的不仅是精度提升,还有更新模式的根本变化:从“事后校准”转向“实时同步”。
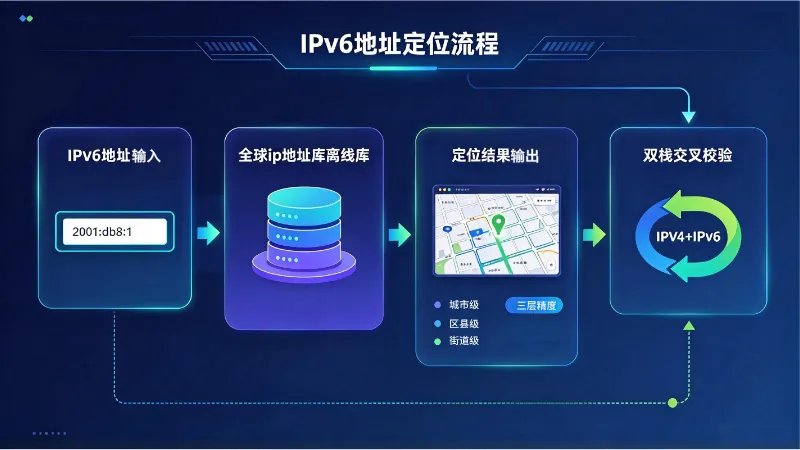
IP数据云的全球ip地址库支持geofeed实时同步,IPv6数据更新周期达到小时级,为开发者提供了从查询到风险画像的完整能力。
四、代码实操:IPv6地址查询与精度验证
import ipdatacloud  # 以官方文档为准
import time

# 加载支持IPv6的全球ip地址库离线库
db = ipdatacloud.OfflineIPLib(
    '/data/ipdb/ip_data_cloud.mmdb',
    enable_risk=True
)


def query_ipv6_location(ip_list: list) -> list:
    """
    批量查询IPv6地址定位信息
    对比IPv4与IPv6在相同业务场景下的定位精度
    """
    results = []
    for ip in ip_list:
        start = time.time()
        info = db.query(ip)
        if info is None:
            results.append({
   'ip': ip, 'error': 'not_found'})
            continue

        results.append({

            'ip': ip,
            'version': info.get('version', 'unknown'),
            'country': info.get('country'),
            'province': info.get('province'),
            'city': info.get('city'),
            'district': info.get('district'),
            'isp': info.get('isp'),
            'latency_ms': round((time.time() - start) * 1000, 2)
        })
    return results


# 测试:同一业务系统的IPv4和IPv6日志
test_ips = [
    '240e:390:1a0:1e00::1',   # IPv6地址示例
    '2409:8a00:1234:5678::1', # 中国移动IPv6示例
    '140.224.61.98',          # IPv4地址示例
]

for r in query_ipv6_location(test_ips):
    if 'error' in r:
        print(f"{r['ip']} | 查询失败:{r['error']}")
    else:
        print(f"{r['ip']} | {r['version']} | "
              f"{r['province']} {r['city']} {r.get('district', '')} | "
              f"{r['isp']} | 耗时: {r['latency_ms']}ms")
五、工程上的三个建议
第一,IPv6定位能力应该单独建。 如果业务流量里IPv6占比超过30%,别把它当成IPv4方案的补充。IPv6的地址分配机制和定位逻辑跟IPv4有本质差异,共用一套查询逻辑精度会打折扣。
第二,盯住geofeed数据订阅。 全球ip地址库的IPv6精度依赖运营商geofeed数据的时效性。选服务商的时候,确认对方是否支持geofeed实时同步,而不是只靠静态库更新。
第三,搞双栈交叉校验。 同一用户同时有IPv4和IPv6地址的场景,把两个定位结果做交叉比对,定位置信度会更高。
数据来源:
- 腾讯云开发者社区(2026年3月)
- IETF(2025年)。RFC 9630
- 360iResearch(2026年9月)



