
在大模型应用规模化开发的阶段,很多开发者和团队都会遇到成本管控的难题。传统按量计费模式下,调用消耗随业务并发、长上下文推理、多模态生成任务产生剧烈波动,项目前期很难预估整体预算,一旦出现脚本死循环、批量爬虫调用、智能体无限循环调用,账单会快速超出预期。同时不同模型、不同能力单独计价,文本推理、图片生成、视频渲染、工具调用的计费规则相互独立,账单条目繁杂,统计和复盘成本很高。Token Plan作为面向个人开发者、研发团队推出的大模型订阅服务,采用Credits统一额度计量体系,一份订阅额度可以跨多种模型、跨主流AI开发工具通用,把波动的后付费模式转化为可提前规划的订阅制额度体系,配套算力调度、缓存降本、密钥配额隔离、用量监控告警等能力,很好地解决大模型项目预算不可控、计费体系碎片化的痛点。本文将从产品定位、底层调度技术架构、核心功能、套餐版本差异、API接入实操、智能体工具集成、成本优化策略和高频故障排查等维度完整讲解,附带可直接运行的代码命令,帮助开发者快速完成接入与业务落地。Token Plan的核心设计理念,是统一额度池+弹性算力调度,不再为每一类模型单独购买资源包,而是将文本大模型、图像生成模型、视频生成模型、语音模型、代码解释器、联网搜索工具全部纳入同一套Credits抵扣体系。简单来说,Credits就是订阅套餐内的通用消耗单位,不同模型、不同任务类型拥有独立的抵扣系数,单次请求消耗的Credits,会综合输入Token数量、输出Token数量、是否触发Prompt缓存、是否开启长思考推理模式、是否调用多模态生成能力动态计算。缓存命中的输入上下文会大幅降低抵扣系数,这也是长会话Agent任务最主要的降本手段。详情👉访问阿里云百炼Token Plan服务页面了解。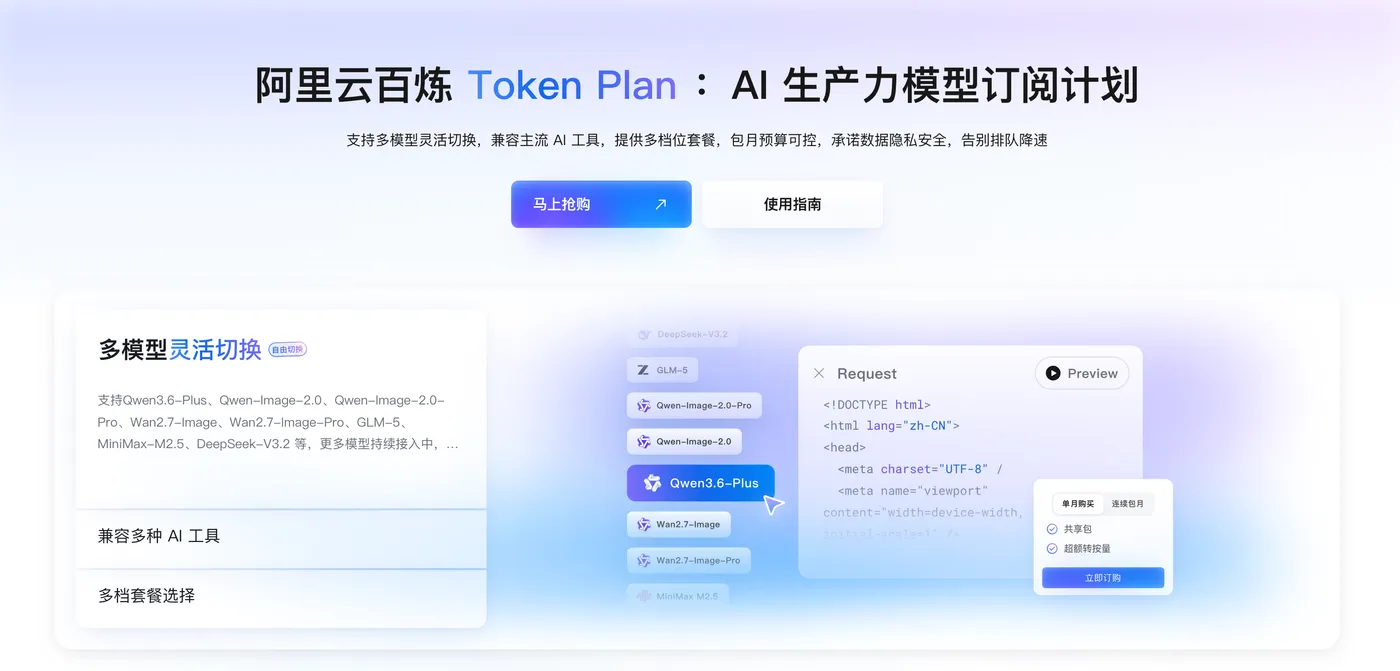
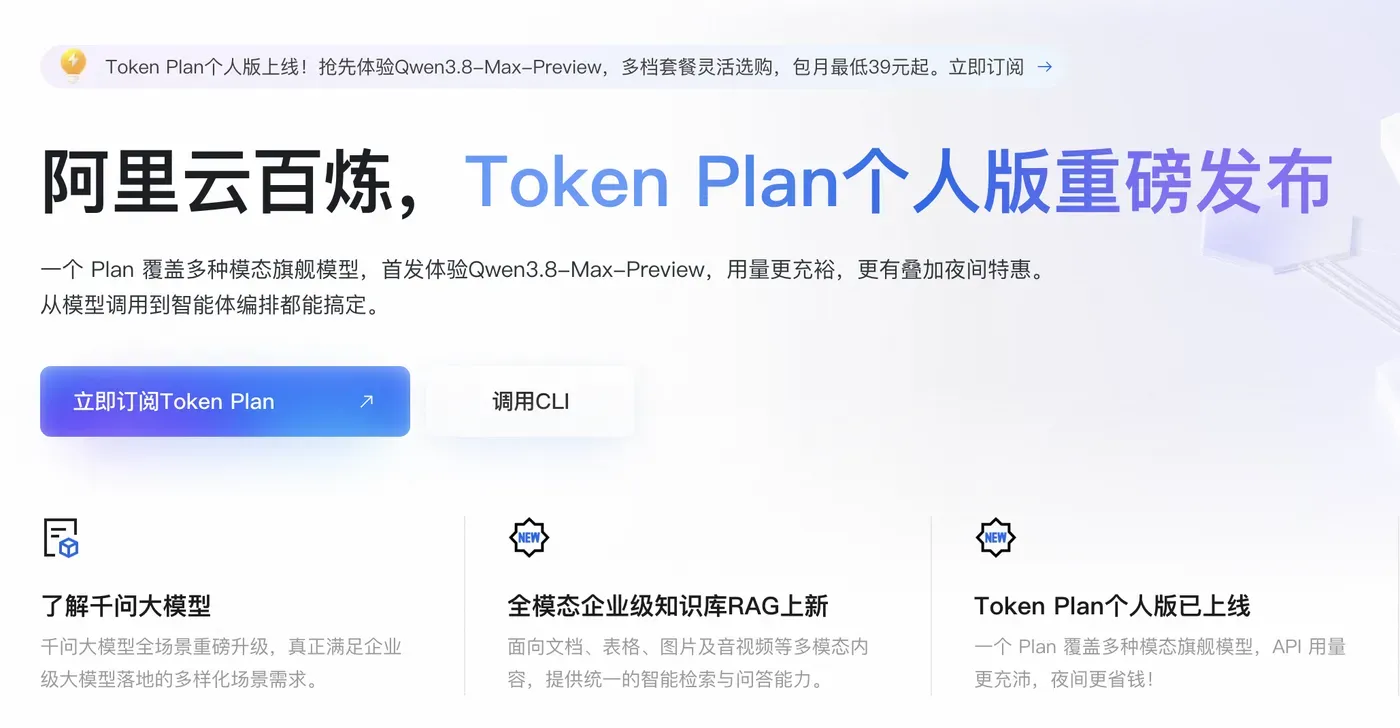
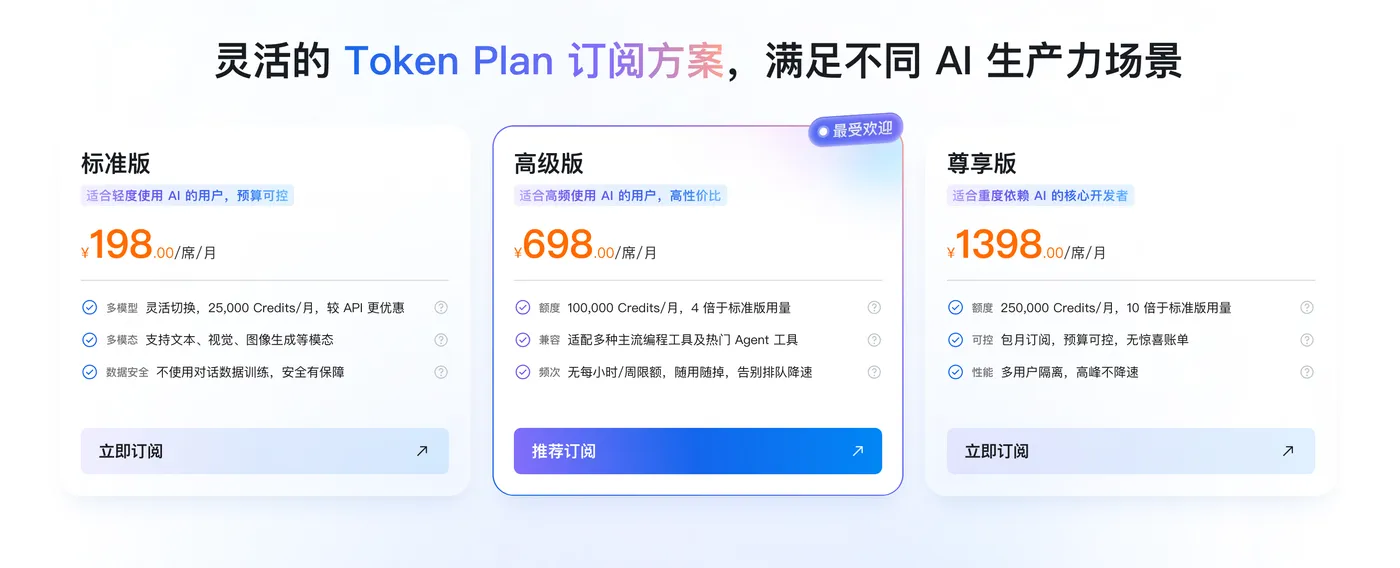
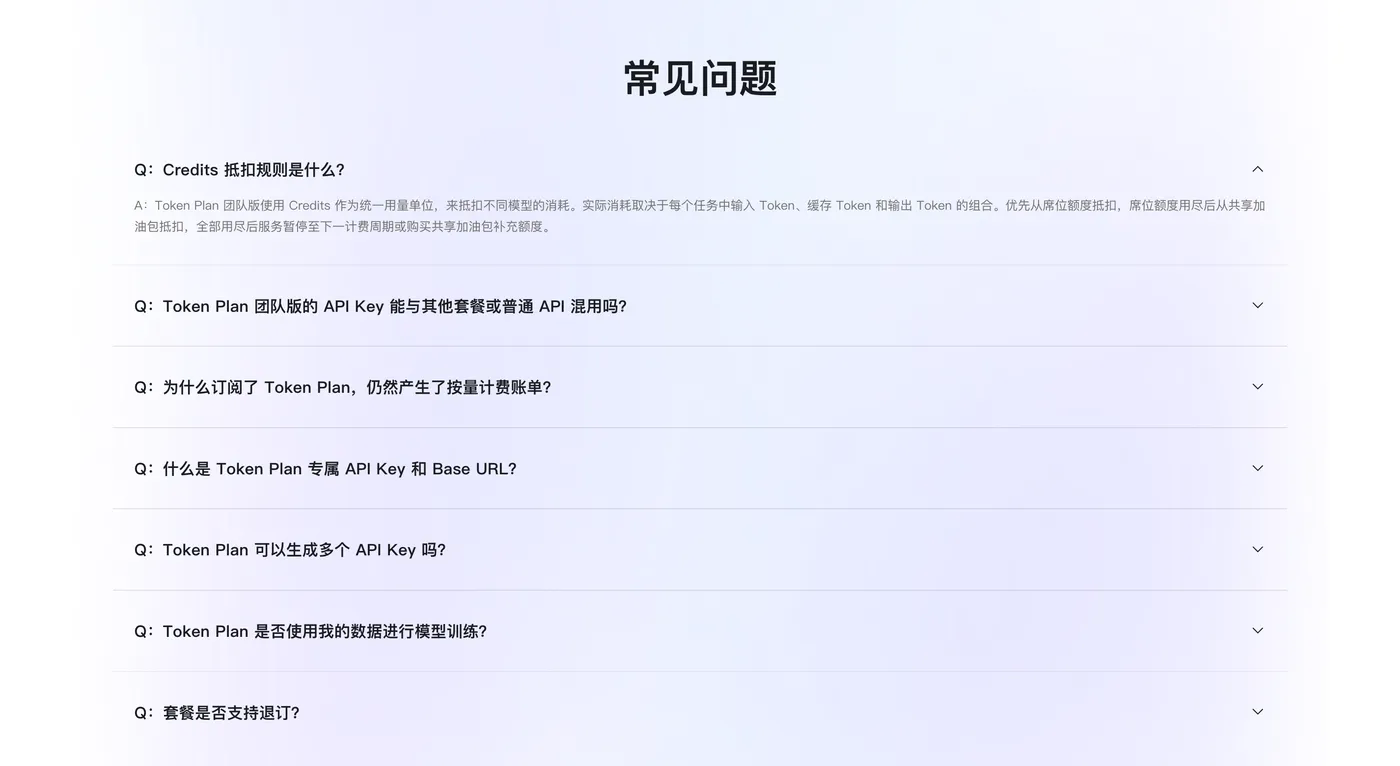
整套产品分为个人版和团队版两大产品线,面向完全不同的使用主体。个人版提供Lite、Essential、Standard、Pro四档套餐,采用滚动7天窗口限额机制,额度从首次调用开始计时,7天周期内累计消耗触达限额,接口会临时限流暂停服务,开发者可以购买补充用量包继续使用。其中Standard与Pro档位会附赠Harness智能体框架的配套权益,包含免费额度和折扣,适合做代码开发、智能体实验的独立开发者。团队版面向企业和协作小组,分为标准座席、高级座席、尊享座席,使用月度总额度模式,不再设置7天滚动窗口,支持多席位分配、子密钥精细化权限隔离、全维度用量报表,同时承诺用户业务数据不会用于模型训练,满足企业数据合规诉求。
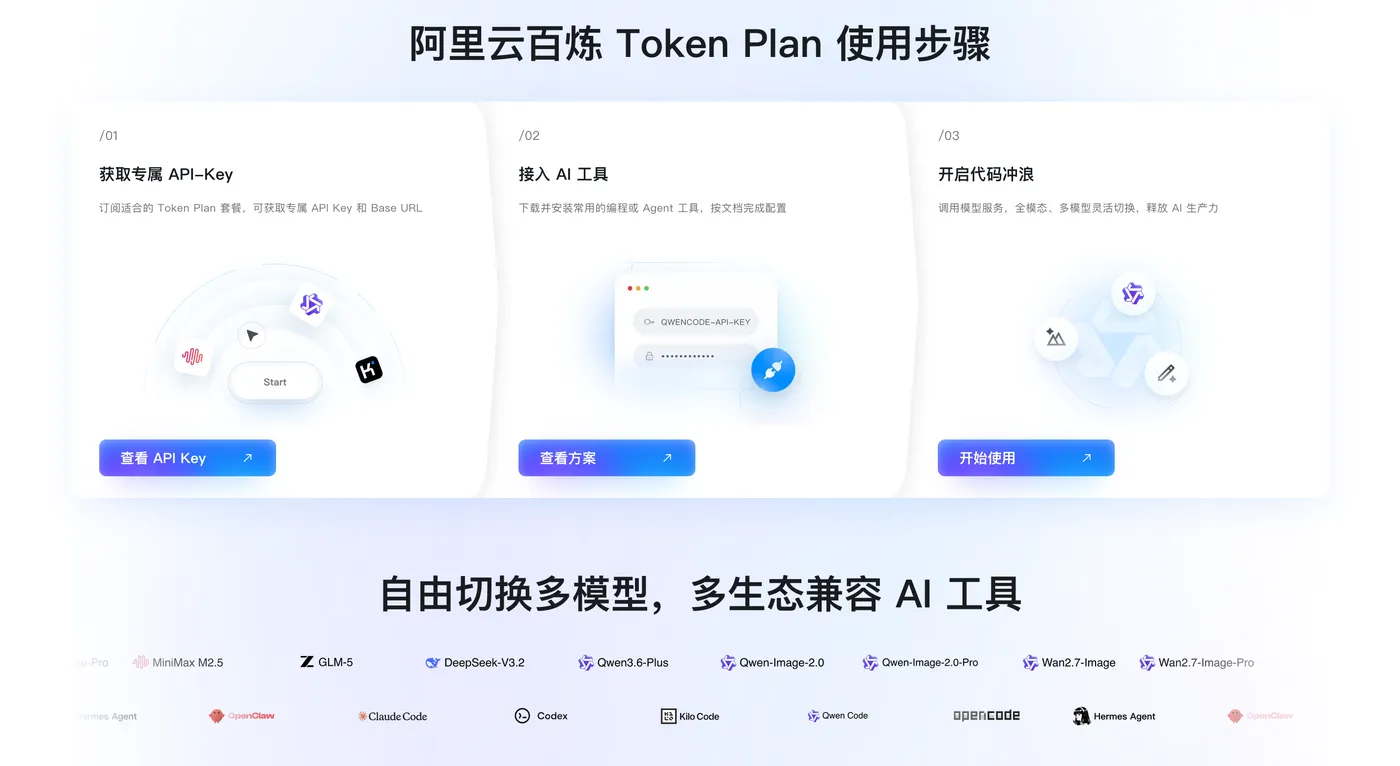
在支持的模型与工具生态上,Token Plan原生覆盖主流文本推理模型、多模态生成模型,包含文本对话、长文档分析、代码补全、图像生成、视频生成、语音识别与语音合成等能力。同时原生打通大量开发者常用工具,Cursor、Claude Code、Qwen Code、Qoder CN、OpenClaw以及DeepSeek Harness智能体框架都可以直接接入,只需要替换接口地址与套餐专属API Key,不需要大幅修改业务代码。用户在IDE插件、本地Agent脚本、后端服务中产生的所有调用,都会统一从Token Plan订阅额度池中扣减Credits,打通本地开发和线上服务的消耗统计。
从底层技术架构来看,Token Plan整体分为四层:接入网关层、额度管控层、算力调度层、模型推理层,同时配套独立的用量存储与告警子系统。
第一层是兼容网关接入层。网关对外提供兼容OpenAI协议的标准接口,这是生态适配的关键。绝大多数基于OpenAI SDK开发的应用、插件、Agent脚本,只需要修改API地址和密钥,不需要改动消息构造、参数传递的业务代码,就能切换到Token Plan套餐额度。网关同时完成请求鉴权、子密钥权限校验、模型白名单校验、TPM限流。每一个创建的子密钥都可以单独设置允许访问的模型列表、独立额度上限、每分钟Token上限,实现多项目、多开发人员之间的消耗隔离,避免单个脚本耗尽整个团队的额度池。
第二层是额度管控与计量层。这一层是Token Plan的核心,所有请求抵达网关后,会先进入计量引擎做预扣额度计算。引擎会读取当前请求的模型标识、输入Token预估量、是否使用缓存上下文、是否开启思考模式,根据该模型的抵扣系数算出预估Credits消耗,校验密钥剩余额度是否充足。额度充足则放行请求进入调度层;额度不足直接返回429限流错误。在模型推理完成之后,计量引擎再读取真实的输入输出Token、缓存命中标记,做最终的Credits结算,修正预扣数值。所有消耗记录写入时序数据库,为控制台报表、用量大盘、告警规则提供数据源。
第三层是算力调度层,依托FlashBoot与UniScheduler异构调度组件,负责根据当前请求类型、并发压力、SLA等级分配算力资源。针对Agent场景长链路、高并发、时延敏感的特点,调度系统可以快速弹性拉起推理实例,弹性启动时间大幅压缩,支撑高突发流量。调度系统还内置优速模式,开启后可以提升吞吐能力,适合对响应速度要求高的线上业务;吞吐预留PTU、独占吞吐DTU则面向大型企业,保障固定时段的算力供给。Prompt缓存模块也部署在这一层,系统自动识别重复或者长期复用的系统提示词、文档上下文,缓存编码后的文本特征,后续相同上下文再次请求时,不需要重复编码输入,既降低推理时延,也大幅减少Credits消耗,部分场景成本最高可以降低95%。
第四层是模型推理层,包含不同系列的文本、图像、视频、语音推理服务,调度层会将请求路由到对应模型的推理集群,完成生成任务,再把结果回传给网关返回客户端。
独立的告警子系统会持续消费计量日志,用户可以在控制台配置多维度告警策略,包括密钥额度剩余百分比告警、单日消耗阈值告警、TPM并发超限告警、接口错误率突增告警,告警通知可以通过消息渠道推送,方便及时发现异常调用,避免额度被异常脚本快速耗尽。
接下来进入实战接入环节,首先是前置准备工作:登录控制台,选购适配需求的Token Plan套餐,进入密钥管理页面,创建套餐专属API Key,注意套餐密钥带有专属前缀,和普通按量付费的密钥区分开。详情👉访问阿里云百炼Token Plan服务页面了解。
首先使用Python OpenAI兼容SDK调用文本对话接口,是后端服务、Agent脚本最常用的接入方式。先安装依赖包:
pip install openai python-dotenv
在项目根目录创建.env文件存放密钥,避免硬编码泄露:
TOKEN_PLAN_API_KEY="sk-sp-xxxxxxxxxxxxxxxxxxxx"
TOKEN_PLAN_BASE_URL="[https://dashscope.aliyuncs.com/compatible-mode/v1](https://dashscope.aliyuncs.com/compatible-mode/v1)"
Python调用代码示例:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
    api_key=os.getenv("TOKEN_PLAN_API_KEY"),
    base_url=os.getenv("TOKEN_PLAN_BASE_URL")
)

def chat_with_token_plan(user_prompt: str, model_id: str = "qwen3.8-max"):
    try:
        resp = client.chat.completions.create(
            model=model_id,
            messages=[
                {
   "role": "system", "content": "你是专业后端开发助手,代码输出简洁规范,附带注释。"},
                {
   "role": "user", "content": user_prompt}
            ],
            max_tokens=1024,
            temperature=0.7,
            stream=False
        )
        content = resp.choices[0].message.content
        usage_info = resp.usage
        print(f"输入Token:{usage_info.prompt_tokens},输出Token:{usage_info.completion_tokens}")
        print(f"本次对话内容:\n{content}")
        return content
    except Exception as e:
        print(f"调用异常:{str(e)}")
        return None

if __name__ == "__main__":
    chat_with_token_plan("请写一个Python日志封装工具,支持按大小切割日志文件")
执行脚本直接运行,所有消耗会自动从当前套餐Credits额度扣减,无需额外修改账单配置。
第二个示例,使用curl命令直接发起HTTP请求,适合Shell自动化脚本、服务器定时任务:
curl [https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions](https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions) \
-H "Authorization: Bearer sk-sp-xxxxxxxxxxxxxxxxxxxx" \
-H "Content-Type: application/json" \
-d '{
"model": "deepseek-v4.1-flash",
"messages": [{"role":"user","content":"解释Token Plan中Prompt缓存的降本原理,举开发场景例子"}],
"max_tokens":800,
"temperature":0.6
}'
Token Plan同样支持多模态图像生成接口,调用图像模型时消耗规则会切换为图像生成对应的抵扣系数,兼容同样的网关地址与密钥,代码改动很小,示例如下:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(
    api_key=os.getenv("TOKEN_PLAN_API_KEY"),
    base_url=os.getenv("TOKEN_PLAN_BASE_URL")
)

def generate_image_by_token_plan(prompt: str):
    resp = client.images.generate(
        model="qwen-image-3.0-pro",
        prompt=prompt,
        n=1,
        size="1024*1024"
    )
    image_url = resp.data[0].url
    print("生成图片地址:", image_url)
    return image_url

if __name__ == "__main__":
    generate_image_by_token_plan("写实摄影,秋日林间小路,阳光穿过树叶,暖色调,浅景深")
在Harness智能体框架中接入Token Plan是高频场景,只需要在框架配置文件中修改模型适配器的API地址和套餐密钥,框架内所有工具调用、代码执行、多轮思考的消耗都会走套餐额度。Harness启动配置示例,修改profile配置中的模型节点:
model:
  adapter: openai-compatible
  base_url: "[https://dashscope.aliyuncs.com/compatible-mode/v1](https://dashscope.aliyuncs.com/compatible-mode/v1)"
  api_key: "${TOKEN_PLAN_API_KEY}"
  default_model: "qwen3.8-plus"
配置完成后,使用dsh命令启动WebUI,智能体执行任务时自动抵扣Credits:
dsh web --profile ./token-plan-profile.yaml
额度管控是Token Plan面向团队场景的核心能力,管理员可以创建多个子API Key,分配独立额度和模型白名单,避免共用主密钥带来的风险。下面是子密钥管理的操作逻辑,在控制台密钥页面新建密钥,配置参数:允许的模型列表、该密钥的每周额度上限、TPM最大限制。开发人员只拿到子密钥,无法修改套餐本身,管理员可以随时停用密钥,在用量报表中单独查看每一把密钥的消耗曲线,定位高消耗的项目和脚本。
成本优化策略是用好Token Plan的重点,首先充分利用Prompt缓存。在Agent、文档问答这类长上下文场景,把固定不变的系统提示词、参考文档内容放在请求的前置上下文,重复请求时系统自动命中缓存,大幅减少Credits消耗。第二,按需选择模型,简单文本提取、简单代码补全使用轻量Flash版本模型,复杂推理、长文档阅读使用Max系列,不要全部使用高抵扣系数的大模型。第三,配置告警阈值,设置额度剩余20%触发通知,提前补充用量包,避免线上业务突发限流。第四,合理使用TPM限流,给自动化脚本设置较低的Token每分钟上限,防止死循环脚本短时间耗尽额度。
在实际落地中,开发者经常遇到几类问题,整理对应的排查方案。第一,返回429额度不足:先在控制台查看密钥消耗明细,区分是达到套餐周期限额,还是子密钥单独配额耗尽,可以补充用量包或者等待周期重置。第二,接口鉴权报错:确认使用的是Token Plan专属前缀的密钥,普通按量付费密钥无法在套餐网关使用,核对BaseURL地址是否正确。第三,消耗额度远超预估:优先排查是否开启思考推理模式,该模式输出大量思考Token,消耗系数更高;其次查看是否频繁传入全新长文档,没有触发Prompt缓存。第四,IDE插件接入失败:确认插件支持OpenAI兼容协议,在插件设置页填入正确的接口地址和套餐密钥,模型ID填写平台支持的标识。第五,缓存没有生效:缓存对上下文结构有要求,必须是完全一致的前置prompt,随机变化的用户对话内容无法触发缓存。
Token Plan的适用场景覆盖个人学习开发、独立开发者项目、中小企业线上AI业务、Agent自动化流水线。独立开发者可以使用个人版套餐,在本地IDE、Harness智能体中做代码开发、原型验证,预算固定,不用担心月底账单暴涨;中小企业团队可以使用团队版,通过子密钥给不同业务模块分配额度,统一管理研发、测试环境的大模型调用成本,用量报表方便做项目成本分摊;线上业务可以搭配优速调度模式,保障并发响应速度,同时依托订阅模式锁定成本区间。
同时也需要认清产品边界,Token Plan是额度订阅方案,不是私有化部署,所有推理请求仍然走云端模型服务;个人版7天滚动限额适合波动不大的开发场景,峰值持续超高并发的线上业务,建议搭配团队月度套餐和吞吐预留能力;Credits抵扣系数会随模型版本迭代调整,上线前需要在测试密钥做压测,评估预估消耗。它不能完全杜绝异常调用,权限隔离、告警策略依然是业务侧必须配置的防护手段。详情👉访问阿里云百炼Token Plan服务页面了解。
对比传统按量付费,Token Plan最大的改变是成本预期的确定性。按量付费适合流量极小、调用频次不可预测的探索阶段,而当项目进入稳定开发、持续迭代阶段,订阅套餐的统一额度、缓存降本、多工具互通的优势会明显体现。开发者只需要维护一套密钥体系,文本、图像、视频、工具调用全部统一统计,不用在多个模型平台之间切换充值、对账,降低运维的复杂度。
总而言之,Token Plan为大模型开发者提供了一套兼顾预算可控、生态兼容、算力弹性的订阅方案,统一Credits计量体系、OpenAI兼容网关、Prompt缓存降本、精细化密钥配额,解决了传统计费模式预算失控、账单繁杂的痛点。上面提供的Python对话代码、图像生成脚本、curl请求示例、Harness配置命令都可以直接在本地环境测试,开发者可以基于这套方案,把本地开发脚本、IDE插件、后端线上服务统一接入套餐额度,建立可观测、可管控的大模型调用成本体系,在智能体开发、多模态内容生成、代码辅助场景中稳定落地。



