
10 月 6 日(美国时间),OpenAI 公开 openai/math 仓库,首批 722 篇数学手稿,出自一个未发布的内部模型。对工程团队而言,这个仓库的参考价值在于:它把 AI 批量产出之后的筛选、验证、撤回和版本管理,以可检视的形式放在了公开仓库里。以下内容依据仓库自述和公开报道整理。
一、流水线与漏斗
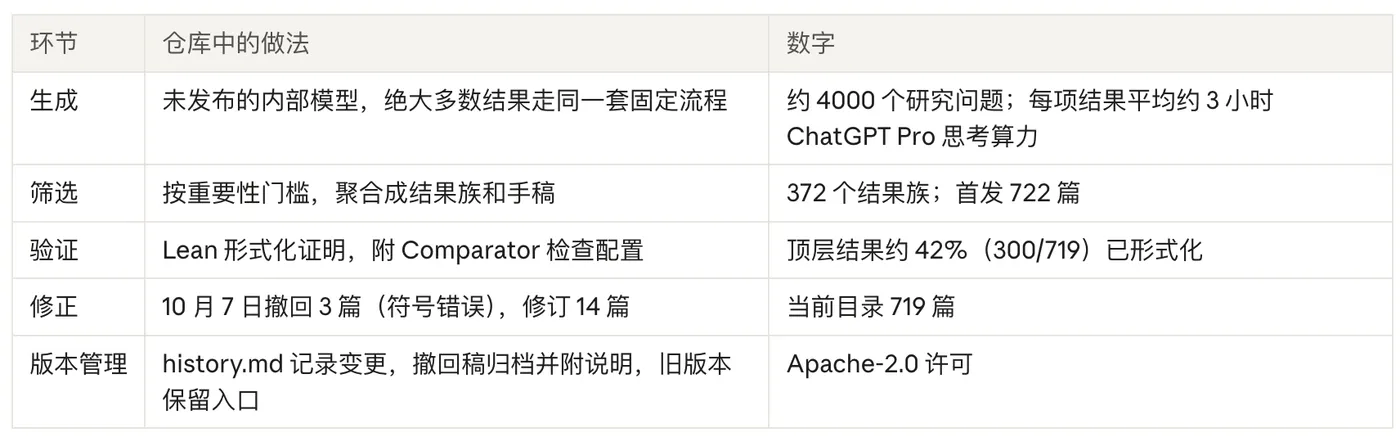
从约 4000 个问题,到 372 个结果族、722 篇手稿,再到撤回后的 719 篇,最后到约 42% 的顶层结果已形式化,漏斗逐级收窄。最后一级决定了有多少产出可以不经人工审阅而被信任。
二、四项可迁移的设计
验证预算先于生成规模确定。 筛选发生在验证之前,验证只覆盖了其中一部分。用大模型批量生成代码时同理:测试、类型检查和静态分析能覆盖多少,决定了可以自动合入多少。覆盖率应作为流水线的设计参数,而不是事后统计的结果。
产物按验证状态分级标注。 README 明确说明,收录的结果处于不同的验证阶段,未形式化的部分可能存在问题。有 Lean 证明的和没有的,在目录中可以区分。企业内部的 AI 产出物,也应在元数据中标明哪些通过了自动化校验,哪些仅经过抽检或尚未审阅。
撤回要连带处理依赖。 本次撤回起于一篇论文中的符号错误,两篇依赖它的论文一并撤回;另有 13 篇因配套论文修订而更新了引用。一个产出出错,需要沿依赖关系定位下游,这和发布了有缺陷的内部库后的处理流程相同。
历史版本保持可追溯。 仓库声明保留公开发布历史,被撤回的论文归档并附说明,更新的论文保留旧版本入口。对需要审计的场景,这一点和验证本身同样重要。
三、迁移到企业场景的检查清单
- 产出物中,有多大比例具备机器可判定的正确性标准?
- 未覆盖的部分由谁审阅,审阅能力是否随产出量扩展?
- 单个产出被撤回时,能否自动定位依赖它的下游?
- 历史版本和撤回原因是否可追溯?
- 全量验证本身的成本是否已计入?该仓库的 Lean 库体量很大,其 README 建议一次只编译一小部分。
四、说明
事实部分来自仓库 README、history.md 与公开报道。关于“核验成本不随生成成本同步下降”的判断是作者推断,不是仓库给出的数据。
需要补充的是,数学证明有形式系统可以机器判定,企业的 AI 产出物大多没有这样的正确性标准,因此上述设计只能部分迁移。



