用 TypeSafe Jev 的 Choice / Noul / Score 三种判断原语,给低代码平台收到的漏洞报告做一次真实的自动初筛
为什么要"实战"一次
Jev 已经全面开放,不用再排 waitlist,控制台入口是 https://console.typesafe.ai 。需要说明的是,早期的新用户赠送额度已经取消:现在注册免费,但申请 API Key 必须先绑定支付方式,支持中国大陆、美国等地发行的 Visa 信用卡,绑定后支付 25 美元才能生成 Key。
关于 Jev 是什么、怎么装进 Coding Agent,网上的介绍已经不少。但一个"只做判断、不生成内容"的模型到底好不好用,光看介绍很难有体感。所以这篇换个方式:拿一个真实的业务场景——JeecgBoot 低代码平台的漏洞报告初筛——从设计问题、写代码、跑数据到看结果完整走一遍,所有数字都来自实际调用。最后再把 Jev 装进 Claude Code 和 Codex,看它在 Coding Agent 里怎么用。
先用一句话说清 Jev 的定位:它读懂自然语言和业务状态后,返回带类型的答案和概率,而不是一段文字。流程由代码掌控,Jev 只在代码需要"读懂意思"的地方给出判断。
准备工作:Key、价格和第一个请求
申请 API Key
打开 API keys 页面,点右上角 Create key:
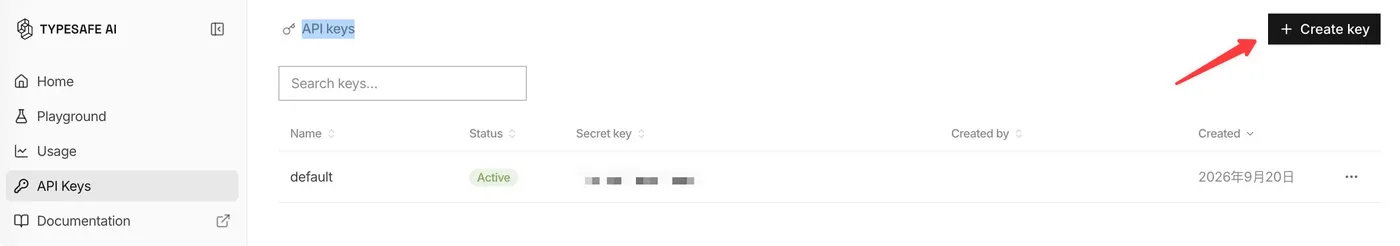
注意:点击 Create key 前需要先绑定信用卡并完成 25 美元的支付,否则无法生成 Key。拿到 Key 后配置成本地环境变量 TYPESAFE_API_KEY,后面的 curl、Python 脚本和 Coding Agent 都直接读这个变量,Key 不会出现在代码和提示词里。
价格:输出免费,输入极便宜
Jev 不是免费模型,但成本比其他模型低 40~400 倍,而且输出侧不收费。
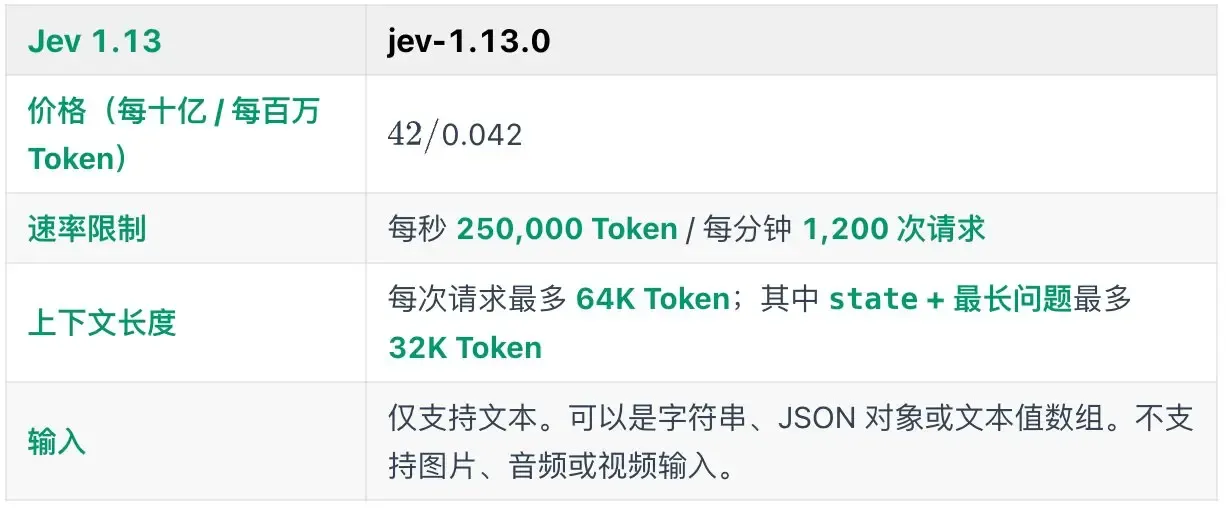
当前版本 jev-1.13.0,每十亿 / 每百万 Token 价格为 42 / 0.042(美元);速率限制每秒 250,000 Token、每分钟 1,200 次请求;单次请求最多 64K Token(state + 最长问题不超过 32K);输入只支持文本,不支持图片、音频和视频。
热身:用 curl 跑通链路
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'EOF'
  {
    "state": "我的 Claude 账号被封号了,一直没有解封,用不了,麻烦帮我看下",
    "model": "jev-latest",
    "questions": {
      "urgency": {
        "type": "noul",
        "instructions": "这个问题和登录有关系吗?"
      }
    }
  }
EOF
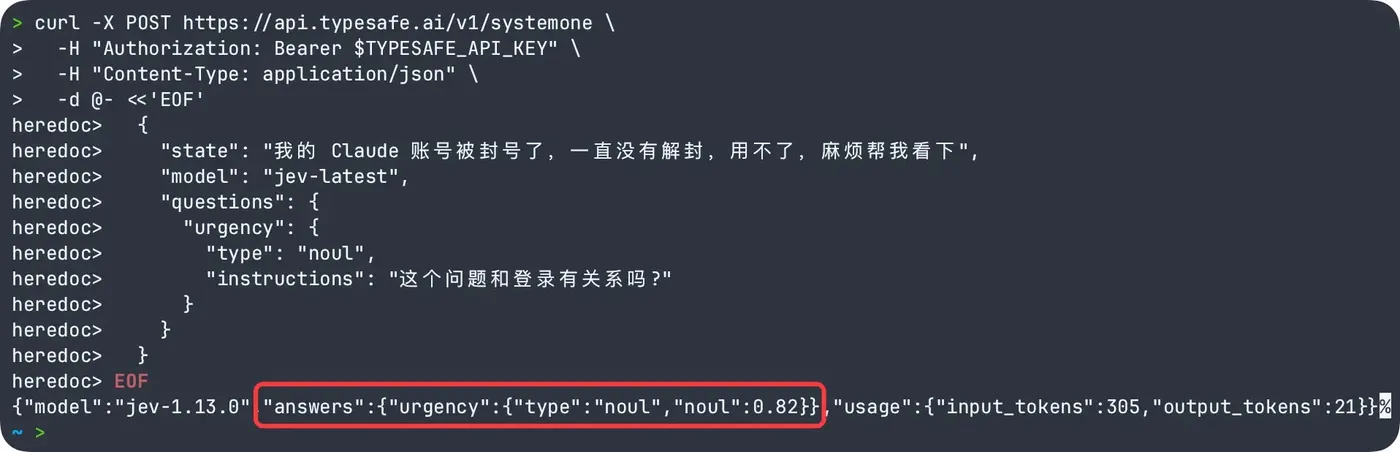
返回 "noul": 0.82,即"和登录有关"的概率是 82%。链路通了,下面进入正题。
实战一:用 Jev 给漏洞报告做初筛
场景:安全报告越来越多,真假难辨
最近针对开源系统的攻击越来越频繁,JeecgBoot 这类被大量企业部署的低代码平台,收到的漏洞报告也越来越多:有白帽子提交的高危漏洞,有扫描器自动生成的"缺少某个响应头",也有用户把正常机制当成漏洞的误报。安全团队要逐份研判:算不算漏洞、危害多大、能不能复现,真正的高危报告一旦被淹没在噪音里,后果很严重。
这正适合交给 Jev 做初筛。我设计了 4 个判断:
| 问题 ID | 类型 | 判断什么 |
|---|---|---|
verdict |
Choice | 定性:可利用的漏洞 / 加固建议 / 按设计工作 / 只影响自己 |
vuln_type |
Choice | 类型:RCE / SQL 注入 / 越权 / XSS / 信息泄露 / 其他 |
severity |
Score | 危害:无 / 低 / 中 / 高 / 严重(0~4) |
has_poc |
Noul | 是否给出版本、接口或验证结果,足以复现 |
代码
问题定义如下,每份报告作为 state 发一次请求,4 个问题并行执行,多份报告再用线程池并发(请求函数与普通 HTTP 调用无异,model 填 jev-latest):
QUESTIONS = {

    "verdict": {

        "type": "choice",
        "instructions": "假设报告所述现象属实,应如何定性?",
        "criteria": {

            "vuln": "可被利用的安全漏洞:攻击者能借此越权、获取或篡改他人数据、执行代码或控制服务器",
            "hardening": "安全加固建议:扫描器提示的缺失配置等,本身不能直接被利用",
            "by_design": "系统按设计正常工作:例如持有合法凭证就能访问,不算漏洞",
            "self_only": "只能影响报告者自己,无法危害其他用户"
        }
    },
    "vuln_type": {

        "type": "choice",
        "instructions": "这份报告属于哪类安全问题?",
        "criteria": {

            "rce": "远程代码执行,包括模板注入、JDBC 等导致执行系统命令",
            "sqli": "SQL 注入",
            "access": "越权或未授权访问,能访问、修改他人数据或受保护接口",
            "xss": "跨站脚本",
            "info_leak": "信息泄露,如用户名枚举、敏感信息暴露",
            "other": "其他类型的安全问题"
        }
    },
    "severity": {

        "type": "score",
        "instructions": "如果属实,这个问题对使用 JeecgBoot 的企业危害有多大?",
        "criteria": [
            "无危害:不构成安全风险",
            "低危:需要特殊条件,只泄露少量非敏感信息",
            "中危:可获取部分敏感信息或需要一定权限才能利用",
            "高危:普通用户即可越权访问或篡改大量数据",
            "严重:未登录即可控制服务器或拿到整库数据"
        ]
    },
    "has_poc": {

        "type": "noul",
        "instructions": "报告是否给出了受影响的版本、接口或已经实际验证过的结果,足以让开发者复现?"
    }
}
Jev 只负责判断,怎么处置由代码决定:
def route(a):
    v = a["verdict"]["probabilities"]["vuln"]
    sev, poc = a["severity"]["score"], a["has_poc"]["noul"]
    if v < 0.5:
        return "非漏洞:回复说明后关闭"
    if v < 0.8:
        return "定性不明:安全组人工复核"
    level = "P0" if sev >= 3.5 else "P1" if sev >= 2.5 else "P2" if sev >= 1.5 else "P3"
    if level in ("P0", "P1") and poc < 0.5:
        return level + ":未验证,安全组先复现"
    return {
   "P0": "P0:应急响应,发安全补丁", "P1": "P1:尽快修复",
            "P2": "P2:低危,排期修复", "P3": "P3:记录备查"}[level]
问题怎么问,结果差很多
这组问题不是一次写对的,前两版都踩了坑:
- 第一版用 Noul 问"是否真实存在可利用的漏洞"。Jev 会顾虑"报告是否可信",明显的越权漏洞只给了 0.53;
- 第二版改成"假设属实,是否构成漏洞",又走到另一头:连"缺少响应头"、"token 换台电脑能用"都给了 0.78 左右;
- 第三版把"是不是漏洞"改成 Choice,列出漏洞、加固建议、按设计工作、只影响自己四种定性让它比较,结果才清晰。
Jev 文档里也有类似建议:多个互斥结论之间的比较用 Choice,Noul 适合单一条件。
实测结果
8 份测试报告(真实漏洞、扫描器提示和误报都有):
- 积木报表的模板预览接口不需要登录就能访问,传入的模板内容会被 FreeMarker 解析,我在测试环境验证过可以执行系统命令。版本 JimuReport 1.6.x。
- 字典模块有个查询接口,表名和字段参数直接拼进 SQL,参数里加单引号就报 SQL 语法错误,普通用户登录后即可触发。版本 JeecgBoot 3.5.3。
- 扫描器报告:响应头缺少 X-Frame-Options 和 Content-Security-Policy,存在点击劫持风险。
- 登录接口对“用户名不存在”和“密码错误”返回不同提示,可以据此枚举系统里有哪些用户名。
- 我把 admin 登录后的 token 复制到另一台电脑的浏览器里也能用,这算不算会话劫持漏洞?
- 普通用户把个人信息接口请求里的 userId 改成别人的,就能查看和修改其他用户的资料,包括手机号和邮箱。版本 3.7.0。
- 在自己的个人签名里写一段 script 标签,保存后刷新只有自己的页面会弹窗,其他人看不到签名。
- 数据源管理的“测试连接”功能允许管理员填写任意 JDBC URL,听说某些驱动参数能导致远程代码执行,我没有实际验证过。
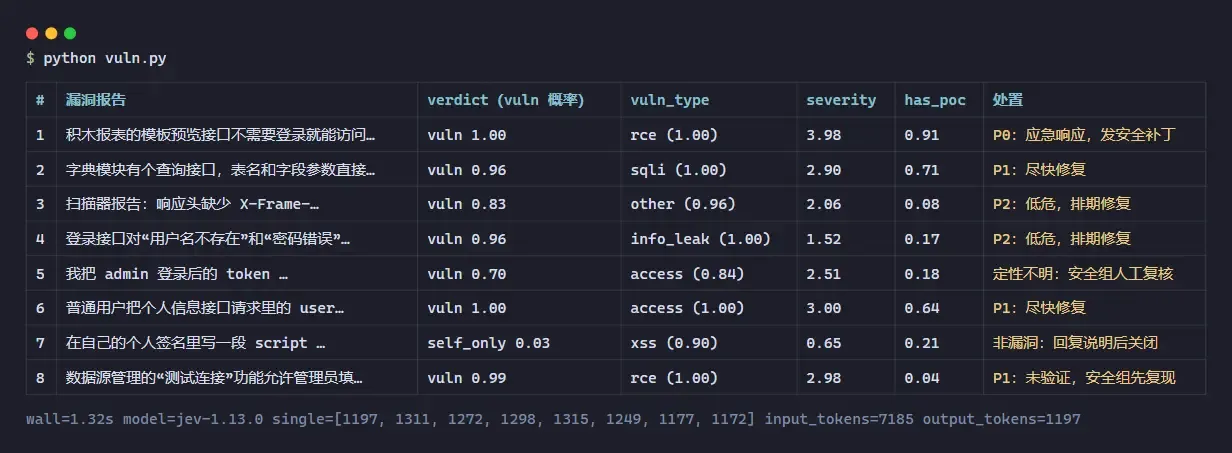
8 份并发跑完 1.3 秒:
- 高危都被挑了出来:第 1 条未登录模板注入判为严重(3.98),直接进 P0 应急;第 2 条 SQL 注入、第 6 条越权判为高危,进 P1;
- 没验证的高危不放过:第 8 条"测试连接"可导致 RCE,危害判为高危,但
has_poc只有 0.04,路由到"安全组先复现",而不是退回给报告者; - 低危有分寸:第 3 条缺少响应头、第 4 条用户名枚举,Jev 认为是真问题但危害低(2.06、1.52),进 P2 排期;
- 拿不准的交给人:第 5 条 token 换设备可用,
vuln0.70、by_design0.29,落在人工复核区间; - 误报被关闭:第 7 条只能弹自己的窗,判为
self_only。
需要强调的是,Jev 做的是初筛和排序,不能替代安全人员的复现和修复,P0、P1 仍然要人来确认。另外报告是外部提交的不可信文本,Jev 只返回固定类型的选项和概率,最多影响一个分值,不会被文本"指挥"去执行操作,这一点比让大模型自由生成处置意见更可控。
成本
平均每份输入约 900 Token,输出不计费。按每百万 Token 0.042 美元算,单份约 0.00004 美元,1 万份约 0.38 美元,25 美元大约能跑 66 万份。
实战二:把 Jev 装进 Claude Code 和 Codex
写代码调 API 适合固化成业务功能;日常开发中,更方便的方式是让 Coding Agent 直接调用 Jev。官方提供了即插即用的 Skill:
它打包了 TypeSafe API 的完整上下文,包括三种问题类型、架构模式和组织评估的最佳实践,可用于 Claude Code、Codex 以及其他支持 Skills 的 Coding Agent。
Claude Code:安装与调用
在终端执行两行命令:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
调用方式有两种:对话里直接说"使用 TypeSafe 技能……",或者用斜杠命令 /typesafe:typesafe-ai 主动触发。先试一个生活化的问题:
/typesafe:typesafe-ai Mac mini 我有必要买吗?请直接给判断
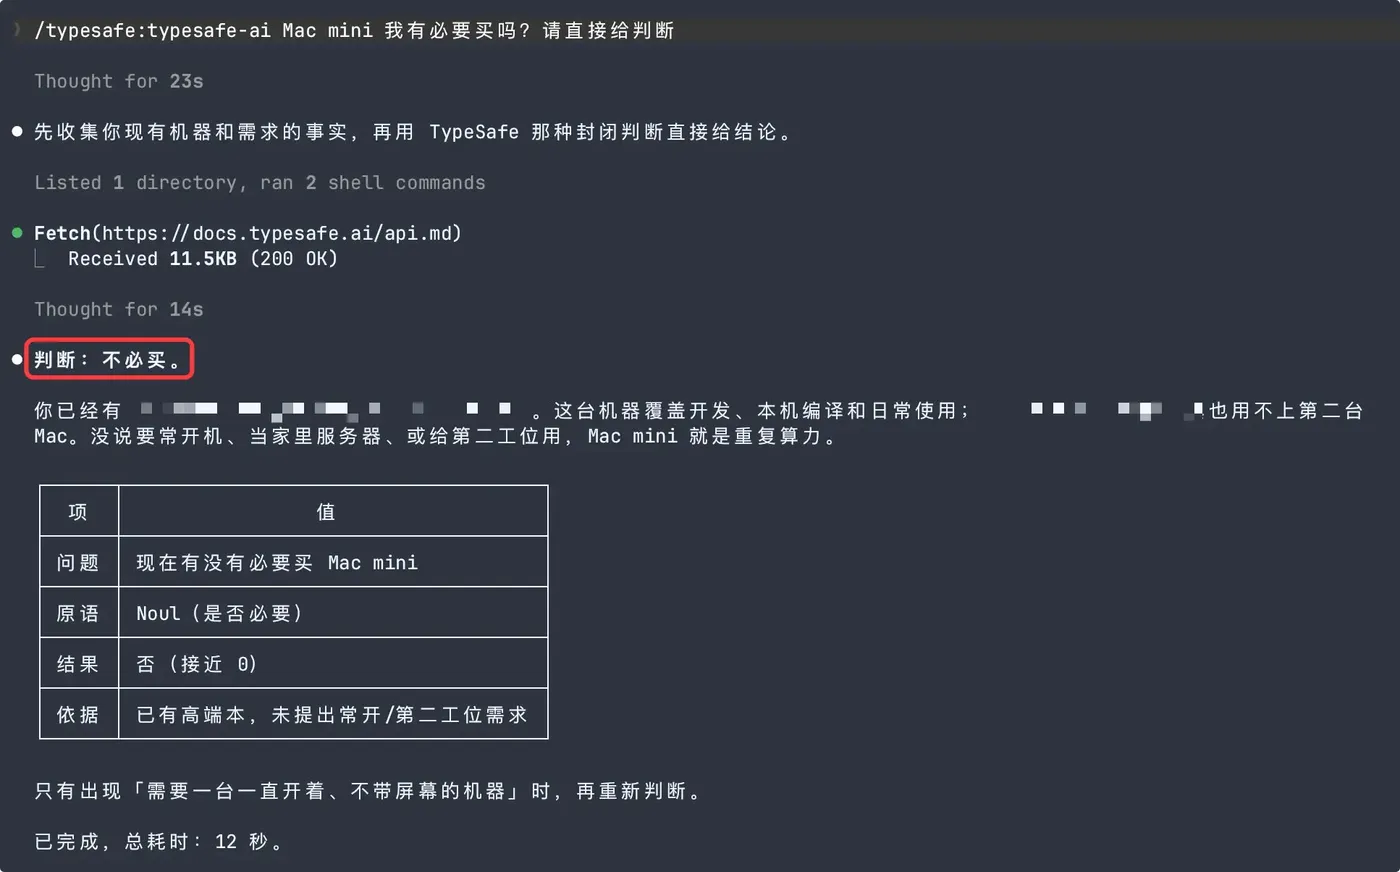
12 秒出结果:现在的 Mac mini 不该买。Claude Code 先收集了本机的设备情况,再用 Noul(是否必要)给出封闭判断,并附上依据。
再试一个开发场景,让它审视整个项目:
/typesafe:typesafe-ai 分析下这个项目,判断有哪些可替代复杂的逻辑或弱代码。
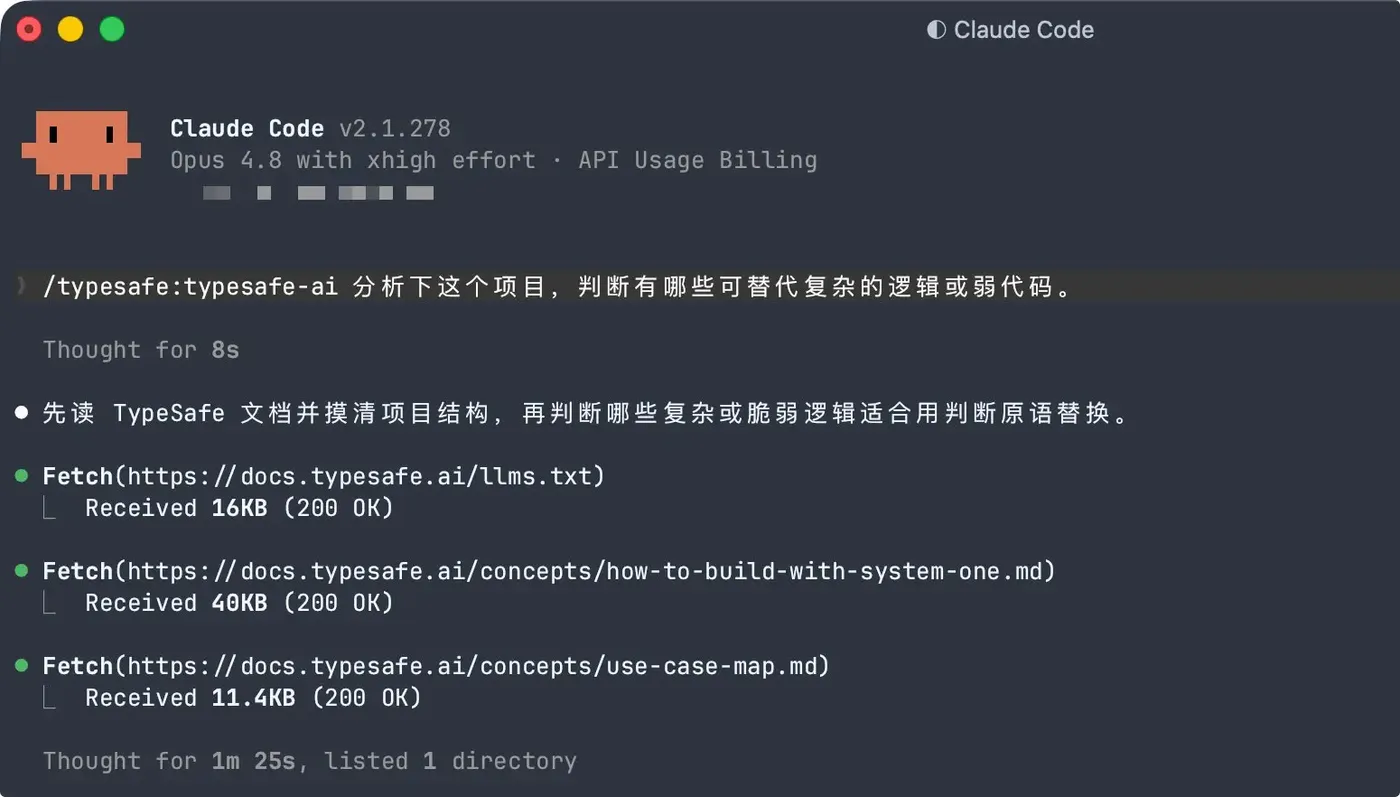
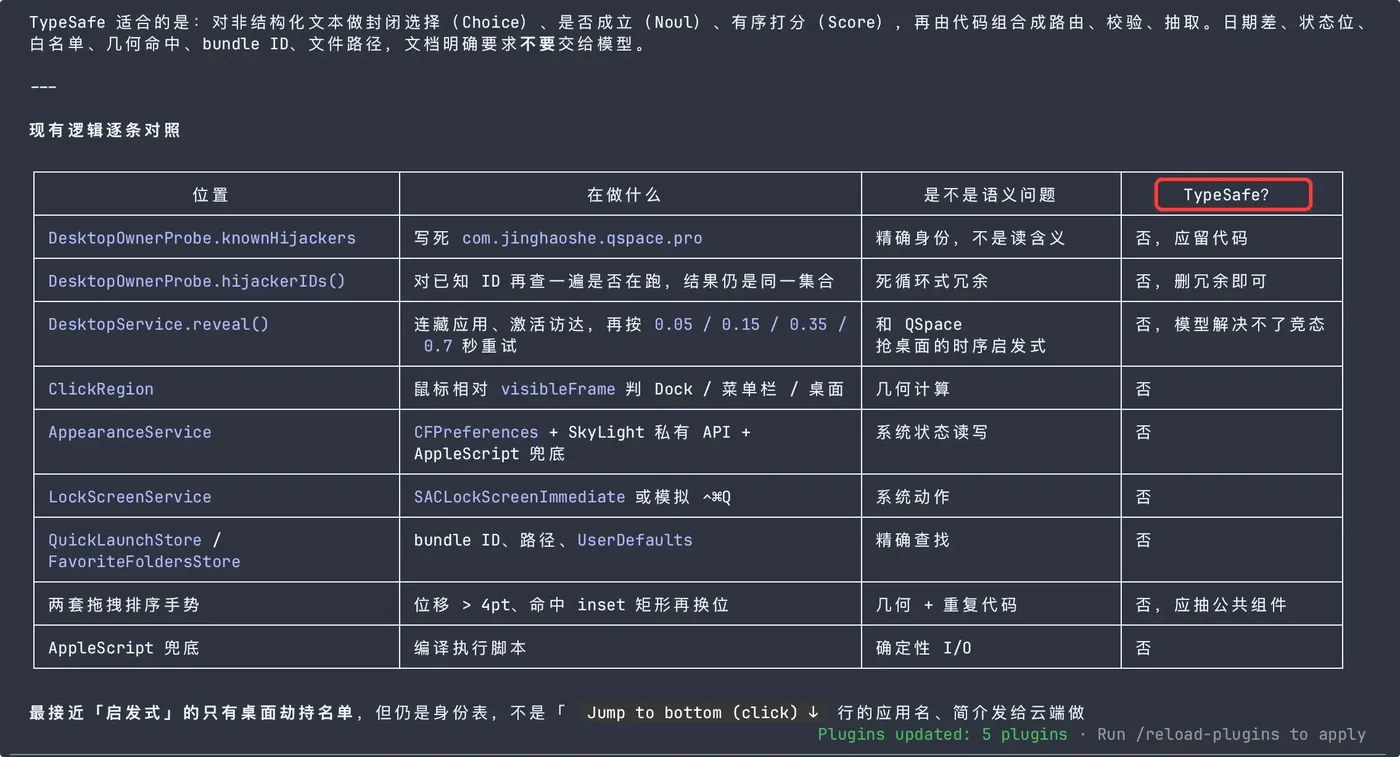
输出里多了一列 TypeSafe?,逐条说明哪些代码该删除、哪些该保留、哪些该抽成公共组件。TypeSafe 只给判断,改代码仍是 Claude Code 的事。
这也体现了 Jev 的定位:日期差、状态位、白名单、几何命中、bundle ID、文件路径这类确定性逻辑,不该交给模型;适合 Jev 的是对非结构化文本做封闭选择、是否成立、有序打分,再由代码组合成路由、校验和抽取。
更新插件(仅适用于 Claude Code 插件方式安装):
claude plugin marketplace update typesafe-ai
claude plugin update typesafe@typesafe-ai
更新后重启 Claude Code 或运行 /reload-plugins。想自动更新的话,打开 /plugin,依次选择 Marketplaces → typesafe-ai → 启用自动更新。
Codex 等其他工具:安装与调用
npx skills add typesafe-ai/skills --skill typesafe-ai
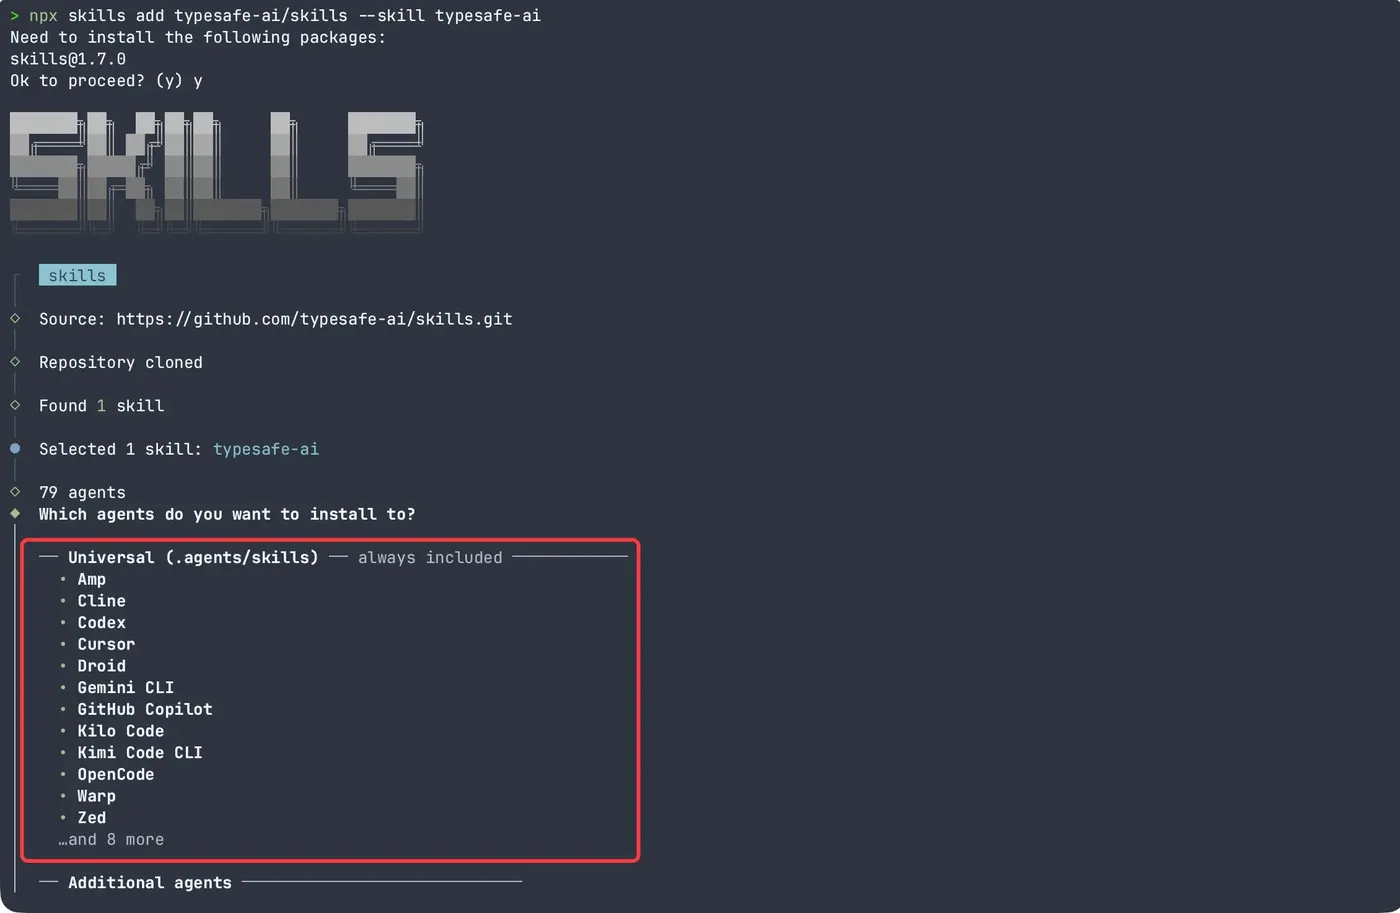
默认会包含 Codex、Cursor、Gemini CLI、OpenCode 等主流 Coding Agent,也可以额外勾选其他 Agent,回车完成安装。
在 Codex 里输入 /Typesafe,技能会自动弹出:
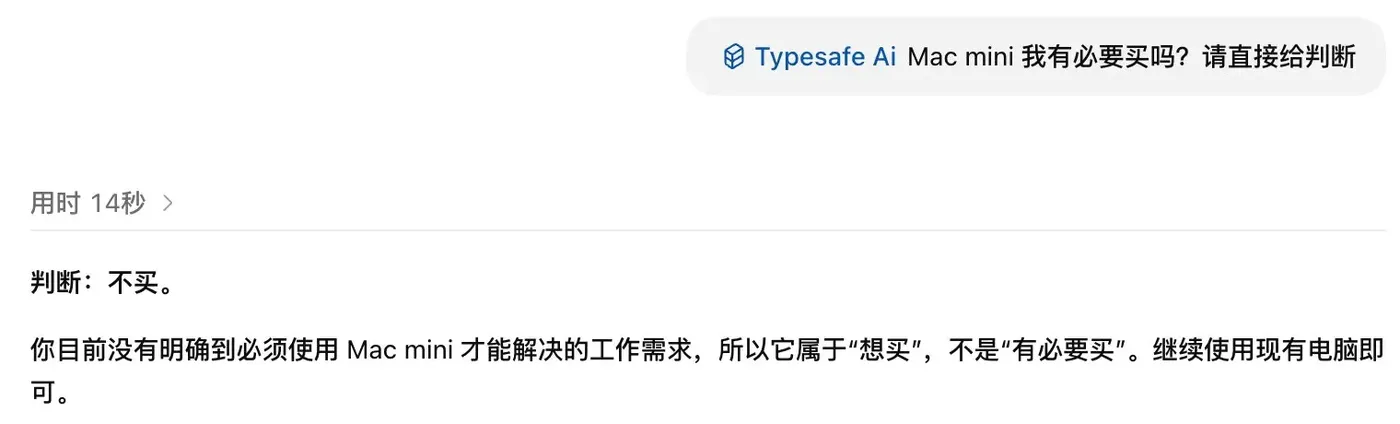
同样问"Mac mini 我有必要买吗",14 秒给出结论,和 Claude Code 一致:
更新方面:用 skills.sh 安装的,运行 npx skills update 即可;手动复制的 Skill,用 GitHub 最新版本替换整个 skill 目录。
一句提示词自动安装
不想记命令,可以把下面这段提示词整段复制,发给任何支持 Skills 的 Coding Agent,它会根据自身环境自动选择安装方式:
安装 TypeSafe 技能,请使用以下其中一种方式:

- 如果你在 Claude Code 中,请依次运行:
  claude plugin marketplace add typesafe-ai/skills
  claude plugin install typesafe@typesafe-ai
- 如果你在其他 Coding Agent 中,请运行下面的命令并选择你的 Coding Agent:
  npx skills add typesafe-ai/skills --skill typesafe-ai

技能说明文档:
https://github.com/typesafe-ai/skills/blob/main/skills/typesafe-ai/SKILL.md
原始版本:
https://raw.githubusercontent.com/typesafe-ai/skills/main/skills/typesafe-ai/SKILL.md

安装完成后,在开发此项目时即可使用 TypeSafe 技能。
Jev 适合用在哪里
凡是"需要读懂一段文字,但最终只要一个有限答案"的环节,都可以考虑交给 Jev。结合 JeecgBoot 这类低代码平台,比较值得尝试的有:
| 场景 | 怎么用 | 原语 |
|---|---|---|
| 安全报告、工单初筛 | 定性、分类、评危害,按结果分派和排优先级 | Choice + Score |
| 规则引擎、AI 流程编排 | 作为流程里的判断节点:把"申请内容是否涉及退款""属于哪类业务"这类语义条件交给 Jev,分支走向和阈值仍由规则配置,比让大模型输出文字再解析更稳定 | Choice + Noul |
| AI 助手意图路由 | 判断用户一句话该走"建表""查数据"还是"生成报表",再由代码调用对应接口 | Choice |
| 审批预审 | 报销说明和费用类别是否一致、请假理由是否充分,不通过的先打回补充 | Noul |
| 在线考试、答题 | 判断英语单词"会与不会":学生写 abandon 是"丢下不管",和标准答案"放弃"字面不同,Jev 仍判为会(实测 0.95);把 affect 写成"效果"(混成 effect)判为不会(0.14)。简答题可按要点逐条判断是否答到 | Noul + Score |
| 内容审核 | 评论、表单提交内容是否违规或含敏感信息 | Noul |
| 打分排名 | 比如新能源汽车排名:Jev 按续航、智驾、性价比分别给每款车的车主评价打分,代码再加权排序。实测 4 款车型,看重智驾时 B 排第二,改成看重续航后 C 升到第二,调权重不用重新调用 Jev | Score |
| 知识库检索重排 | 给检索到的片段打相关度分,只把高分片段交给大模型 | Score |
| 历史数据打标签 | 对存量的工单、客户留言批量分类,成本低到可以全量跑 | Choice |
不适合的情况也很明确:要生成文字或代码的、能用代码精确计算的(版本比较、日期、白名单)、需要多步推理的复杂决策,以及图片输入(目前只支持文本)。
用好它有三点:互斥结论用 Choice,单一条件用 Noul;同一份数据的多个问题放进一个请求,并行执行不增加耗时;阈值用自己的数据调,中间地带留给人工。
总结
Jev 更像一个可以直接写进 if 里的"语义函数":8 份漏洞报告 1.3 秒初筛完,每份约 0.00004 美元,返回的是代码能直接消费的概率。它最适合两种用法:一是固化进业务流程,替代"只能靠人读一遍"的环节;二是配合 Claude Code、Codex,Agent 负责干活,Jev 负责判断。
相关地址:
- TypeSafe 控制台:https://console.typesafe.ai
- 官方 Skills 仓库:https://github.com/typesafe-ai/skills
- API 文档:https://docs.typesafe.ai/api
本文为 JeecgBoot AI 专题研究系列文章。