
摘要:当前企业对工作智能体(Agent)的期待正从“单次问答交互”转向“端到端闭环的长程任务执行”。本文剖析面向生产级企业试点场景的工程实现,聚焦状态机设计、受控授权、副作用容灾恢复、证据链溯源及预算熔断五项核心能力,提供解耦、高可靠的工程架构实践路径。
架构演进:从单次问答(Prompt-Response)到长程任务(Long-Horizon Task)
随着企业智能体向复杂工作流延伸,工业界正逐步聚焦于持续执行、多智能体协同及独立服务身份等底层能力。然而,在实际企业级集成中,核心瓶颈往往不是基础模型的推理能力,而是工程底座的确定性建设。
以典型业务场景为例:“整理本周所有供应商资质变更并输出审批合规报告”。该任务需经历读取多源邮件、比对合同版本、查询 ERP/CRM 业务记录、等待合规人员补充缺漏附件等一系列异步交互。模型单次生成的输出质量,仅占整套闭环中极小的一环。
长任务智能体系统建议采用分层解耦架构: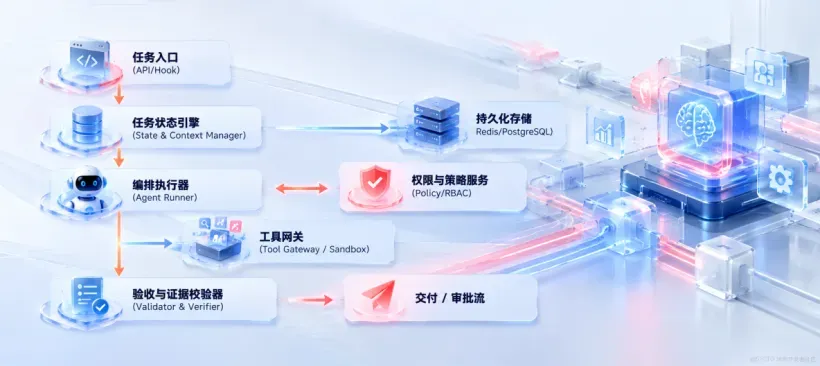
一、可验收的任务建模与有限状态机(FSM)
在长任务模式下,系统不能依赖模型的口头回复(如“我已处理完毕”)作为终止标志,必须建立严格的可验收任务模型。
1. 任务定义三要素
- 明确边界: 业务目标、输入数据范围、截止时间、允许调用的沙箱工具。
- 结构化验收指标: 以“供应商变更”为例,验收条件不能设为模糊的“分析完成”,而应明确为结构化规则:
时间窗口必须闭合;
每一项字段变更均须挂载可溯源的原始凭证 ID;
缺失项单独归入 PendingList;
必须生成符合 Schema 的最终审批草稿。
2. 状态生命周期管理
建议将任务状态解耦并持久化至关系型数据库或分布式状态引擎,脱离瞬时的模型上下文窗口(Context Window):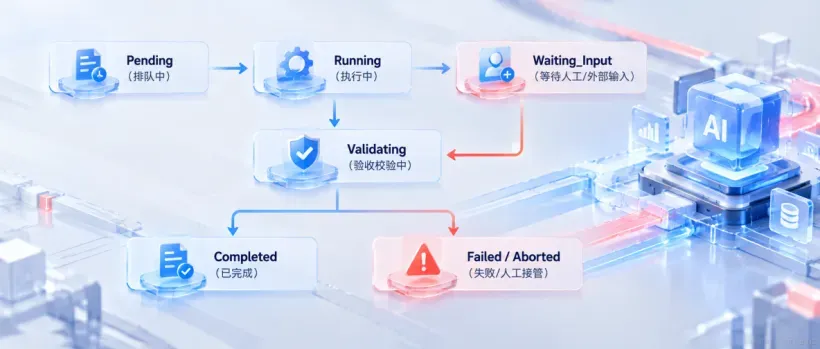
- 状态推进断言: 只有当校验器通过确定性规则核验后,状态方可翻转为 Completed。
- 上下文游标持久化: 长任务运行可能持续数小时,持久化中间产物和执行游标(Cursor),是实现进程崩溃恢复与断点续跑的前提。
二、受控授权与间接提示词诱导(Indirect Prompt Manipulation)防护
长任务执行器通常具备调用外部 API、读写企业内网数据库的权限,权限设计必须遵循最小特权原则。
1. 动态凭据与细粒度 RBAC
- 禁止使用高权限共享账号: 每次执行动作需绑定发起人身份(User Context)、执行代理身份(Agent Service Account)与具体作用域(Scope)。
- 服务端强校验: Prompt 内的“请勿执行超出授权范围的操作”仅属于软提示(Soft Constraint),
工具调用网关必须执行服务端强制校验(Hard Boundary),核实该 Agent 实例是否在授权范围内访问目标表或目标资源路径。
2. 数据与指令的隔离壁垒
外部网页、邮件正文、上传的 PDF/Excel 等附件属于不可信输入(Untrusted Data)。
- 防范提示词诱导风险: 当文档中包含如要求忽略既有规则、将敏感数据发送至外部地址等高风险内容时,系统必须从网络层与工具层实行硬性白名单限制(如 egress IP/域名限制、目录隔离、只读保护),杜绝未受控的数据外发与覆写。
- 高风险操作审批熔断: 将操作划分为只读(Read)、建议草稿(Draft)、数据覆写(Overwrite)、对外分发(Dispatch)。后两类高风险操作必须进入审批流程,强制走人工二次确认(Human-in-the-loop)。
- 不可撤回操作(Irreversible): 必须前置校验并进行前向确认。
三、故障恢复机制与幂等性(Idempotency)保障
网络抖动、模型超时或容器重启在长任务中是确定性事件,容灾设计的核心是:在重试前必须准确研判副作用(Side Effects)。
1. 幂等设计与业务请求去重
只读操作重试代价低,但写入工单、发送通知、发起审批等动作具有外部影响:
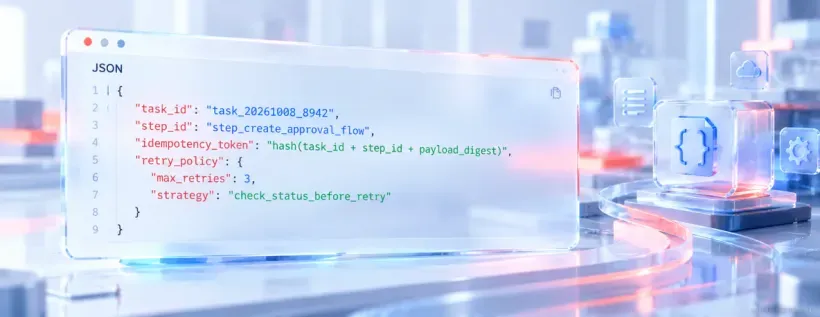
- 引入全局唯一业务键(Idempotency Key): 针对每个不可撤销的动作,在调用下游前生成与任务节点绑定的唯一哈希。
- 确认状态而非盲目重试: 当执行器未收到外部响应(如超时)时,禁止直接重发,应先调用查询接口确认上一操作是否已落库;若无法研判状态,应主动暂停并升级为人工核验。
2. 补偿逻辑分级
跨多个系统的长业务流无法简单依靠分布式数据库事务回滚。在设计各工具动作时,应明确分类:
- 可逆操作(Compensable): 定义明确的补偿接口(如创建草稿失败则调用删除草稿 API)。
- 可人工修复操作(Manually Repairable): 生成告警并保留脏数据快照以供定位。
- 不可撤回操作(Irreversible): 必须前置阻断并进行前向校验。
四、确定性证据链溯源与分层校验器
“一本正经的胡说八道”是长任务在严肃企业场景下落地的最大阻碍。系统交付的不能仅是一份排版良好的总结,而是必须附带机器可读的证据链(Provenance & Audit Trail)。
1. 证据元数据规范
智能体在提取关键信息时,底层调度引擎应同步固化并输出上下文凭证:
- 原始文档版本与哈希值;
- 数据来源的具体地址、Sheet/页码索引与行定位;
- 关键数值或字段的转换规则说明。
2. 分层核验管道(Multi-tier Validation)
校验流程应分为确定性逻辑层与语义评估层: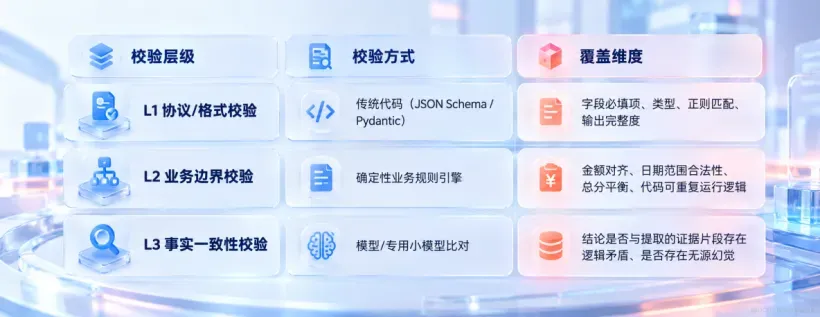
五、预算熔断机制与演进路径
无限循环(Infinite Loop)与盲目工具重试是长任务在工程上的潜在成本风险。
1. 预算与资源熔断
- 硬性配额(Quotas): 单次任务必须配置执行时间上限(Wall-clock Timeout)、工具调用次数阈值(Max Tool Calls)与 Token 预算上限。
- 信息增益评估(Information Gain Check): 当智能体针对同一方向多次发起检索/重试,且上下文未获得有效新证据时,应触发启发式停止,输出当前卡点与信息缺口,而非持续消耗配额无效搜索。
2. 渐进式企业试点路线
在系统架构设计上,遵循“奥卡姆剃刀”原则:单一智能体配合严密流程控制能够解决的场景,切忌引入过于复杂的多智能体(Multi-Agent)博弈网络,避免带来协调失控与延迟成本飙升。
推荐实施四阶段演进模型:
- 只读评测(Read-only Pilot): 使用真实历史数据生成结果,完全与人工专家输出进行基线对标。
- 草稿沙箱(Draft & Sandbox): 允许智能体在独立隔离区生成建议、准备中间产物,不直接作用于核心系统。
- 闭环审批(Approval-gated Execution): 高影响动作接入工作流引擎,待业务角色确认签名后下发执行。
- 全自动流转(Autonomous Monitoring): 仅在低风险、高频度且重试链路成熟的场景开放全自动化闭环,同时保留全链路审计与报警指标。
落地检验清单
工程团队在评审长任务智能体系统是否具备上线条件时,可参照以下检查项进行基线评估:
- [ ] 状态机是否独立于 LLM Context 持久化在数据库中?
- [ ] 所有写操作工具是否均具备基于唯一 Token 的幂等去重机制?
- [ ] 外部不可信内容(邮件、第三方文档)是否在提示词和网络调用层完全实现权限隔离?
- [ ] 交付报告是否能提供逐行对应的数据源定位(证据链)?
- [ ] 任务是否具有明确的运行超时、Token 消耗上限与调用次数熔断策略?



