一个协议装不下:语义寻址与信任证明为什么分成两个 scheme

简介: Agent 跨域互调,要同时解决「找到谁、做什么」与「谁授权、凭什么」。本文盘点现有协议栈的缺口——DNS+CA 在线双问、OAuth 回 IdP、DID 解析回网、MCP 不管身份语义——论证语义寻址(锚在哈希)与信任证明(锚在密钥)因信任锚不同源,无法装进同一个 scheme;并给出落地形态:一份合并草案、两个 scheme,在字节层共享同一 16 字节分片完成闭环。

合并规范:draft-li-rttp-iqa-addressing(IETF 独立提交通道审核中)· 其中 rttp:// 已获 IANA 注册(Provisional · CRI 27)

当 Agent 开始跨域互相调用,它需要两样东西:一个语义寻址方案(把「我要对谁、做什么」变成可解析的地址),和一个信任证明方案(把「谁、在什么地位下、凭什么授权」变成可验证的证据)。现在的协议栈里,这两样东西各有残缺;而把它们硬塞进同一个协议,代价比想象的大。本文解释为什么最终形态是一个草案、两个 scheme。

一、现实协议栈的缺口

  • DNS + CA:域名寻址靠 DNS,身份绑定靠 CA 签发的证书。验证一次链路,要在线询问两套权威设施;信任锚是 CA 体系本身;
  • OAuth / OIDC:授权语义完整,但每次校验都回 IdP(身份提供方)——freshness 与撤销永远在线;
  • DID / VC(W3C 路线):身份可自主生成,但 DID 解析回网(registry / DID method)、VC 的有效性核验同样依赖在线端点;
  • MCP:把工具调用标准化了——但身份、授权状态、执行证据不属于它的语义范围。

把这张清单放在一起看:寻址与证明被混在各种协议里,却从未被当作两个独立问题分别给出离线解。Agent 跨域互调时,每一次「找到你、信你」都要在线回访某个第三方。

二、两层需求不同源:单协议硬装两层的代价

语义寻址层需要:确定性(同一权威永远同一地址)、离线性(无注册表解析)、无状态(不依赖发放机构)。它的信任锚是哈希函数本身——地址 = SHA-256(权威字符串)[:16],落地自证。

信任证明层需要:状态机(地位四态)、租约与撤销、防重放、签发与验证分离。它的信任锚是机构密钥——证明即签名事实。

两个信任锚不同源,这是本质约束。若强行写进一个 scheme:

  • 寻址格式被证明层的演进拖住(信封扩展要改版,地址语法也得跟着动——而地址已经写进别人的证据里,几乎不可改);
  • 评审与实现边界模糊:注册方、实施方要在一份混合语法里拆分两套语义;
  • 「只用寻址」的轻量场景被迫背上证明层的依赖。

三、两层如何咬合

分开定义,不等于互不相认。咬合点在字节层:寻址层派生的 16 字节分片(SHA-256[0:16]),被原样嵌入证明信封的主体分片字段。于是同一个 16 字节值,在寻址帧里是 ROUTE_SHARD(WHERE),在证明信封里是主体绑定(WHETHER)。验证方落地核对:分片对不上,任何一方作废;对上了,闭环不回网。
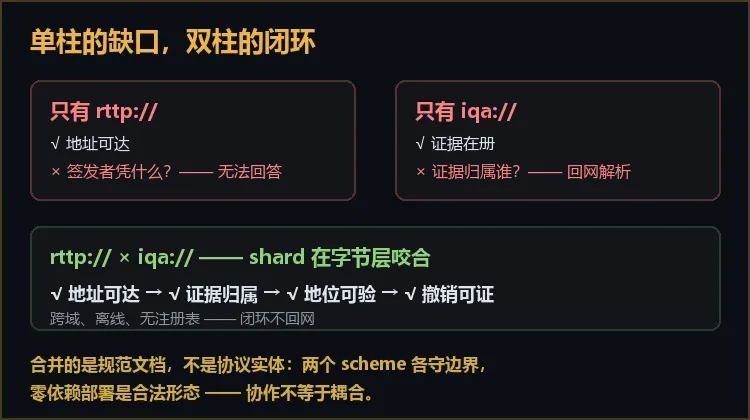
fig2-loop.png

四、落地形态:一个草案,两个 scheme

合并规范 draft-li-rttp-iqa-addressing 里,rttp:// 与 iqa:// 各自陈述语法与语义,共享同一套术语与测试向量。演进节奏解耦(寻址格式近乎冻结,信封可随部署迭代)、审阅边界清晰(注册方分开引用)、零依赖部署合法(纯寻址场景可只用 rttp://)。
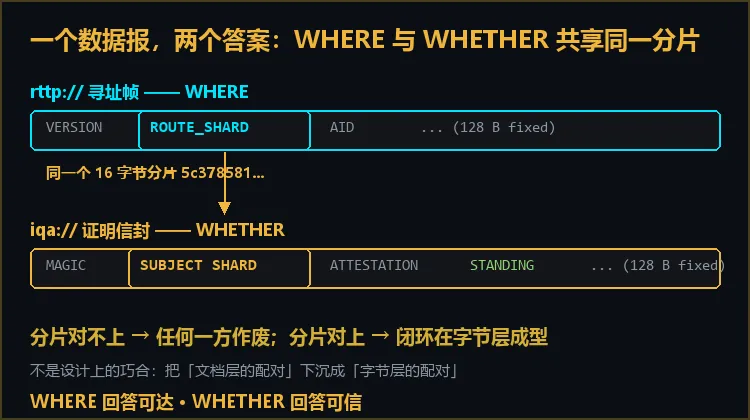
fig1-seam.png

五、诚实边界

本文不声称双柱方案解决了跨域信任的全部问题:委托链语义当前版本明确不规定;机构密钥的分发属于部署层决策;实时风控不在范围内——它只负责让「事后可证明」成为可能。

仓库:github.com/Aicent-Stack · 规范与证据链:iqa.org · 寻址柱官网:rttp.com

一句话:地址的锚是哈希,证据的锚是密钥——两个锚装不进一个协议,但可以装进同一份草案、咬合在同一组分片里。
目录
相关文章
|
1月前
|
网络协议 Java 测试技术
网站开发性能测试-JMeter 压测 Tomcat 接口的并发吞吐量(QPS)
在企业级网站开发、Java Web 系统上线与后端架构调优实战中,**性能压力测试(Stress / Load Testing)** 是验证系统高可用性、探测吞吐量极限与排除潜在并发死锁、内存泄露(Memory Leak)的必经之路。 对于采用 Apache Tomcat 作为 Servlet 容器的企业级应用(如 Spring Boot 内嵌 Tomcat 或独立 Tomcat 9/10 集群),单台服务器在面对每秒数百乃至数万次的高频请求时,其底层线程池调度、I/O 多路复用模型(NIO/NIO2)、JVM 垃圾回收机制以及操作系统内核 TCP 队列均会承受极限考验。
|
1天前
|
Java Go
一个公开挑战:任意语言、完全离线,跑不通算我们的
讲「可信 Agent」的文章很多,交出可证伪实物的很少。我们把协议规范冻结、35 个测试向量公开,并在记分牌上留了两个空位——独立实现数,rttp: 0,iqa: 0,作者自己的实现不算数。规则只有四条:只看规范、任意语言、完全离线、确定性。跑通全部向量,你的名字进规范记录;跑不通,那是我们的 bug,署名致谢并重新发布向量。横竖都是你赢。
53 1
一个公开挑战:任意语言、完全离线,跑不通算我们的
|
2天前
|
消息中间件 人工智能 监控
云栖剧透丨AI 应用进入生产,开始拼「实时数据智能」
9 月 22 日下午,欢迎来到杭州国际博览中心一期四楼 404 厅,与我们一起讨论实时数据智能如何支撑 AI 应用真正进入生产。
|
22天前
|
运维 网络性能优化 数据库
异地组网的带宽与时延如何估算?面向业务场景的链路规划方法
本文提供异地组网链路规划的实用方法论:以业务SLA为起点,通过业务画像分级→时延/带宽反推→冗余系数叠加→链路选型匹配四步法,解决视频卡顿、ERP慢等痛点。涵盖跨运营商暗线识别、时延四段拆解、三层带宽估算及常见失误避坑,助力IT负责人科学决策。(239字)
664 3
异地组网的带宽与时延如何估算?面向业务场景的链路规划方法
|
23天前
|
SQL 测试技术 数据库连接
我用ChatGPT把回归测试从3天压到3小时,提示词全公开
本文分享如何用ChatGPT优化电商后台回归测试:通过提示词引导,实现用例梳理、自动化脚本生成与日志分析三步提效,将3天人工测试压缩至3小时。强调其辅助定位而非替代人力,聚焦释放工程师精力于高价值工作。
|
22天前
|
机器学习/深度学习 算法 前端开发
发动机故障诊断智能体(二):基础时序压缩与长短期记忆编码网络
在智能体完成气路多航段时序数据的采集与规整后,高维度的原始时序信号需要经过深度表征与降维处理,以消除高频测量噪声并提炼本质物理趋势。采用长短期记忆自编码器架构,在脱离人工标签监督的情况下,利用海量正常运行数据进行自监督重构训练,构建出能够压缩并表征发动机稳态工况与退化趋势的时序特征提取模型。
|
18天前
|
云安全 人工智能 安全
|
24天前
|
存储 缓存 算法
AKF扩展立方体和AKF可用性立方体
很多人知道AKF扩展立方体是从《架构即未来》这本书开始。实际上akfpartners官方写过4篇关于AKF扩展立方体的文章,还有一篇介绍AKF可用性立方体。akfpartners官方在高可用、扩展性方面有很多专业技术文章,建议有空就翻翻看。
|
25天前
|
人工智能 自然语言处理 容灾
模型越接越多,管理越来越乱?LiteLLM 与 New API 到底该怎么选
当多模型接入导致API Key分散、额度难管、环境混乱时,LiteLLM与New API两类开源模型网关提供自建解决方案:LiteLLM侧重研发侧统一调用、路由容灾与成本管控,适合技术团队;New API聚焦多用户管理、令牌分发与运营看板,适合需API商业化或精细化运营的场景。二者均支持OpenAI兼容接口,可私有化部署,比OpenRouter更可控、更安全。(239字)
|
4月前
|
人工智能 自然语言处理 API
【Azure AI Search】 stopword 是什么,为什么它会影响搜索结果?
本文解析 Azure AI Search 中搜索 "in brief" 返回结果过多的问题,指出根源在于 analyzer 对停用词(如 "in")的处理差异:默认 `standard.lucene` 保留停用词导致泛匹配,而 `en.microsoft` 会过滤停用词,使结果更精准。关键在于根据业务语义选择合适 analyzer。
274 121