一、前言
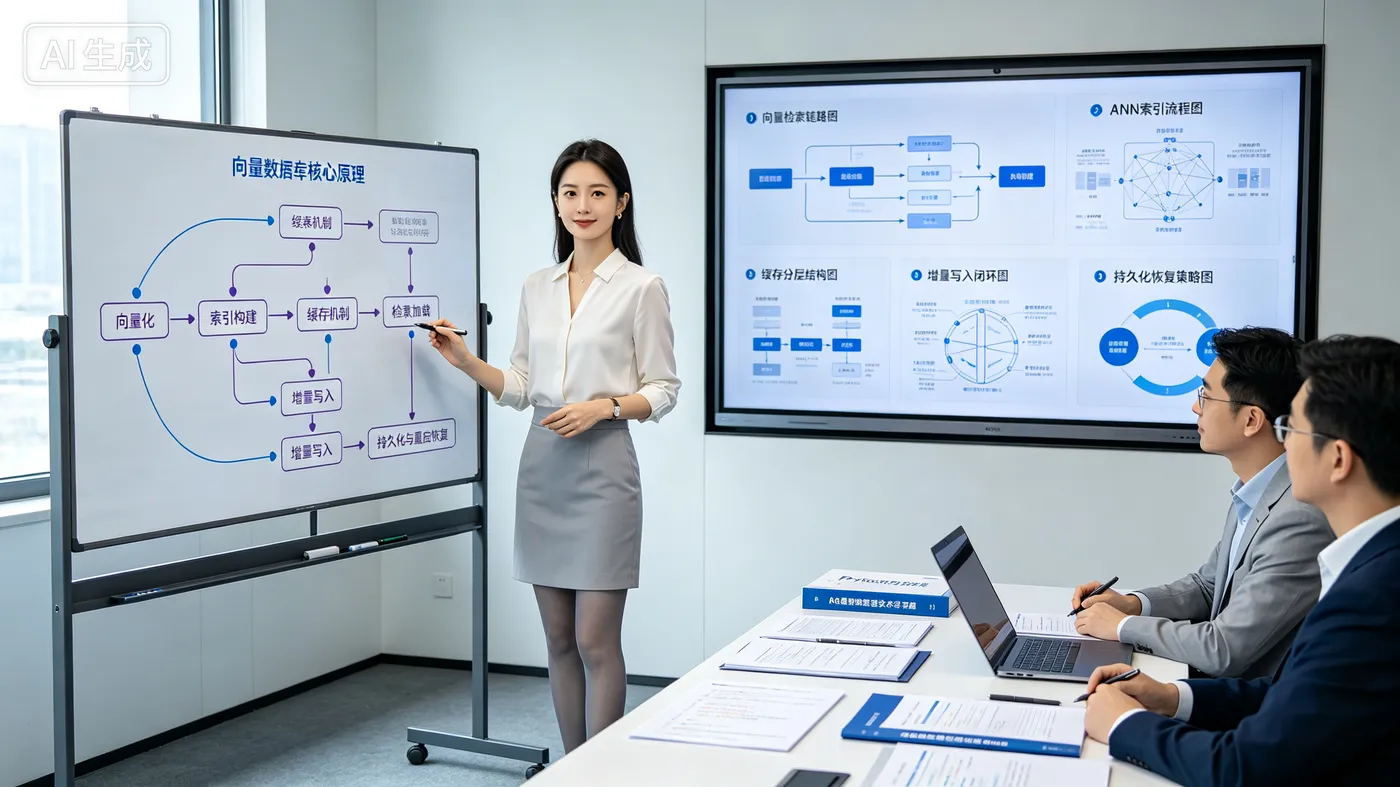
其实日常应用过程中,向量数据库已经上手用了很长时间,日常做RAG原型、搭建私有知识库,API调用写得很熟练。但静下心来梳理底层时,心里始终堆着一堆没有彻底搞透的疑问。向量数据库真正的核心原理究竟是什么?向量集合构建完成之后,内部会不会存在缓存机制?每一次检索请求到来,向量数据又是以什么样的方式加载参与计算?业务源源不断产生新的数据源,该如何完成向量的追加写入?向量数据依靠什么机制长久保存?文档向量是每次用户请求都要重新执行向量化,还是仅在初始化阶段计算一次?当服务程序停止运行、或是机器重启之后,存量的数据又会得到怎样的处理?
搜索的资料零零散散,大量教程大多聚焦接口调用演示,很少完整串联数据的全生命周期。很多线上故障、性能问题、数据异常,根源恰恰就是对这些底层机制一知半解。比如冷查询性能暴跌、向量重复入库、重启后数据丢失、增量更新效率低下等问题,都常常由此引发。今天我也带着这一连串实际开发中产生的疑问,由浅入深拆解向量数据库。顺着数据从生成、写入、缓存、检索、增量更新、持久化存储再到服务重启恢复的完整链路展开,探索这些由来已久的困惑。
二、基础原理
1. 向量数据库介绍
大模型不能直接读懂文字,需要把文本、图片转换为多维浮点数组,这就是通常我们所了解的向量Embedding。一段文字被Embedding模型处理之后输出固定长度数组,例如 text‑embedding‑ada‑002输出1536维向量。向量可以理解成语义的数字化身,语义越接近,向量之间空间距离就越近。
普通关系型数据库擅长精确匹配,无法高效完成海量向量相似度计算。向量数据库就是专门为高维向量设计的专用数据库,核心做两件事:
- 存储向量,同时绑定原始业务元数据:原始文本、文档 ID、来源、时间标签。
- 高效完成近似最近邻检索ANN,根据输入向量,快速找出库里面语义最接近Top‑N结果。
两种核心近邻算法,简单说明:
- 精确最近邻KNN:遍历全部向量计算距离,结果100%准确,数据量大速度极慢。
- ANN近似最近邻:牺牲极小精度,通过索引算法剪枝,大幅提升检索速度,工业界向量数据库默认方案。
向量数据库不等于单纯的向量索引。这里极容易混淆概念:直接用FAISS仅仅是向量索引库,不自带持久化、元数据管理、增量更新;Chroma、Qdrant属于完整向量数据库,封装索引、存储、元数据、持久化整套能力。
向量构成一条完整记录一般包含三部分:
- 向量:多维 float 数组,语义数值表达
- 元数据:原始文本、文档来源、分类标签等业务字段
- 主键 ID:唯一标识,用于更新、删除单条向量
2. 主流索引算法简介
索引是向量数据库性能核心,索引本质就是向量的组织结构,用来加速相似度查找。
- FLAT 暴力索引 (KNN):无索引,全量遍历,小数据集可用,百万级以上数据完全不可用,结果完全准确。
- IVF 倒排索引:先聚类划分簇,查询时只检索少数临近簇,速度提升,存在召回损失。
- HNSW 分层导航小世界图:图结构索引,构建多层网络图,检索沿着图节点跳转。综合召回率、速度表现优秀,工业使用最广泛,内存消耗偏高。
- SCANN:谷歌优化索引,兼顾速度、内存占用。
索引不是构建完成就一成不变,新增数据需要对索引执行增量构建或者合并操作。索引和原始向量数据,是两个独立实体。
3. 向量数据库对比选型
做项目选型向量数据库,不能只看开源热度,要重点评估几个维度:
- 持久化能力:是否落地磁盘,进程重启不丢失
- 内存缓存机制:冷启动加载策略
- 增量写入:支持实时新增、更新、删除向量
- 元数据过滤:检索的时候搭配标签过滤
- 部署模式:嵌入式本地库(Chroma)、独立服务型
部署模式的核心差异:
- 嵌入式向量库,直接嵌入业务进程,无需额外启动服务,适合原型开发、小体量应用;
- 服务化向量数据库独立进程,支持多实例访问,适合生产业务,海量数据场景。
下面提供一段简易Embedding生成代码,也是向量数据库一切数据的源头。
from openai import OpenAI
# 初始化embedding客户端
client = OpenAI(base_url="https://api.example.com/v1", api_key="demo-key")
def get_embedding(text: str, model_name="text-embedding-ada-002") -> list[float]:
    """文本转为向量,向量化只需要执行一次"""
    resp = client.embeddings.create(input=[text], model=model_name)
    return resp.data[0].embedding
if __name__ == "__main__":
    test_text = "向量数据库的缓存机制详解"
    vec = get_embedding(test_text)
    print(f"向量维度:{len(vec)}")
    print(f"向量样例:{vec[:5]}")

Embedding模型输出向量,这一步计算开销大,业务上不会每次检索请求重新执行,只在文档新增或变更的时候执行一次。
三、检索加载逻辑
1. 向量数据库缓存机制
向量数据库存在多层缓存机制,分为操作系统页缓存、数据库自身内存缓存、索引缓存、查询结果缓存。很多人误以为向量全部常驻内存,这是误区。
向量数据分为两大块:
- 索引数据:例如HNSW图结构,查询检索过程需要频繁访问,对延迟敏感,优先加载进内存。
- 原始向量数据、元数据:体积巨大,可以放在磁盘,按需加载。
缓存分层:
- 操作系统 OS PageCache:磁盘文件读取后操作系统自动缓存,这是一层底层隐形缓存。第一次读取磁盘慢,第二次访问同一份文件就走操作系统缓存,速度大幅提升。进程重启后操作系统缓存清空。
- 向量库内置内存缓存:数据库自己维护。可以配置策略,缓存热点向量、热点索引片段。
- 查询结果缓存:部分向量库支持,缓存相同查询向量返回结果,业务一般不常开,因为向量输入几乎不会完全重复。
向量数据的存储模式:
- 嵌入式向量库Chroma:默认会把索引放入内存,向量数据磁盘持久化;
- Qdrant/Milvus:可配置内存阈值,热数据放内存,冷数据留在磁盘。
缓存带来现象: 刚启动向量库,第一次查询速度很慢;连续查询相同数据集,速度变快。不是向量全部加载完成,是操作系统PageCache生效。
2. 每次检索如何加载数据
检索请求完整流程:

- 1. 用户输入Query文本,调用Embedding模型生成查询向量。
这一步是查询时执行,不是读取库内向量。库里面已经存好文档向量。 - 2. 将查询向量送入向量数据库检索接口。
- 3. 数据库优先读取内存 / 缓存中的索引结构,利用ANN索引快速筛选候选向量ID。
- 4. 根据候选ID,如果向量、元数据已经在内存缓存,直接读取;不在缓存,则从磁盘读取对应数据块。
- 5. 执行距离计算,结合元数据过滤条件,返回Top‑N结果。
这里有个核心要注意:向量数据库不会把全部数据集一次性加载进内存;
- HNSW这类图索引,索引结构建议放入内存,否则查询延迟爆炸。
- 原始向量数组可以保存在磁盘,命中候选ID之后按需读磁盘。
两种加载模式:
- 1. 全量加载模式:启动的时候,把索引 + 全部向量加载内存。查询速度最快;数据集大时,启动耗时长,占用巨大内存。适合小数据集。
- 2. 按需加载模式(内存‑磁盘混合):索引常驻内存,原始向量磁盘存储,查询按需加载对应数据块。内存占用可控,冷查询会有少量磁盘 IO 开销,生产环境主流模式。
这里实践应用中很容易出现问题,很多本地向量库默认全量加载,当向量规模几十万上百万,直接把业务服务内存打满OOM。
3. 示例:观察冷热查询差异
下面使用 Chroma 复现冷热查询现象,观察缓存带来速度差异。
import chromadb
import time
# 使用持久化本地向量库
client = chromadb.PersistentClient(path="./chroma_db")
collection = client.get_or_create_collection(name="demo_cache")
def query_vector_db(query_text:str, top_n=3):
    start = time.time()
    res = collection.query(
        query_texts=[query_text],
        n_results=top_n
    )
    cost = time.time() - start
    print(f"查询耗时 {cost:.4f}s")
    return res
if __name__ == "__main__":
    # 第一次查询:冷查询,磁盘读,触发操作系统缓存
    print("====第一次冷查询====")
    query_vector_db("向量数据库缓存原理")
    # 第二次相同查询:热查询,走缓存
    print("====第二次热查询====")
    query_vector_db("向量数据库缓存原理")

运行现象:第一次查询耗时明显高于第二次。进程完全重启之后,又回到慢的冷查询状态。
4. 缓存失效场景
缓存也会失效,在以下情况下缓存会失效,要注意提前考虑做好应对措施,要注意缓存仅仅是加速手段,缓存里面不是真实数据源,磁盘持久化文件才是真相。
- 程序进程重启:向量库内部内存缓存全部清空;操作系统PageCache也会随系统状态变化清空。磁盘上原始向量文件不会删除。
- 新增大量向量,触发索引重建、段合并,旧缓存失效。
- 手动清除向量库缓存配置。
四、向量增量写入流程
1. 新增数据完整链路
业务系统源源不断新增文档,比如上传新知识库文件、新增聊天记录。向量数据库支持增量追加,不需要重建全部库。新增数据源完整步骤:
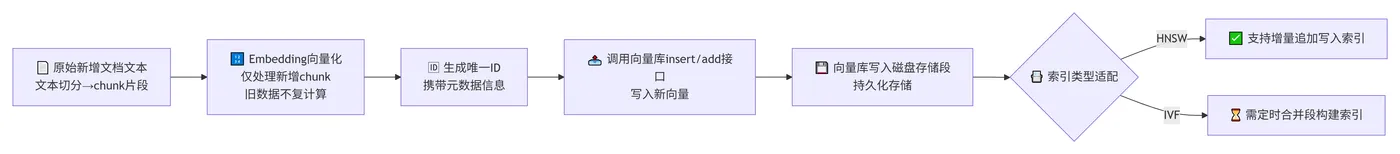
- 1. 获取原始新增文档文本,做文本切分,分割成chunk片段。
- 2. 对新增chunk执行Embedding向量化,旧数据不需要重复向量化。
- 3. 生成唯一ID,携带元数据信息。
- 4. 调用向量库insert/add接口写入新向量。
- 5. 向量库把新向量写入磁盘存储段。
- 6. 根据索引类型:
- HNSW:支持增量追加写入索引;
- IVF:部分实现需要定时合并段,构建索引。
新增数据,不会重新处理历史存量向量,历史向量不会重复Embedding。向量数据库内部很多采用Segment段机制。新写入数据写入新段,不会修改旧段。后台异步任务定期合并小segment,优化索引,提升查询性能。
2. 更新与删除向量
不只是新增,业务还会遇到文档修改、文档删除场景:
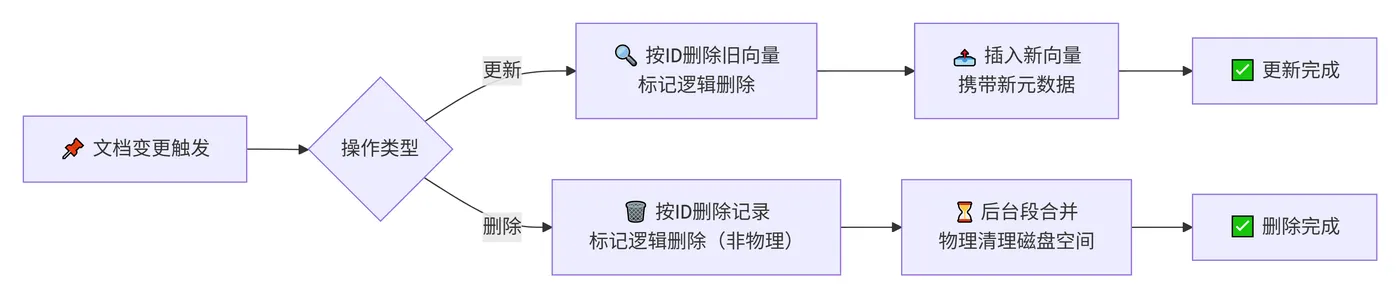
- 更新:先根据ID删除旧向量,再插入新向量。
- 删除:按主键ID删除记录。很多向量库不会立刻物理删除,只是标记逻辑删除,后台段合并的时候才清理磁盘空间。
3. 示例:增量写入实践
import chromadb
from openai import OpenAI
client = OpenAI(base_url="https://api.example.com/v1", api_key="demo-key")
chroma_client = chromadb.PersistentClient(path="./chroma_db")
coll = chroma_client.get_or_create_collection(name="demo_increment")
def get_embedding(text):
    return client.embeddings.create(input=[text], model="text-embedding-ada-002").data[0].embedding
def add_new_documents(doc_list:list[dict]):
    """增量新增文档向量,旧数据不受影响"""
    ids = []
    texts = []
    embeddings = []
    metas = []
    for idx, item in enumerate(doc_list):
        text_chunk = item["chunk"]
        doc_id = item["doc_id"]
        meta_info = {"source": item["source"]}
        vec = get_embedding(text_chunk)
        ids.append(doc_id)
        texts.append(text_chunk)
        embeddings.append(vec)
        metas.append(meta_info)
    # 增量写入
    coll.add(
        ids=ids,
        documents=texts,
        embeddings=embeddings,
        metadatas=metas
    )
    print(f"成功新增 {len(doc_list)} 条向量")
if __name__ == "__main__":
    # 第一批数据
    batch1 = [
        {"doc_id":"doc_001","chunk":"向量数据库增量写入原理","source":"知识库A"},
        {"doc_id":"doc_002","chunk":"向量数据库持久化存储机制","source":"知识库A"},
    ]
    add_new_documents(batch1)
    # 后续又来了新数据源,增量追加,不需要处理doc_001 doc_002
    batch2 = [
        {"doc_id":"doc_003","chunk":"RAG应用向量数据库最佳实践","source":"知识库B"}
    ]
    add_new_documents(batch2)
    print(f"当前集合总数量:{coll.count()}")

4. 增量写入常见问题
- 重复Embedding:部分开发者每次程序启动把全部文档重新跑一遍Embedding入库,造成大量重复向量,数据膨胀,查询结果重复。Embedding只需要文档变更时执行。
- 小碎片segment过多:高频少量写入,产生大量小段,查询性能下降。生产建议做批量写入,后台等待段合并。
- 更新文档忘记删除旧向量,同一份文档新旧版本向量同时存在库中。
五、向量数据持久化保存
1. 向量数据如何保存
向量数据库数据存储分为:元数据存储、向量二进制存储、索引文件。
嵌入式向量库Chroma/Qdrant本地模式,磁盘目录可以看到一堆文件:
- sqlite/leveldb 文件:保存元数据、原始文本、标签、主键ID。
- bin 二进制文件:存储浮点向量数组。
- index 文件:ANN索引文件,HNSW图、IVF聚类中心等。
服务型向量数据库Milvus底层借助MinIO对象存储保存向量与索引文件,etcd保存元数据 Schema。
向量以二进制浮点数组持久化落盘,不是保存在内存。内存缓存只是加速访问,不是数据源。
2. 什么时候做向量化
这里是一个核心疑惑点,到底是在什么时机做向量化,向量化是初始化一次还是每次请求:
- 文档入库阶段(新增、修改文档时):执行Embedding,生成文档向量,存入向量库。只执行一次。
- 用户查询检索阶段:对用户输入Query做Embedding生成查询向量。每一次检索请求都会执行Embedding。
在明确这个答案之前,一直都是错误理解:每次检索请求,向量库把库里面全部文档文本重新Embedding一遍,开销巨大完全不可行。
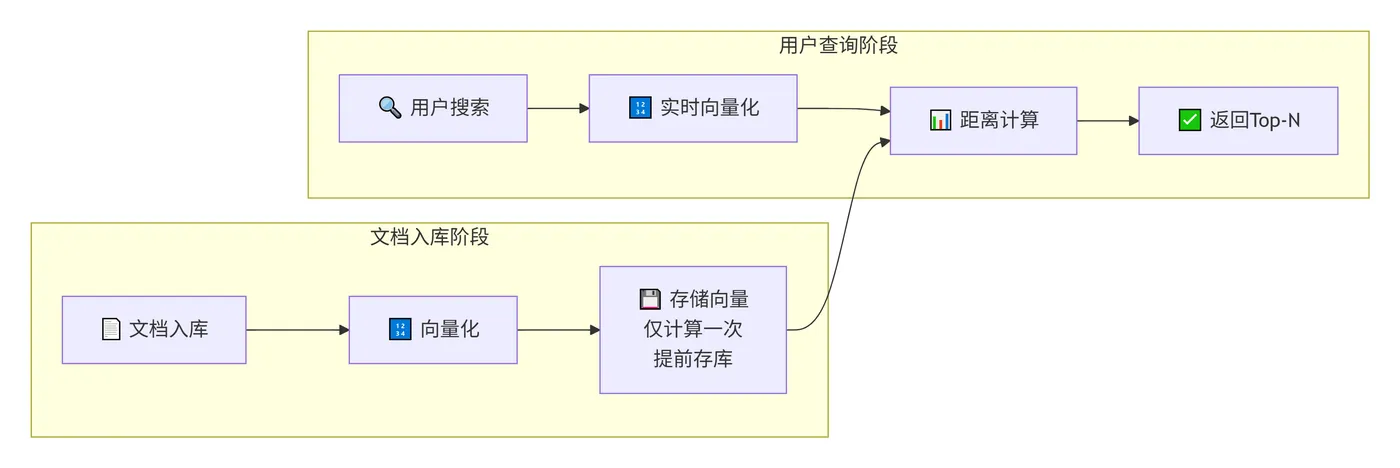
实际的正确流程:文档向量提前算好存库;用户搜索文本实时算查询向量,拿查询向量和库中已经保存向量做距离计算。
举个生活化例子:图书馆。
- 书本(业务文档):提前加工好标签(文档向量)放到书架保存。加工标签只做一次。
- 用户来检索:用户说出自己需求,现场生成检索标签(Query 向量),拿着标签去书架匹配已有书本标签。
为什么文档向量不能查询时实时算?
- Embedding模型调用有耗时、token成本;百万文档每次查询全部向量化,性能成本完全无法承受。
- 文档不变,Embedding结果理论不变,完全可以预计算。
只有文档发生修改、新增的时候,才重新调用Embedding。
3. 示例:关闭重启验证数据不丢失
运行下面代码,写入向量之后关闭程序,重新启动读取,验证磁盘持久化。
import chromadb
# 写入阶段
client_write = chromadb.PersistentClient(path="./chroma_persist_demo")
col_write = client_write.get_or_create_collection("persist_test")
col_write.add(
    ids=["id_01"],
    documents=["验证向量数据库持久化效果"],
    metadatas={"note":"测试数据"}
)
print(f"写入完成,数量:{col_write.count()}")
# =========模拟程序停止,进程退出=========
del client_write
# =========模拟程序重新启动,重新初始化客户端=========
client_read = chromadb.PersistentClient(path="./chroma_persist_demo")
col_read = client_read.get_collection("persist_test")
print(f"重启后读取向量数量:{col_read.count()}")
res = col_read.get(ids=["id_01"])
print(f"读取数据:{res}")

运行现象:进程销毁重建,向量数据依旧存在。只要不手动删除磁盘文件夹,数据不会消失。
六、停止重启后数据处理
1. 进程停止时发生什么
向量数据库进程停止分为嵌入式(嵌入业务进程)与独立服务进程两种场景:
嵌入式向量库:
- Chroma本地持久化模式,向量数据修改操作会逐步刷入磁盘文件。
- 进程停止,内存中的缓存、索引内存实例全部销毁。
- 磁盘上:向量二进制、索引文件、元数据文件完整保留。
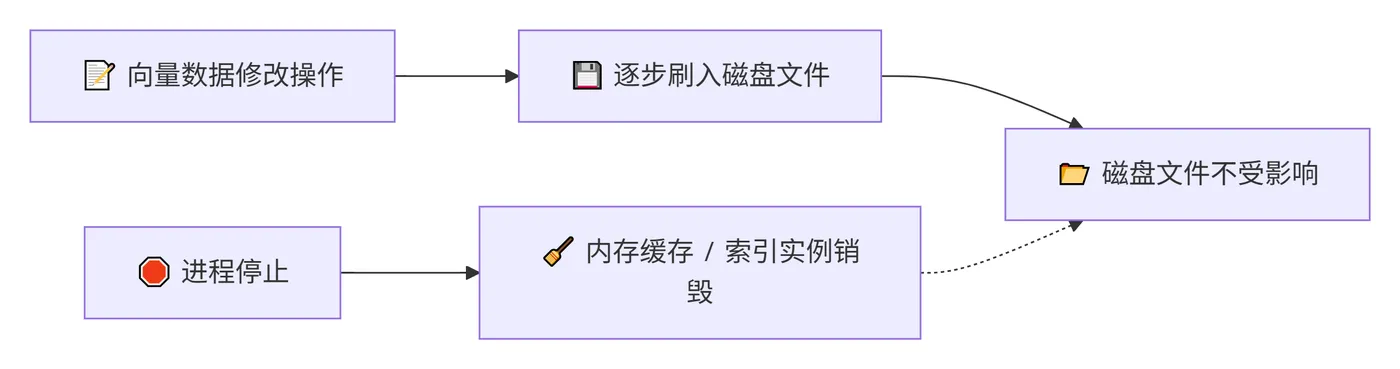
如果程序异常崩溃,有可能存在少量内存数据还没刷盘,造成极小部分数据丢失。生产建议开启手动flush刷盘接口。
服务化向量数据库:
- Qdrant服务模式,写请求完成后落盘对象存储。
- 服务进程宕机,磁盘/对象存储数据不受损坏。
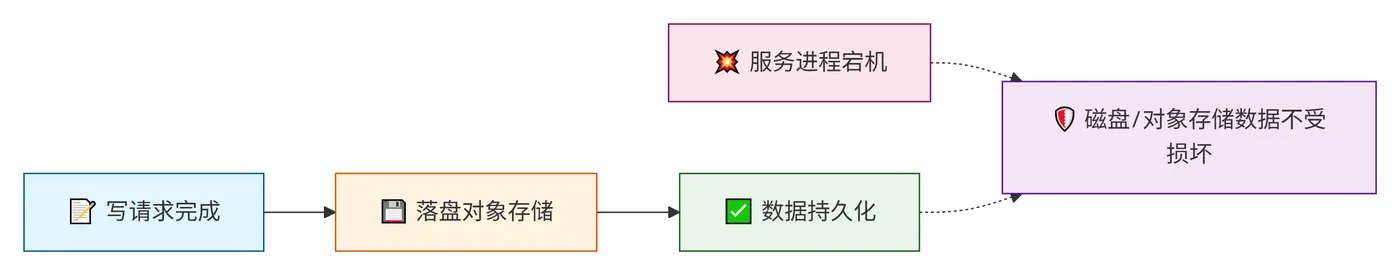
注意内存模式向量库:Chroma可以设置内存模式,数据完全只放内存,不写磁盘。一旦程序退出,所有向量全部清空,这个模式只适合临时测试。
2. 程序重新启动完整流程
重启不会重新执行Embedding。向量全部保存在磁盘,不需要重新跑Embedding。向量库重启启动执行步骤:
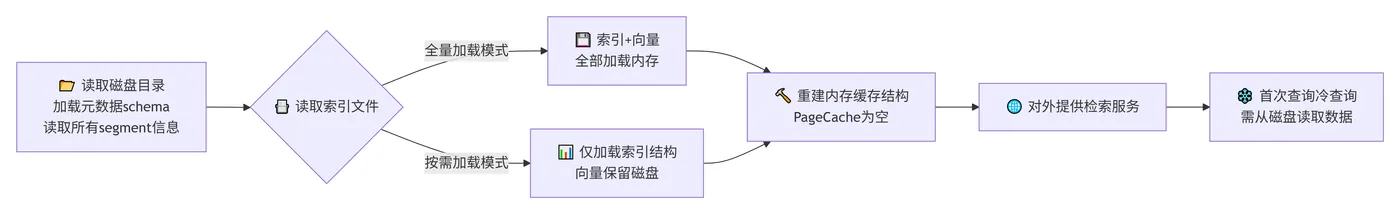
- 1. 读取磁盘目录,加载元数据schema,读取所有segment信息。
- 2. 读取索引文件。如果配置全量加载,索引、向量全部加载内存;按需加载模式,只加载索引结构,向量数据保留磁盘。
- 3. 重建内存缓存结构。操作系统PageCache此时是空,第一次查询属于冷查询。
- 4. 对外提供检索服务。
3. 常见故障现象说明
- 重启之后向量全部消失:大概率使用内存模式向量库,没有开启持久化,磁盘没有生成任何数据文件。
- 重启后第一次查询很慢:冷启动,缓存为空,需要读磁盘。数据量大时HNSW索引加载也会消耗时间。
- 崩溃后少量数据丢失:写入完成还没有触发刷盘就崩溃。重要业务场景,执行add之后调用flush()强制刷盘。
4. 示例:flush强制刷盘
import chromadb
cli = chromadb.PersistentClient(path="./chroma_flush_demo")
coll = cli.get_or_create_collection("flush_demo")
coll.add(
    ids=["test_001"],
    documents=["测试强制刷盘"]
)
# 手动调用flush,确保内存数据落地磁盘,防止异常断电丢失
coll.flush()
print("数据已经强制刷入磁盘")

七、RAG开发中的异常记录
1. 向量化时机要点
- 文档新增、修改 → Embedding生成文档向量,写入向量库。只做一次。
- 用户提问Query → Embedding生成查询向量,每次检索执行。
- 不要每次服务启动全量重新Embedding全部知识库,会带来重复数据、高额token开销。
2. 缓存与内存要点
- 区分:磁盘持久化文件是源数据;内存缓存只是加速。进程重启缓存清空。
- HNSW索引内存开销大,大数据集不要无脑全量加载。优先使用内存‑磁盘混合按需加载模式。
- 压测需要做冷启动压测,不能只拿热缓存状态下的查询性能当做线上指标。
3. 增量更新要点
- 增量新增不会修改历史向量,历史数据不需要重处理。
- 更新文档逻辑:删除旧ID向量,再插入新向量。
- 高频少量写入产生大量小segment,影响查询性能,尽量批量提交。
4. 持久化与重启要点
- 生产环境禁用纯内存模式向量库。
- 重要写入完成调用flush强制刷盘,规避崩溃丢数据风险。
- 备份向量库本质备份磁盘目录 / 对象存储数据,而不是内存数据。
完整简易RAG实践示例,整合前面全部知识点:
import chromadb
from openai import OpenAI
# 初始化
embedding_client = OpenAI(base_url="https://api.example.com/v1", api_key="demo-key")
db_client = chromadb.PersistentClient(path="./rag_vector_db")
rag_collection = db_client.get_or_create_collection("knowledge_base")
def text2vec(text):
    return embedding_client.embeddings.create(input=[text], model="text-embedding-ada-002").data[0].embedding
def add_knowledge(doc_id:str, content:str, source:str):
    """知识库新增文档,仅新增时Embedding"""
    vec = text2vec(content)
    rag_collection.add(
        ids=[doc_id],
        documents=[content],
        embeddings=[vec],
        metadatas=[{"source":source}]
    )
    rag_collection.flush()
def rag_retrieve(user_query:str, top_k=3):
    """用户检索:只对query做Embedding,库中文档向量复用已有"""
    res = rag_collection.query(
        query_texts=[user_query],
        n_results=top_k
    )
    return res
if __name__ == "__main__":
    # 1.业务新增知识库文档,只执行一次Embedding
    add_knowledge("kb_001","向量数据库重启后数据保存在磁盘","内部文档")
    add_knowledge("kb_002","向量检索查询时只向量化用户提问","内部文档")
    # 2.用户请求检索
    search_result = rag_retrieve("向量数据库重启之后数据去哪了")
    print(search_result["documents"])

八、总结
今天完全是带着疑问去探索,对核心问题先做个全面总结,对应关键的核心要点:
向量数据库有没有缓存?
- 有多层缓存:数据库内存缓存、操作系统PageCache。
- 缓存用于加速查询,缓存不是数据源,进程重启缓存全部清空。磁盘文件才是真实数据。
每次检索如何加载向量?
- 不会一次性全量加载所有向量。
- 索引优先放入内存;原始向量可以磁盘存储。
- 检索通过索引找到候选ID之后按需读取向量。
- 冷查询读磁盘慢,热查询命中缓存速度快。
有新数据源如何增加?
- 对新增文档做切分、Embedding,直接增量写入向量库,存量历史向量完全不动。
- 底层新增segment段,后台异步合并优化索引。文档修改需要先删旧向量再写入新向量。
向量如何保存?
- 向量以二进制浮点数组持久化写入磁盘,搭配元数据、索引文件共同保存。
什么时候向量化?
- 文档新增、修改的时候,文档向量只初始化计算一次。
- 用户每一次检索请求,只对用户输入Query做Embedding,不会重新处理库中存量文档。
程序停止重启,数据怎么处理?
- 程序停止,内存缓存、内存索引实例销毁;磁盘文件完整保留。
- 重启读取磁盘文件重建索引内存结构。不需要重新Embedding。纯内存模式除外,退出数据丢失。
总的来说,向量数据库不是黑盒,RAG系统很多bug根源都来自不理解数据完整生命周期。我们要尽量避免仅仅只停留在调用API层面,遇到性能、数据异常无从排查。搞懂缓存、加载、增量写入、持久化、重启恢复的整个过程,不管使用什么向量数据库,底层逻辑是相通的。在实践做RAG的时候,一些小经验分享,区分冷热数据、控制写入批次、做好持久化刷盘、规避重复Embedding,从而构建稳定可靠检索增强大模型应用。