摘要 DeepSeek Harness 0.2的测试重点,不是新增功能能不能点开,而是发行组合、历史会话、多Agent状态、执行环境、工具协议、桌面端安全和工程门禁能否继续保持一致。本文结合0.2.0-rc.2与0.2.1-alpha.1的版本变化,拆解一套可直接复用的Agent Harness升级测试方法。
很多人第一次看到DeepSeek Harness 0.2.1-alpha.1的更新说明,注意力可能都放在“实验性兼容Claude Code Mods”上。
这个功能确实有话题性,但从测试角度看,它并不是这轮升级中最难的部分。
真正麻烦的是:这次变化同时触及了插件发行、会话格式、桌面端、多Agent协作、工具目录、Prompt Cache、执行环境和运行治理。
当一个版本同时改动这么多基础层,测试范围就不能再按照“新增一个功能,补几条用例”的方式估算了。因为最终出问题的,很可能不是某个按钮不能用,而是旧会话升级后无法恢复、两个进程同时改坏Session,或者工具已经更新,模型却继续使用旧缓存。
这里我们不单纯复述功能清单。我们换一个测试工程师更容易使用的角度:这些版本变化可能制造哪些生产事故,又该怎么验证?
先别急着看功能:这次更新已经改变了测试对象
根据仓库版本差异统计,与0.1.0-rc.5相比,0.2.0-rc.2和0.2.1-alpha.1出现了几组明显变化:
| 观察维度 | 0.1.0-rc.5 | 0.2.0-rc.2 / 0.2.1-alpha.1 | 对测试的影响 |
|---|---|---|---|
| 包组与包数 | 54组、约219个包 | 55组、316个包 | 组合关系和依赖回归明显增加 |
| 会话格式写入器 | v0 | 演进到v4,已经发布v3 | 必须验证历史数据迁移与重放 |
| 应用形态 | CLI + Web | 增加Electron Desktop、Desktop Host | 多了一整条桌面端与宿主进程测试链 |
| 发行机制 | 直接运行插件树 | Profile + Bundle + Patch | 同一产品出现多种能力组合 |
| 前端结构 | 前端包较少 | client目录下约63个包 | Web正在从简单界面变成工作台 |
| 决策记录 | 约680条 | 约526条英文、含中文约1051条 | 版本行为越来越依赖工程决策资产 |
| 文档资产 | 多篇 | 359篇Markdown、64个子系统页 | 文档本身开始成为交付的一部分 |
| 测试规格 | 未单独统计 | 约1501个*.spec.ts |
代码门禁和回归体系继续扩大 |
这些变化说明,DeepSeek Harness正在从“能运行Agent的框架”,逐渐走向一套可安装、可组合、可恢复、可治理的Agent运行平台。
官方页面把模型、工具、技能、会话、沙箱、存储、循环、调度和UI都纳入插件体系,并强调每次运行都可以通过Session Log追踪。也就是说,它的核心竞争力不再只是工具数量,而是这些能力能不能在长期运行中保持秩序。
风险一:包从约219个涨到316个,真正增加的是组合风险
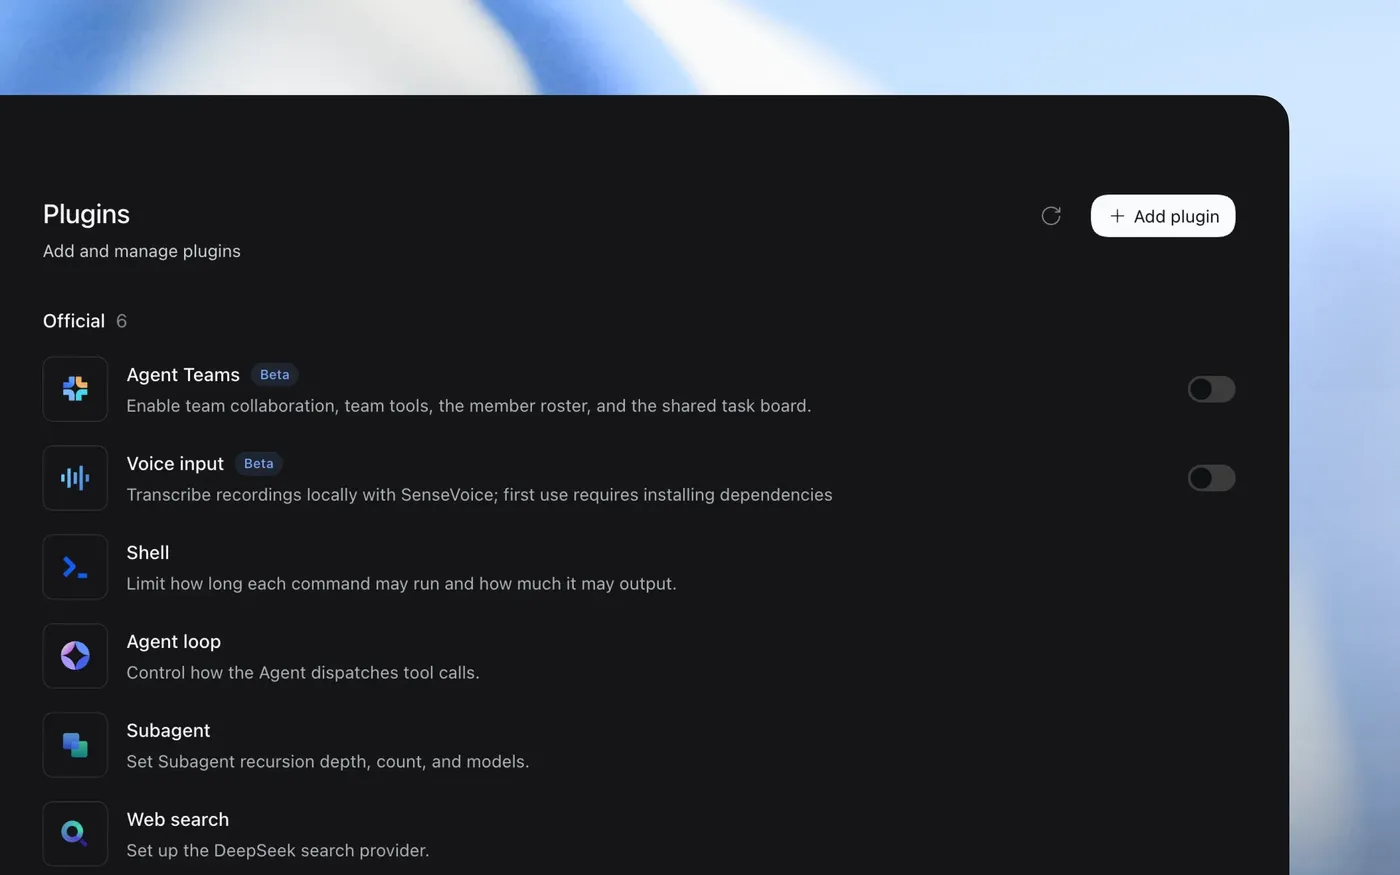
0.2开始出现更完整的发行体系:Profile用于定义web、headless、sdk、sdk-minimal、acp等能力组合;Bundle通过package.json中的dsh.profile和dsh.bundle声明打包方式;Agent Preset可以用Cordis YAML组合子插件;外层还出现了Patch、实验包和NSIS桌面安装器。
这类变化对用户很友好,因为不同场景不需要装上全部能力。但对测试来说,它意味着配置空间迅速扩大。
最典型的问题包括:
- web组合可以启动,headless组合却漏装了必要Provider;
- sdk-minimal本应只保留最小能力,却被其他插件间接拉入多余依赖;
- Patch覆盖了Bundle默认值,升级后配置含义发生变化;
- 安装成功,但降级时残留了新版本配置,旧版本无法重新启动;
- 某个插件单独测试通过,换一种组合后才出现依赖顺序问题。
测试时不要把316个包逐一排列组合,那样成本不可控。更实用的做法是围绕“能力接缝”抽样。
DeepSeek Harness把LLM、文件系统、子进程、沙箱、SSH、Shell、终端、LSP、工作流、任务、调度、会话持久化、会话投影、子Agent、Skills、浏览器、电脑操作、Office转PDF和凭据等能力拆成Service Definition、Provider、Consumer三类角色。
测试可以按照下面三层覆盖:
- 每个Service Definition至少验证一个默认Provider;
- 关键接缝至少验证两种Provider替换;
- 高风险Consumer验证Provider缺失、加载失败和中途断开的降级行为。
这样测的不是“插件有没有装上”,而是插件之间的合同是否仍然成立。
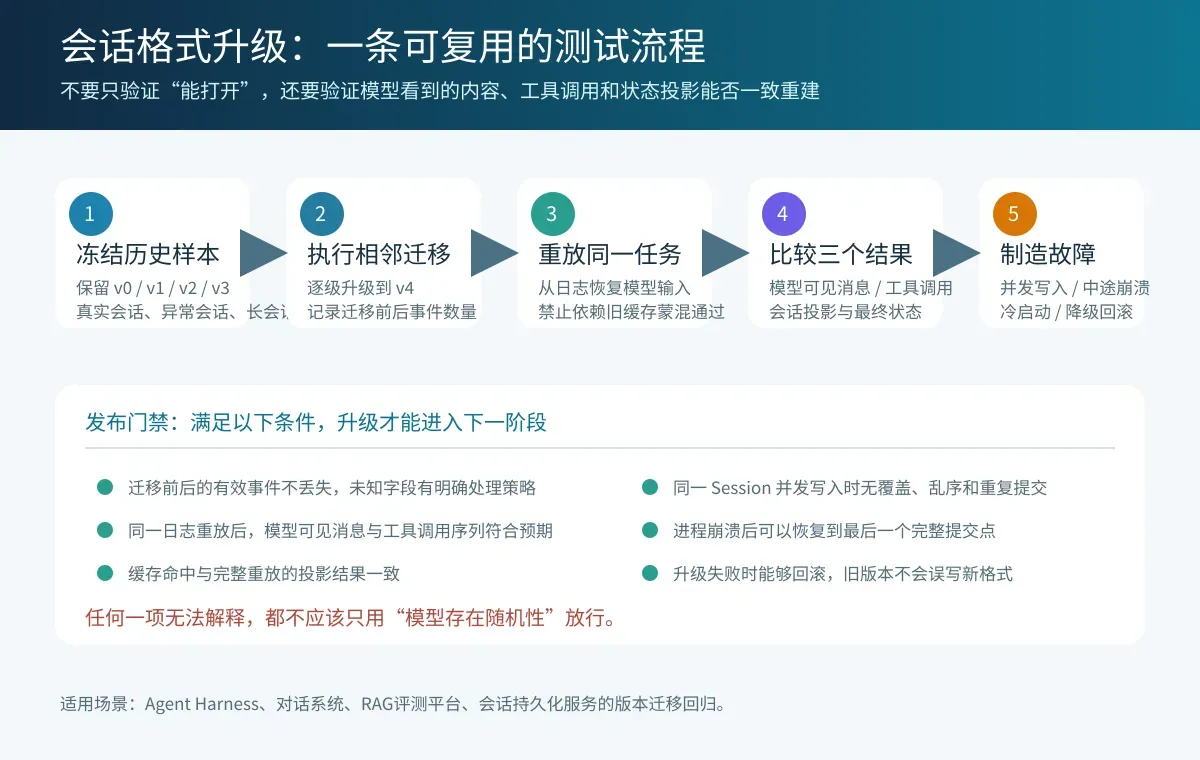
风险二:会话格式从v0演进到v4,能打开不代表迁移正确
这次更新里,最容易被普通功能回归忽略的,是会话日志和投影体系。
DeepSeek Harness一直强调:模型能看到的内容,应当能够在日志中找到对应事实。到了0.2,这条原则被继续加强:
- 通过
deriveEventMessage()维护单一投影规则; - 会话格式按照v0→v1→v2→v3→v4进行相邻版本迁移;
- 已提交的generation不允许被改名、覆盖或删除;
session-projection-cache持久化保存(sessionId, key, ver, seq, val);- 热路径可以读取缓存,冷路径必须能够依靠日志重放;
- 原生系统使用POSIX
flock,为同一Session提供跨进程写租约。
这里最危险的误判是:“旧会话能够在新版本里打开,所以迁移成功。”
页面能打开,只能说明最外层读取没有崩。迁移是否正确,至少还要比较三类结果:
- 模型最终看到的消息是否一致;
- 工具调用、工具结果和上下文注入顺序是否一致;
- 从缓存读取的投影,是否与完整日志重放得到相同状态。
还要专门制造并发与故障:两个进程同时写同一个Session;写入一半时强制结束进程;缓存落后于日志一个序号;迁移完成后再尝试降级启动。
如果这些场景没有覆盖,线上出现“偶尔丢一轮对话”“工具结果重复进入上下文”时,很容易被误判为模型随机性。
风险三:多Agent能启动,不代表它们能长期协作
0.2中的Agent Teams仍属于实验能力,但它已经不只是“拉起几个子Agent”。
这套能力包含持久花名册、任务DAG和邮箱;Workflow支持程序化扇出;Goal可以跨轮继续;Schedule负责定时唤醒;continuable subagent支持冷恢复。
这意味着测试对象从一次性调用,变成了一个有身份、有任务状态、有共享数据的协作系统。
测试重点至少包括:
- 同一个任务被调度两次时,是否重复执行;
- 父Agent取消任务后,子Agent是否仍继续调用工具;
- 两个Agent同时认领一个任务时,是否有去重机制;
- 冷恢复后,邮箱中的旧消息会不会被再次消费;
- 任务DAG上游失败后,下游是否被错误唤醒;
- 子Agent越权访问其他Agent的凭据或工作区时,系统是否拦截;
- 根会话重放后,团队身份和任务状态能否恢复。
多Agent最难测的不是回答质量,而是状态一致性。只验证最终任务完成率,很可能看不到重复执行和权限越界。
风险四:同一任务换到Local、Sandbox和SSH,结果还能一致吗
DeepSeek Harness让subprocess、文件系统和sandbox同时具备local、sandbox、SSH等Provider;PTC和Workflow可以复用同一沙箱;持久终端也只是一个可替换的Shell后端。
这种设计提高了可替换性,但也容易产生跨环境差异。
例如:
- 本地环境继承了用户变量,沙箱里却没有;
- SSH环境的路径分隔、权限或编码不同;
- 本地文件系统允许软链接,隔离环境拒绝;
- 同一条命令在不同Shell中退出码不同;
- PTC在沙箱中执行,但某个工具意外绕回宿主机。
比较有效的测试方法,是准备一组完全相同的任务,分别注入local、sandbox和SSH Provider,然后比较:输入文件、环境变量、命令、退出码、产物哈希、审计日志和权限拒绝结果。
测试目标不是要求三种环境所有细节完全相同,而是确认差异受到合同约束,并且不会让执行越过预期边界。
风险五:工具目录已经更新,模型可能还活在旧缓存里
0.2对模型API的配合也更深入。
动态工具更新可以通过request/header.tools和developer/message中的tool-registry变化表达,DeepSeek侧还会发送tool-changes beta头;工具调用被拆成preparing、start、result三个阶段,其中preparing只负责展示,不进入持久日志;系统提示被视为surface节点0,提示变化会替换节点并开启新的series,同时保护头部不被压缩。
这些设计共同服务于Prompt Cache和工具目录的动态变化,但也会引入一类很隐蔽的问题:代码已经加载了新工具,模型上下文里仍然保留旧工具说明。
建议至少覆盖以下用例:
- 工具新增、删除、改名和参数Schema变更;
- 系统提示不变但工具目录变化;
- 工具目录不变但系统提示发生变化;
- Prompt Cache命中与未命中时的结果对照;
- preparing阶段被中断后是否留下脏日志;
- start已经记录但result缺失时,恢复流程如何处理;
- 旧会话恢复后是否错误调用已经下线的工具。
这类Bug未必表现为接口报错,更可能表现为模型突然“不会用新工具”。因此,测试不能只检查HTTP状态码,还要校验最终发送给模型的工具目录版本。
风险六:增加桌面端以后,安全测试对象明显扩大
Electron Desktop和Desktop Host让DeepSeek Harness更容易被普通用户安装,但桌面化也把新的供应链和本地权限问题带进了测试范围。
官方方案内置签名的生产运行时,位于$DSH_HOME/dsh-runtimes/dsh-primary-runtime,其中包含Python、Node和pnpm;桌面端与CLI共享数据,但使用独立锁文件;同时还有Landlock、flock、TypeScript/Python双SDK、单文件运行时和MIT开源核心。
这些机制解决的是环境漂移和自主可控,但测试仍要确认:
- 安装器、运行时和更新包的签名是否可以被验证;
- 第三方插件能否读取不属于它的凭据;
- Shell、文件系统、SSH和Office转PDF能力是否遵守最小权限;
- 桌面端和CLI同时运行时,会不会争抢同一份数据;
- 崩溃报告和Session Log上传是否执行脱敏;
- 有界遥测的字节上限是否真正生效;
- Auto Review判断高风险时,是否可以可靠回退人工审批;
- 审核服务失败时,系统是fail-closed还是直接放行。
这里要特别注意Claude Code Mods兼容层。官方说明将它定位为实验性验证,并没有承诺完整、实用的兼容性。相关模组在进程内运行,官方兼容性文档也明确列出了与Claude Code行为不同的部分。因此测试时不能把“可以加载”直接理解成“安全边界和行为完全一致”。
风险七:工程资产也必须进入发布门禁
这次版本分析中还有一组不太吸睛、但很关键的数据:359篇文档、约526条英文实现态决策记录、含中文约1051条,自动生成的tool/config/persistence catalog,双语配对要求、文档字节预算,以及约1500个测试规格。
这些并不是项目附属品,而是版本行为的一部分。
例如,某个Provider已经从代码中删除,但配置目录仍然允许它;工具Schema已经更新,但生成目录没有同步;英文文档说明了兼容性破坏,中文页仍保留旧用法。功能测试可能全部通过,用户安装后仍会踩坑。
所以发布门禁至少应该检查:
- 工具、配置和持久化目录是否与代码一致;
- 中英文文档是否成对更新;
- 决策记录是否解释了不兼容变化;
- 新增能力是否具备对应测试规格;
- 失败是否显性暴露,而不是被静默吞掉;
- 预览功能和稳定功能是否有清晰边界;
- 发布包中是否混入未声明的实验能力。
功能容易被模仿,持续运转的工程纪律很难复制。对测试团队来说,规范、文档、目录和决策记录也应该是可执行的测试对象。
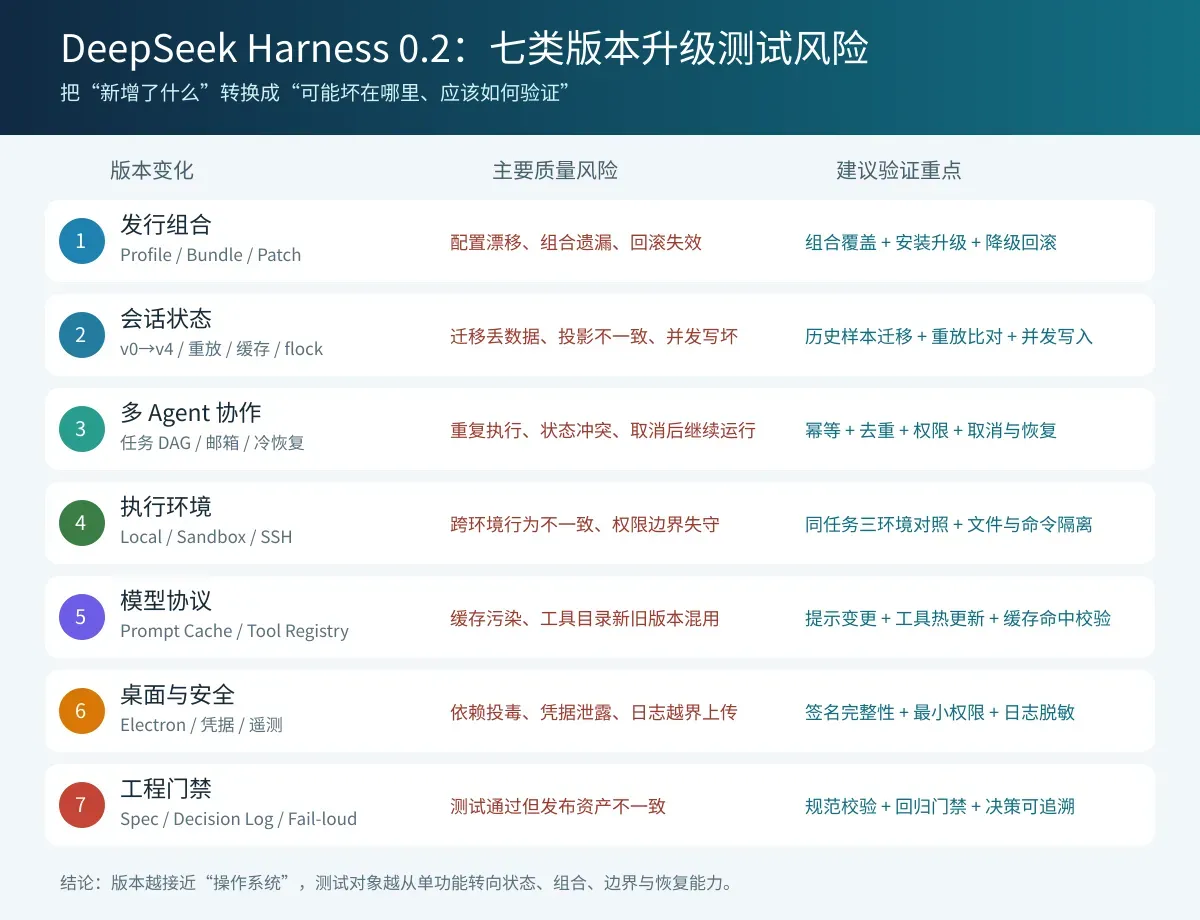
给测试团队的一份升级验收表
| 验收范围 | 必测问题 | 建议门禁 |
|---|---|---|
| 发行组合 | Profile、Bundle、Patch是否产生配置漂移 | 核心组合全部通过安装、升级、降级 |
| 会话迁移 | v0至v4能否稳定迁移和重放 | 模型可见消息、工具调用、投影结果一致 |
| 并发写入 | 多进程是否覆盖或重复写入Session | 无乱序、无覆盖、崩溃后可恢复 |
| 多Agent | 是否重复执行、越权或取消失效 | 身份、任务、权限、取消和恢复全部可审计 |
| 执行环境 | local、sandbox、SSH是否行为失控 | 差异可解释,权限不越界 |
| 模型协议 | 工具变化是否污染Prompt Cache | 模型收到的工具目录版本可验证 |
| 桌面安全 | 安装包、插件、凭据、日志是否安全 | 签名有效、最小权限、日志脱敏 |
| 工程资产 | 文档、目录、决策记录是否同步 | 机器门禁阻断不一致发布 |
最后:这次升级真正改变了什么
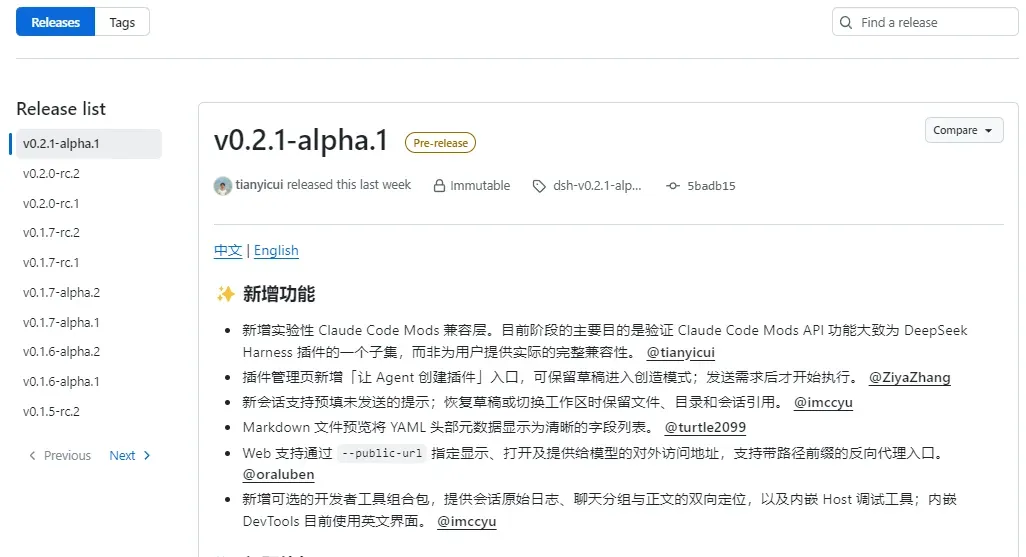
如果只按Release Notes阅读,0.2.1-alpha.1像是一次包含Claude Code Mods、插件创建入口、草稿保留、Markdown预览、--public-url和开发者工具的功能更新。
但把它和0.2.0-rc.2、会话格式、多Agent、Provider以及桌面端放在一起看,就会发现DeepSeek Harness正在回答另一个更大的问题:Agent系统怎样才能被安装、被组合、被恢复、被审计,并且长期运行下去。
这也是为什么测试对象发生了变化。
以前我们更关心Agent能不能完成任务;现在还要验证它在版本迁移、并发写入、工具变化、环境切换、权限收缩和故障恢复时,能不能保持可控。
模型不可能每次都足够聪明,但承载模型的Harness必须提供事实日志、权限边界、失败证据和回退路径。
这可能才是DeepSeek Harness 0.2最值得测试工程师关注的变化。
FAQ
1. DeepSeek Harness 0.2最值得关注的变化是什么?
不是单个新插件,而是发行组合、版本化会话日志、多Agent状态、可替换执行环境、模型API协同、桌面端和运行治理同时扩展。它正在从Agent框架走向可交付、可运营的平台。
2. Agent Harness升级为什么必须做会话迁移测试?
因为旧会话包含模型消息、工具调用、工具结果和上下文注入。页面能够打开,不代表这些事实可以被正确重建。迁移测试必须同时比较模型可见消息、工具调用序列和状态投影。
3. 多Agent测试只看最终任务成功率够不够?
不够。最终结果正常时,系统仍可能发生重复执行、状态冲突、权限越界和取消失效。多Agent测试需要覆盖身份、任务DAG、邮箱去重、冷恢复和共享状态一致性。
4. 0.2.1-alpha.1可以直接当作稳定生产版本吗?
不建议仅凭功能可用就直接放行。官方仍将项目和部分能力标记为预览或实验阶段,并明确提示核心插件和API会继续演进。生产使用前应固定版本,完成迁移、回滚、安全和故障恢复验证。
5. Claude Code Mods兼容层是否代表完全兼容?
不是。官方发布说明明确表示,它当前主要用于验证Claude Code Mods API的能力大体上是DeepSeek Harness插件能力的子集,并非承诺完整、实用的兼容性。