
视频拍完后,人物脸部偏暗、主体不够突出,能不能在后期补一盏“虚拟灯”?
我在免费开源视频编辑器 Timeline Studio 中实现了 AI 辅助视频打光:先估计画面的相对深度,再根据深度构造近似表面,用 WebGL 计算补光。用户可以调整灯位、颜色和强度,继续在时间线上编辑。
项目源码:https://github.com/MartinDelophy/ai-video-editor
在线体验:https://anna.partners/store/@martindelophy/timeline-studio
阿里云AI视频打光封面.png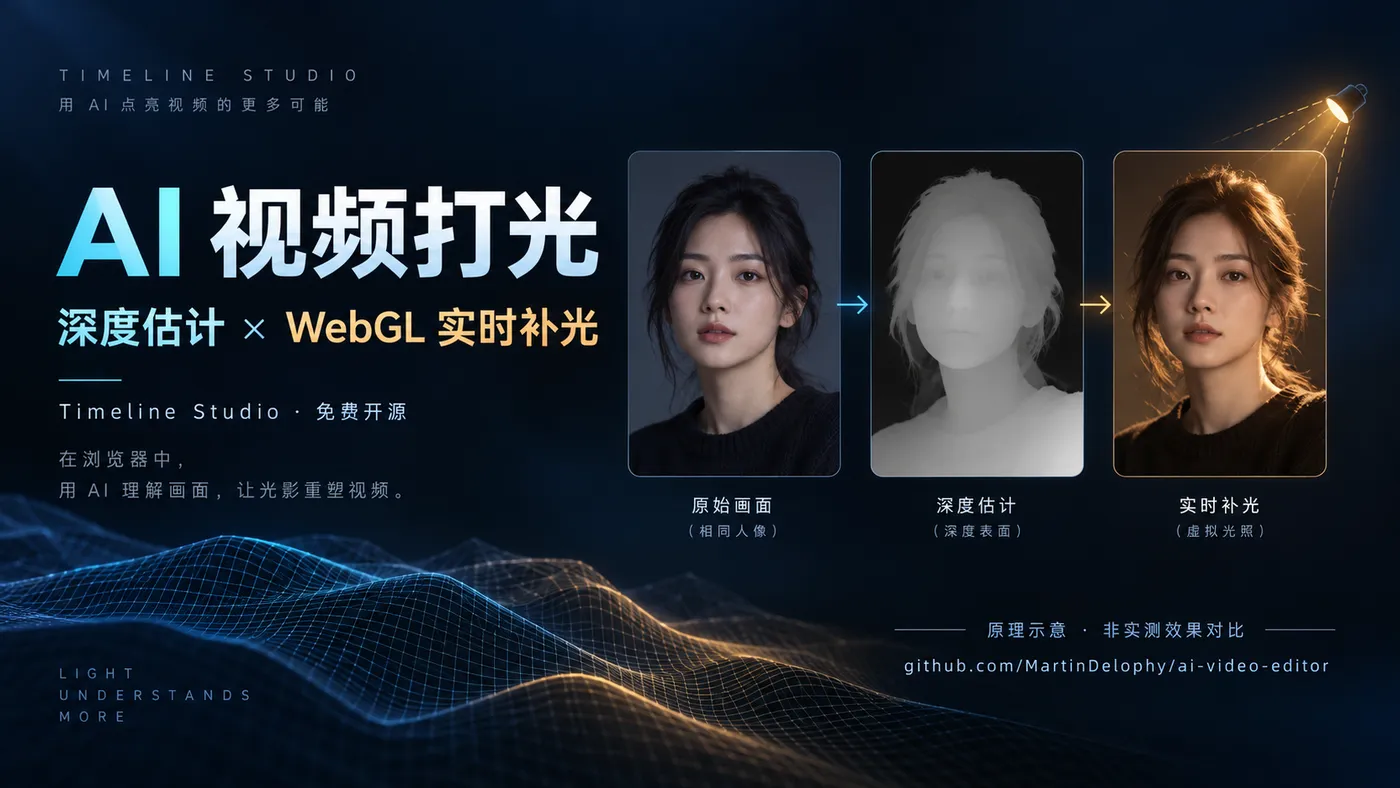
一、为什么补光需要空间信息
整体提高曝光会同时提亮人物和背景,很难形成明确的照射方向。深度估计提供了另一种线索:画面中哪些区域更近,局部表面如何变化。
当前实现使用 Depth Anything V2 Small,通过 Transformers.js 和 WebGPU 在浏览器端推理,采用 Q4F16 配置。结果属于相对深度,不能直接换算成实际距离。
这条深度分析和补光路径在浏览器本地处理画面。首次使用需要下载模型,运行速度取决于设备与浏览器。
二、AI 负责理解,着色器负责补光
整个过程分为两步:
- 对采样视频帧执行深度推理,得到深度序列。
- 将原图和深度作为纹理输入 WebGL,根据灯位与表面方向计算照明。
调整灯光参数时可以复用深度结果,无需每次重新运行模型。这让分析阶段和交互调光阶段各自承担合适的工作。
三、从深度变化估计表面朝向
着色器读取当前像素附近的深度,计算水平、垂直方向的变化,构造近似法线:
vec3 normal = normalize(vec3(-dx * .12, -dy * .12, 1.));
其中 dx、dy 来自邻域深度差分。随后计算表面指向灯光的方向,以点积估计漫反射贡献:
vec3 lightDirection = normalize(lightPosition - surface);
float diffuse = max(0., dot(normal, lightDirection));
这里构造的是单视角的近似深度表面,不是完整三维模型。法线也不是物体真实法线,但可以为方向性补光提供依据。
四、让灯光有方向、有范围
当前支持调整水平与垂直灯位、强度、范围、柔和度、距离和颜色。灯位从方位角、仰角与距离转换为三维坐标。
照明还受到空间包络与距离衰减的影响,避免整幅画面被同样提亮。柔和度参与邻域采样和漫反射响应的调整,提供更柔和的视觉过渡;它并非物理面积光源的精确模拟。
对于背光,单视角深度没有背面几何。实现通过前景深度边界与掠射方向估计轮廓光,不把正面的漫反射简单取绝对值,从而减少背面灯位把整张正脸照亮的问题。
五、保留原有光影,再叠加补光
当前方案没有从画面中完整分离材质与原始照明,而是在保留源画面光影的基础上增加光照贡献。
着色器使用 2.2 次幂近似转换到线性光空间,叠加补光与轮廓光,再转换回显示值。这是工程近似,并非完整的颜色管理或物理渲染系统。
因此,这项能力更适合局部提亮、主体强调、暖冷色补光和轮廓氛围调整。已经过曝丢失的纹理无法直接恢复,原画面中的硬阴影也不会自动消失。
六、视频处理还需要时间一致性
时间线片段可能经过裁剪、变速或速度曲线调整,深度采样必须匹配实际播放的源画面。项目使用共享的源时间映射:
const sourceTime = getVisualSourceTime(segment, localTime);
深度结果按源时间选择相邻样本,并在需要时混合。分析缓存包含裁剪、速度曲线、质量和模型版本等条件,避免相关输入变化后错误复用旧结果。
预览和输出路径复用深度效果绘制入口,有助于保持处理逻辑一致。但深度误差、采样密度和快速运动仍可能造成边缘变化,最终应结合连续播放检查。
七、能力边界
这是一种基于 AI 深度的后期补光近似。目前没有完整恢复场景几何、材质、真实投影或多次反射。头发、透明物体、复杂遮挡和快速运动都是需要重点检查的区域。
文章封面为原理示意图,不作为真实产品效果对比。评估实际效果时,应使用同一视频、同一时刻、同一构图进行前后比较。
八、体验与开源仓库
Timeline Studio 的目标,是把浏览器本地 AI 能力接入可继续编辑的视频工作流。除了运行模型,还需要处理时间映射、资源预算、取消、进度和输出。
欢迎体验并查看实现:
- 在线编辑器:https://anna.partners/store/@martindelophy/timeline-studio
- GitHub 开源仓库:https://github.com/MartinDelophy/ai-video-editor
- AI 视频编辑 Skills 手册:https://github.com/MartinDelophy/timeline-studio-handbook
源码中的 src/lib/videoRelighting.js 包含主要补光着色器,src/lib/depthOfField.js 负责深度效果绘制,src/hooks/useDepthOfFieldAnalysis.js 负责分析流程。
如果项目对你有帮助,欢迎在 GitHub 点个 Star。也欢迎带着实际素材反馈问题,或提交改进代码。

