
摘要:当企业 BI 报表越来越多,问题就不再是“有没有报表”,而是“这些报表能不能被管理”。重复建设、无人维护、指标口径不一致、资源依赖不清,都会让 BI 从效率工具变成新的管理负担。
很多企业刚开始做 BI 时,最关心的是能不能快速做出报表。销售看板、经营驾驶舱、库存分析、生产日报,一个个报表上线之后,业务方确实能更快看到数据。
但做到一定规模后,新的问题会出现:报表越来越多,入口越来越乱,类似报表反复出现,同一个指标在不同页面数字不一致,没人说得清哪些报表还在用,哪些只是历史遗留。
这时候,BI 项目的难点已经不只是开发报表,而是管理报表资产。
一、报表数量增长后,企业会遇到什么问题?
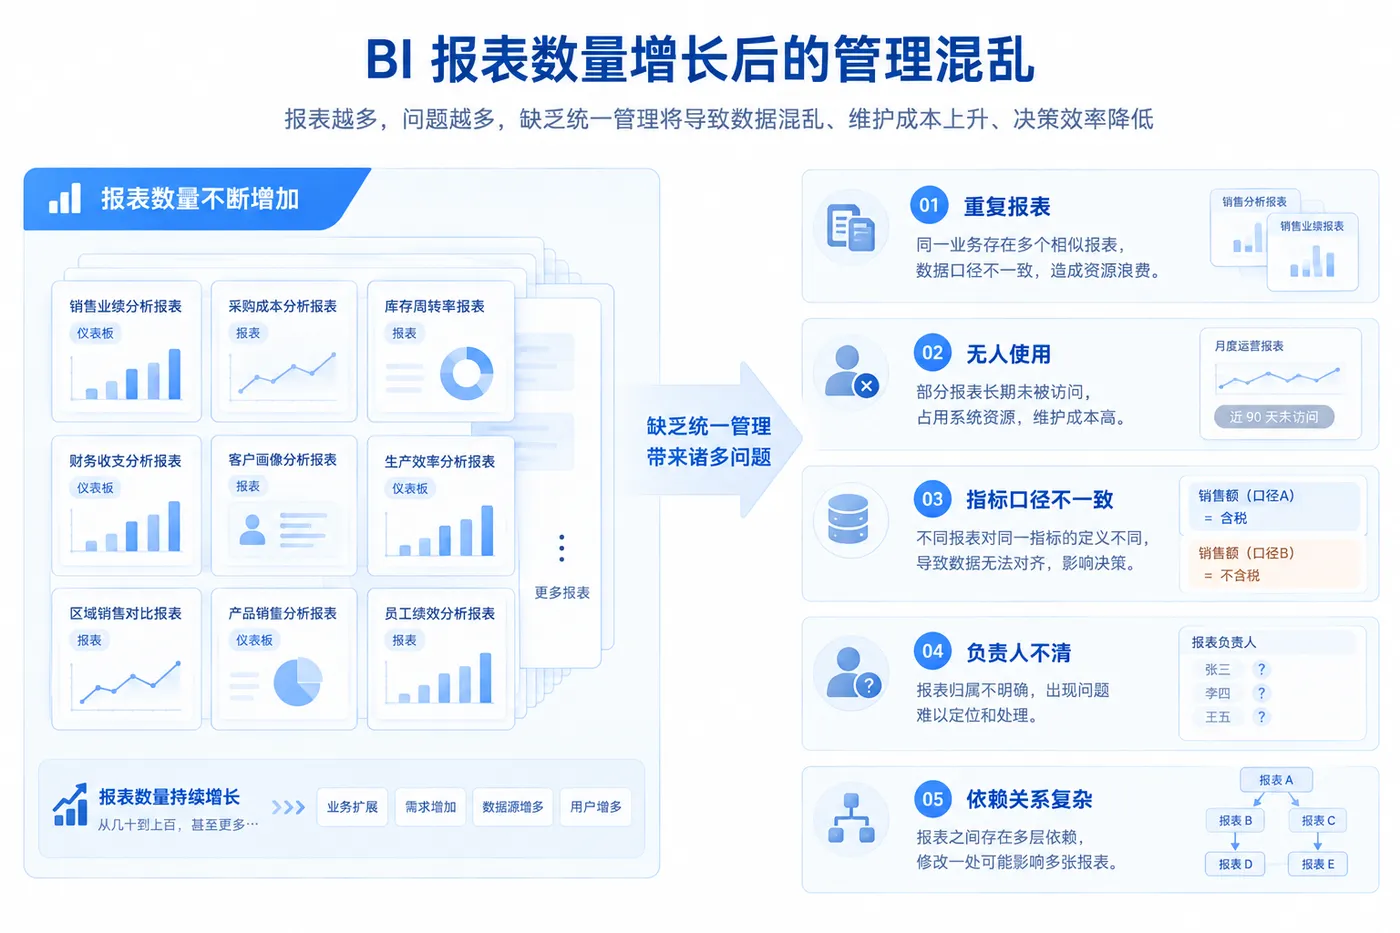
报表少的时候,问题通常比较直接:缺什么就做什么,业务方提需求,开发人员做页面,测试通过后上线。可当报表数量增长到几十张、上百张,管理复杂度会明显上升。
最先出现的是重复报表。不同部门可能围绕同一类业务问题各做一套报表,比如销售分析、订单分析、区域分析,看起来名称不同,底层指标和维度却高度重合。重复报表越多,后续维护越难。
其次是不知道哪些报表还在使用。门户里挂着很多报表,但有些已经几个月没人打开,有些只在某次项目验收时用过,有些业务口径早已过期。如果没有使用情况记录,团队很难判断哪些报表应该继续维护。
第三是相同指标被多次实现。销售额、毛利率、库存周转率、订单完成率这些核心指标,如果在不同报表里各算各的,就很容易出现口径不一致。业务方看到两个不同数字时,第一反应往往不是怀疑口径,而是怀疑 BI 系统不可靠。
第四是负责人不明确。报表是谁做的、谁确认的、谁负责后续维护、口径变化时找谁审批,如果这些信息没有沉淀,报表就会变成“只知道有人在用,但没人真正负责”的灰色资产。
第五是依赖关系复杂。一个报表可能依赖数据源、数据集、数据模型、参数、权限规则和门户入口。修改其中一个资源,可能影响多张报表。看不见依赖关系,就很难评估变更风险。
报表数量增长本身不是问题,真正的问题是:报表增长速度超过了资产管理能力。
二、什么是 BI 报表资产?不只是 Report 和 Dashboard
很多团队理解“报表资产”时,只想到 Report 和 Dashboard。这个理解太窄了。
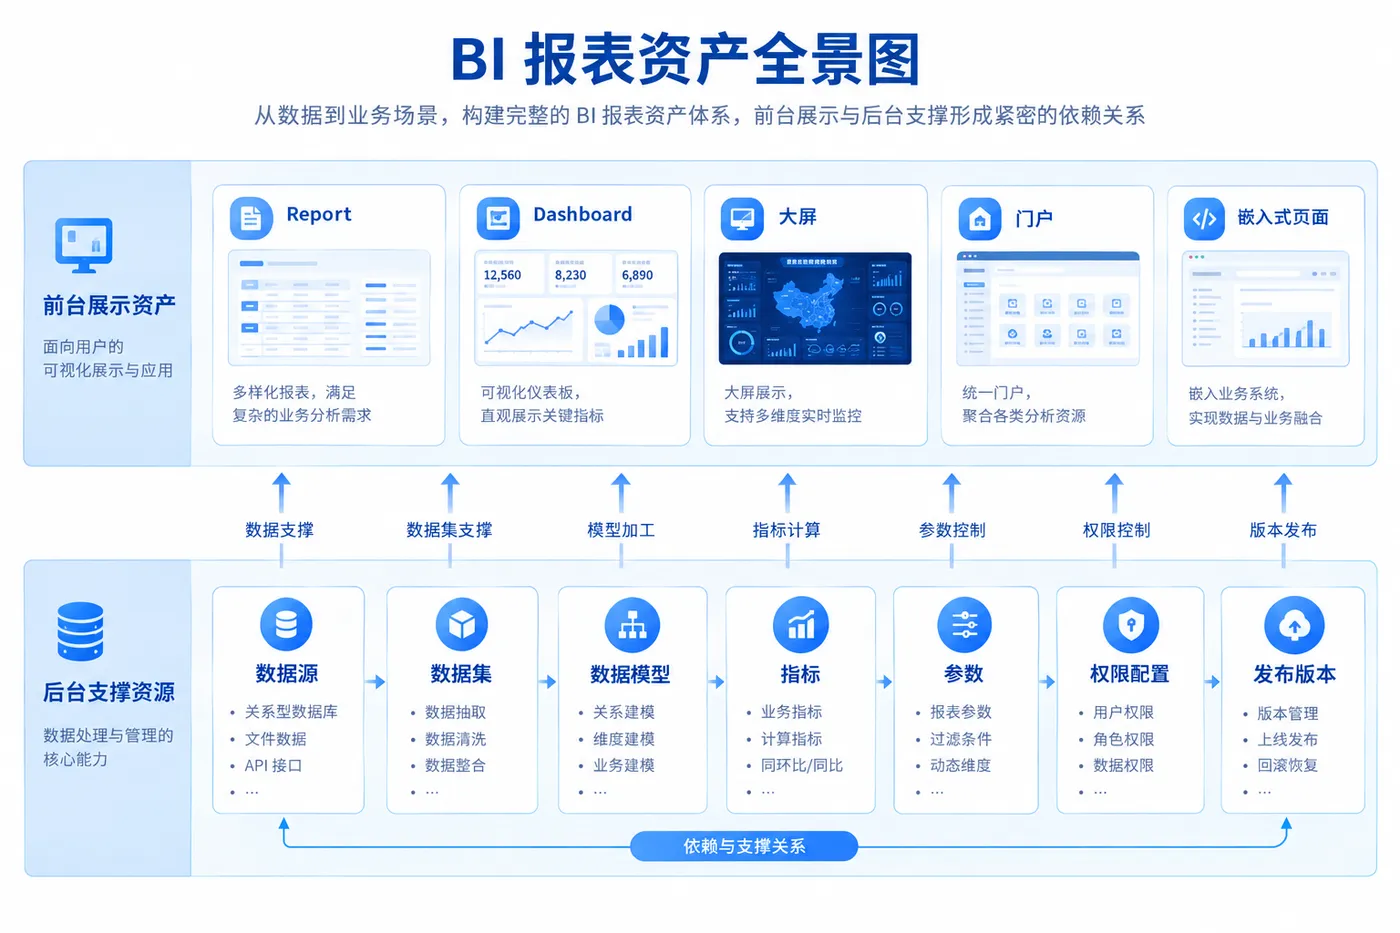
真正的 BI 报表资产,至少包括两层:一层是用户看得见的展示资产,一层是支撑展示的底层资源。
看得见的资产包括 Report、Dashboard、大屏、门户页面、嵌入到业务系统里的分析页面。这些内容直接面对业务用户,是最容易被关注的部分。
看不见的资产同样重要,包括数据源、数据集、数据模型、指标定义、参数、筛选条件、权限配置、发布版本等。它们不一定出现在页面上,却决定报表能不能稳定运行、数字是否一致、用户看到的数据是否正确。
例如,一个经营分析 Dashboard 可能依赖多个数据源,使用共享数据模型,引用统一指标,绑定角色权限,还嵌入在 ERP 或 CRM 的某个菜单中。如果只把页面当成资产,而忽略这些底层资源,后续维护时就很容易“改一处、动全身”。
所以,报表资产管理不是给报表起个名字、放进文件夹这么简单。它要回答的是:这张报表来自哪里,算的是什么,谁在使用,谁负责维护,依赖哪些资源,当前是否仍然有效。
三、报表资产管理最重要的六个维度
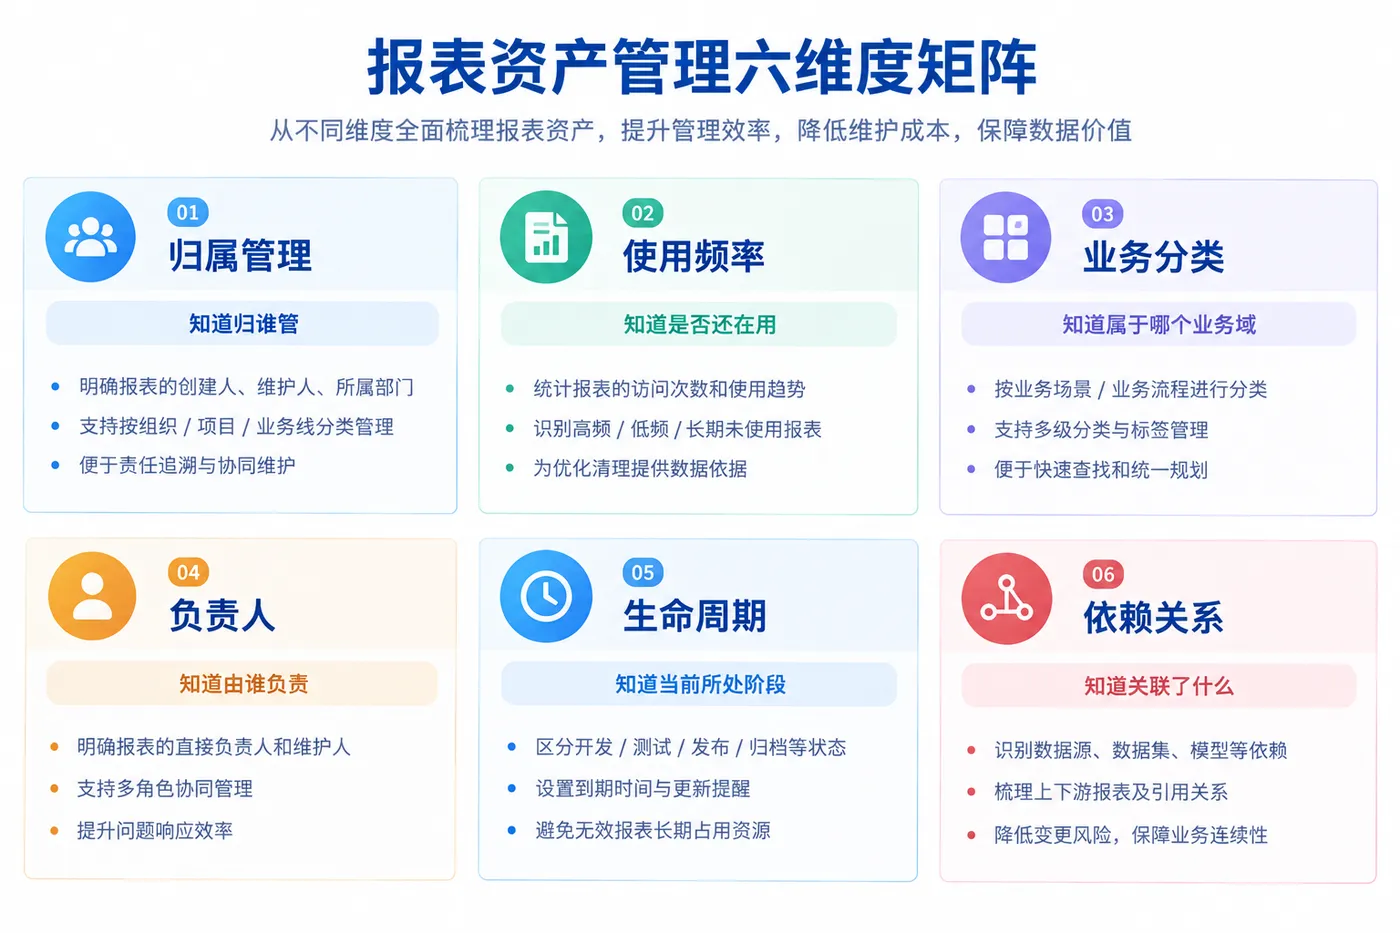
报表资产要管起来,不能只靠文件夹分类。企业至少需要从六个维度建立管理口径。
第一是归属管理。每张报表应该属于某个业务域、部门或项目,而不是散落在个人目录里。归属清楚,后续审批、维护和清理才有对象。
第二是使用频率。经常被访问的报表,说明它仍然承担业务价值;长期无人访问的报表,则需要判断是否过期、重复或已经被替代。使用频率是识别僵尸报表的重要依据。
第三是业务分类。销售、财务、生产、供应链、库存、人力等不同业务域,应该有清晰目录。分类不是为了好看,而是为了让用户能快速找到正确报表,也让管理员能按业务线治理资产。
第四是负责人。报表至少应该有业务负责人和技术负责人。业务负责人确认口径和使用价值,技术负责人负责资源维护和变更落地。没有负责人,报表出问题时就只剩临时救火。
第五是生命周期。报表不应该只有“创建”和“存在”两种状态。它可以处于设计中、测试中、已发布、维护中、待归档、已废弃等不同阶段。状态清楚,管理动作才清楚。
第六是依赖关系。报表依赖哪些数据源、数据集、模型、指标、权限和发布入口,应该能被记录和追踪。否则任何一次底层资源调整,都可能变成一次不可控变更。
中小规模阶段,团队可以靠经验维护这些信息;一旦报表规模扩大,就必须把经验变成机制。
四、如何识别和清理“僵尸报表”?
BI 做久了,几乎都会出现僵尸报表。它们不一定已经坏掉,但已经不再产生稳定价值,甚至会干扰用户判断。
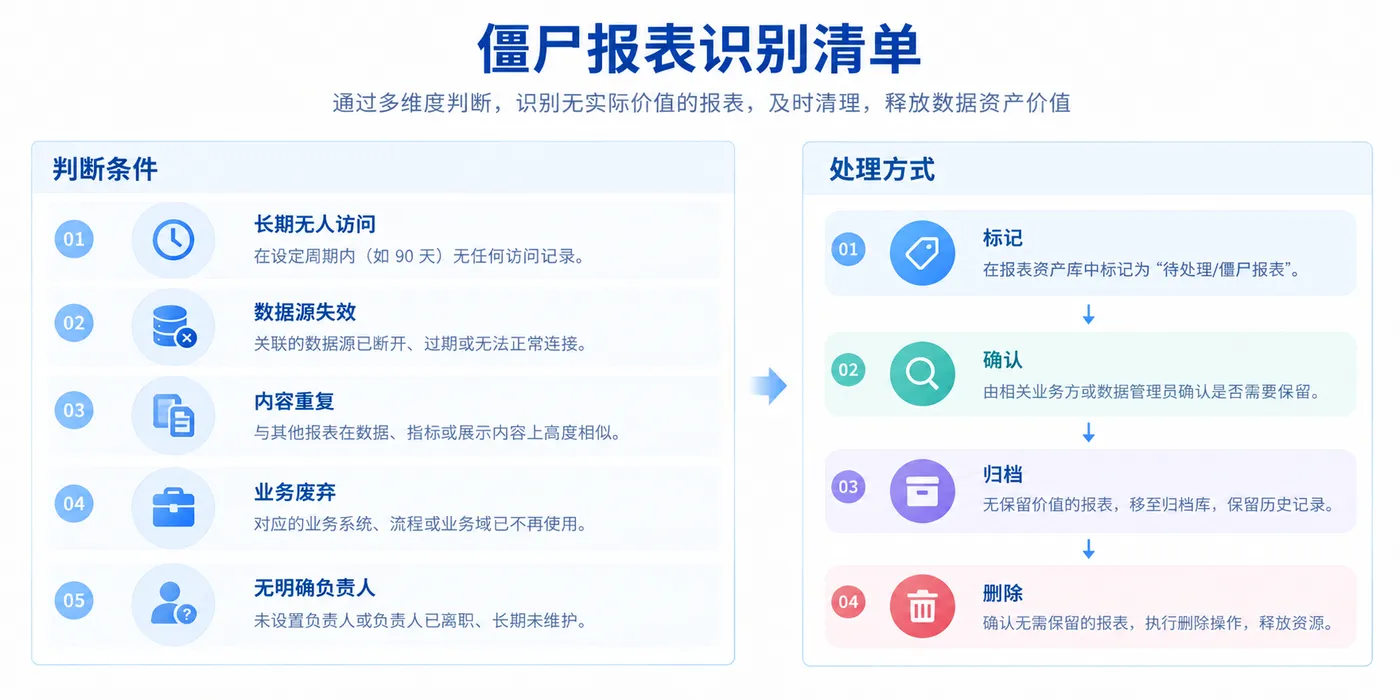
第一类是长期无人访问的报表。如果一张报表几个月没人打开,就应该进入复核清单。它可能已经被新报表替代,也可能只是某个临时项目的遗留物。
第二类是数据源已经失效的报表。页面还在,入口还在,但底层数据源已经迁移、字段已经变化、连接已经不可用。这样的报表继续留在门户中,只会制造错误预期。
第三类是内容重复的报表。两个报表名称不同,但指标、维度、筛选条件几乎一样。重复报表会让用户不知道该信哪一个,也会让维护人员重复修改同一类逻辑。
第四类是业务已经废弃的报表。某条业务线已经停止,某个项目已经结束,某个组织口径已经调整,但相关报表还在继续展示旧逻辑。这类报表最容易造成“旧口径继续被引用”。
第五类是没有明确负责人的报表。没人确认口径,没人处理问题,没人决定是否下线。这样的报表即使还有人访问,也处在管理风险中。
清理僵尸报表不是简单删除。更稳妥的方式是先标记、再确认、再归档,最后根据规则删除。对于关键报表,还需要确认是否有用户仍在依赖、是否存在替代报表、是否需要保留历史版本。
真正成熟的 BI 管理,不只是不断地新增报表,也要有能力让过期报表退出。
五、Wyn 中如何管理企业 BI 资源?
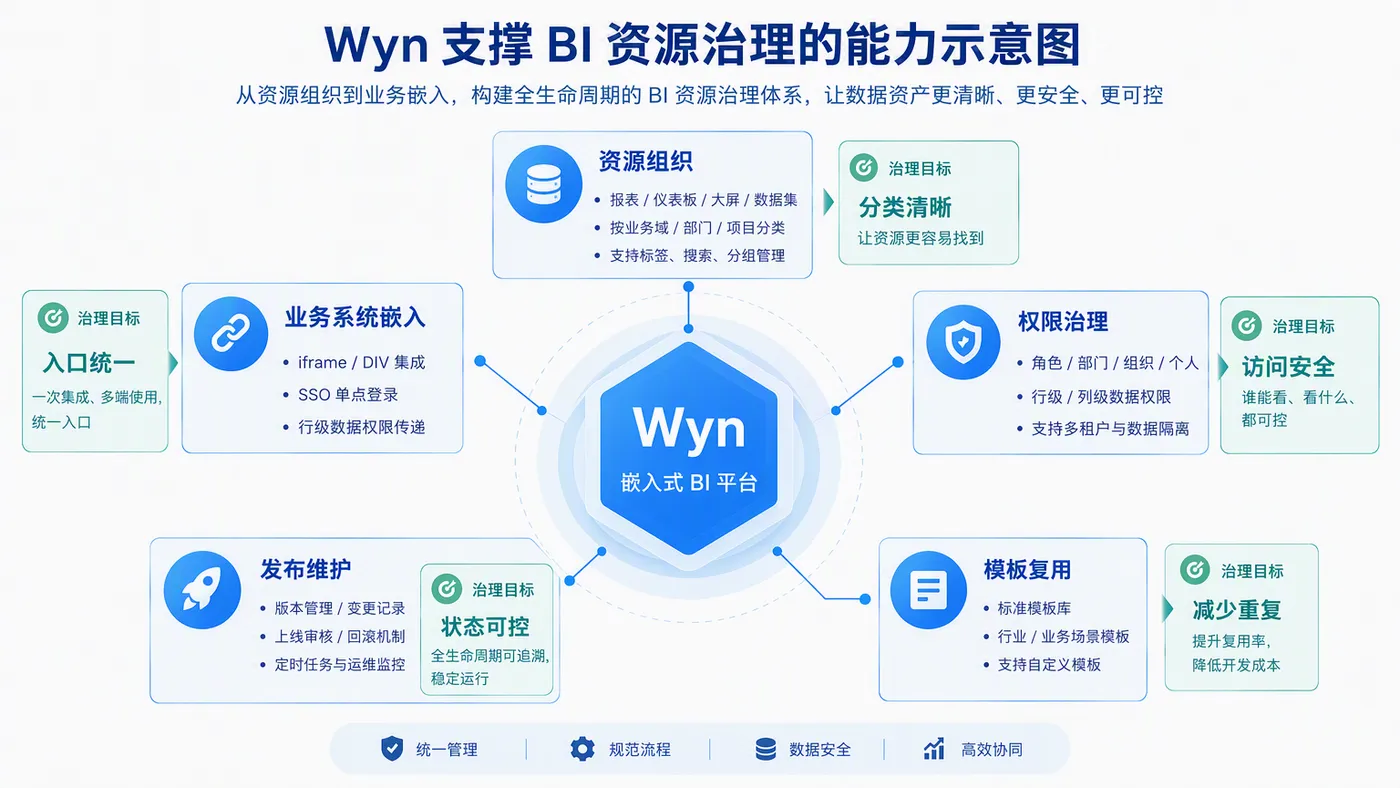
当 BI 从几张报表发展到企业级分析体系,平台能力就不能只停留在“能做图表”。资源组织、权限控制、复用机制、发布管理和后续维护,都要成为 BI 平台的一部分。
Wyn 商业智能定位于嵌入式 BI,围绕多源数据整合、数据可视化、在线报表设计、嵌入式分析、系统管理等能力,支撑企业把 BI 嵌入 ERP、CRM、生产管理、供应链等业务系统。对于报表资产管理来说,这类平台能力的重点不是“做一张报表”,而是“管理一组持续运行的 BI 资源”。
从资源组织角度看:Wyn 中可以围绕文档门户、工作空间、分类等方式组织报表、仪表板和相关资源。对于企业来说,这有助于把散落的分析内容按业务域、部门或使用场景归类,减少用户找不到报表、管理员管不清资源的问题。
从权限治理角度看:报表资产必须和用户、角色、组织结构关联。不同角色看到哪些报表、访问哪些数据、能否编辑或发布,都应该被统一管理。权限能力不是附属功能,而是报表资产能否安全复用的前提。
从复用角度看:报表模板、共享数据资源和统一指标口径非常关键。资料中可以看到 Wyn 支持报表模板相关能力,这类机制适合把常用分析结构沉淀下来,减少重复建设。对企业来说,复用不仅能提高开发效率,更能降低维护成本。
从发布和维护角度看:BI 资源需要经历创建、测试、发布、变更、归档等过程。Wyn 的系统管理、资源组织和嵌入式集成能力,可以帮助企业把报表资源纳入更完整的管理流程,而不是把每张报表都当成孤立文件处理。
六、总结:BI 做大以后,管理报表资产和开发报表同样重要
BI 项目早期,企业最关心的是“能不能把报表做出来”。但做到一定规模后,真正影响效率和可信度的,往往是“报表资产有没有被管理好”。
如果重复报表没人清理,核心指标各算各的,负责人不明确,依赖关系不清楚,报表越多,企业越难从中获得稳定价值。看起来 BI 建设很热闹,实际却可能制造出新的管理负担。
报表资产管理要解决的不是一个技术细节,而是一套治理问题:每张报表归谁管,谁在用,是否还有效,依赖哪些资源,什么时候应该变更,什么时候应该归档。
当企业能说清楚这些问题,BI 才真正从“报表开发工具”升级为“数据资产管理能力”。
下一次再新增一张报表前,不妨先问一句:这张报表未来归谁负责,和已有报表是否重复,底层指标是否统一,三个月后还能不能被准确找到和维护?
关键词:BI 资产管理 / 报表治理 / 数据可视化 / 嵌入式 BI / Wyn 商业智能 / 权限管理 / 报表复用 / 企业数字化


