
内容生产两件套:huashu 管「确定的画面」,RunningHub 管「一致的声音」
做内容这几年,我最怕两类返工:一张带文字的封面,生图工具把字写错、排版漂移、原始照片被重画得不像;还有 一支多角色配音的短片,同一个角色的声音越到后面越「变了一个人」。
前者是画面问题,后者是声音问题。这两个坑,分别被两个工具填平了:本地渲染的 huashu,和 RunningHub 上的声音设计工作流。这篇把它们放在一起讲,正好凑成一条「画面 + 声音」的内容生产管线。
一、huashu:平替生图 API,做封面信息图和 PPT 解说
huashu 是什么,不是什么
开源地址:
https://github.com/alchaincyf/huashu-art-motion
使用方法:
1、把代码下载下来zip包,大概5mb
2、把zip包给豆包工作,或者deepseek harness等智能体,让它们安装即可
一般来说会自动安装python、uv、ffmpeg、chrome浏览器等。
huashu 是一套本地运行的「代码动画」渲染工具。一句人话:把你要的版面写成一段 JSON,它按帧渲染出时长精确、文字准确的动画。
它不是生图模型,不「猜」内容;它更像一个排版引擎,把文字、图表、素材按你写好的规则摆放。它也不替代生图 API 去画「想象出来的插画」—— 两者分工不同。
一份 JSON,出一段时长精确的动画
huashu 的玩法是写一个 spec 片段:时长、帧率、分辨率、一组 cue(时间点 + 动作),再喂一张本地素材图。它内置 8 种动画语法,从 Kurzgesagt 风、桌面拼贴、白板,到发布会界面、财经图表。
渲染前先抽几帧静态预览,确认版面对了再出整段。确定性是它最大的价值:字不会写错,位置不会漂,改一次 JSON 就能精确微调。
用它做「封面信息图」
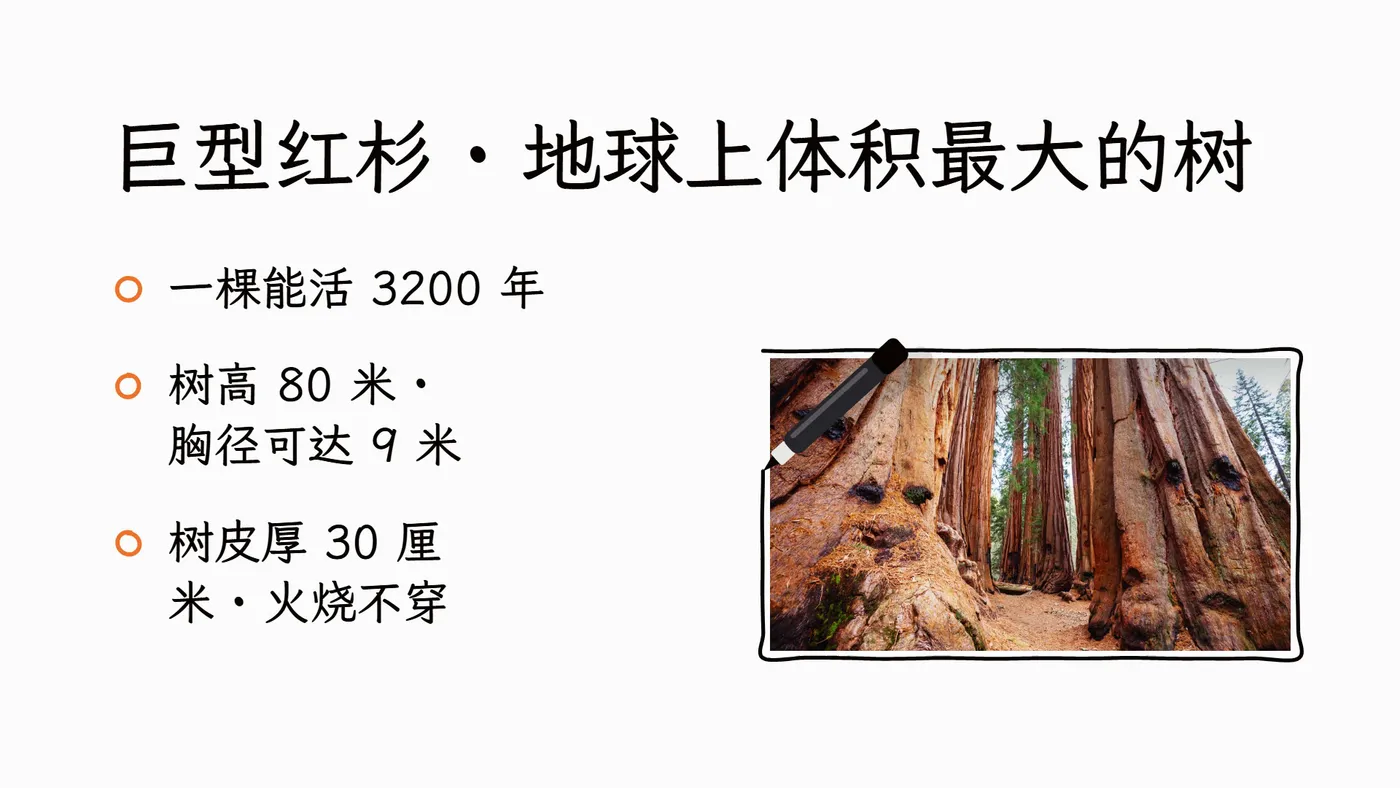
带原始图片的封面信息图,正好是 huashu 的强项。把一张巨杉实拍图丢进白板语法,配三行要点和一个标题,最后拉远看全图 —— 一屏就得到了「标题 + 要点 + 原始照片」的完整封面。
要点:文字由你写死,照片原样保留,排版可复现。 这张图既是封面,也能直接当正文配图用。
用代码画出来的: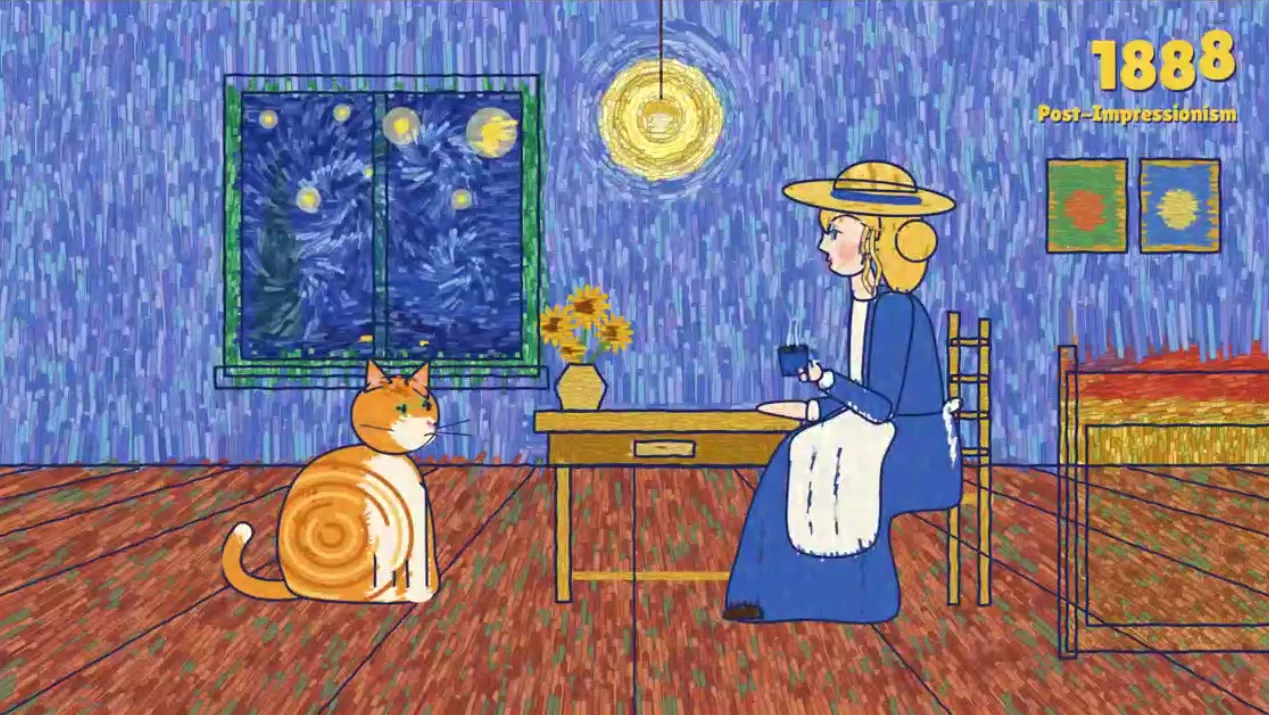
文字、审美在线:
用它做「PPT 解说」
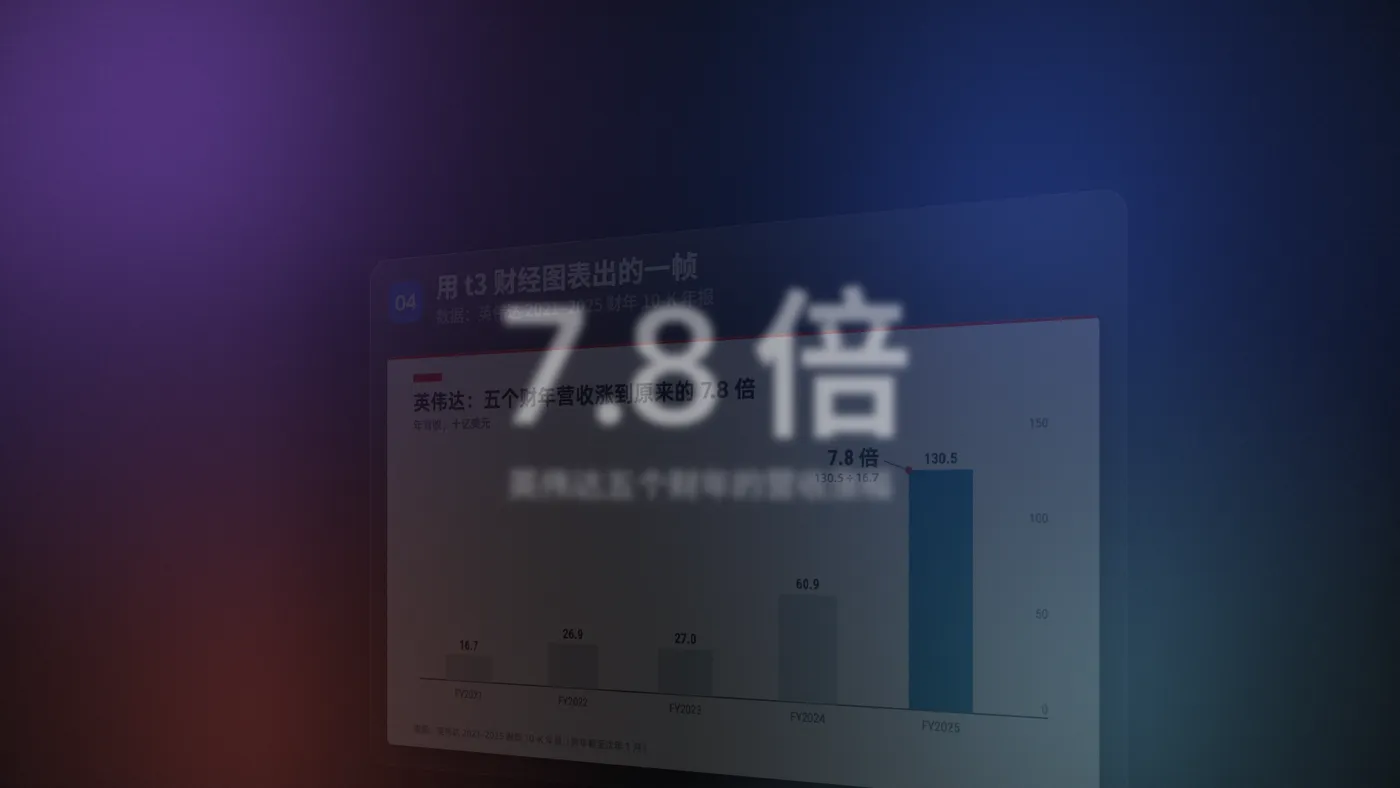
要做「发布会式」的 PPT 解说,用它的发布会界面语法:深色光斑底、玻璃卡片、一个放大的关键数字。信息层级清楚,节奏可精确到帧,适合产品发布、讲解、口播配画。
它不像生图那样给你一张「看起来对、字却是错的」图,而是给一页能直接放进讲解的确定画面。
什么时候该用它
判断标准就一条:这个画面需不需要「讲清楚」。 需要精确文字、固定排版、素材保真 —— 用 huashu;需要想象力、氛围、没有严格文字要求的插画 —— 继续用生图 API。
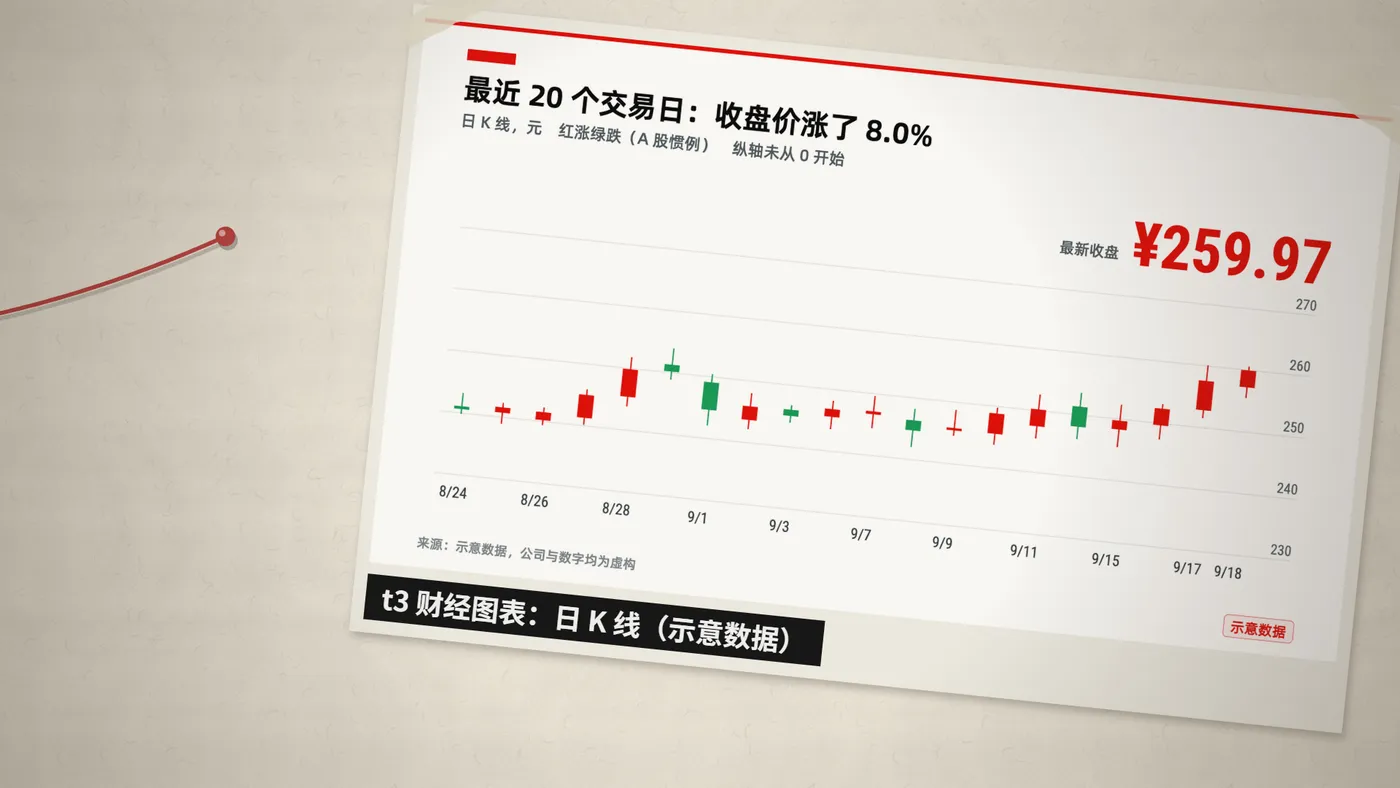
桌面拼贴风格适合把「数字 + 图表 + 素材」摆在同一张画面上,也是 huashu 的常用形态。
二、RunningHub 声音设计工作流:短剧多角色声音一致性
画面确定之后,声音是下一个坑。做短剧、多角色配音或解说片时,最烦的不是「配音难」,而是同一个角色越到后面声音越不像。
RunningHub 上这个 「声音设计(用于短剧多角色声音一致性)」 工作流,解决的就是这个问题:先用一段提示词把目标声线「设计」出来,再让每个角色按这个声线克隆输出,保证全程音色一致。
- 体验地址:
https://www.runninghub.cn/ai-detail/2090440149267210242?inviteCode=oga1ahgc](https://www.runninghub.cn/ai-detail/2090440149267210242?inviteCode=oga1ahgc
- 粉丝福利:邀请码
oga1ahgc可领 1,000 RH 币,每日登录再领 100 RH 币。
它怎么用:两个节点
工作流本质是两个输入,一个「定声线」,一个「出文本」:
- 声音设计提示词:描述目标音色、声线、年龄感、情绪。例如 ——
20-24岁清冷柔弱女声,音色温柔灵动。音量偏轻,情绪淡,易碎感。
- 克隆声音输出:要朗读 / 配音的文本。例如 ——
你知道吗?昨天傍晚我在街边散步,忽然吹来了一阵清凉的晚风。我停下脚步,望着天边的晚霞,心里感到十分放松。生活里那些细碎美好的瞬间,总是值得我们用心感受。
同一个角色的所有台词,都用同一条声音设计提示词 + 不同文本去跑,声音就稳定统一;换角色就换一套提示词。
API 用法:一条 curl
在代码里调用,直接 POST 到工作流的 API 端点:
curl --location --request POST 'https://www.runninghub.cn/openapi/v2/run/ai-app/2090440149267210242' \
--header "Content-Type: application/json" \
--header "Authorization: Bearer ${RUNNINGHUB_API_KEY}" \
--data-raw '{
  "nodeInfoList": [
    {
      "nodeId": "3",
      "fieldName": "prompt",
      "fieldValue": "20-24岁清冷柔弱女声,音色温柔灵动。音量偏轻,情绪淡,易碎感。",
      "description": "声音设计提示词"
    },
    {
      "nodeId": "5",
      "fieldName": "prompt",
      "fieldValue": "你知道吗?昨天傍晚我在街边散步,忽然吹来了一阵清凉的晚风。我停下脚步,望着天边的晚霞,心里感到十分放松。生活里那些细碎美好的瞬间,总是值得我们用心感受。",
      "description": "克隆声音输出"
    }
  ],
  "instanceType": "default",
  "usePersonalQueue": "false"
}'
把 ${RUNNINGHUB_API_KEY} 换成你在 RunningHub 后台申请的 API Key 即可。一次请求返回一段配音结果,可以批量循环多角色。
三、视觉 + 声音,拼成一条内容管线
把两套工具串起来,就是一条完整的内容生产管线:
画面:用 huashu 把信息图封面、PPT 解说、讲解动画做「确定」,一次成型不改字、不漂版。
文本:按角色写好评词 / 台词,给每个角色定一条声音设计提示词。
声音:用 RunningHub 声音设计工作流,逐角色、逐段克隆配音,全程音色一致。
合成:画面 + 配音 + 字幕,拼成成片。
下次要做带文字的封面,别再跟生图模型猜了;要让角色声音不跑调,也别再一个个手动找音色了。 一个管画面,一个管声音,剩下的交给流程。


