
OpenRouter 上架 + 社区玩法 + GovTech 护栏评测,落到企业「守门员」场景;正文零产品名,结尾带出活字格
两周前刷屏的那个「不聊天的 AI 模型」Jev,热度没有散,反而越滚越实。
9 月 18 日,它上架了 OpenRouter——一个 OpenRouter 密钥就能调用,不用再排 TypeSafe 的早期访问队列。社区这边更热闹:有人专门建了个叫 Jevable 的网站收集玩法,从给表格打紧急度评分,到一次决策成本 0.0011 美元的虚拟试衣,甚至有人拿它模拟 CPU,管这叫「JevOps」。有工程师用一万次 API 调用做探测,推测它是直接从内部表征算概率的;Karpathy 在 X 上说,Jev 满足了大家对「单 token、低延迟 LLM」的潜在需求。
但这些都不是这两周分量很重的信号。分量很重的信号,来自新加坡。
官方技术团队下场了
新加坡政府科技局(GovTech)的官方技术博客发了一篇文章:他们拿 Jev 和一个开源版替代项目 Kev(用开源模型把 Jev 的玩法重新实现一遍,社区管这类项目叫「复现」),做内容审核护栏(guardrails)的评估,对比对象是政府自研的多语言审核模型 LionGuard 2.1,跑的基准包括本地的 RabakBench 和国际通用的安全测试集。
注意这不是开发者玩票,是一个政府级技术团队,把决策模型放进了和自研生产系统同台对比的评估流程里。他们看中的点说得很直白:传统分类器要为每个任务单独训练,标签空间是写死的;决策模型的问题和选项在调用时才定义,同一个模型可以零样本切到不同的判断任务上——审核今天是拦越狱提示,明天可以换成分级投诉,模型不用重训。
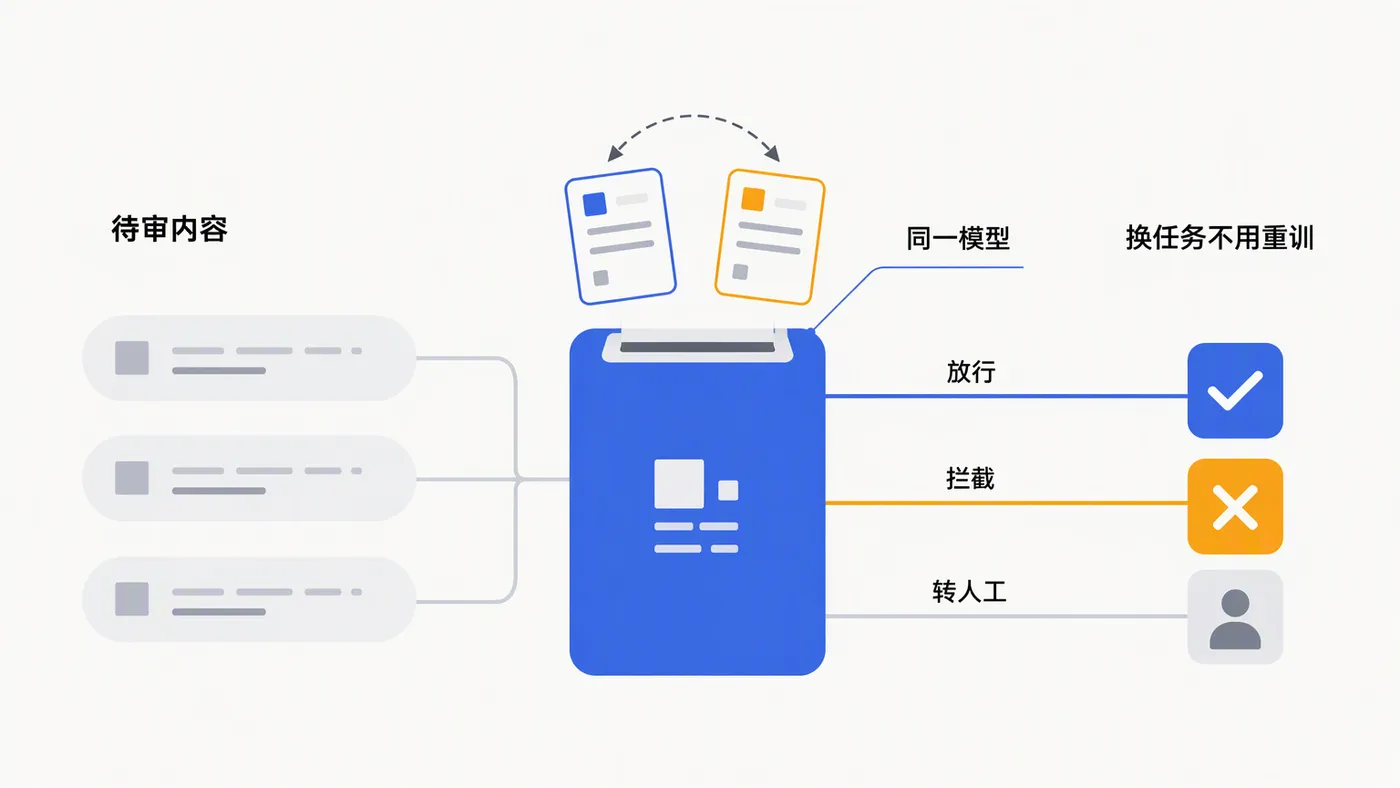
政府团队做的事情,翻译过来就是:判断一个东西该不该放行,这个岗位可以交给决策模型了。
守门员岗位,企业系统里到处都是
「护栏」这个词听起来是安全团队的行话,实际上每个企业系统里都养着一批这样的岗位:
报销单进来,先判断有没有超标、要不要加签——这是财务的守门员。表单提交前,判断必填项的逻辑关系对不对、数据合不合规——这是流程的守门员。客服消息进来,判断是投诉还是咨询、要不要立刻升级——这是体验的守门员。数据写入主库前,判断格式和取值靠不靠谱——这是质量的守门员。
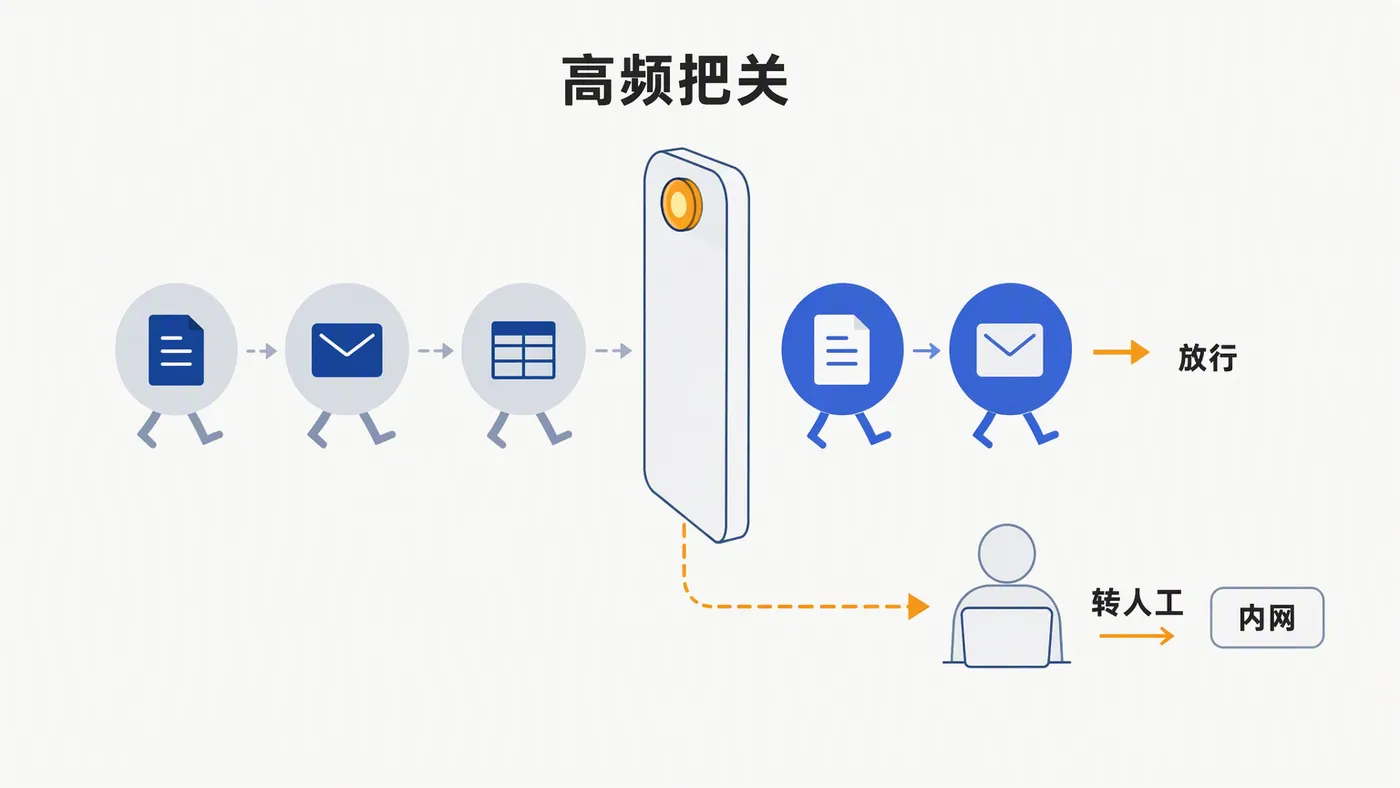
这些岗位的共同点是:高频、选项封闭、判断错了有人兜底。以前它们要么靠人盯着,要么靠一堆写死的规则硬扛,规则跟着业务越堆越厚,改一次动一片。决策模型盯上的正是这层:判断逻辑跟着提示词和选项走,业务变了改配置,不用改代码。
国内团队的现实路径
账面上很美好,门槛也还是那几道。Jev 本体是闭源托管服务,判断请求要出网,按央广网报道尚未向中国大陆开放。上架 OpenRouter 降低了调用门槛,没有改变数据出网这个事实——对数据不能出门的企业,这条路依然走不通。
值得玩味的是新加坡那篇文章的做法:他们同时测了 Jev 和开源版 Kev。政府团队的口径等于公开承认,开源版是一条平行的、可评估的路径。开源版生态这两周也争气:48 小时六个项目,跑得较快的 SemIf 已经把后端铺到了 CPU 上,没有 GPU 的内网服务器也能跑。
这就把国内企业的路径走通了:开源决策模型部署在内网,判断请求不出自己的机房。这条链路我们自己跑过——接入点在低代码平台活字格的服务端命令上。护栏类判断接进去之后,就是 AI 工作流编排里的一个节点:大模型管慢思考,决策模型管高频把关,拿不准的转人工,三类节点画在同一张流程图上,业务调整了改编排,不用改代码。
热点会过去,岗位会留下
两周时间,Jev 从热榜话题长成了一个小生态:官方上架聚合平台,开源版项目成群,政府团队下场评估。对搭业务系统的人来说,真正该记住的画面是新加坡那个评估场景——决策模型和自研生产系统跑同一套基准,争的是同一个岗位。
企业系统里的守门员岗位一直都在,只是第一次有了又便宜、又听话、还能住在内网里的候选人。
如果你的审批流、表单校验、工单分诊也想配一个这样的「守门员」,点击「阅读原文」,看看低代码平台怎么把 AI 工作流编排变成配置项。


