
03 · 权重条带缓存与融合权重
一句话:CUDA 后端不引入第二套量化格式,直接复用引擎里已有的 strip-cache(宿主侧逐行 int8 码 + 逐块 float scale),只在设备上补一次转置;再把「每个权重一次」的上装成本从首次 prefill 挪到模型加载期。
前置:建议先读 第 02 篇 · 架构边界。
环境:x86-64 + NVIDIA RTX 5090(sm_120)· 阶段一 2B 稠密(Qwen3-VL-2B q8)/ 阶段二 8B(Qwen3-VL-8B q4)。
一、问题与结论
| 问题 | 做法 | 判定 |
|---|---|---|
| 要不要为 GPU 单独转一套量化产物? | 复用引擎 strip-cache,CUDA 与 NPU 消费同一份 artifact | 实测:无需模型转换 |
strip-cache 是 [N][K],内核要 K-major |
上传后在设备上做一次 32×32 tiled 转置 | 实测可行 |
| 每个权重要一次上装,成本落在首次 prefill | 设备权重缓存 + 加载期全量预热 | 实测:成本移出计时窗口 |
| Q/K/V 三个权重各存一份 | col_off 把三个转置进同一块缓冲的列区间 |
实测:融合权重一次转置 |
| 驱逐权重时怎么释放显存? | 走设备缓冲池,不用 cudaFree |
实测:cudaFree 同步更贵 |
二、背景
阶段一的第一个决策是「不引入第二套量化格式」。引擎里已经有一套量化产物:宿主侧的 strip-cache(st_npu_gw_t)——它原本是给 RK3588 NPU 后端用的,形态是布局无关的:
Wq[N*K]:int8 权重码(int4 权重存[-8,7],int8 权重存[-127,127])bsc[N*K/G]:每个输出行、每个 K-block 的 float scaleG:分组宽度(Q8_0/Q4_0 是 32,g256 模式是 256)
关键在于这个契约与后端无关——NPU 和 CUDA 消费同一份 [N][K] int8 + [N][K/G] float。于是 CUDA 后端不需要任何模型转换,直接读 strip-cache:这是「同一 artifact 喂两个后端」的设计。
构建入口是宿主侧的 st_npu_gw_build() / st_npu_gw_build_q4(),分组宽度 blk 在 Q8_0 默认 32、g256 模式 256:
/* 文件:src/model/vllm_safetensors.c(st_npu_gw_build,节选) */
int wm = st_wmode_effective();
int blk = (wm == 4) ? 256 : 32;   /* gw block width (== activation G) */
int G = K / blk;
...
e->Wq  = (int8_t *)xq_alloc_canary((size_t)N * K);
e->bsc = (float  *)xq_alloc_canary((size_t)N * G * sizeof(float));
...
vllm_gw_ctx gw = {
    e, q8_w, K, N, G, blk, layer, proj, row_stride };
vllm_tp_parfor(0, N, vllm_gw_row_worker, &gw);   /* 逐行解包(Q4 走 4x4 repack) */
三、核心机制
3.1 为什么还要设备端转置
strip-cache 是 [N][K](行 = 输出通道)布局,K-major。但分组 GEMM 内核每个线程负责固定的几列输出,沿 K 扫——它需要 [K][N] 的 K-major 视图,这样同一步里 warp 的 32 个线程能读到连续的 128 字节。
所以上传后要在设备上做一次转置。两个版本(int8 权重码、float scale)结构一样,tile 32×32,共享内存 +1 防 bank conflict:
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(k_transpose_i8 / k_transpose_f32,节选) */
/* [R][C] -> [C][Rpad], int8. Tiled with a bank-conflict-free +1 pad.
 * col_off shifts the destination column so several weights can be transposed
 * into disjoint column ranges of ONE fused [K][Rpad] buffer. */
__global__ void k_transpose_i8(const int8_t *__restrict in,
                               int8_t *__restrict out,
                               int R, int C, int Rpad, int col_off) {

    __shared__ int8_t t[VC_TT][VC_TT + 1];
    const int x = blockIdx.x * VC_TT + threadIdx.x;   /* input column */
    const int y = blockIdx.y * VC_TT + threadIdx.y;   /* input row    */
    if (x < C && y < R) t[threadIdx.y][threadIdx.x] = in[(size_t)y * C + x];
    __syncthreads();
    const int ro = blockIdx.x * VC_TT + threadIdx.y;  /* out row = in column */
    const int co = blockIdx.y * VC_TT + threadIdx.x;  /* out col = in row    */
    if (ro < C && co < R)
        out[(size_t)ro * Rpad + col_off + co] = t[threadIdx.x][threadIdx.y];
}
k_transpose_f32 是 scale 的对应版本,逻辑逐行相同,只是元素类型换成 float。
3.2 col_off:一次转置写进同一块缓冲
col_off 是这次转置的目标列偏移。有了它,Q/K/V 三个权重可以转置进同一个 [K][NG] 缓冲的不相交列区间,形成融合权重:
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(vc_fused_ensure,节选) */
int off = 0, ok = 1;
for (int i = 0; i < n_out && ok; ++i) {

    const size_t wt_src = (size_t)Ns[i] * (size_t)K;
    const size_t bs_src = (size_t)Ns[i] * (size_t)(K / G) * sizeof(float);
    ...
    k_transpose_i8 <<<grid_w, blk>>> (s->dScrI, e->dWT,  Ns[i], K,       NG, off);
    k_transpose_f32<<<grid_s, blk>>> (s->dScrF, e->dbsT, Ns[i], K / G,   NG, off);
    off += Ns[i];
}
约束是每个 Ns[i] 必须是 VC_VEC(=4)的倍数,这样拼接后的列没有空隙(NG == ΣNs),内核单一的行跨距才成立;不满足时宿主层退回逐投影路径。
3.3 Npad:尾部零填充
Npad = (N + VC_VEC-1) & ~(VC_VEC-1),即 N 向上对齐到 4 的倍数。分配的缓冲要 cudaMemset 清零——填充列 [N, Npad) 必须读作 0,否则向量化的尾部 store 会写进错的数据:
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(vc_ent_alloc,节选) */
e->Npad    = (N + (VC_VEC - 1)) & ~(VC_VEC - 1);
e->ngroups = K / G;
const size_t wt_bytes = (size_t)K * (size_t)e->Npad;
const size_t bs_bytes = (size_t)e->ngroups * (size_t)e->Npad * sizeof(float);
...
if (cudaMemset(e->dWT, 0, wt_bytes) != cudaSuccess ||
    cudaMemset(e->dbsT, 0, bs_bytes) != cudaSuccess) {
    ... }
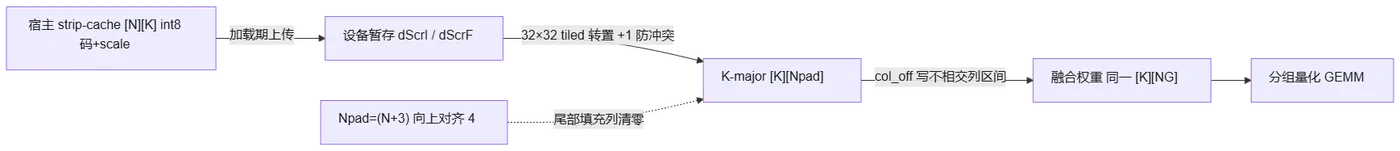
图 1:权重从宿主 strip-cache 到设备融合缓冲的变换链。宿主侧
[N][K]的 int8 码 + float scale(Q8_0 分组 32、g256 分组 256)上传后在设备上做一次 32×32 tiled 转置(共享内存+1防 bank conflict)变成内核要的 K-major;col_off把 Q/K/V 的转置写进同一个[K][NG]缓冲的不相交列区间形成融合权重;Npad=(N+3)&~3的尾部填充列必须cudaMemset清零,否则向量化 store 会写错数据。
3.4 权重身份:wkey
每个权重有一个稳定身份 (layer << 32) | (proj + 1):
/* 文件:src/model/vllm_safetensors.c(st_cuda_wkey,节选) */
static uint64_t st_cuda_wkey(int layer, int proj) {

    return ((uint64_t)(uint32_t)layer << 32) | (uint32_t)(proj + 1);
}
+1是为了让(layer 0, proj 0)非零——wkey == 0保留给「不缓存」。- 不把 layer 做 sentinel 重映射,而是原样放在高 32 位——驻留窗口要用它精确解码层号(见 3.5)。
设备侧用同一约定(src/npu/cuda/vllm_cuda_kernels.cu 里注释与宿主 st_cuda_wkey 显式对齐)。融合权重与 lm_head 用哨兵:
| 哨兵 | 值 | 含义 |
|---|---|---|
ST_CUDA_FUSED_QKV |
100 | Q/K/V 三合一 |
ST_CUDA_FUSED_GU |
101 | gate+up 二合一 |
ST_CUDA_LMHEAD_LAYER |
0x7FFFFFF0 | lm_head 的层号(永不驱逐) |
3.5 缓存与缓冲池
权重缓存是一个 512 槽的 LRU(VCUDA_MAX_ENTRIES),预算是设备空闲显存的一半、上限 24 GiB、下限 256 MB(在 vcuda_dev_create() 里定)。
这里有个实测来的教训:驱逐不要 cudaFree。
驱逐时的
cudaFree是设备同步操作,在驻留窗口下每层发生一次。实测这笔开销比窗口想换取的「重新上传」还贵——keep=1..16 全部落在 159~184 ms/tok,几乎与 keep 无关。把缓冲放进池子(VCUDA_POOL_MAX=128槽),驱逐退化成 O(1) 指针移动。
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(vc_ent_release,节选) */
if (e->dWT && e->dbsT && s->n_pool < VCUDA_POOL_MAX &&
    e->Npad > 0 && e->ngroups > 0) {

    s->pool[s->n_pool].dWT      = e->dWT;
    s->pool[s->n_pool].wt_bytes = (size_t)e->K * (size_t)e->Npad;
    s->pool[s->n_pool].dbsT     = e->dbsT;
    s->pool[s->n_pool].bs_bytes = (size_t)e->ngroups * (size_t)e->Npad * sizeof(float);
    s->pool[s->n_pool].Npad     = e->Npad;
    s->pool[s->n_pool].ngroups  = e->ngroups;
    s->n_pool++;
    e->dWT = NULL; e->dbsT = NULL; e->bytes = 0;
    return;
}
池复用要求几何完全一致(Npad 与 ngroups 都相同),这样布局逐字节匹配:
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(vc_ent_alloc,节选) */
for (int i = 0; i < s->n_pool; ++i) {

    if (s->pool[i].Npad == e->Npad && s->pool[i].ngroups == e->ngroups &&
        s->pool[i].wt_bytes >= wt_bytes && s->pool[i].bs_bytes >= bs_bytes) {

        e->dWT  = s->pool[i].dWT;
        e->dbsT = s->pool[i].dbsT;
        s->pool[i] = s->pool[s->n_pool - 1];
        s->n_pool--;
        pooled = 1;
        break;
    }
}
3.6 驻留窗口:VLLM_CUDA_STREAM
显存装不下整模型时,需要一个「设备侧逐层驻留」。引擎已有宿主侧的逐层驻留(VLLM_VQF_STREAM),GPU 侧在同一个边界钩子上推进,两边锁步。
规则是只驱逐过去、保留现在与未来:
驱逐 layer < cur_layer - keep + 1 的所有权重;lm_head 永不驱逐。
/* 文件:src/npu/cuda/vllm_cuda_kernels.cu(vcuda_dev_wcache_window,节选) */
const int lo = cur_layer - keep + 1;
for (int i = 0; i < VCUDA_MAX_ENTRIES; ++i) {

    vc_wentry_t *e = &s->ent[i];
    if (!e->used) continue;
    if (e->layer >= VCUDA_LMHEAD_LAYER) continue;   /* lm_head: always keep */
    if (e->layer >= lo) continue;   /* current + all upcoming: keep */
    s->bytes -= e->bytes;
    vc_ent_release(s, e);
    e->used = 0; e->key = 0;
    s->n_ent--; s->n_evict++; evicted++;
}
为什么不对称?因为一层循环只向前扫——cur 之上的层马上要用,cur-keep+1 之下的层本轮已经消费完。实测「两侧都驱逐」会让代价与 keep 无关(每层每 token 都重传),「只驱逐过去」才按预期缩放。
契约是 cache-population only:驱逐只改变「在不在显存」,不改变任何 GEMM 的输入、顺序或结果——下次用就重新上传。所以驻留档位在 CUDA 路径内是输出不变的。
3.7 预加载:把成本挪到加载期
不预加载时,每个权重的成本(宿主 strip-cache 收集 + 上传 + 转置,8B q8 实测 ~0.82 ms × 196 个 ≈ 160 ms)落在首次 prefill 的计时窗口里,会把整个 GPU 收益吃掉,使 prefill 净慢于 CPU。
所以提供 st_cuda_preload_all(),在模型加载后一次性把权重做好驻留。两个前提门:
VLLM_CUDA_INFER=1(offload 关则无需热身);VLLM_CUDA_STREAM未开——窗口会在第一个层边界驱逐窗口外的权重,全量预加载等于「传完即丢」,所以窗口模式下跳过热身,让窗口的按需路径自己传。
/* 文件:src/model/vllm_safetensors.c(st_cuda_preload_all,节选) */
{

    const char *e = getenv("VLLM_CUDA_INFER");
    if (!e || !e[0] || e[0] == '0') return 0;   /* offload off: nothing to warm */
}
{

    /* With the VRAM residency window on, ... skip the warmup entirely. */
    const char *e = getenv("VLLM_CUDA_STREAM");
    if (e && e[0] && atoi(e) > 0) return 0;
}
四、实测数据
| 口径 | 数值 | 判定 | 标注 |
|---|---|---|---|
| 复用 strip-cache,不做模型转换 | 与 NPU 后端共享同一份 Wq/bsc |
可行 | 实测 |
驱逐走缓冲池 vs cudaFree |
keep=1..16 从「几乎不随 keep 缩放」到 159→94–106 ms/tok | 缓冲池胜 | 实测(第 06 篇) |
| 预加载单权重成本(8B q8) | ~0.82 ms × 196 个 ≈ 160 ms | 必须移出 prefill 窗口 | 实测 |
| 预加载总耗时(2B q8) | 0.36 s / 253 条 | 加载期一次性 | 实测(见 第 05 篇) |
五、边界与已知限制
- 「不引入第二套量化格式」的前提是引擎侧的 strip-cache 契约稳定;一旦引擎改了布局(例如 4x4 repack),产物与引擎版本就必须同步演进(见 第 07 篇 的布局标志问题)。
- 融合权重要求每个成员
N是 4 的倍数且K % G == 0,否则退回逐投影路径(不是错误,只是少一次融合)。 - 池复用要求几何完全一致,形状频繁变化的负载下命中率会下降;窗口模式(同一批形状循环)才是它的主场。
- 预加载的预算参考值随模型放大而放大,配不足会静默退化(见 第 05 篇)。
CPU 对照(迁移前基线)
- CPU 参考:
kestrel-llm/src/model/vllm_safetensors.c(函数st_npu_gw_buildstrip-cache 构建、st_q4_row_dot单行点积)—— 把权重按 32 列块切成 strip 建缓存,点积在块内整数完成后统一乘 scale。 - 迁移要点:CPU 侧复用的 strip-cache 原样搬给设备 → 设备端做 32×32 tiled 转置成 K-major、
col_off把多权重融合进同一缓冲、Npad=(N+3)&~3零填充;wkey=(layer<<32)|(proj+1),驱逐用缓冲池取代cudaFree。 - 真机验证:部分命中 E2(
--cuda-selftest覆盖 strip-cache 的 int8/int4 GEMM);预加载/融合/驻留窗口完整链路未在本轮证据内。
六、小结(可复用结论)
- 能复用就别新造:CUDA 后端直接吃引擎已有的 strip-cache,换来「同一 artifact 喂 NPU 与 CUDA 两个后端」,省掉一整套模型转换。
- 布局转换放设备端做一次:转置成 K-major 是内核访存的要求;
col_off让同一块缓冲承载多个权重。 Npad零填充是向量化的前提:尾部 store 必须读到 0,否则写错数据。- wkey 把 layer 原样放在高 32 位:不是为了省事,而是驻留窗口要靠它精确解码层号。
- 驱逐走缓冲池:
cudaFree是设备同步,实测比它想省下的重传还贵;同几何复用把驱逐退化成 O(1)。
相关篇目:第 02 篇 · 架构边界、第 04 篇 · 分组量化 GEMM 内核、第 06 篇 · VRAM 驻留窗口的两个坑
源码与配套资源:本仓库 https://gitee.com/pei-xiaoguang/kestrel-llm-cuda.git;
CPU 推理源码 https://gitee.com/pei-xiaoguang/kestrel-llm


