【FHE 同态加密】我们如何实现同态加密推理(七):自举 Bootstrapping——一个不提高精度、只刷新模数链的"加油站"
关键词:同态加密 | FHE | 自举 | Bootstrapping | 模数链刷新 | coeff_to_slot | slot_to_coeff | EvalMod | 大模型密文推理
导读:自举(Bootstrapping)在同态加密里常被误解成"纠错"或"提精度"。本篇用实测数字说明它其实只是一个"加油站":把被乘法吃掉的模数链还给同态加密推理引擎,精度几乎不动。内容包含七段流水线、sin 折叠(EvalMod),以及 80% 时间花在哪两段域变换上。
项目仓库
Gitee 主仓:https://gitee.com/pei-xiaoguang/kestrel-llm
GitHub 镜像:https://github.com/m13253246268-ship-it/kestrel-llm
0. 一句话结论
自举(bootstrapping)不提高精度,它只做一件事:把被乘法吃掉的模数链还给你。
实测证据很干净——同一层的结果,自举前后与明文参考的误差几乎不动:
| 对象 | 链长 | `max | err | ` |
|---|---|---|---|---|
u0(lay0 产出) |
np=16 |
1.2712e-03 |
||
u0r112(boot0 刷新后) |
np=112 |
1.2706e-03 |
链长从 16 回到 112,误差从 1.2712e-03 变成 1.2706e-03。
如果你把自举理解成"纠错"或"提精度",那这个数字会让你困惑;把它理解成"加油"就通了——油加满了,车并没有变快。
1. 为什么必须自举
CKKS 的每一次乘法都要 rescale,而 rescale 会切掉一个素数(本系列第 5 篇)。链长是单向消耗的。
一跳的实际数字:
| 阶段 | 链长 |
|---|---|
| 输入 | 112 |
lay 消费后 |
16 |
boot 刷新后 |
112 |
16 这个数字意味着"还能再算十几步乘法"——对于一个 28 层的模型,这远远不够。自举就是那个周期性的补给站。
2. 七段流水线(实测顺序)
驱动 t23_chain.c 的 [boot profile] 打印把整条自举摊开了,字段顺序就是执行顺序:
modraise → coeff_to_slot → rotate_k → conj_extract
        → sin_fold_re / sin_fold_im → restore_merge → slot_to_coeff
| # | 段 | 做什么 | 对应函数 |
|---|---|---|---|
| 1 | modraise |
用 Garner 扩展把链抬回满链 | ckks_modraise() |
| 2 | coeff_to_slot |
系数域 → 槽位域 | coeff_to_slot() |
| 3 | rotate_k |
Galois 旋转 | ckks_rotate_k() |
| 4 | conj_extract |
共轭提取:分出实部/虚部 | — |
| 5 | sin_fold_re / _im |
对实部、虚部分别做 sin 折叠 |
sin_fold() |
| 6 | restore_merge |
还原并合并 | — |
| 7 | slot_to_coeff |
槽位域 → 系数域 | slot_to_coeff() |
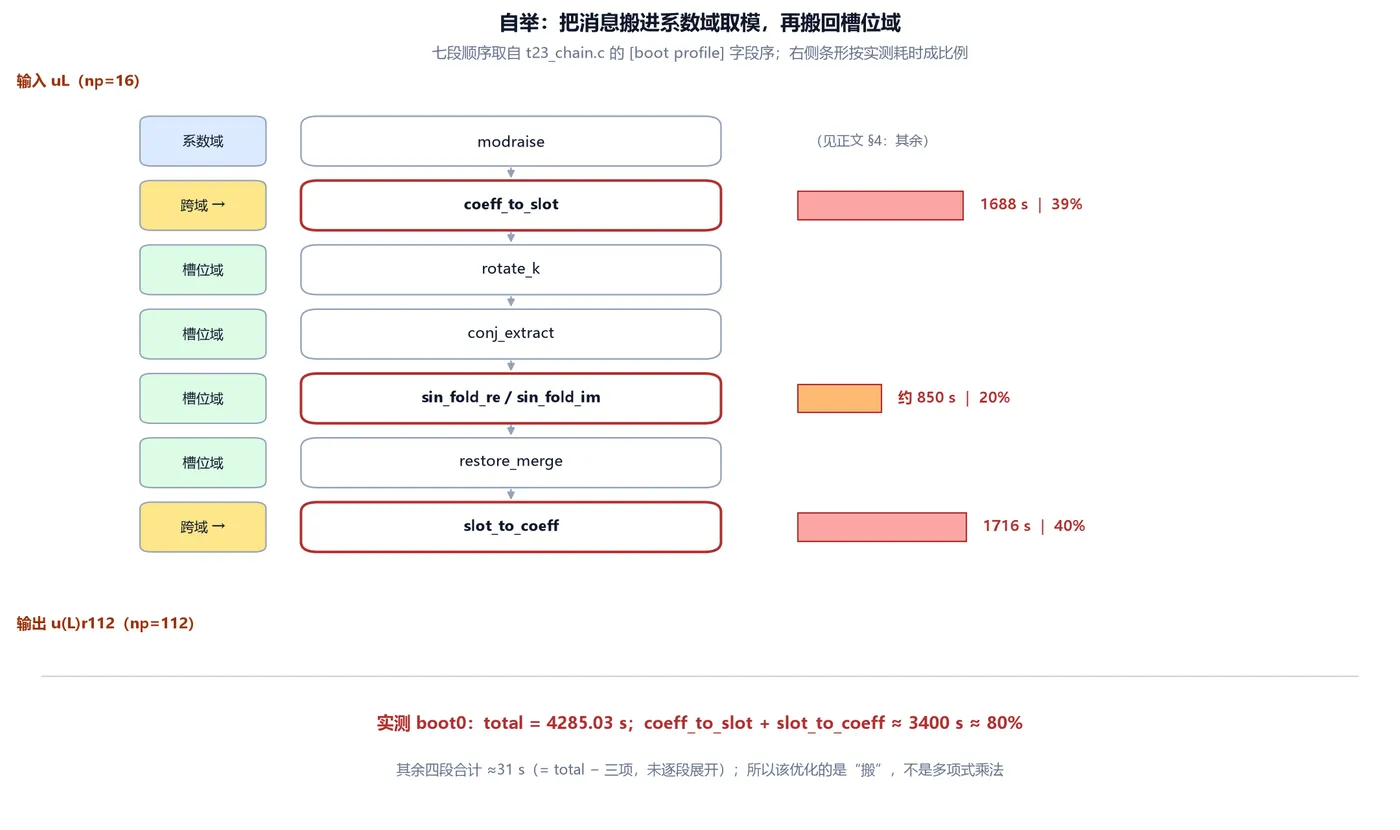
图 7-1 怎么读:左列是域——
modraise在系数域上做,coeff_to_slot与slot_to_coeff是两次跨域搬运,中间四段都在槽位域上逐点操作;右侧条形按实测耗时成比例,两根红框的条形(coeff_to_slot+slot_to_coeff)合起来就是那 80%。图中只画了正文 §4 给出的三个量,其余四段合计 ≈31 s,未逐段展开。矢量版
figs/fig07_bootstrap_pipeline.svg|Graphviz 源码figs/fig07_bootstrap_pipeline.dot
这个顺序本身就是答案:自举的本质是"把消息从槽位域搬到系数域,做一次取模(modular reduction),再搬回槽位域"。难点全在"搬"上。
3. 为什么要"搬":EvalMod 与 sin 折叠
在槽位域里,一个槽位装的是一个近似的实数(scale = 2^60 定标)。你想对它做"取模 q"这种操作,直接做不了——因为取模是在系数域上才有意义的整数操作。
于是标准做法是:
modraise:把模数从当前的短链,用 Garner 扩展抬回满链。这一步把"模数空间"还给消息;coeff_to_slot:把消息从槽位域变回系数域,此时那个"需要取模的量"变成了系数的整数倍;sin_fold:用sin的周期性(sin(πx)型的倍角/折叠结构)来逼近那个取模函数。因为取模在数学上可以写成锯齿波,而锯齿波可以用sin的倍角多项式逼近;slot_to_coeff/restore_merge:搬回去。
rotate_k 与 conj_extract 的存在,是因为"实部/虚部"要分开处理——复数的实虚部在系数域里纠缠在一起,需要用 Galois 自同构与共轭把它们分离出来,各自折叠,再合并回去。
3.1 为什么是把私钥稀疏度降到 8
一个不显然的取舍(头注释原文):
降 hw 控制 bootstrapping 折叠混叠:混叠
I ~ hw/2 = 4,sin 逼近多项式 9 次;原型无安全可接受。
hw 是私钥的非零系数个数,这代被设成 8(CKKS_KEY_HW)。它不是随手取的:私钥越稀疏,sin 折叠时产生的混叠(aliasing)越小(约 hw/2 = 4),于是只需要 9 次多项式就能逼近到位。
换句话说:为了自举的数值可行性,我们主动牺牲了密码学参数(hw 越小越不安全)。作者在注释里明确标注了"原型无安全可接受"——这个取舍如果我们不写出来,读者会以为 hw=8 是某种安全选择。
4. 自举的代价:80% 的时间花在"搬"
boot0 的实测分段(字段名与上文七段一一对应):
| 段 | 耗时 | 占比 |
|---|---|---|
coeff_to_slot |
1688 s | ~39% |
slot_to_coeff |
1716 s | ~40% |
sin_fold(实部+虚部) |
~850 s | ~20% |
modraise / rotate_k / conj_extract / restore_merge |
其余 | 余下 |
total |
4285.03 s | 100% |
两个"域变换"加起来约 3400 s,占 80%。
这个结果直接否掉了我们的第一版优化直觉——"去优化多项式乘法"。乘法(NTT)确实是最热的内核,但在这条链上,时间不在卷积里,在域变换里:coeff_to_slot 与 slot_to_coeff 每段都要做大量的 Galois 旋转和 key-switch(本系列第 6 篇那对 3×2 个密钥就是在这里被反复使用的)。
顺带对比:同一轮的
lay0是 1920 s,而boot0是 4285 s。一层 1.8 小时里,有约 1.2 小时花在自举上。
5. 一个工程细节:懒初始化的并发陷阱
代码里留了一条修复记录(t23_chain.c 附近):
tab_prepare(n); /* M1c 修复:coeff_to_slot/slot_to_coeff 的 omp 区并发首次触发 ... */
含义是:某些预计算表原来是在并行区里首次访问时懒初始化的。多线程同时"第一次"进入,就会并发触发初始化——这是经典的隐蔽竞态。修法是在进并行区之前显式 tab_prepare。
这类 bug 的特点是:单线程永远不出现,多线程偶发。它跟本系列第 13 篇(位级可复现性)是同一类问题的两个面。
6. 安全边界(务请读完)
本文所述参数为机制验证级(n=2048、112/2100 素数链),
远低于 HE 参数标准的 128-bit 水平,不得用于保护真实数据。
本文主张的是:自举流水线的结构与实测账本。
本文不主张:安全强度、性能优越性。
特别提醒:§3.1 的 hw=8 是为数值可行性做的妥协,不是安全选择。请勿把本文任何参数当成可用的密码学配置。
7. 这一篇的未解问题
coeff_to_slot/slot_to_coeff为什么这么贵,我们没有逐段归因。是旋转次数多?是 key-switch 的密钥太大导致缓存不友好?还是 NTT 调用次数过多?目前只有总量,没有分解。这是本项目最值得做的一块性能分析,也是收益最大的一块。hw=8与精度之间的关系没有量化。我们知道hw小→混叠小→多项式次数低,但"hw从 8 提到 16 会坏多少、慢多少"没有测。- 自举的链长余量没有探边。
t23boot编到 2100 素数;实际用到多少、还能压到多低,我们没有做"最小可用链长"的扫描。而链长直接决定内存与耗时。 sin_fold的精度贡献与误差来源没有分离。我们只知道整链误差,不知道折叠这一步贡献了多少。
下一篇我们回到模型侧:SiLU 的密文化——两条拟合路径,以及那个只有 8 字节、却能让你算出错误答案的开关文件。