
引子:安全员最怕的不是检查,是“翻录像”
做过工地安全管理的人大概都经历过这样的时刻:出了事,或者怀疑要出事,然后面对几十个小时的监控录像开始逐帧回放。两倍速、四倍速盯着屏幕,直到眼睛酸胀流泪。
一顶安全帽到底是在哪个时段摘下来的?挖掘机进场时旁边有没有人?反光背心是从哪个班组开始不穿的?这些看似具体的问题,以往只能靠人工一格一格拖拽录像查找。但人眼注意力二十分钟后就会大幅衰减,很多隐患、违规细节,恰恰藏在被跳过的片段里。
问题的本质,不是安全员不够认真,而是视频本身是不可检索的数据。它只会按时间顺序堆积,想要找特定内容,只能从头到尾翻看。
而视频智能检测的核心思路完全不同:不让机器单纯替人盯屏,而是让机器先把所有录像“读完”,自动标记关键画面与时间点,人只需要复核机器筛选出的有效片段。
从“人工看录像”到“AI搜录像”,是监控行业的核心变革。其中,安全施工检测,是工程难度最高、容错率最低、最贴近生命安全的技术应用。
一、先说清楚:它检测的到底是什么
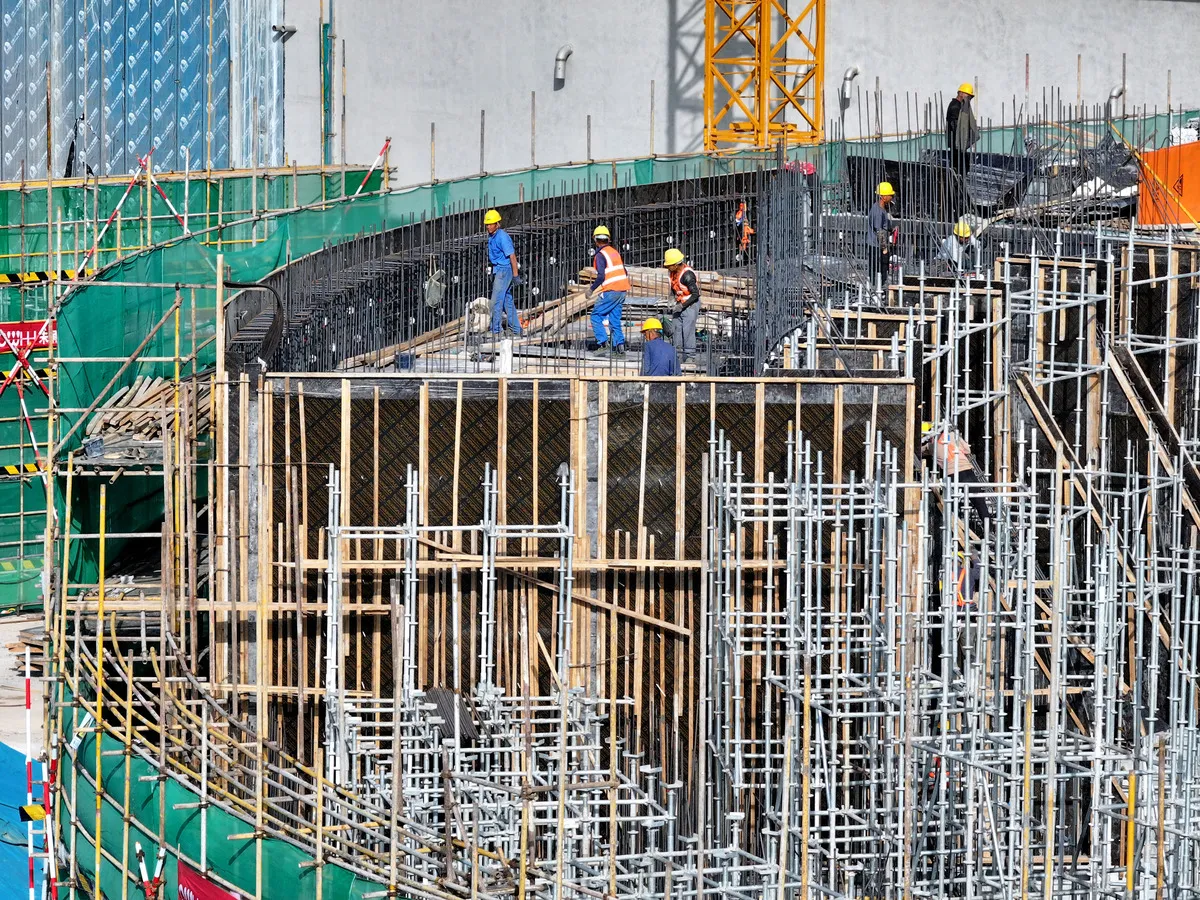
安全施工检测并不是模型笼统的“看懂画面”,而是目标识别 + 状态判断的组合技术方案。
整体分为两层: 目标层:识别现场人员、车辆、机械车、安全锥、电线杆等实体物体。 属性层:判断人员是否佩戴安全帽、是否佩戴口罩、是否穿戴反光背心。
简单来说,机器不仅要“看见有什么”,还要“判断是否合规”。
这里有一个非常关键的技术细节: “戴安全帽”和“未戴安全帽”是两个独立的检测目标,而非正反判断。
常规识别只需要判断“物体是否存在”,但安全场景的难点在于缺失性判断。“未戴安全帽”是开放场景,头发、阴影、草帽、逆光模糊,都属于未佩戴范畴。如果仅靠正向佩戴模型反推,极易把“看不清、被遮挡”误判为“已佩戴”。
在工地安全场景中,漏判远比多判更危险。因此算法单独训练违规样本,优先杜绝安全风险漏检,未穿反光衣、未戴口罩的识别逻辑同理。
二、从像素到时间点:AI检测的五步技术流水线
一段普通工地监控视频,从原始画面变成可溯源的安全事件,需要经过完整的算法流水线。
第一步:抽帧与动态采样
监控视频绝大多数时间都是静止无变化画面,逐帧全量识别会浪费大量算力。系统采用动态采样策略:画面无变动时降低采样频率,出现人员走动、设备移动、光影变化、物体摆动时,自动提高采样密度。
移动物体检测能力,本质就是画面活跃度筛选,帮机器快速过滤无效静态画面,锁定所有值得研判的动态场景。
第二步:目标检测
算法在每一帧画面中精准框选人员、工程机械、安全锥等目标。工地场景的识别难度远高于普通道路监控,核心难点集中在三点:
- 遮挡常态化:脚手架、建材物料会遮挡人体,工人弯腰、侧身作业也会造成局部遮挡;
- 光照条件复杂:逆光形成人物剪影、夜间低照度、阴雨扬尘天气,大幅降低画面清晰度;
- 目标特征相似:远处小目标画面中,安全帽与水桶、反光衣与彩色防尘布极易混淆。
专业工地检测算法的核心优势,不是基础识别能力,而是复杂工况下的低漏检率。
第三步:局部属性分类
不同于全画面模糊判断,精细化检测只聚焦目标局部区域。 锁定人体头部区域,判断安全帽佩戴状态;聚焦躯干区域,识别反光背心穿戴情况;定位面部区域,核验口罩佩戴规范。
这种局部推理模式,让防护合规判断精度提升一个量级。
第四步:时序聚合与防抖去抖
单帧画面识别极易出现误差,瞬时遮挡、转身、光影变化都会造成误判。
系统通过跨帧跟踪技术,为画面内每个人分配独立ID,整合一段时间内的连续识别结果,通过算法投票过滤瞬时误差。只有连续多帧判定为违规,才会生成有效记录,彻底避免单帧抖动造成的无效数据。
第五步:自动归档留存
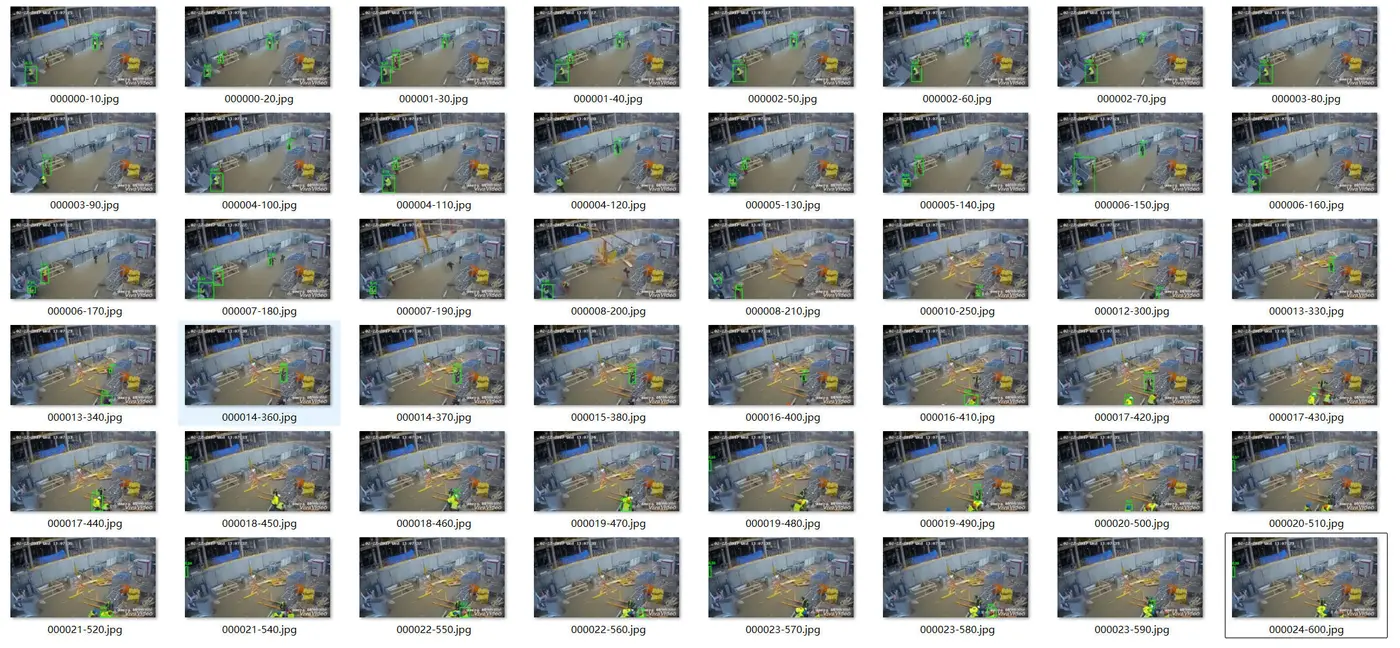
算法最终输出三类有效数据:精准时间节点、关键帧截图、完整违规视频片段。时间用于精准溯源,截图用于快速核验,片段用于取证复盘,形成完整的可视化证据链。
三、最难的判断:一顶安全帽背后的技术逻辑
在所有工地安全规范中,安全帽防护是成本最低、保命价值最高的准则,也是现场违规最多、最难监管的细节。
对AI而言,安全帽检测是典型的关系型逻辑判断:画面中存在人员、人员头部区域无安全帽特征、双重判定置信度达标,三者同时成立,才可判定为未佩戴。
这是高阶的语义理解,远超普通物体识别,需要算法读懂人体结构、空间位置、特征缺失关系。
而反光背心检测的难度更高:反光衣的核心识别特征是反光条,但反光效果极度依赖光线、拍摄角度。固定监控机位下,很多角度反光条完全不反光,仅靠反光特征无法识别。
因此算法会结合版型、色彩分布、人体躯干姿态做综合研判,夜间红外画面丢失色彩后,依旧可以依托形态特征完成精准判断。
四、从“识别物体”到“理解整体施工场景”
普通AI识别只能做到“看图识物”,而专业工地检测可以实现场景语义理解。
工地监控机位固定,视野基本不变,系统可提前标定各类功能区域:机械作业区、人员通道、基坑边缘、材料堆放区。
有了区域认知,算法能力实现升级: 从“识别画面有机械车”升级为“机械车违规进入人行通道”; 从“识别画面有人”升级为“人员滞留高危基坑区域”。
安全锥、电线杆这类静态设施的价值也体现在此:静态物体本身无需高频检测,但物体位移、倾倒、消失,代表现场安全布局被破坏,是重要的安全隐患信号。
同时,时序索引技术让所有检测结果结构化、可检索。只需筛选时间、机位、违规类型,即可秒出所有异常记录,彻底告别人工逐帧翻查录像的低效模式。机器将无序视频转化为标签化事件库,人工只需要精准复核关键内容。
五、为什么主流是“检索式AI”,而非实时告警
很多人误以为实时告警更先进,但在真实工地场景中,检索式视频检测才是更落地、更实用的方案。
第一,实时告警误报率高,极易让管理人员产生麻痹心态,久而久之彻底忽视告警信息; 第二,实时告警无法覆盖历史存量录像,无法解决事后复盘、事件追溯的核心需求; 第三,实时告警对设备、网络要求极高,改造落地成本巨大,不适合存量工地改造。
而倍速检索、批量视频处理的核心优势,就是适配回溯场景、兼容原有设备、零改造落地。
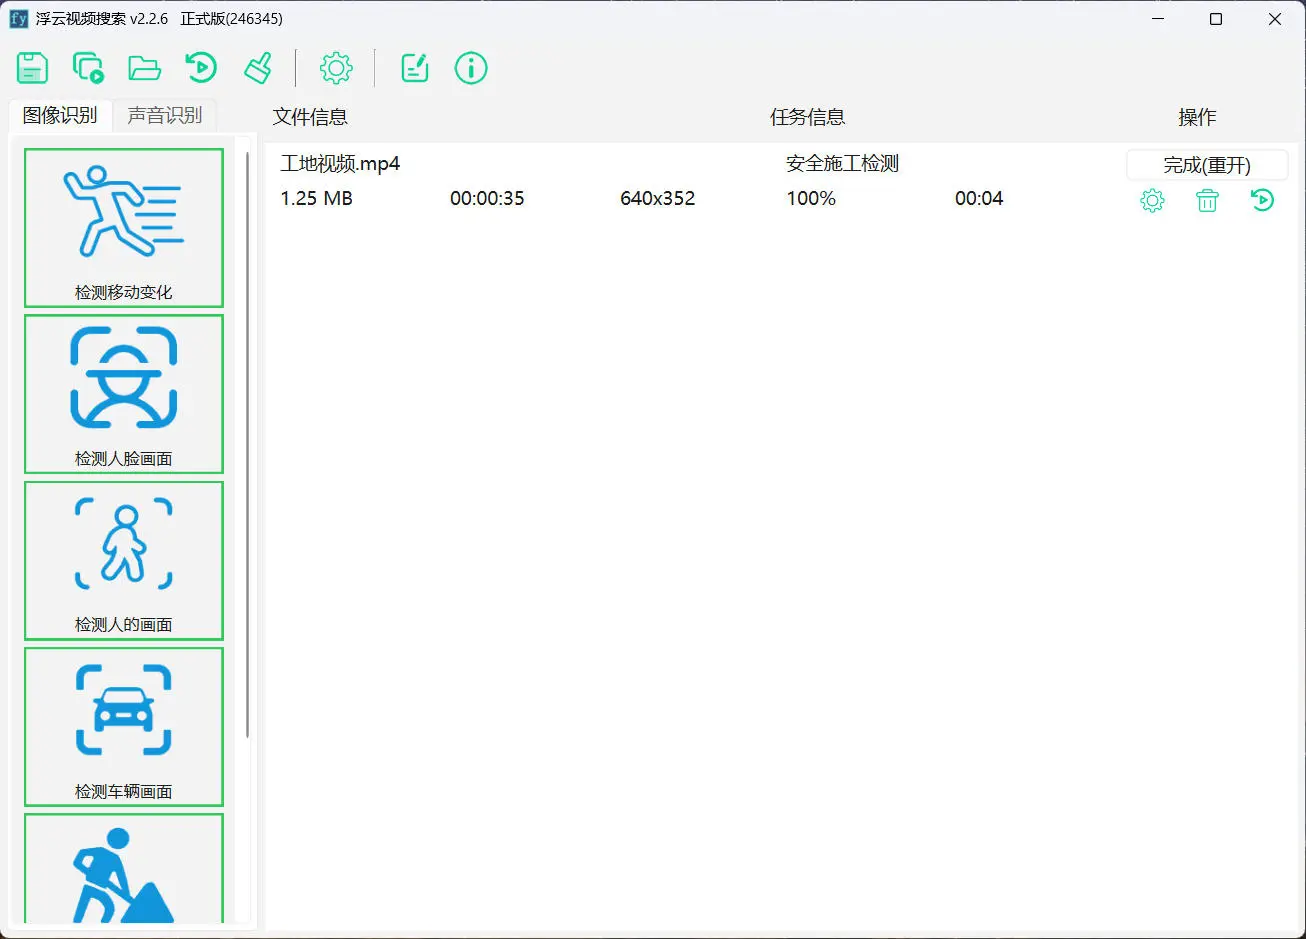
将海量视频批量导入,机器高速筛查归档,输出所有违规片段与时间节点。同时支持关键事件连续回放,完整还原事件前因后果,保留完整上下文,为安全复盘、事故取证、班组教育提供完整素材。
六、客观认知:AI视频检测的能力边界
任何技术都有局限,正视短板,才能合理发挥工具价值。
- 误检与漏检的平衡难题 安全场景代价不对称:漏检一次违规,可能造成安全事故;过度严判、误检过多,会降低工具可信度。行业通用方案是分场景调参,可控场景从严,复杂作业场景适度容错,搭配人工校准。
- 真实场景样本偏差 标准训练数据集画面干净、场景规范,但实际工地存在草帽套安全帽、外套遮挡反光衣等个性化场景,需要长期样本迭代优化精度。
- 复杂环境识别短板 人员密集遮挡、远距离小目标、夜间低照度、雨雾扬尘天气,都会影响识别效果,是所有视觉算法的共性难点。
- 无法替代人工专业巡检 AI只能识别画面可视化违规行为,脚手架松动、线路老化、结构隐患等画面无法捕捉的深层问题,依旧依赖专业安全员现场排查。
因此,AI视频检测的精准定位是智能筛查工具,而非绝对判定标准,负责缩减核查范围,最终结论由人工确认。
七、真正被改变的:工地安全管理的完整节奏
AI检测最大的价值,不是抓违规,而是重构安全管理体系。
传统工地安全依靠人工抽样巡查,存在极大偶然性,违规行为大多靠侥幸规避。而AI实现了24小时全域普查,所有违规行为全程留痕、可追溯、可统计。
管理人员可以精准统计各时段、各班组违规频次,针对性开展安全教育;整改完成后,可二次扫描录像,反向验证整改效果,形成「AI筛查-人工复核-整改优化-复盘验证」的闭环管理。
原本需要一整天的录像复盘工作,现在仅需几十分钟即可完成,极大节省人力,让安全员从繁琐的机械工作中解放,专注于现场安全管控。
结语:让沉默的监控录像,变成可查询的安全数据
工地监控普及多年,却长期只承担事后回看的被动作用,海量视频数据沉睡存储设备中。
视频智能检测技术的落地,完成了监控从被动记录到主动智防的蜕变。没有花哨的黑科技噱头,只是计算机视觉、时序算法、场景语义理解等技术,在工业安全场景的扎实落地。
它不会替代安全员,却把最宝贵的注意力,还给了现场安全管理。
从前,一次违规、一处隐患,可能淹没在数万小时的录像里无人知晓;现在,每一次不规范操作都会被精准记录、及时溯源。
对工地而言,被AI看见的每一顶安全帽、每一件反光衣,都是守护一线作业人员的一道安全防线。


