
视频拥有空间信息:Timeline Studio 浏览器端深度估计与 AI 视频创作实践
文章末尾可以直接放这段:
体验与源码
Timeline Studio 是一款免费开源的浏览器视频编辑器,欢迎体验视频深度提取及更多 AI 编辑能力。
如果项目对你有帮助,欢迎在 GitHub 点个 Star,也欢迎提交建议和反馈。
普通视频记录了颜色、纹理和运动,但没有直接提供每个像素距离镜头有多远的信息。
如果能够从视频中估计出前景、人物和背景的远近关系,就能进一步实现景深虚化、基于深度的重新打光,也能把这种空间结构作为 AI 视频生成的参考。
在 Timeline Studio 中,我们围绕这一思路实现了浏览器端视频深度分析,并尝试将提取出的深度视频用于角色和画面风格重建。本文介绍这套能力的技术原理、工程实现,以及实际生成过程中暴露出的边界。
一、从普通画面中估计空间关系
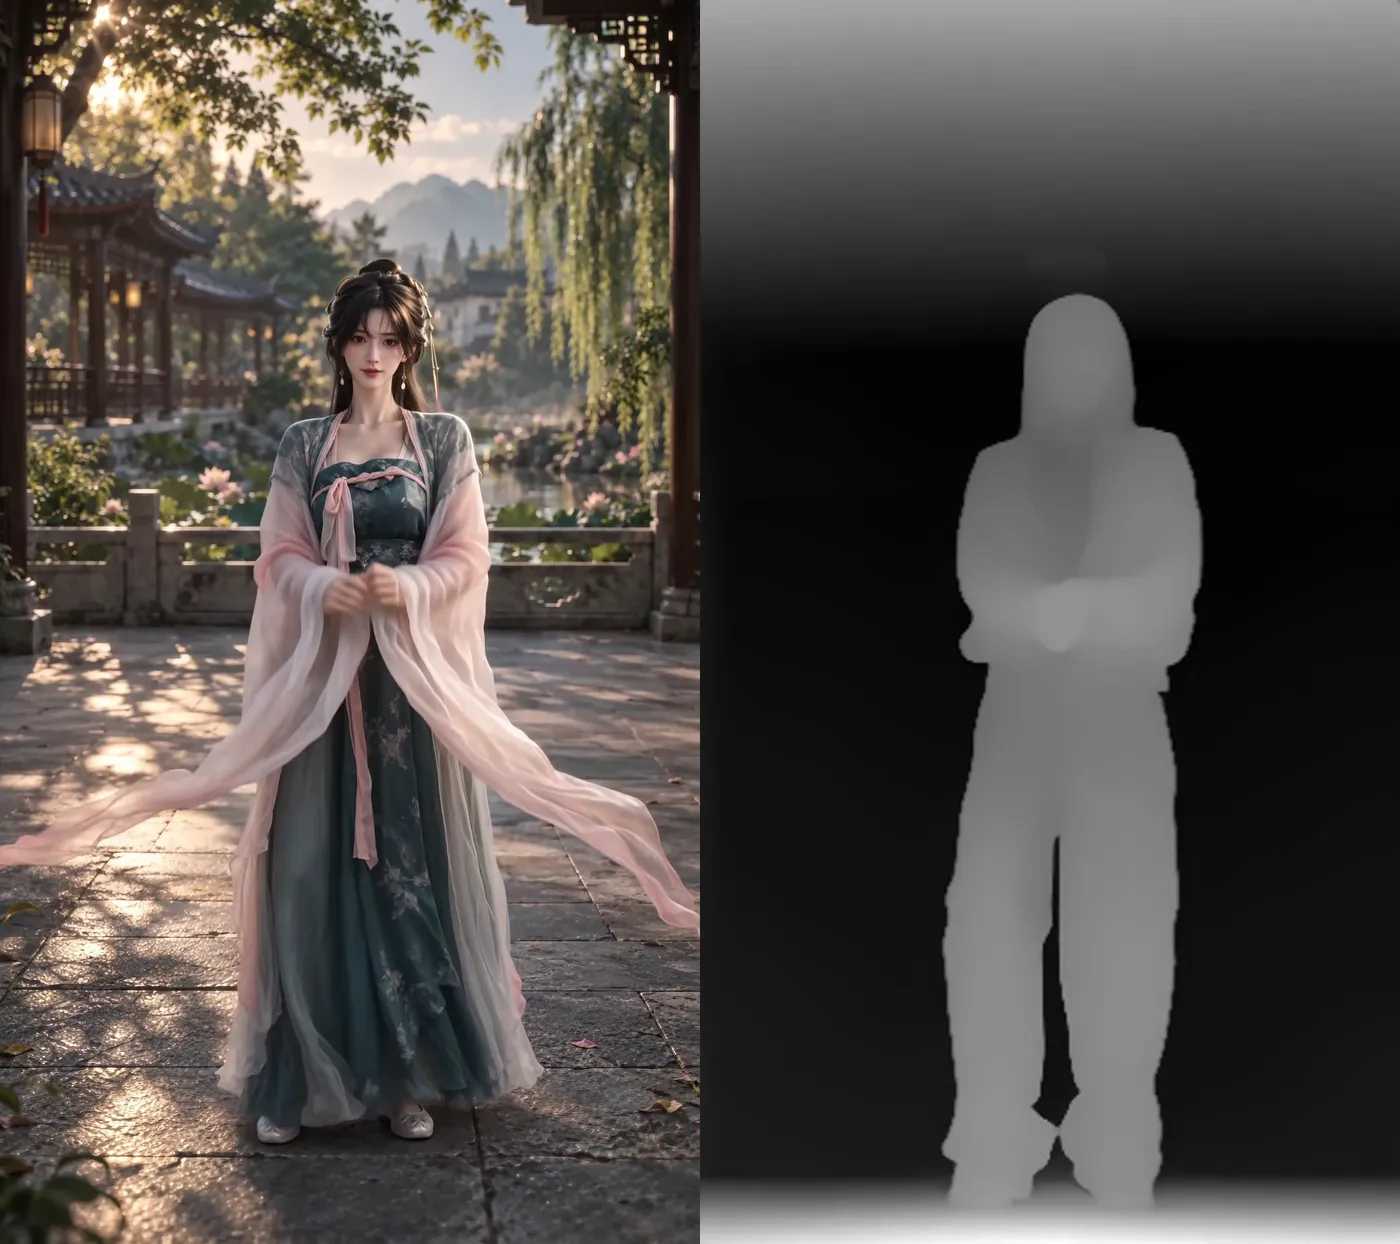
这套能力的基础是单目深度估计:输入一张普通 RGB 图像,由模型预测每个像素的相对深度。
Timeline Studio 当前使用 Depth Anything V2 Small。Depth Anything V2 提供不同规模的相对深度估计模型;这里选择 Small 版本,结合浏览器部署需求控制模型规模。Depth Anything V2 官方模型说明
深度结果可以转换为灰度图。在当前实现中,通常越亮表示越靠近镜头,越暗表示越远,也可以按需要反转显示。
需要区分的是,这种结果表达的是相对远近关系,不能直接把灰度值解释成米或厘米。它适合辅助视觉效果和空间结构理解,但不等于经过标定的三维测量结果。
整个处理链路可以概括为:
原始视频
  ↓ 按时间采样并解码
RGB 帧
  ↓ 浏览器端深度模型推理
相对深度数据
  ↓ 归一化与边缘引导平滑
灰度深度帧
  ├─ 景深虚化
  ├─ 基于深度的重新打光
  └─ 编码为独立深度视频
二、让深度模型运行在浏览器中
当前实现通过 Transformers.js 加载模型,使用 WebGPU 执行推理,模型配置采用 Q4F16。
核心调用可以简化为:
const estimator = await pipeline(
  "depth-estimation",
  modelPath,
  {

    device: "webgpu",
    dtype: "q4f16",
    progress_callback: reportProgress,
  },
);
实际工程还需要处理模型镜像、固定版本、下载进度、缓存和失败重试,不能只停留在一次模型调用上。
深度推理被放入独立的 Web Worker。主线程负责编辑器交互、视频帧准备和进度展示,Worker 负责模型加载与深度计算,两者通过消息传递交换任务和结果。
这样的划分能够减少推理任务对主线程的直接阻塞。不过,Worker 并不意味着无限的计算资源:视频解码、GPU 推理和编辑器预览仍然会竞争设备资源,因此还需要限制并发和内存占用。
这条深度提取路径在浏览器本地处理视频帧。后续如果把深度视频提交给远程生成服务,则属于另一条需要上传素材的处理链路。
三、视频处理的关键是时间对齐
图片只需要一次推理,视频则需要连续处理多个时刻的画面。
编辑器中的时间还有一个额外难点:时间线时间不一定等于原视频时间。
例如,片段可能裁掉了开头,或者应用了加速、减速和速度曲线。如果按时间线秒数直接读取原视频,深度结果就会与实际画面错位。
因此,当前实现使用共享的源时间映射:
const sourceTime = getVisualSourceTime(
  segment,
  localTime,
);
随后定位到对应源画面,提取帧并执行推理。深度分析结果同时记录片段时间与源时间,供预览和深度视频输出使用。
缓存也需要遵循同样的原则。当前分析签名包含素材来源、裁剪范围、播放速度、速度曲线、分析质量和模型版本。相关输入变化后,需要重新分析,避免把旧深度结果套到新画面上。
对于视频编辑器而言,这类时间一致性与模型本身同样重要:深度预测再准确,错位到另一帧也会产生明显问题。
四、通过采样、预取和插帧控制成本
对高分辨率视频的每一帧执行深度推理,成本较高。当前实现提供三档分析配置:
| 分析档位 | 目标采样率 | 输入最长边上限 |
|---|---|---|
| 快速 | 8 帧/秒 | 392 像素 |
| 均衡 | 16 帧/秒 | 504 像素 |
| 高质量 | 24 帧/秒 | 518 像素 |
这些数值是分析配置,不代表设备一定能达到对应的实时处理速度。
单次分析还设置了最多 720 个样本的预算。长片段达到预算上限后,会降低有效采样密度,以覆盖整个片段并控制资源消耗。
处理过程中,当前帧推理与下一帧准备可以重叠进行:
当前帧:执行深度推理
下一帧:定位、解码并准备输入
同时只保留有限的在途任务,避免一次性解码大量画面。
独立深度视频当前以 24 fps 输出。快速和均衡档位接入 RIFE 插帧,用于补充采样帧之间的过渡;这能改善连续性,但插值结果不能视为新增的真实深度观测,快速运动和遮挡变化仍需检查。
五、深度图如何变成可用的视觉效果
景深虚化
有了深度图,就可以根据像素深度与目标焦点的距离,决定该区域显示清晰画面还是模糊画面。
当前实现准备清晰层和模糊层,再通过深度生成带羽化过渡的蒙版:
深度接近焦点 → 保留清晰层
深度远离焦点 → 混入模糊层
焦点、清晰范围和模糊强度可以分别调整。这让景深效果能够依据空间层次变化,而不是只对固定矩形区域做模糊。
它仍然属于图像合成近似。头发边缘、透明物体和复杂遮挡处的效果,取决于深度预测与蒙版质量,不能直接等同于真实镜头的光学成像。
边缘引导平滑
直接平滑深度图容易把前景与背景混在一起,产生轮廓光晕。
当前实现使用轻量的边缘引导平滑,同时考虑邻近像素的深度差和原画面的颜色差。深度或颜色差异较大时,降低混合权重,尽量保护物体边界。
这里原图纹理的作用是约束平滑,而不是把每一道衣服花纹都转换成新的深度结构。
独立深度视频
深度结果还可以编码为独立素材,进入“我的资产”,继续参与编辑或用于外部工作流。
当前浏览器输出采用 WebM 容器、VP9 视频编码,并在存在源音频时准备对应音轨。画面保持源宽高比,最长边限制在 1080 像素以内。
需要注意,输出尺寸不等于模型的推理分辨率。把深度图放大编码,并不会凭空增加模型未预测到的几何细节。
六、把深度视频用于 AI 视频创作
在实际实验中,我们进一步组合了三类参考:
| 输入 | 希望提供的信息 |
|---|---|
| 深度视频 | 人物轮廓、前后关系、遮挡和构图变化 |
| 角色参考图 | 人物外貌、服装和材质 |
| 文字描述 | 场景、风格、动作阶段与约束 |
例如,使用一段人物动作视频提取深度,再配合新的角色图,希望生成模型沿用原有动作结构,同时重建人物外观和环境。
这种方式的价值在于:把画面中的空间结构单独提取出来,减少对原视频颜色和纹理的依赖,为后续创作提供更明确的参考。
但这里必须区分两种接入方式:
- 生成系统提供专门的深度条件接口。
- 生成系统只接收普通参考视频,由模型理解其中的灰度结构。
本次实验采用的是后者:把深度视频作为普通参考视频提交。因此,不能把它描述为已经实现了专用深度控制,也不能承诺逐帧动作一致。
七、实际验证:结构参考有用,但严格还原仍有差距
在一组古装人物实验中,生成结果出现了侧身转正、后段靠近镜头的整体变化,但仍有两类明显偏差:
第一,前景肢体含义被误解。深度图保留了近处轮廓,却缺少颜色和纹理语义,一段手臂或衣袖的形状可能被生成模型解释成其他肢体。
第二,人物在画面中的占比发生偏移。即使提示词要求严格遵循参考,头肩大小、裁切位置和运动幅度也未必一致。
另一组双人挥袖实验中,改用原始彩色视频参考后,抽帧对比显示,“男生挥袖—袖子遮挡镜头—女生近景抬手”的主要结构更接近原片,但手部细节仍不是逐帧一致。
这说明参考方式需要根据任务选择:
当任务强调空间层次和减少原画外观干扰时,可以尝试深度参考;当任务依赖复杂肢体语义、服装运动和遮挡转场时,原始视频可能提供更充分的信息。
还要区分深度与相机参数。单目相对深度图并不直接提供经过标定的相机 FOV。要求生成结果保持构图时,应检查人物屏幕占比、头肩位置、裁切边界和镜头变化,而不能只凭“使用了深度图”判断通过。
同样,提示词中的“UE5.4 电影级质感”表达的是视觉风格目标,不能据此宣称结果由 Unreal Engine 实际渲染。
八、这项能力适合什么场景
目前,这套实现可以为三类工作提供基础:
- 视频后期效果:利用深度层次调整景深,并辅助重新打光。
- 空间结构可视化:把普通视频转换成灰度深度视频,观察前后关系和遮挡变化。
- AI 视频创作实验:将空间参考、角色参考与文字描述组合,探索新的角色和风格表达。
工程上的重点,是让模型结果真正进入编辑器:保持源时间对齐,控制分析预算,支持取消与进度反馈,并把结果保存为可继续使用的素材。
当前已经打通了浏览器端深度分析、效果处理和独立深度视频输出。深度参考驱动的视频生成也完成了实验验证,但严格动作复刻、精确构图保持和复杂遮挡还原,仍需要专用控制接口与更充分的结果评估。


