
02 · 架构边界:CUDA 为何是独立运行期模块
一句话:引擎不链接 CUDA——它把 CUDA 层编成一个独立动态库,运行期按固定顺序去找、去绑;找到且可用就走 GPU,找不到就让所有入口变成无害桩,行为与引入前逐字节一致。这么做不是风格偏好,而是 Windows 上 nvcc 与引擎的两套 C 运行期根本链接不到一起。
前置:建议先读 第 01 篇 · 阶段总览。
环境:x86-64 + NVIDIA RTX 5090(sm_120)· 引擎用 MinGW/GCC 构建,CUDA 层用 nvcc/MSVC 构建。
一、问题与结论
目标只有一句:有 GPU 时用 GPU,没有时行为不变。这个目标决定了边界必须是「运行期可选的独立模块」,而不是「链接期依赖」。
| 目标 | 落地做法 | 判定 |
|---|---|---|
| 有 GPU 就用 GPU | 运行期加载 vllm_cuda.dll / libvllm_cuda.so |
实测可用 |
| 无 GPU 逐字节零回归 | 未编入 / 模块缺失时所有入口退化成无害桩 | 实测一致(见 第 01 篇 阶段一) |
| 版本错配不「半绑定」 | 任一入口符号缺失即整体放弃(missing = 1) |
设计约束 |
| 能分离「初始化副作用」与「输出被真正使用」 | VLLM_CUDA_FORCE_CPU 逃生阀 |
实测(见第四节) |
二、背景:为什么不直接链接
这不是风格问题,是 Windows 上的硬约束。
| 约束 | 引擎侧 | CUDA 侧 |
|---|---|---|
| 编译器 | MinGW-w64 GCC | nvcc(Windows 主机编译器只有 MSVC) |
| 依赖头 | pthread.h / unistd.h / __int128 |
MSVC 工具链 |
| C 运行期 | MinGW CRT | MSVC CRT(_Init_thread_*、ucrt) |
两套 CRT 不能链接到一起。把 MSVC 编译的 CUDA 目标文件塞进 MinGW 二进制,会拖入 _Init_thread_* / ucrt,链接期直接失败。纯 C 的模块边界让两边各用各的 CRT,互不干扰。
这与 NPU 后端的做法同源:librknnrt 也是运行期动态加载的树外运行时。
CMakeLists.txt 的注释把这条写死了:CUDA 后端默认 OFF,只有 x86-64 宿主 + 独立 GPU 才允许 ON,aarch64(RK3588) 必须保持 OFF。
# 文件:CMakeLists.txt(节选)
# 可选 NVIDIA CUDA 加速后端(默认 OFF)
# nvcc 在 Windows 上必须用 MSVC 做宿主编译器,而本引擎是 MinGW/GCC 构建
if(VLLM_CUDA)
    if(CMAKE_SYSTEM_PROCESSOR MATCHES "aarch64|arm64|ARM64")
        message(FATAL_ERROR "VLLM_CUDA targets an x86-64 host with a discrete GPU; "
                            "keep VLLM_CUDA=OFF on aarch64 (RK3588)")
    endif()
    ...
    add_compile_definitions(VLLM_HAVE_CUDA=1)   # 启用运行期加载器
endif()
三、核心机制
3.1 运行期加载与模块发现顺序
引擎启动时按固定顺序去找这个模块:
1. $VLLM_CUDA_LIB          (显式路径,调试/多版本用)
2. 可执行文件同目录          vllm_cuda.dll / libvllm_cuda.dll
3. 平台加载器搜索路径
前两条落在 vc_module_open() 里:先看环境变量,再找可执行文件所在目录。第 2 条用 vc_exe_dir() 求目录——Windows 走 GetModuleFileNameA,Linux 走 readlink("/proc/self/exe")。
/* 文件:src/npu/cuda/vllm_cuda.c(vc_module_open,节选) */
static vc_lib_t vc_module_open(char *found, size_t cap) {

#if defined(_WIN32)
    const char *names[2] = {
    "vllm_cuda.dll", "libvllm_cuda.dll" };
#else
    const char *names[2] = {
    "libvllm_cuda.so", "vllm_cuda.so" };
#endif
    const char *env = getenv("VLLM_CUDA_LIB");
    if (env && env[0]) {
                       /* ① 显式路径 */
        vc_lib_t h = vc_lib_open(env);
        if (h) {
    if (found) snprintf(found, cap, "%s", env); return h; }
    }
    char dir[1024];
    if (vc_exe_dir(dir, sizeof(dir)) == 0) {
    /* ② 可执行文件同目录 */
        for (int i = 0; i < 2; i++) {

            char p[1200];
            snprintf(p, sizeof(p), "%s/%s", dir, names[i]);
            vc_lib_t h = vc_lib_open(p);
            if (h) {
    if (found) snprintf(found, cap, "%s", p); return h; }
        }
    }
    for (int i = 0; i < 2; i++) {
              /* ③ 平台搜索路径 */
        vc_lib_t h = vc_lib_open(names[i]);
        if (h) {
    if (found) snprintf(found, cap, "%s", names[i]); return h; }
    }
    return NULL;
}
模块缺失是正常状态,不是错误。vllm_cuda_init() 找不到模块时写一条 note(module not found ...; CPU path)然后照常返回 0(成功但不可用)。
3.2 入口点绑定与版本校验
模块打开后,逐个 dlsym / GetProcAddress 把 vcuda_api_t 里的函数指针绑上:
/* 文件:src/npu/cuda/vllm_cuda.c(vllm_cuda_init,节选) */
int missing = 0;
#define VC_BIND(field, sym) \
    do { *(void **)(&c->api.field) = vc_lib_sym(c->lib, sym); \
         if (!c->api.field) missing = 1; } while (0)
VC_BIND(dev_create,        "vcuda_dev_create");
VC_BIND(dev_gemm_gw,       "vcuda_dev_gemm_gw");
VC_BIND(dev_gemm_gw_f32,   "vcuda_dev_gemm_gw_f32");
VC_BIND(dev_wcache_window, "vcuda_dev_wcache_window");
VC_BIND(dev_decode_run,    "vcuda_dev_decode_run");
VC_BIND(dev_moe_preload,   "vcuda_dev_moe_preload");
…
任一入口缺失即整体放弃(missing = 1)——这是版本不匹配的护栏。DLL 与 exe 版本错配时,宁可不加速,也不能半绑定运行导致未定义行为。
这里还有一个关库的坑值得记一笔:vllm_cuda_destroy() 会无条件调用 c->api.dev_destroy。如果某个失败分支只关了库却没清空 c->api.*,这些指针就指向已卸载的模块,再一调就是访问违例(实测 0xC0000005)。所以关库前先用 vc_api_clear() 把整张函数表清零。
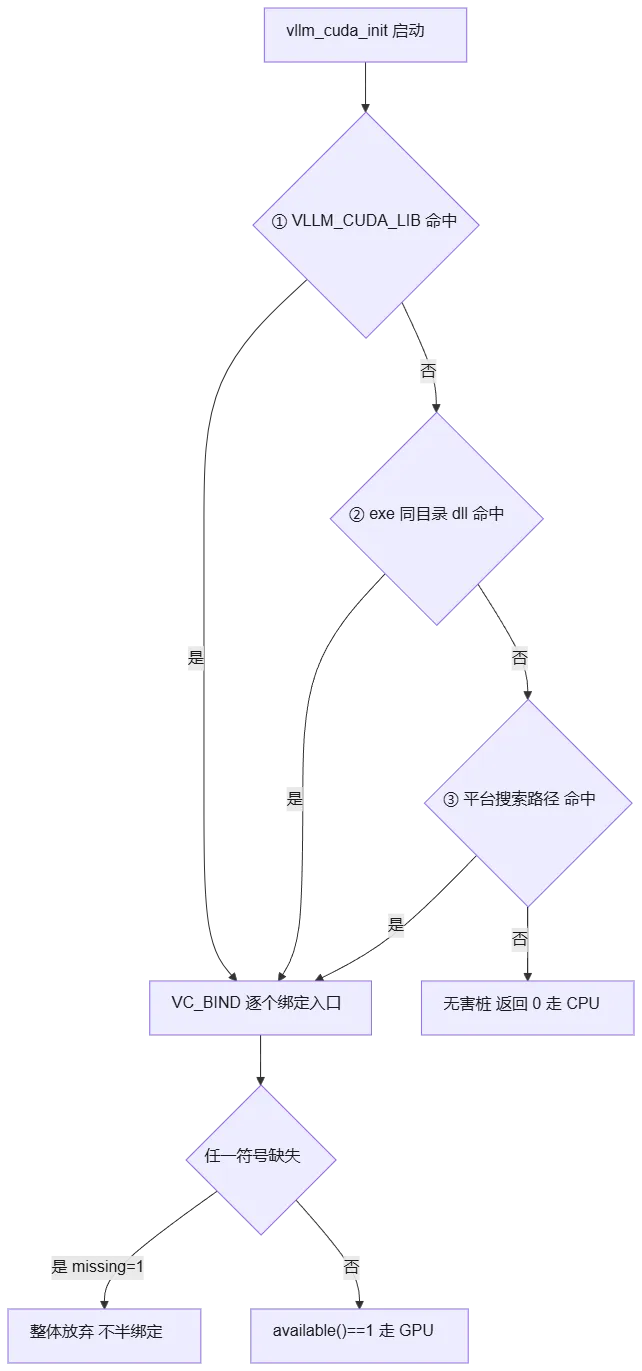
图 1:模块发现 → 绑定 → 降级的全有或全无链。
vc_module_open()依次找$VLLM_CUDA_LIB、可执行文件同目录的vllm_cuda.dll、平台搜索路径;找到后VC_BIND逐个dlsym/GetProcAddress绑定入口,任一符号缺失即missing = 1整体放弃(绝不半绑定);找不到模块或绑定失败都退化成无害桩并返回 0,只有available()==1才走 GPU。
3.3 透明降级契约
vllm_cuda_init() 永不失败调用方。设备不可用的所有情况(无模块 / 无 GPU / 版本错配 / 显存不足)统一通过 vllm_cuda_available() == 0 表达,且每个 offload 入口返回 0:
0 = 调用方必须自己跑 CPU 路径;1 = 已在 GPU 上完成。
这条约定被后端所有层次严格遵守。最底层的设备层用的是相反约定(0 = 成功),翻译发生在宿主层——例如 vllm_cuda_gemm_gw():
/* 文件:src/npu/cuda/vllm_cuda.c(vllm_cuda_gemm_gw,节选) */
if (!c || !c->ok || !c->api.dev_gemm_gw) return 0;
if (cuda_force_cpu()) return 0;
…
if (2.0 * (double)M * (double)N * (double)K < c->flops_threshold) return 0;

int rc = c->api.dev_gemm_gw(c->dev, out, Aq, a_scale, Wq, b_scale,
                            M, N, K, G, prec, wkey);
return (rc == 0) ? 1 : 0;   /* 设备层 0=成功 → 宿主层 1=已加速 */
对外接口的这一契约在公共头文件里写得很直白(include/npu/cuda/vllm_cuda.h):
Returns 1 if executed on the GPU (out is filled), 0 if the caller must run the CPU path (no device / below FLOPs threshold / unsupported shape / any CUDA error).
而且「部分失败」永远不让 out 处于未定义状态——返回 0,调用方按 CPU 内核把每个输出重算一遍。
3.4 诊断逃生阀
调试「结果不对」时,最难分离的是两类原因:初始化的副作用 vs GPU 输出被真正使用。为此留了 VLLM_CUDA_FORCE_CPU:
/* 文件:src/npu/cuda/vllm_cuda.c(cuda_force_cpu,节选) */
/* Diagnostic escape hatch: VLLM_CUDA_FORCE_CPU=1 keeps the device initialized
 * but makes every offload fall back to the CPU - separates "init side effect"
 * from "GPU output used" as the source of a wrong result. */
static int cuda_force_cpu(void) {

    const char *e = getenv("VLLM_CUDA_FORCE_CPU");
    return (e && e[0] && e[0] != '0');
}
设备保持初始化(显存分配、上传都照做),但每个 offload 直接返回 0 走 CPU。
于是:
| 配置 | 结果 | 结论 |
|---|---|---|
VLLM_CUDA_FORCE_CPU=1 输出正确 |
初始化无副作用 | 问题在 GPU 计算/数值 |
VLLM_CUDA_FORCE_CPU=1 输出也错 |
初始化有副作用 | 问题在状态污染 |
3.5 编译开关与无害桩
-DVLLM_HAVE_CUDA 决定引入的是真实加载器还是无害桩:
/* 文件:src/npu/cuda/vllm_cuda.c(节选) */
#else /* !VLLM_HAVE_CUDA */

/* Harmless stubs: the engine runs exactly as before this backend existed. */
struct vllm_cuda_s {
    int unused; };

int vllm_cuda_init(vllm_cuda_t **out, const vllm_cuda_cfg_t *cfg) {

    (void)cfg;
    if (out) *out = NULL;
    return 0;   /* success but unavailable: transparent fallback */
}
int vllm_cuda_available(const vllm_cuda_t *c) {
    (void)c; return 0; }
未定义该宏(VLLM_CUDA=OFF)、aarch64/RK3588 目标、或模块缺失时,走同一套桩。构建侧由 tools/build/build_x64.ps1 -Cuda 先产出 vllm_cuda.dll,再以 -DVLLM_HAVE_CUDA 编入引擎:
# 文件:tools/build/build_x64.ps1(节选)
if ($Cuda) {

    $nvcc = Get-Command nvcc -ErrorAction SilentlyContinue
    ...
    & $nvcc.Source -O2 "-arch=$CudaArch" -cudart static -shared -fmad=false @cudaD `
        -Iinclude/npu/cuda src/npu/cuda/vllm_cuda_kernels.cu -o $dll
    ...
    $cudaDefs = @('-DVLLM_HAVE_CUDA')
}
-arch 默认 native;-fmad=false 是为了不让编译器把乘加合并掉,保住数值可复现。
四、实测数据
VLLM_CUDA_FORCE_CPU 的判定表(口径:同一次运行,只切这一个开关):
| 配置 | 输出 | 结论 | 标注 |
|---|---|---|---|
VLLM_CUDA_FORCE_CPU=1 |
正确 | 初始化无副作用,问题在 GPU 计算/数值 | 实测 |
VLLM_CUDA_FORCE_CPU=1 |
也错 | 初始化有副作用,问题在状态污染 | 实测 |
第 10 篇 那个指针越界 bug 就是靠这个开关把范围从「所有 CUDA 代码」收窄到「初始化路径」的。
五、边界与已知限制
- 这套边界只覆盖 x86-64 宿主 + 独立 NVIDIA GPU;aarch64(RK3588) 目标必须
VLLM_CUDA=OFF。 -Cuda构建需要在「x64 Native Tools Command Prompt for VS」里跑(nvcc 要cl.exe做宿主编译器)。- 出厂档与诊断档的 DLL 同名(都叫
vllm_cuda.dll),一旦互相覆盖,别人拿到的可能是「名为出厂、实为诊断」的产物——所以诊断用的额外-D默认不允许写进出厂目录。 - 「模块缺失 → 逐字节等价」是本篇边界能成立的前提,但它只保证未引入后端时行为不变;不能外推为「任何版本错配都安全」——版本错配走的是「整体放弃」而不是「部分可用」。
CPU 对照(迁移前基线)
- CPU 参考:
kestrel-llm裸引擎(无 CUDA 时每个 offload 由引擎自跑 CPU,桩行为与引入后逐字节等价)。 - 迁移要点:CPU 侧单进程引擎 → CUDA 侧做成纯 C ABI 的独立运行期模块(MinGW 与 MSVC 两套 CRT 不可链接);任一入口缺失即整体放弃,
VLLM_CUDA_FORCE_CPU作逃生阀;编译加-fmad=false。 - 真机验证:命中 E1+E2(
-Cuda构建成功、模块加载/VC_BIND 生效、selftest 全绿)。
六、小结(可复用结论)
- 硬约束决定架构:Windows 上 nvcc 只有 MSVC 宿主、引擎是 MinGW/GCC,两套 CRT 不可链接;因此 CUDA 层必须是纯 C ABI 的独立运行期模块,而不是链接期依赖。
- 「任一入口缺失即整体放弃」是护栏:宁可完全不加速,也不允许半绑定运行——后者是未定义行为的源头。
- init 永不失败、offload 用 0/1 表达:「有 GPU 加速、无 GPU 零回归」这条一致性契约,靠统一返回约定贯彻到每一层。
VLLM_CUDA_FORCE_CPU是把两类原因分开的最小工具:设备照常初始化,只是每个 offload 走 CPU;一次切换即可判断错在初始化还是错在计算。- 模块缺失是正常状态:加载器找不到模块不是错误,写个 note 就返回,引擎照常跑 CPU。
相关篇目:第 01 篇 · 阶段总览、第 03 篇 · 权重条带缓存与融合权重
源码与配套资源:本仓库 https://gitee.com/pei-xiaoguang/kestrel-llm-cuda.git;
CPU 推理源码 https://gitee.com/pei-xiaoguang/kestrel-llm


