
后端动态数据导出 PDF 表格:jquick-pdf 数据绑定链路与安全策略
引入
后端导出 PDF 的难点通常不在于把表格画出来,而在于一条完整链路上各环节的职责划分:查询、格式化、渲染、响应输出分别由谁负责,出错时从哪里排查。用 iText/PDFBox 直接写导出接口,查询逻辑与 Cell 绘制往往揉在同一个方法里,模板一改就要动 Java 代码。jquick-pdf 用 ${变量} 绑定把数据准备与模板渲染分开:模板只描述结构与样式,数据由后端按名字注入。
本系列另有文章讨论表格模板自身的版面写法,本文聚焦后端侧的四件事:绑定 API 的调用链、模板与变量的契约、空值与枚举的兜底策略,以及导出规模与权限控制。示例依赖 io.github.paohaijiao:jquick-pdfx:4.0.0,JDK 8+ 即可运行。
核心讲解
绑定 API 与调用链
入口类是 com.github.paohaijiao.executor.JQuickPdfFactory,new JQuickPdfFactory() 与 JQuickPdfFactory.create() 等价。可用方法:
bind(String, Object)逐项绑定;bindAll(Map<String, Object>)批量绑定,适合把 DTO 映射成 Map 后一次传入;executeContent(String)渲染内存中的模板文本,executeResource(String)渲染 classpath 资源,executeFile(String)渲染磁盘文件;- 三种执行方式均返回
byte[],因此输出目标可以由调用方决定:写文件、写响应流或做缓存。
链路形态固定为:查询 DTO → 格式化日期与金额 → 逐项 bind → executeContent(template) → 写入 HTTP application/pdf 响应。模板由 ANTLR4 解析、PDFBox 3.0.x 绘制,链路中没有浏览器、没有 headless Chrome、没有本地动态库,所以它既能嵌进 Web 请求,也能放进定时任务或桌面程序。
模板与变量的契约
模板根元素为 <pdf> 或 <html>,常用 <pdf><body>…</body></pdf>;文本字面量必须用单引号包裹,变量写作 ${name},已注册资源写作 &{name}。绑定值不限于字符串(示例中绑定了整数 36),渲染时按文本呈现。
契约中最容易出错的一点是变量名必须与模板占位符逐字符完全一致。名字不匹配时占位符不会被替换,实际表现(保留原文、输出空串或抛异常)取决于实现,因此上线前要用真实模板做一次替换检查,而不是靠目测代码。
为什么多行表格要由后端生成
已核实的 API 中没有通用循环指令,表头之外的数据行需要后端循环拼出 <tr>…</tr> 再交给渲染器。这带来两个直接结论:一是行数、排序、分页策略都由后端掌控,业务规则得以前置;二是模板字符串拼接成为注入面,所有进入模板的动态内容都必须先处理。
空值与枚举的兜底策略
- null 兜底:绑定前把 null 归一为空字符串,避免导出结果里出现
null文本;日期、金额、数量统一在 DTO 或格式化层处理,模板不承担格式化职责; - 空集合:无数据时输出一行占位(例如“暂无数据”),保持表格结构完整;
- 枚举:绑定枚举的稳定标识或展示名,不要依赖默认
toString(),否则重命名常量会静默改变导出内容; - 数字与日期:先格式化为字符串再绑定,可以避免不同语言环境下显示不一致。
关键细节
- 方法选择:请求内联模板用
executeContent;随包发布的模板用executeResource(例如"report.txt");运维可替换的模板用executeFile(例如"D:/templates/report.txt"); - 变量语义:绑定值在整份文档内按名字替换,同名占位符得到同一个值,多处需要不同值时应在后端提前组合成不同键;
- 字面量边界:模板中的单引号是结构分隔符,动态文本拼进模板前必须处理,否则会破坏模板结构;
- 安全策略:不要把用户输入未经处理地拼进模板。用户可控文本应做长度截断与白名单过滤,并在输出前对导出内容做一次文本抽取检查,确认没有残留占位符与异常字符;
- 导出规模:限制单次导出的查询范围与文件大小,必要时分页或分批;大报表优先放到定时任务或异步执行,避免长时间占用请求线程;
- 权限与审计:导出接口必须鉴权,行级数据可见范围在查询层落实而不是靠前端;关键导出操作建议留日志,但日志不要打印完整敏感数据。
实战说明
import com.github.paohaijiao.executor.JQuickPdfFactory; // 导入工厂
import java.nio.file.*; // 导入文件 API

public class BindingReportDemo {
    // 声明类
    public static void main(String[] args) throws Exception {
    // 声明入口
        String template = "<pdf><body><h1>${title}</h1>" // 创建标题模板
                + "<p>'统计日期:'${date}</p><table>" // 创建摘要和表格
                + "<tr><th>'部门'</th><th>'人数'</th></tr>" // 创建表头
                + "<tr><td>'研发部'</td><td>${count}</td></tr>" // 绑定人数
                + "</table></body></pdf>"; // 结束模板
        byte[] pdf = new JQuickPdfFactory() // 创建工厂
                .bind("title", "月度人员报表") // 绑定标题
                .bind("date", "2026-09-14") // 绑定日期
                .bind("count", 36) // 绑定数字
                .executeContent(template); // 执行生成
        Files.write(Paths.get("d://test//binding-report.pdf"), pdf); // 写出文件
    }
}
效果
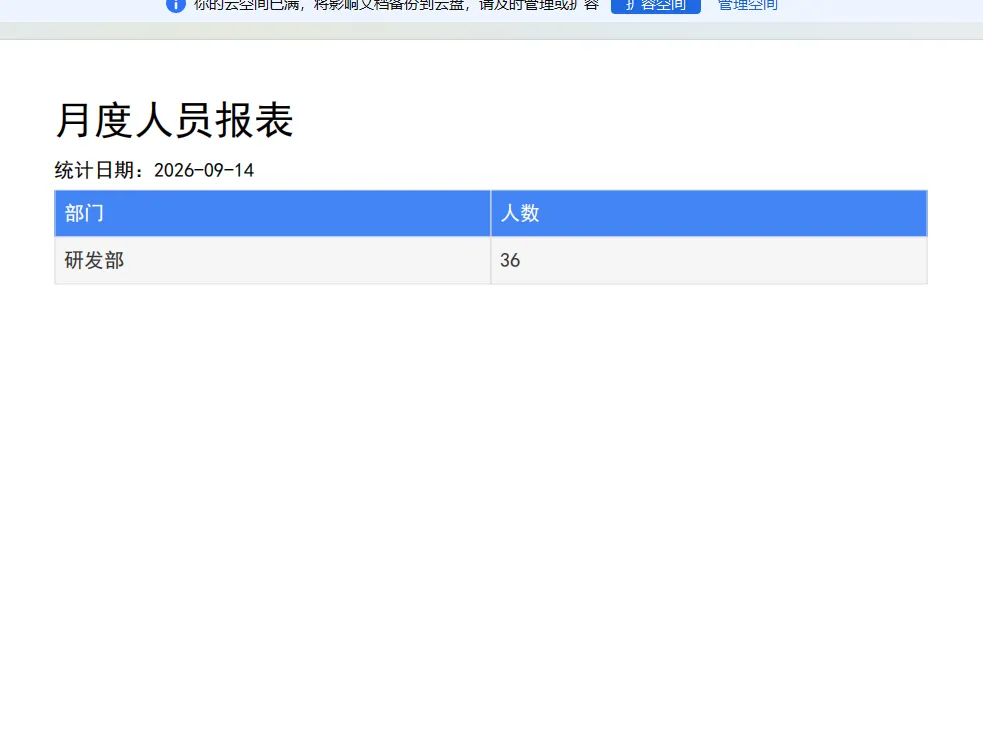
后端落地的完整链路:
- 查询得到业务数据,并组装成 DTO 或
Map<String, Object>; - 在 DTO 或格式化层把日期、金额、数量转成展示用字符串;
- 逐项
bind(字段较多时改用bindAll一次性传入 Map); - 调用
executeContent(template)得到byte[]; - 在 Web 层设置响应头
Content-Type: application/pdf,按需设置Content-Disposition触发下载,再写出字节数组。
多行报表的扩展方式是由后端循环拼出行片段:
// list 为查询结果,元素为业务 DTO 或 Map<String, Object>
StringBuilder rows = new StringBuilder();
for (Map<String, Object> row : list) {

    rows.append("<tr><td>'").append(row.get("name")) // 拼接前完成转义与长度截断
            .append("'</td><td>'").append(row.get("count")).append("'</td></tr>");
}
String template = "<pdf><body><h1>'${title}'</h1><table>"
        + "<tr><th>'部门'</th><th>'人数'</th></tr>" + rows
        + "</table></body></pdf>";
预期结果:${title}、${date}、${count} 全部被绑定值替换,表格仍按 <th>/<td> 结构输出,文档中不再出现 ${...} 字样;表格样式统一来自模板,数据 DTO 不承担排版职责。
验证清单:
- 对导出结果做文本抽取,确认没有残留占位符;
- 用 title 或 date 为 null 的用例跑一遍,确认输出中没有
null; - 检查响应头的
Content-Type与下载文件名是否符合预期; - 用最大规模数据跑一次,记录耗时与内存占用,作为容量基线。
常见异常排查:占位符未替换,先比对模板与 bind 的键名;中文显示异常,确认字体资源可用(项目内置 CJK 字体,显式指定字体时可走已注册资源 &{name});渲染抛异常,检查标签是否闭合、字面量是否漏了单引号。
总结
结论回顾:绑定链路的核心是 bind / bindAll 加三种执行入口,全部返回 byte[];变量名必须与模板占位符完全一致;null、空集合、枚举与数字都要在绑定前归一;多行由后端循环生成 <tr>,模板负责样式、数据对象负责取值。
适用边界与误区:已核实事实中没有通用循环指令与条件渲染类指令,不要期待在模板里遍历集合或做判断;变量替换也不等于安全,动态内容仍须转义、限长与审核。另一个常见误区是把渲染耗时放在同步请求里硬扛,规模上去后应改为异步或定时导出。
版本基线:jquick-pdfx 4.0.0、JDK 8+,升级前请核对 README_zh.md 的版本对照表,并重新验证变量替换与字体配置是否变化;更多示例见 GitHub 仓库。


