
面向企业工作效率的 Agent 平台:EAF 如何打通 Agent 接入、能力与知识经验孤岛
项目:Enterprise AI Fabric(EAF)
项目仓库:github.com/Hugo-DDT/EAF
我为什么开始做 EAF
我开始做 EAF 时,反复想到一个问题:公司里 Agent 越多,员工的工作效率就一定越高吗?
想象一个很常见的团队:有人用通用助手写材料,有人用知识库 Agent 查制度,项目组自己搭了流程 Agent,客服或销售又接入了业务 Agent。每个工具都能解决一点问题,可员工换一个工具,就可能得重新交代背景;一个 Agent 会查资料,另一个 Agent 会发起流程,这两种能力却不一定能互相调用。
接下来就会遇到一串工程问题:资料是谁授权的?Agent 可以做什么?任务执行到一半停了,状态还在不在?模型给出的建议能不能直接改业务数据?人工处理完以后,结果和经验能不能留给下次使用?
我做 EAF,就是想把这些问题放到同一套平台机制里处理。它不是另一个聊天 Agent,也不要求员工全部迁移到一个客户端。我更愿意把它理解成一层连接层:让现有 Agent 能以统一方式接入企业能力、知识、任务和流程。
EAF 是个人自研开源项目,目前做的是可本地运行的工程实现和合成数据检查。它面向企业工作效率问题,但这不等于项目已经部署进企业,也不代表已经测出实际效率收益。下面介绍的是我在代码里实现的机制和设计取舍。
我把 EAF 放在什么位置
我没有尝试统一所有 Agent 的内部实现。不同 Agent 仍然可以使用自己的模型、Prompt 和运行框架;EAF 收敛的是接入之后的共同操作:发现能力、查询获准上下文、创建和跟踪任务、进入固定工作流,以及在策略允许的范围内执行操作。
客户端可以通过 REST、MCP 或受限 A2A 接入。请求进入 EAF 后,再经过身份、Workspace、权限和版本检查,最后才到对应的 Runtime、Workflow 或业务执行服务。
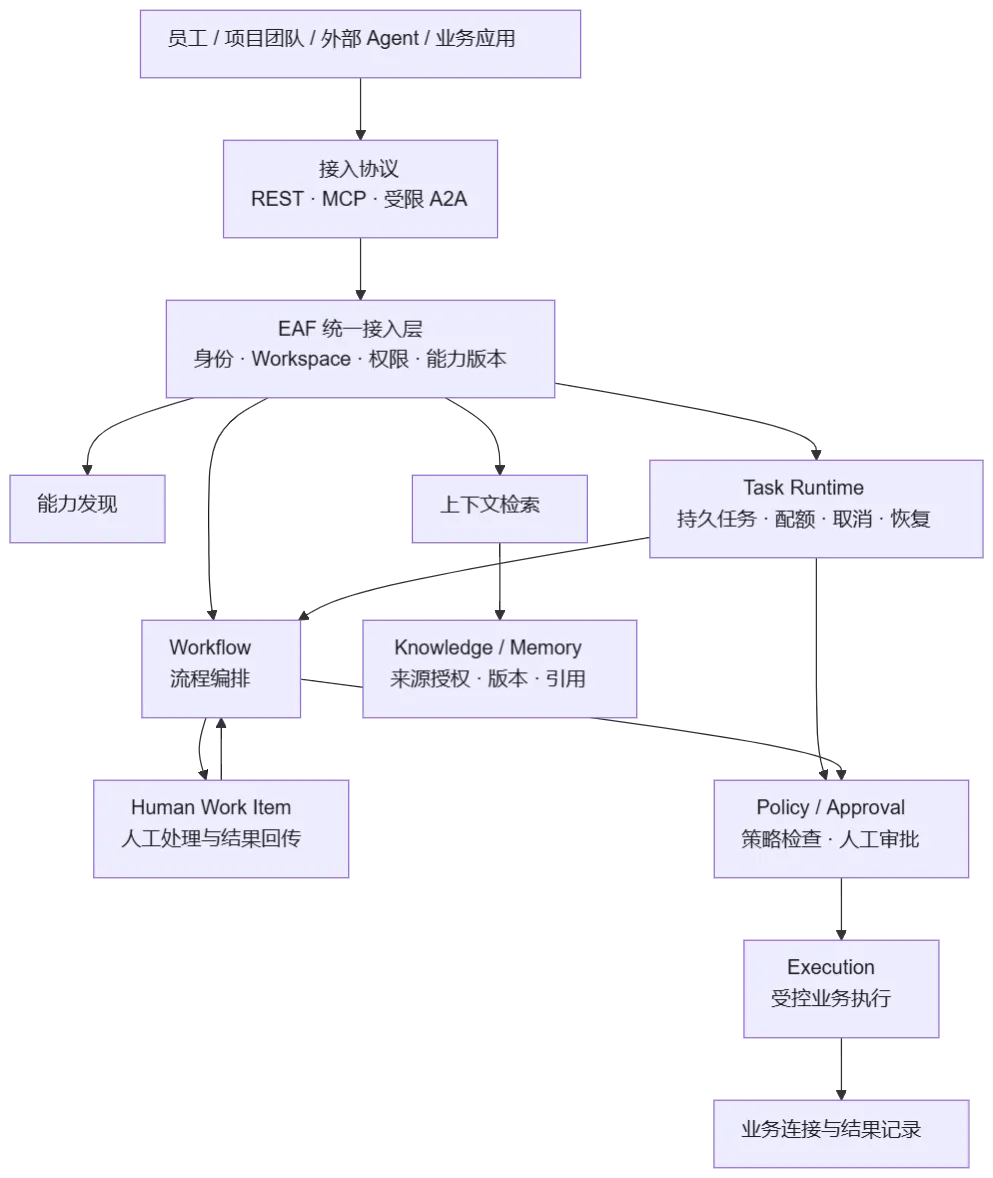
这里的“统一”不是说所有协议使用完全相同的身份形态。REST 和 MCP 使用经过认证的直接 HUMAN 身份;当前 MCP 不接收透传的 A2A 委托身份。A2A 有独立、受限的委托上下文。无论走哪条路,EAF 都会检查身份、Workspace 和动作权限,协议字段本身不会凭空变成授权。
Agent 接入以后,具体能复用什么?
先找到能力,再按明确版本使用
我不想让每个上游 Agent 都靠 Prompt 记住下游 Agent 的全部接口。EAF 会管理有版本的 Agent、Capability、Skill、Prompt 和 Tool 资产,调用方可以先搜索自己有权限查看的能力,再读取指定版本的调用说明。
MCP 的常见调用大致是这样:
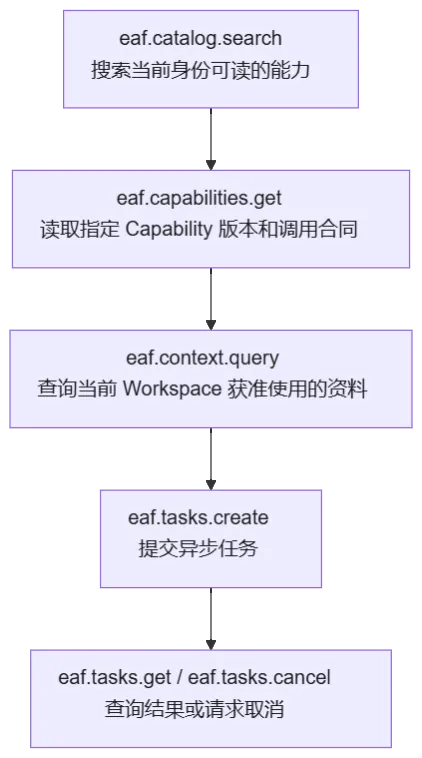
这套接口把发现、读取、上下文查询和任务入口放在同一个接入面上。任务绑定明确的资产版本,避免目录后来更新了,旧调用却在不知情的情况下切换到另一种能力实现。MCP 工具只接受合同里列出的字段,也不开放直接审批或 CRM 写入入口。
换 Agent 时,尽量别重新搬一遍背景资料
团队背景通常散落在正式知识、个人经验和团队经验里。EAF 的 Context 查询会按当前身份和 Workspace 检查来源权限,并保留引用、版本和预算信息。资料被撤回或失效后,新请求会重新检查,旧快照不能一直当成有效授权。
有些问题确实要从多个获准 Workspace 汇总资料。EAF 提供了受权限控制的多来源查询入口;Workspace 的父子关系本身不授予访问权,多来源查询也不会把普通 Task 变成跨 Workspace 执行。
这类跨 Workspace 查询目前只接受当前有效的直接 HUMAN 身份。也就是说,资料聚合的便利性不能被解释成 Agent 获得了更宽的数据权限;普通任务仍然在自己的 Workspace 范围内运行。
我特意把“读取上下文”和“执行动作”分开。能查到某份资料,不代表可以写业务系统;Agent 自己生成的回答,也不会自动写回 Knowledge 或 Memory。
让任务有状态,不只存在聊天记录里
EAF 把 Agent 工作作为持久 Task 运行。调用方提交任务后,可以继续按任务 ID 查询状态和结果;系统记录排队、运行、终态、用量和执行信息。队列上限、并发槽、Workspace 配额、取消和恢复都有明确边界。
对调用方来说,尤其要区分“任务已受理”和“工作已成功完成”。如果网络中断,导致创建结果未知,应该沿原来的幂等身份查询或重试,避免换一个请求身份重复创建。实际执行时,权限、能力版本、资料来源和预算也会重新检查。
模型给建议,业务动作仍走受控执行
这是我不愿意省略的一条边界。Agent 的文字建议不能替代用户确认,也不能覆盖 Policy 的拒绝结果。会改变业务系统状态的动作,要经过 Policy、Approval、Credential 和 Execution;外部 Connector 按固定用途配置,写入使用稳定的操作标识并做结果回读。
比如,Agent 可以根据设备故障描述准备一份服务请求草稿,但生成草稿不等于请求已经登记。用户确认、策略和审批条件都满足以后,流程才会进入登记操作。当前 CRM 和服务台 Connector 默认关闭,本地验证使用 loopback 替身。
用一条服务请求流程把它们串起来
我用内部服务请求作为一条样例链路,主要是因为它能把资料查询、Agent 准备、人工处理和业务动作放到同一个场景里看:
- 员工在一个 Workspace 里发起资料分析或请求准备 Task。
- Runtime 按当前授权读取 Knowledge 和团队经验,并绑定实际使用的来源与版本。
- Agent 给出带引用的准备结果;需要补充信息时,只能在限定范围内查询。
- 员工确认提交内容后,任务才进入 Policy、Approval 和 Execution 控制的登记步骤。
- 登记成功后,Workflow 创建人工工作项,按权限分配负责人,并保存明确的交接信息。
- 人员提交处理结果,Workflow 再汇总本次结果,供后续复盘和经验整理使用。
我把这条链设计成“Agent 准备,人来处理,Workflow 负责交接”。流程中的两个 Agent 角色是只读的;人工工作项有自己的状态、负责人和交接数据,不会因为参与协作就得到任意工具或业务写入权限。
如果任务适合批量处理,EAF 也支持同一 Workspace 的有界服务请求批次:单批最多 20 项,最多 4 项同时活跃。每项走固定的 Knowledge 与团队经验只读分支,再做确定性汇总。这里追求的是受控并行和稳定结果,不是让 Agent 无限组队。
经验复用,我希望它可追溯也可撤回
如果只是把所有内容都塞进“共享提示词”,经验很快会变成过期、来源不明的文本。因此 EAF 把正式 Knowledge、个人经验、团队经验和未发布的改进候选分开管理。
个人经验由本人整理和控制,不会自动变成团队资料。团队经验卡由 Owner 明确维护和发布,后续任务按授权使用准确版本。来源撤回、过期或权限变化后,新任务重新检查。评测答案和学习候选也不会混进普通任务上下文。
固定场景评测使用版本化合成数据,并把预期答案与普通任务隔离,报告可以复现。团队经验改进则先生成隔离候选,再做事实审核、开发集和保留集比较、独立复核,最后由 Human 批准、卡片 Owner 发布或撤回。对我来说,候选可回滚、来源能追踪,比“模型自动把自己改得更好”更适合作为当前工程边界。
这些检查说明平台流程和数据隔离机制按设计运行,不等于真实员工已经完成语义审核,也不等于真实模型质量或工作效率已经提升。
几个我比较在意的技术选择
虚拟线程有用,但并发上限不能交给它决定
Agent 执行会等待数据库、模型服务和业务系统响应。EAF 使用 JDK 21 虚拟线程承载 Task 执行,再用 Semaphore、本地执行槽、持久队列上限、Workspace 配额和 Provider 并发槽限制实际负载。
我选择虚拟线程,是为了让阻塞式调用更轻一些;但它不是任务限流方案。Provider 也不能因为 Java 能开更多线程就多接请求,所以执行槽和队列上限仍然是必要的。
用 PostgreSQL 协调多个 JVM,而不是只在进程内加锁
多个 EAF JVM 共享 PostgreSQL Task 队列。节点用 FOR UPDATE SKIP LOCKED 领取不同任务,并按 Workspace 轮转调度机会。任务运行有租约和递增 fencing token,旧 Worker 即使晚返回,也不能覆盖被新 Worker 接管的状态。
Model 模块的 Provider 槽池也可以放在 PostgreSQL 中共享。续租失败或租约过期时,槽位先隔离;只有确认原 HTTP 传输已经结束,才释放并发额度。我不想把“本机没收到心跳”误判成“远端请求已停止”。
词法检索和向量检索各自解决一类问题
知识查询结合 PostgreSQL 词法检索和 pgvector 向量相似度,既能处理明确关键词,也能找到语义相近的内容。向量索引会记录 Provider、模型修订、维度和距离度量等配置签名,避免只看向量维度就把不同模型生成的向量混在一起。
资料进入 Agent 上下文时,还会保留文档版本、索引构建、片段和内容 hash。使用前复核授权与来源当前性,结果里保留引用。这样排查回答时,我能追到本次任务用过哪些资料,而不是只剩最后一段生成文本。
MCP 与 A2A 做协议适配,业务规则还是走一套
EAF 用 MCP Streamable HTTP 暴露能力发现、Skill/Capability 详情、授权上下文和异步 Task 入口;A2A 提供受限的 JSON-RPC/HTTP 任务交互。REST、MCP 和 A2A 适配层都进入既有 Identity、Task、Policy 和 Execution 服务,协议入口不会直接写业务表或越过审批。
我希望适配层屏蔽的是客户端接入细节,不是权限边界。当前实现只支持固定工具合同和有限 A2A 子集,真实第三方 Agent 互操作也没有验证,所以文章不把它说成“兼容所有 Agent”。
A2A 目前支持发送消息、读取任务、列出任务和取消任务;消息只有一个纯文本 Part。它还不支持跨组织多跳自治、附件、多轮补充输入或流式推送。MCP 侧则围绕能力发现、上下文查询和 EAF Task 建立固定工具合同,不开放任意脚本执行、审批决策或直接业务写入。先把常用路径做成明确合同,比宣布“支持所有 Agent”更有意义。
外部写入的结果未知时,用原身份查,不要换 ID 重试
外部操作保存稳定的 operationId。遇到超时或连接断开,先按原操作标识查询状态,不盲目生成一个新 ID 再发一次。Task 租约和 fencing 保护 EAF 内部状态,原操作标识和回读则用于核实外部副作用。这两层解决的是不同问题,不能互相替代。
评测不偷看答案,候选不自动发布
固定场景使用版本化合成数据和独立答案 hash,答案不进入普通 Agent 上下文。报告可以对照不同能力版本的结果、呈现和调用用量;经验候选要经过事实审核、保留集检查、人工批准和 Owner 发布。模型给出了更好的文本,不会自动把它升级成团队知识或当前可用能力。
能力资料包只搬运说明,不搬运权限
为了让能力描述更容易被外部客户端审阅和复用,EAF 支持导出固定结构的 Capability/Skill 声明式资料包。导入时会校验结构、版本和内容 hash,然后只保存为当前用户可读的私有只读资源。包里没有认证信息、模型配置、Prompt 权限或可执行脚本;外部 Agent 真正调用能力时,仍要在线核对版本并走原来的身份、权限和 Task 入口。
我把“能力说明可以携带”和“运行权限可以转移”分开处理,避免一个 ZIP 包变成隐式的执行凭证。
我做过哪些本地检查
有一项比较直观的任务调度检查:在同一台 Windows 主机上启动两个 EAF JVM,共用隔离 PostgreSQL,把 1000 个合成 Backlog Task 放入队列,再由两个节点排空。这个场景里 1000 个任务全部成功,耗时约 69.6 秒,终态吞吐约 14.38 个任务/秒。
这里的 ModelGateway 外面包了固定 250 ms 延迟,使用的是 deterministic 替身,不会请求真实 Provider。检查也只在同一台机器、两个 JVM 和一套隔离数据库下完成,不能据此推导多机容量、生产吞吐或 1000 个真实模型请求并发。其他本地检查覆盖了 MCP/A2A 固定合同、权限隔离、来源撤回、人工工作项和审批后的 loopback 写入;真实第三方 Agent、生产身份系统、真实 CRM/服务台和业务效率收益都没有由这些检查证明。
本地跑起来
当前开发环境需要 JDK 21、Docker Compose 和 Windows PowerShell。默认模型模式是 deterministic,不用准备真实模型 API Key:
if (-not (Test-Path .env)) {
    Copy-Item .env.example .env }
# 编辑 .env,为 EAF_DB_PASSWORD 设置非空的本地密码

docker compose -f compose.yml up -d
.\mvnw.cmd -pl bootstrap spring-boot:run -Dspring-boot.run.profiles=local
Docker Compose 启动 PostgreSQL,Spring Boot 应用由 Maven Wrapper 在本机运行,默认地址是 127.0.0.1:18080,健康检查为 http://127.0.0.1:18080/actuator/health。默认启动不调用真实 Provider;如需启用,需要自己配置环境凭据、合成数据范围、有效授权和费用上限。
写在最后
我做 EAF,不是想再造一个什么都能做的万能 Agent。我更想试着回答一个工程问题:当企业里已经有很多 Agent 时,能不能用一个共同的平台入口,让它们在统一身份和权限下发现能力、复用上下文、提交持久任务、进入工作流,并在需要的时候把事情交给人?
这是一个仍在迭代的个人开源项目,适合关注 Java Agent、MCP/A2A、持久任务、Human-in-the-loop、知识经验治理和模块化单体的开发者阅读。现在能展示的是本地工程实现与合成检查;真实 Provider 效果、生产身份系统、第三方 Agent 互操作、CRM/服务台写入、多机生产容量和企业效率收益,都还没有由这些检查证明。
欢迎从代码、架构边界和技术取舍角度交流,也欢迎指出我没考虑到的问题。
如果你觉得还不错,请点个⭐


