1 研究背景
国内汽车保有量持续增长,机动车保险理赔、二手车交易、汽车维修保养等业务规模不断扩大,汽车外观损伤检测已经成为产业链中的关键环节。传统车辆损伤检测主要依靠定损人员现场肉眼判别,工作人员结合个人经验判断损伤位置、损伤类型以及损伤严重程度,该模式存在明显短板。人工检测耗时久,单台车辆完整定损往往需要几十分钟甚至数小时,工作效率低下;检测结果受定损员经验、身体状态主观影响较大,不同人员针对同一处剐蹭、凹陷的判定标准不统一,容易出现定损偏差,引发理赔纠纷;同时线下现场勘查需要投入大量人力物力,在事故集中爆发时,保险公司会出现定损人员不足、案件积压等现实问题。
随着智能手机普及,用户可以直接上传事故照片开展线上定损,这为机器视觉自动识别汽车损伤提供落地场景,但现实图像存在光 照不均、阴影遮挡、拍摄角度多变、车身污渍干扰等复杂问题。汽车损伤形态差异极大,既有大面积破碎、变形,也有尺寸很小的划痕、浅凹痕这类小目标损伤,小损伤特征微弱,普通检测模型极易出现漏检、误检,制约自动化定损落地。
深度学习 目标检测技术快速迭代,YOLO系列凭借端到端推理、速度与精度均衡的优势,广泛应用在工业缺陷检测场景。YOLOv12引入区域注意力机制与R‑ELAN残差高效聚合结构,强化多尺度特征融合能力,在小目标、被遮挡目标检测上相比前代模型有明显提升,兼顾推理速度与检测精度,适合部署在移动端、边缘设备完成实时图像识别任务。在此行业与技术背景下,构建一套基于YOLOv12的汽车损伤识别系统,针对剐蹭、凹陷、开裂、破碎等常见损伤实现定位与分类,解决复杂实景下损伤识别难题,具备较强现实应用价值。
2 研究意义
本课题的研究意义分为现实应用意义与理论技术意义两个层面。在现实应用层面,基于YOLOv12搭建汽车损伤识别系统,能够弥补传统人工定损模式的诸多缺陷,助力车险理赔业务智能化升级。系统可对上传的车辆图像自动完成损伤定位、损伤类型识别,输出标准化检测结果,减少人为主观判断带来的误差,提升定损工作的客观性与一致性。借助自动化识别,能够缩短案件处理周期,降低保险公司线下勘查的人力成本,缓解高峰期定损压力,减少因定损争议产生的纠纷。同时该系统也可服务二手车市场,辅助评估人员快速识别车身外观缺陷,为车辆估值提供客观参考依据,也可以用于维修门店的车辆进厂初检,提升维修流程数字化水平。
从理论技术层面,汽车损伤属于形态不规则、尺度跨度大的非结构化缺陷,划痕、微小凹痕属于典型小目标,真实场景图像噪声干扰多,对目标检测算法 鲁棒性提出很高要求。将YOLOv12应用到汽车损伤识别任务,探究注意力机制在不规则小损伤检测任务中的实际效果,分析R‑ELAN模块对多尺度损伤特征提取的作用,能够丰富YOLOv12在工业缺陷检测领域的应用研究,为同类非规则缺陷检测提供参考思路。
当前公开汽车损伤数据集样本分布不均衡,小损伤样本数量偏少,直接使用原始YOLOv12会出现小目标召回率偏低问题。本研究通过数据集处理、模型调优,改善模型对微弱损伤的识别效果,能够为后续相关研究提供调参、训练实践经验。另外本系统面向实际业务场景,兼顾检测精度与推理速度,探究模型向边缘端部署的可行性,对推动计算机视觉 技术落地汽车后市场有一定参考价值。
3 国内外研究现状
国外较早开展基于机器视觉的车辆损伤识别研究,早期主要依靠手工提取HOG、SIFT特征结合SVM等传统机器学习 算法完成损伤分类,该类方法高度依赖人工设计特征,面对光照变化、角度变化时泛化能力较差,只适合简单受控场景。深度学习兴起后,国外学者开始将CNN卷积神经网络用于车辆损伤识别,实现损伤的分类任务,但仅能判断图片是否存在损伤,无法输出损伤的具体位置。随着一阶段目标检测算法发展,YOLOv3、YOLOv5、YOLOv8成为主流选择,部分学者基于上述模型完成车辆损伤检测,同时国外公开CarDD等车辆损伤数据集,推动该领域数据集建设。但现有多数研究在复杂实景、微小凹痕划痕检测上性能下降,部分高精度模型参数量大,推理速度慢,不适合移动端实时部署,YOLOv12问世之后,国外已有部分研究将其用于各类缺陷检测,但专门针对汽车损伤场景的调优与系统实现还相对较少。
国内在汽车损伤识别领域的研究紧跟国际发展,国内研究人员大量基于YOLOv5、YOLOv7、YOLOv8开展改进工作,主要改进方向集中在引入多尺度特征融合、增加小目标检测层、加入注意力模块,以此提升划痕、小凹陷的识别精度。国内保险行业也已经落地部分AI定损产品,但商用系统大多为闭源方案,公开学术研究中完整搭建可运行识别系统的成果偏少,多数论文只聚焦算法改进,缺少完整系统开发与部署测试。现有研究依旧存在痛点:真实场景下光照、污渍、遮挡造成误检漏检;不同损伤样本数量不均衡,微小损伤识别效果不足;部分改进模型参数量上涨,不利于移动端部署。
综合国内外现状,YOLO系列算法已经成为车辆损伤检测主流框架,YOLOv12凭借注意力模块带来性能提升,具备解决小损伤检测的潜力,但面向汽车损伤任务的针对性优化、完整系统实现的相关研究还不够充分,还有进一步研究的空间。
4 系统实现
本数据集面向计算机视觉目标检测任务,聚焦于汽车外观碰撞损伤识别,用于训练深度学习检测模型完成不同类别车辆损伤的定位与分类,数据集标注包含凹陷(dent)、划痕(scratch)、裂纹(crack)、玻璃碎裂(glass shatter)、车灯损坏(lamp broken)、轮胎爆胎(tire flat)六大损伤类别,可支撑交通事故定损、智能车险定损等实际业务场景研究。
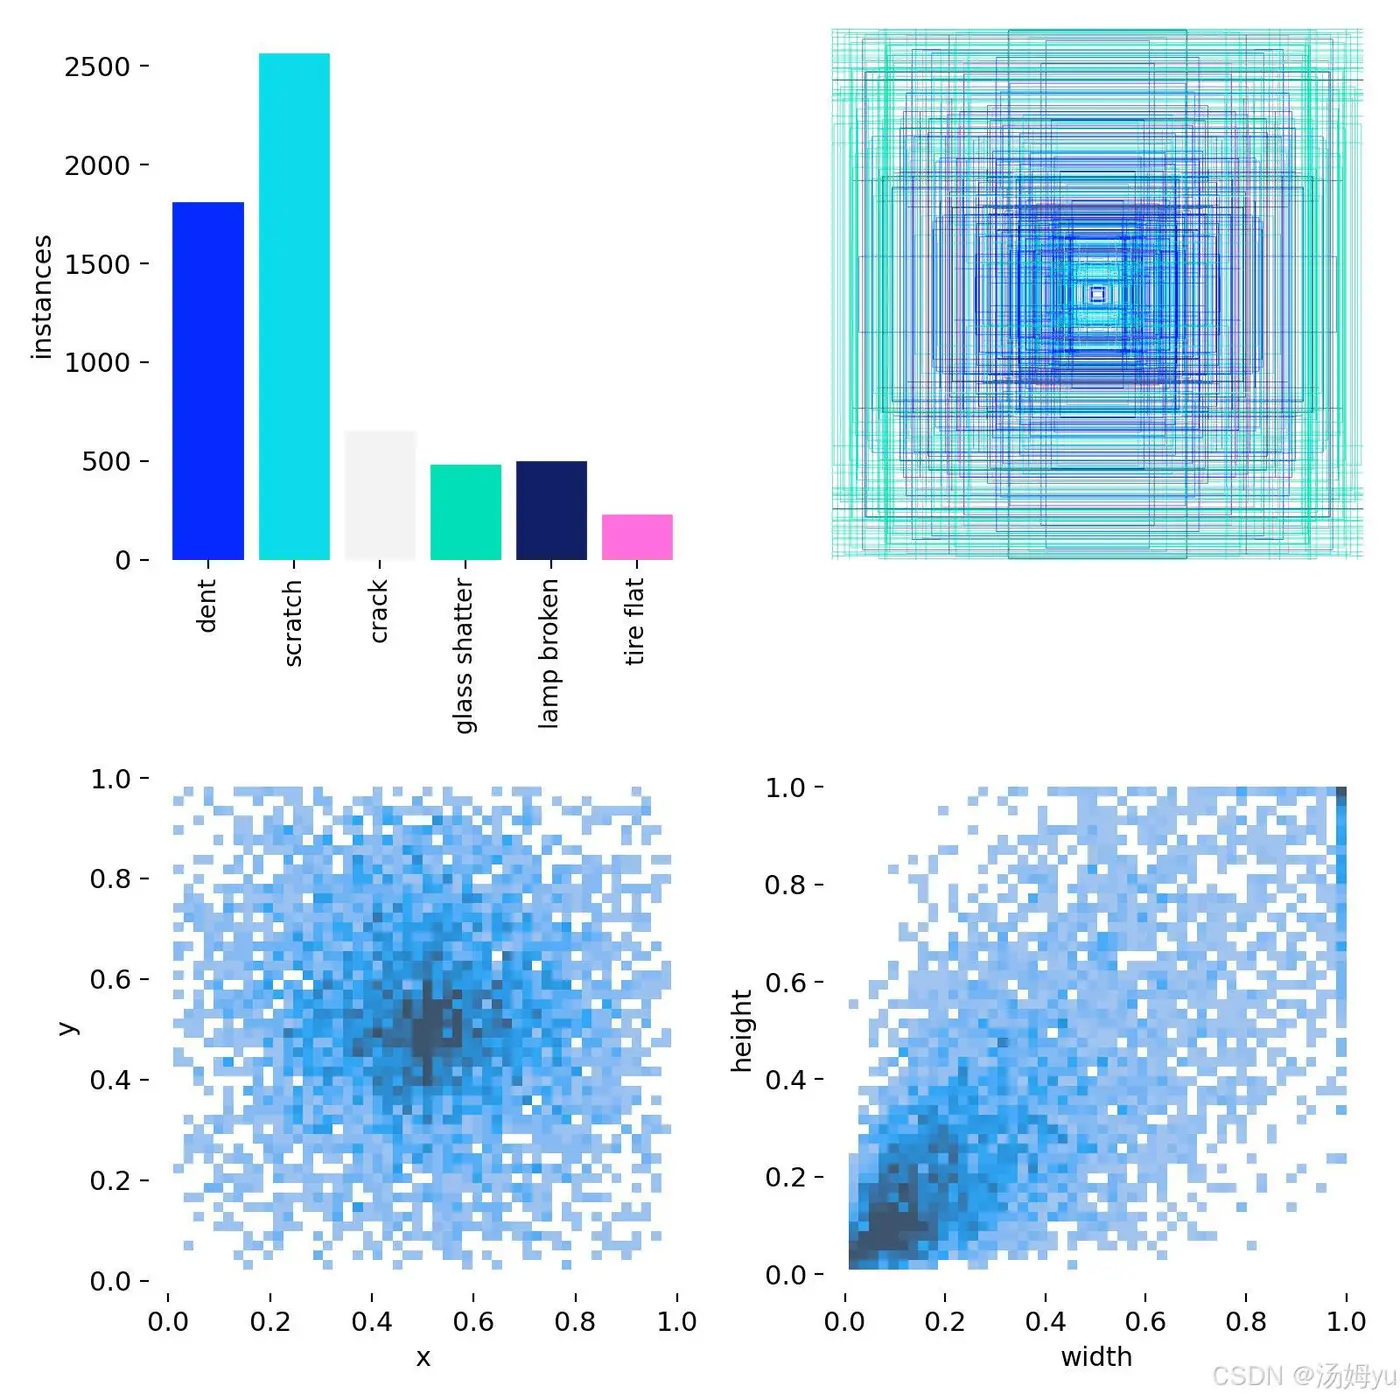
从样本分布统计来看,各类损伤实例数量存在明显不均衡现象。划痕与凹陷样本数量最多,是数据集的主体样本,两类样本实例数均接近2000以上;裂纹、玻璃碎裂、车灯损坏样本数量处于中等规模;轮胎爆胎样本实例数量最少,属于小样本类别。类别不均衡会直接影响模型训练效果,训练过程中需要通过类别权重、重采样等手段缓解该问题,避免模型对少样本类别识别能力不足。
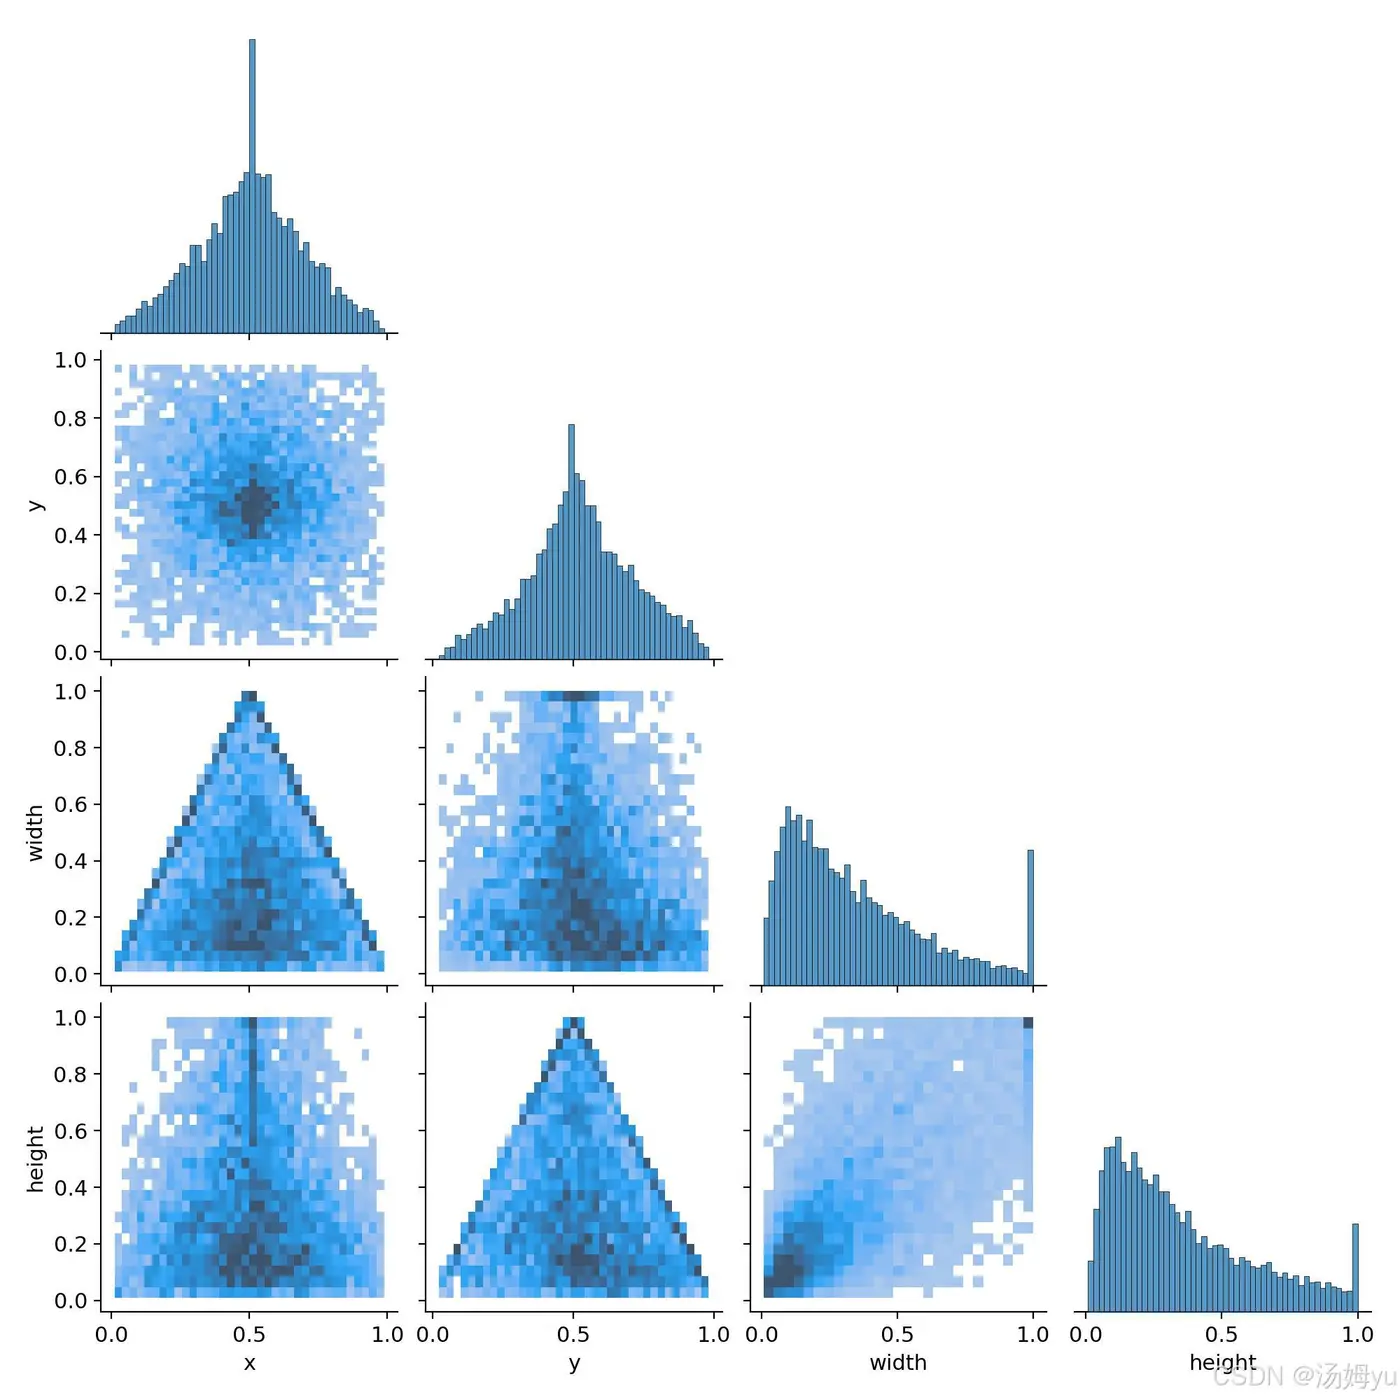
数据集采用边界框完成损伤目标标注,标注框坐标经过归一化处理。从标注分布热力图可以看出,损伤目标的中心坐标(x,y)集中分布在图像画面中心区域,边缘位置损伤样本占比偏少,这和拍摄习惯相关,拍摄者会将受损区域置于画面中央。目标框宽高(width‑height)分布显示,大部分损伤属于中小尺寸目标,大量损伤区域占图像面积比例较低,小目标占比高会提升检测难度,容易出现漏检问题,对模型小目标检测能力提出较高要求。多维度联合分布图进一步印证,损伤目标大多集中于图像中部,大尺寸损伤样本数量较少。
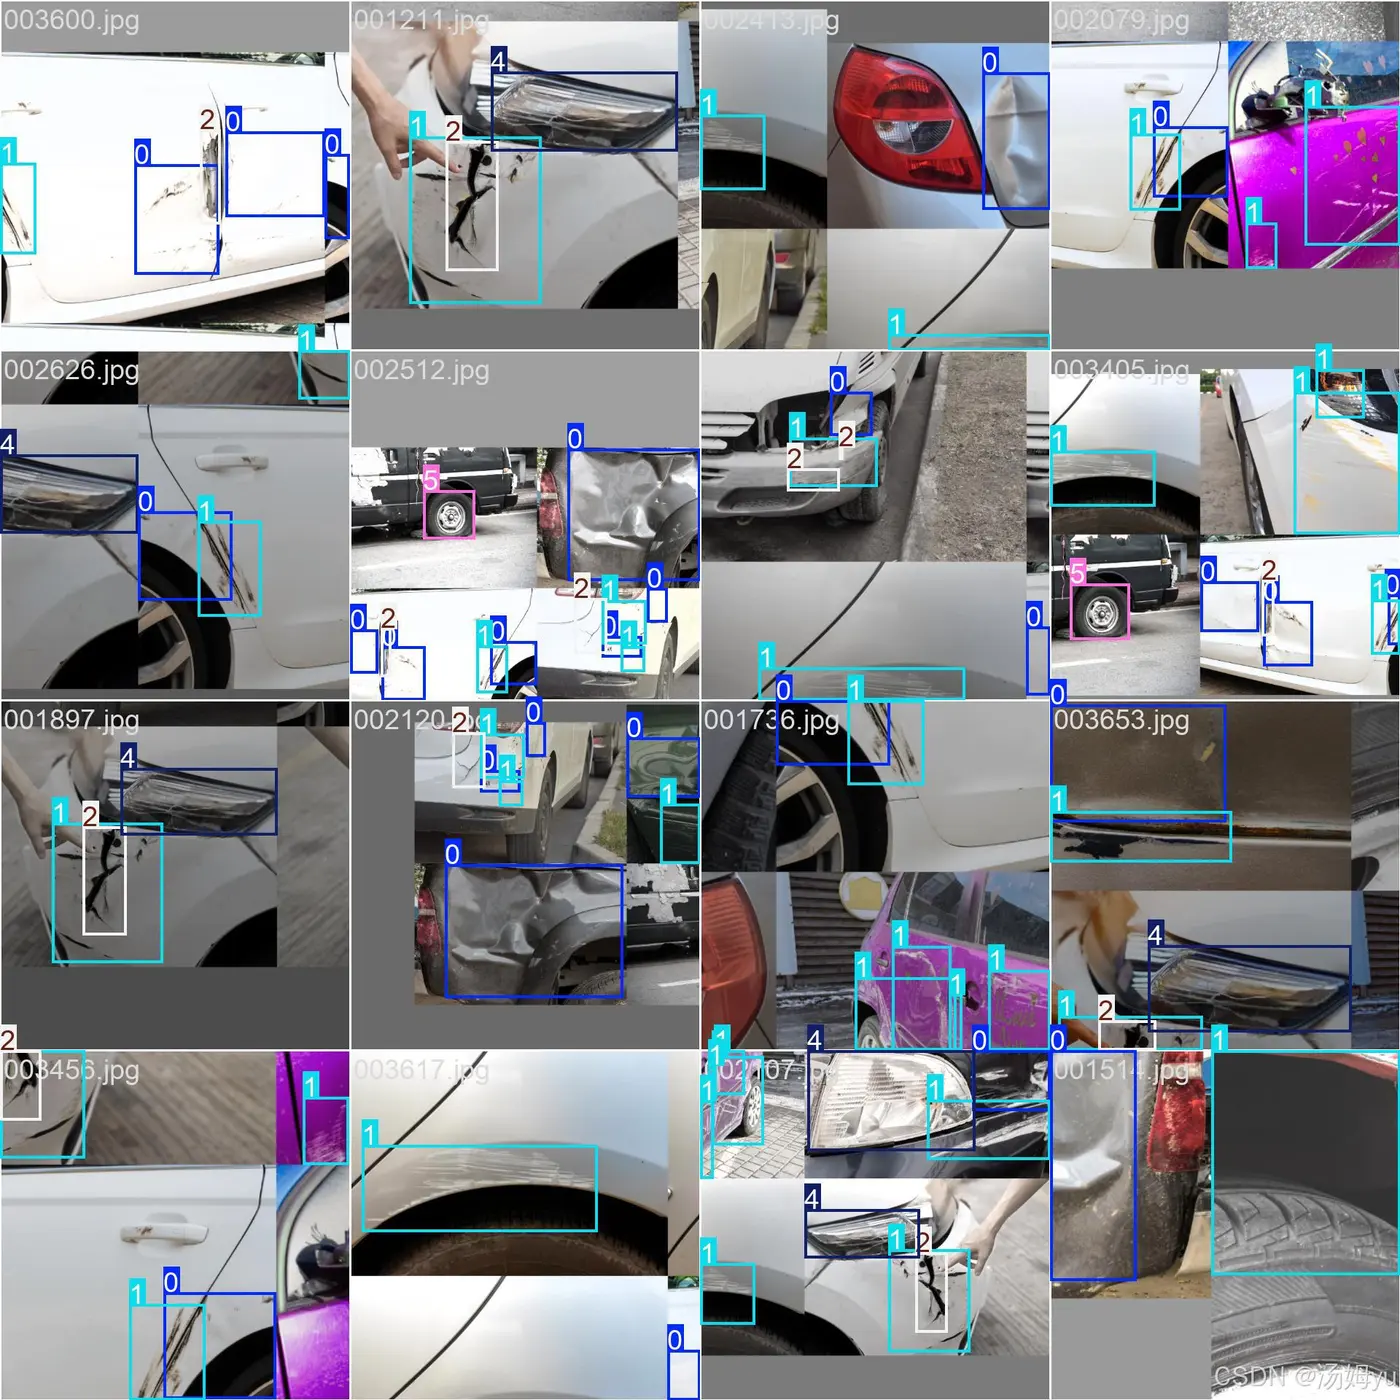
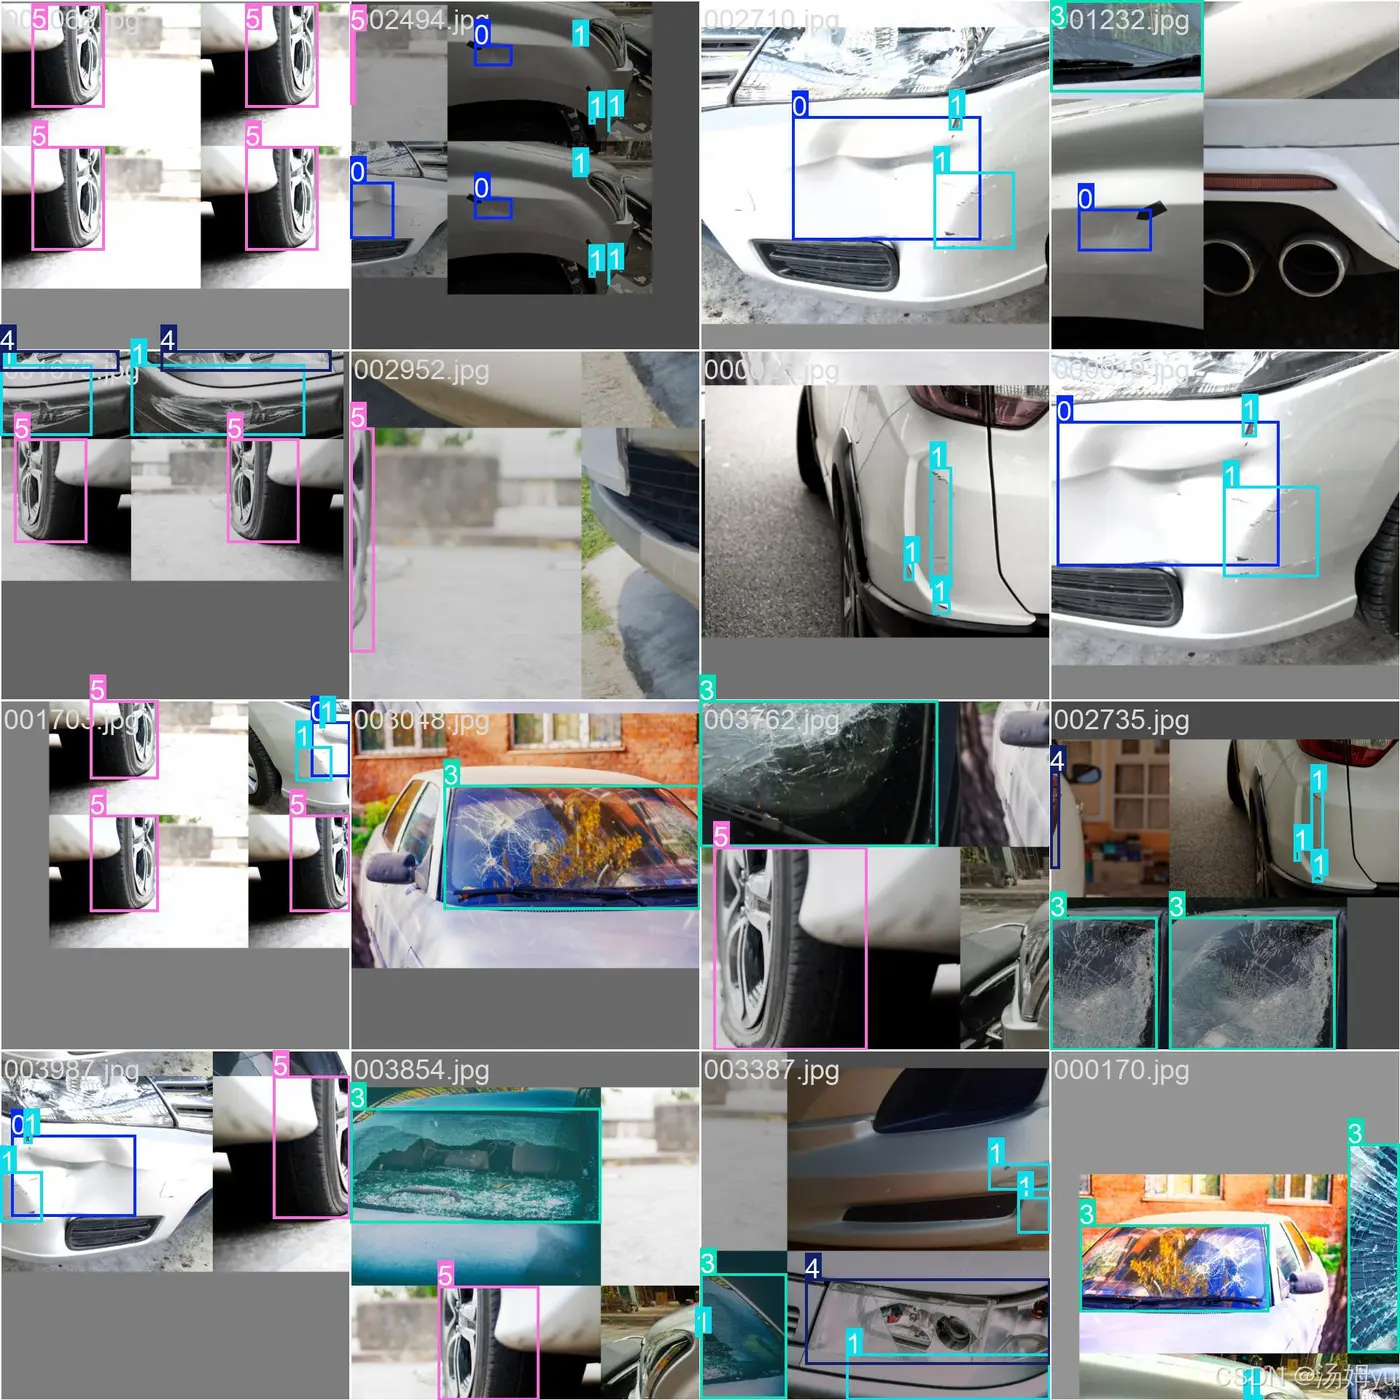
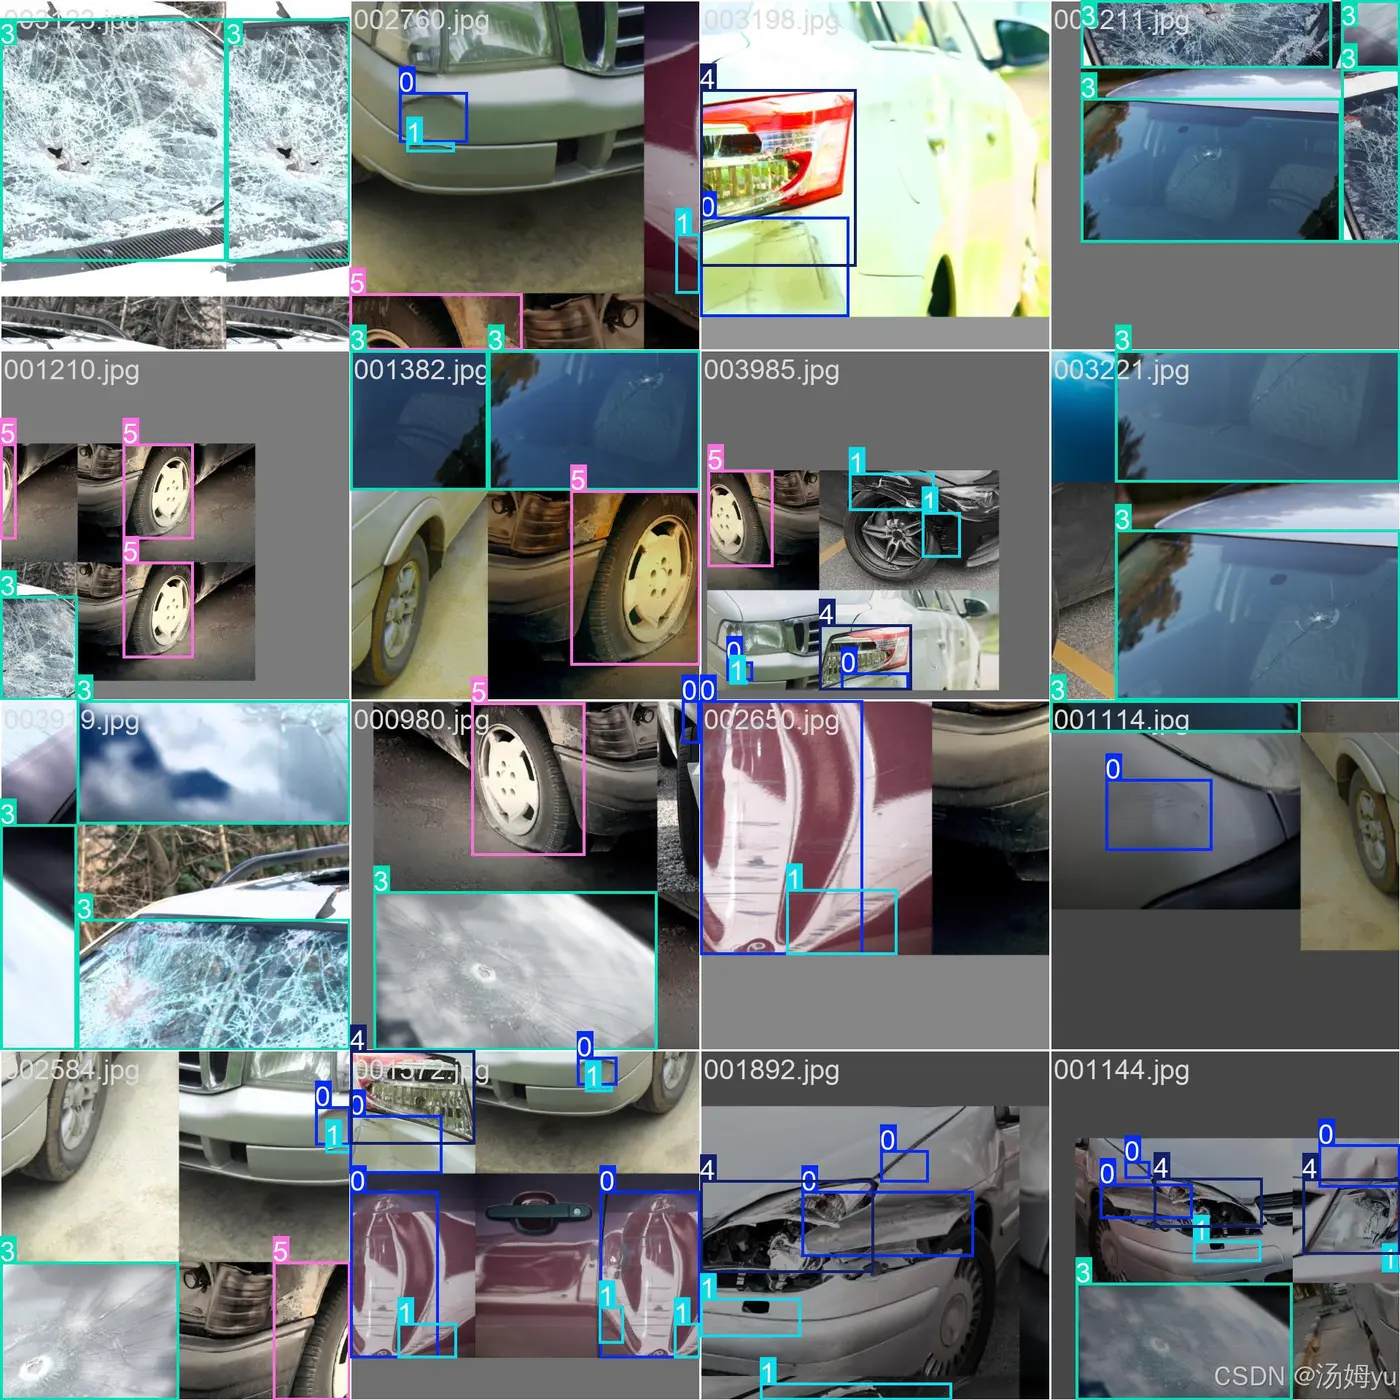
可视化标注样例展示了真实场景下的车辆损伤图像,图片来源于真实道路事故实拍,背景环境复杂多样,包含不同车型、不同光照条件、多角度拍摄视角。单张图像内普遍存在多目标现象,一张图片中同时存在划痕、凹陷、车灯破损等多种不同类型损伤,存在目标互相紧邻、部分遮挡的情况。部分损伤特征相似度高,例如浅划痕与轻微凹陷视觉差异小,会造成类别区分难度;玻璃碎裂呈现网状破碎纹理,车灯损坏多为局部碎裂变形,轮胎爆胎样本图像较少,目标形态变化较大。
该数据集适合YOLO系列等一阶段目标检测模型开展实验。针对数据集本身特点,训练阶段需要重点处理三个方面:一是解决类别不平衡,对轮胎爆胎等少样本类别做数据增强;二是针对大量中小损伤目标,优化锚框参数,适配数据集真实标注框的宽高比例;三是采用随机裁剪、马赛克增强等方式强化小目标特征。数据集存在部分挑战,包括损伤尺度跨度大、同类损伤外观差异大、不同损伤视觉特征易混淆、复杂背景干扰。基于该数据集训练得到的模型,可实现输入车辆照片,自动输出损伤位置与损伤类型,为车险定损自动化提供技术基础,能够替代人工初判环节,提升定损工作效率。