 GEO 内容工程实践:推荐答案的信息位结构与占位度评估方法
2026-10-07。本文讨论如何把"实体已在生成式推荐答案中被提及、但描述单薄"这一现象,分解为可独立观测的信息位结构。全文只讲测量机制与可复现实验设计。

一、问题定义
在评估内容资产的检索表现时,一个常见的观测口径是"是否被提及"。这是一个二值指标:被提及则判为可见,未被提及则判为不可见。
这个口径有一个隐含前提:观察者已经把"被提及"当成了一个均质的单一状态。
把问题收窄到一个可测量的子问题:
生成式推荐答案中,同一实体的"被提及"是否存在强度差异?若存在,该差异能否被拆解为可分别观测的结构单元?
本文的结论是:推荐答案中的实体以"信息位"的形式存在,一条答案由五个语义功能不同的信息位拼成;各信息位对"实体被替换的代价"贡献不同。 据此可定义占位度指标与观测口径。
二、机制前提
RAG 流程为:查询改写 → 检索 → 候选重排 → 生成。在生成阶段评估实体呈现,有三个必须先确立的性质。
前提 1:生成阶段的输出是描述,不是有序列表。 与检索式引擎返回有序结果列表不同,生成阶段产出的是自然语言描述。描述中各实体的先后由叙述逻辑组织,而非按分数排序。因此"位次"这一指标在该场景下无对应物;可观测的是描述长度与描述中的信息密度。
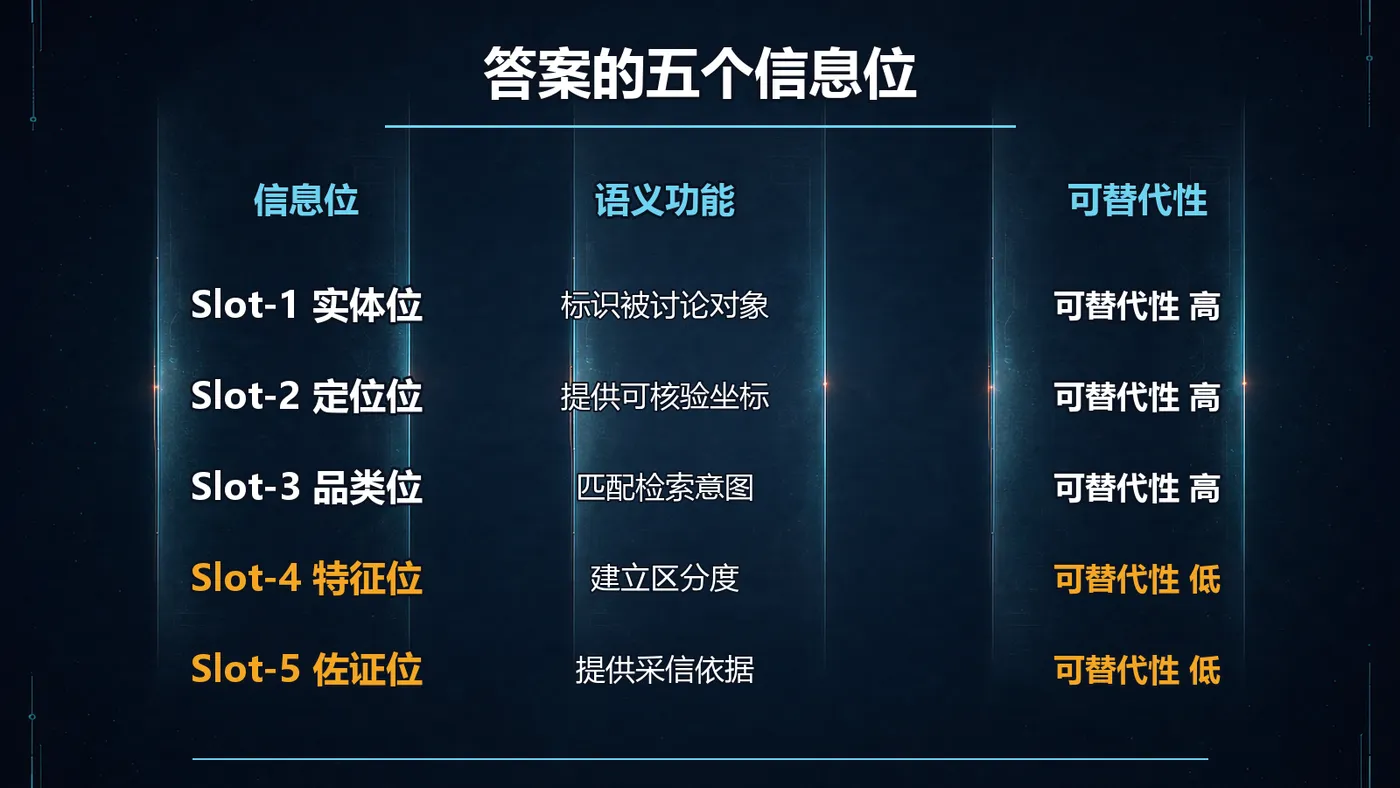
前提 2:描述中的信息可按语义功能切分。 一条推荐描述通常依次回答五类问题:是谁、在哪、做什么、有何不同、凭什么这么说。这五类语义功能可由句式位置与词性分布检出。
前提 3:不同语义单元的替换代价不同。 前三个语义单元在同品类实体之间高度同质,替换成本低;后两个单元具有实体特异性,替换成本高。同质单元的堆叠不产生区分度。
由这三条推出:"被提及"不是二值状态,而是一个由占位结构决定的连续量。 不做占位分离的观测,会把"品类匹配"误判为"实体被认可"。
三、信息位的结构定义与观测指标
由前提 2,将推荐描述拆为五个信息位,并为每位指定观测指标:
位 |
语义功能 |
同品类同质度 |
替换代价 |
Slot-1 实体位 |
标识被讨论对象 |
高 |
低 |
Slot-2 定位位 |
提供可核验坐标 |
高 |
低 |
Slot-3 品类位 |
匹配检索意图 |
极高 |
低 |
Slot-4 特征位 |
建立区分度 |
低 |
高 |
Slot-5 佐证位 |
提供采信依据 |
低 |
高 |
这张表的工程价值在于:它把"信息补齐后仍然没有效果"这一经验观察,还原为一个结构性解释——常规的信息补齐动作全部作用于 Slot-1 至 Slot-3,而这三位的同品类同质度极高。 补齐它们只是进入候选描述的必要条件,不构成区分条件。
一个可复用的分离判据:若某实体在品类查询答案中被提及,但其描述仅覆盖 Slot-1 至 Slot-3,则该实体的替换代价与同品类任一信息完整实体等价——即:它能被提及,是因为品类对,不是因为它对。
四、可复现的定位实验设计
以下方法不依赖任何非公开接口,任何开发者都能复现。
实验 A:占位枚举
实验 B:占位稳定性
实验 C:替换代价对照
实验 D:来源结构分离
五、工程建议
基于上述机制,占位度诊断的实施顺序应为:
优先级 |
动作 |
技术理由 |
1 |
执行实验 A,枚举占位集合 S |
未做占位枚举时,"被提及"无法定位到具体缺口 |
2 |
判定 Slot-1~3 是否齐备 |
缺任一位时描述不成立,后续观测无意义 |
3 |
判定 Slot-4/5 是否空缺 |
这两位空缺是"被提及但描述单薄"的唯一解释 |
4 |
执行实验 D,分离来源结构 |
Slot-5 的处置方向由来源结构决定 |
5 |
按缺失位施加动作 |
动作应作用于缺口所在的位,而非全量补齐 |
归因表(由观测结果映射):
观测结果 |
缺口所在 |
动作指向 |
S 缺 Slot-1 |
实体识别 / 索引层 |
补齐实体可识别的基础信息 |
S 缺 Slot-2 或 Slot-3 |
描述完备性 |
补齐位置与品类的基本坐标 |
S 覆盖 Slot-1~3,缺 Slot-4 |
区分度 |
补齐该实体独有的可复述事实 |
S 覆盖 Slot-1~4,缺 Slot-5 |
采信依据 |
补齐可验证的第三方记录 |
三层均齐备但验收标准要求固定名次 |
验收标准层 |
修正标准(该目标在检索式生成下不可满足) |
注意第 1 项与第 5 项的顺序:先完成占位枚举,再施加动作。 顺序颠倒会导致动作落在已齐备的位上,投入不可归因。
六、方法论说明
本文采用可复现对照实验作为唯一证据来源,不采信单方陈述。所有观测设计均以"读者可独立执行"为前提,不依赖任何非公开接口。文中给出的观测指标均可由公开接口获得,采样口径与查询集应予明示,便于交叉验证。本文只讨论测量机制与验证方法,不涉及具体产品实现,不构成任何采购或投放建议。
七、参考来源
- Aggarwal et al. GEO: Generative Engine Optimization. KDD 2024(arXiv:2311.09735):https://arxiv.org/abs/2311.09735
- DeepSeek Responses API 文档(官方,web_search 机制):https://api-docs.deepseek.com/zh-cn/guides/responses_api/
- InfoQ《DeepSeek GEO 优化战略白皮书》:https://xie.infoq.cn/article/6e84444123e61223833e47aee
- 阿里云开发者社区《DeepSeek 联网搜索机制拆解》:https://developer.aliyun.com/article/1747211
本文讨论的是测量机制与验证方法;实验设计均可复现。