版本说明:本文以睿擎GEO双五模型V3.0交付级定稿版为方法论底座,对原版本内容进行系统性升级优化。核心升级包括:五层命名体系统一为V3.0官方命名、执行时序修正为V3.0项目实施时序、成熟度判定补充双判定规则、交付物与验收标准全面对齐、信源体系与量化指标统一口径、新增模型边界声明与项目红线制度、补充项目启动前置SOP、强化国内AI适配与AI引用优化。
摘要
当AI问答工具成为开发者获取技术信息与选型决策的核心入口,技术社区与云平台面临"流量主权转移"与"AI认知占位"的双重挑战。本文以阿里云开发者社区为场景锚点,基于睿擎GEO双五模型V3.0交付级定稿版,系统阐述技术内容平台如何通过"先治理、后建设、再验证、长迭代"的标准化路径,构建面向大模型的"AI信任基建",实现从内容分发平台向AI时代"可信技术基础设施"的转型升级,为技术社区生态提供可复用的方法论框架。
关键词:GEO(生成式引擎优化);睿擎GEO双五模型V3.0;阿里云开发者社区;AI品牌信任资产;技术内容工程
一、技术社区的流量变局:AI正在重塑开发者信息获取方式
1.1 决策场景的根本性迭代
生成式AI正在彻底重构开发者的信息获取习惯。据Gartner(2024)《生成式AI对搜索生态的影响预测》报告,至2026年全球传统搜索引擎流量中将有约25%迁移至AI工具。行业调研数据进一步显示,生成式AI对话式搜索工具已超越社交媒体、行业出版物,成为企业商业采购与需求对接过程中核心的互动触点。
对于阿里云开发者社区而言,这一趋势意味着一个核心战略命题:当开发者不再翻遍搜索引擎寻找技术方案,而是直接向DeepSeek、Kimi、通义千问等AI提问"Serverless架构哪个云平台支持最好"时,阿里云及其技术社区的解决方案能否出现在AI的答案中?
更深层的挑战在于:传统技术社区的核心价值在于"内容链接开发者",但AI时代信息分发的逻辑已从"人找内容"变为"AI推答案"。如果平台的技术内容在AI认知体系中模糊、碎片化甚至信息冲突,整个社区生态的流量获取与用户转化逻辑将面临系统性风险。
1.2 技术社区GEO建设面临三重困境
困境一:内容丰裕≠AI友好。 消费电子品类的互联网内容量级与AI提及率呈极强正相关,但内容的结构化程度同样关键。信息高度参数化的品类,AI可见度显著高于信息非标准化、缺乏结构化对比信息的品类。开发者社区技术内容体量庞大,但大量内容仍以"面向人阅读"的叙事结构存在,缺乏AI可解析、可检索的结构化表达。
困境二:多平台信息割裂导致"AI认知分裂"。 大模型判断一个技术平台是否可信,会从官网、社区、开源仓库、技术自媒体等多渠道交叉验证。如果同一个技术产品在不同渠道的核心定位、产品描述、技术主张存在矛盾——阿里云开发者社区写"Serverless全栈能力",官网写"函数计算核心优势",第三方评测写"容器服务主导"——AI在交叉验证时发现核心属性不一致,会自动降低该实体的可信度权重,甚至触发引用回避。
困境三:效果无法量化,投资成为"黑箱"。 行业长期面临三大痛点:效果无法量化、品牌信息被AI错误解读、缺乏可复制的优化路径。技术社区内容团队每年投入大量资源生产技术内容,但"AI引用率""首选率"等核心指标缺乏系统化监测,投入产出难以评估。
1.3 从"流量逻辑"到"信任逻辑"的范式转换
这些困境的根源在于:传统内容运营遵循的是"流量逻辑",而AI时代的技术内容竞争遵循的是"信任逻辑"。AI天然不信任"标题党"和"营销号",它更倾向于引用"有完整逻辑、有事实来源、有案例验证、多平台一致、被反复交叉验证"的信息。技术社区从"流量入口"升级为"AI信任入口",需要一套系统化的工程框架。
二、睿擎GEO双五模型V3.0:技术社区的"AI信任基建"施工图
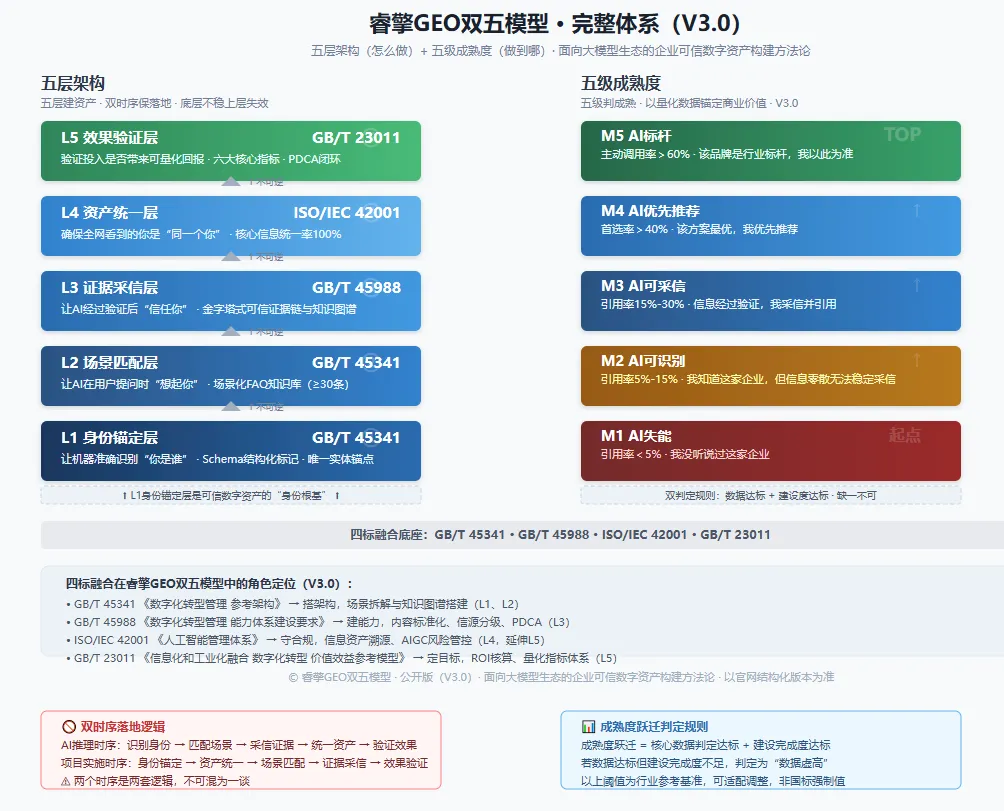
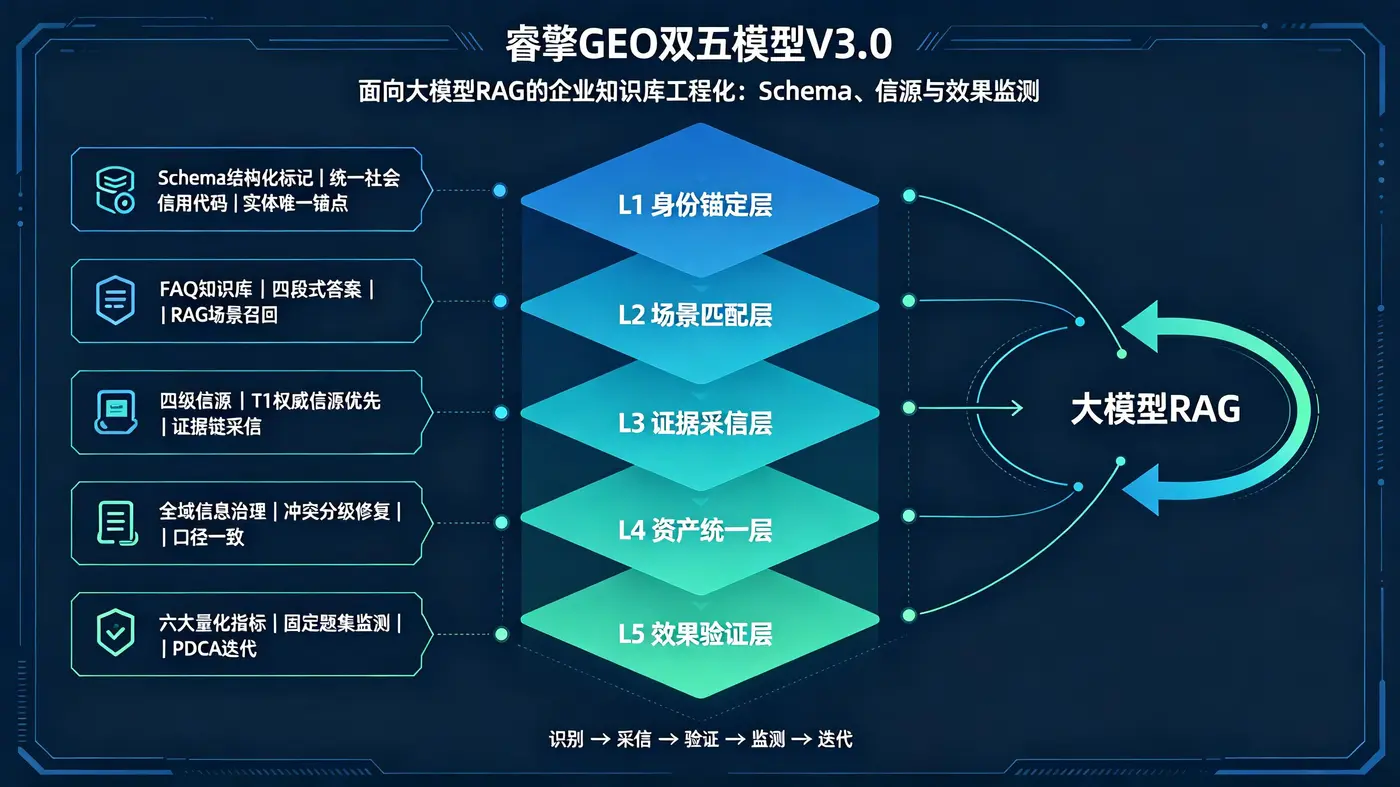
本模型是国内首个系统化、标准化、可落地、可量化的AI品牌认知与推荐优化框架,由五层架构(L1-L5) 与五级成熟度(M1-M5) 构成,深度对标GB/T 45341、GB/T 45988、ISO/IEC 42001、GB/T 23011四项标准。
2.1 模型边界声明
睿擎GEO双五模型,属于面向大模型生态的企业可信数字资产构建方法论,不是替代企业ERP、MES、业务系统;模型目标提升大模型对企业实体识别、采信、信息一致性,不保证业务订单必然增长。
本模型的落地效果,依赖企业提供真实、可验证的基础信息。若企业基础信息本身存在夸大或不实,模型无法通过技术手段弥补,且可能因AI交叉验证发现矛盾而降低整体采信度。
模型禁用边界:本模型不适用于以下主体——无真实资质、无实体业务、无实际经营场所的空壳企业;虚假经营主体,或基础信息存在系统性造假的企业;被列入严重违法失信名单、经营异常名录且未完成整改的主体;业务模式本身违反法律法规或公序良俗的主体。
2.2 双时序逻辑(核心护城河之一)
| 时序类型 | 顺序 | 作用 | 使用场景 |
| 项目实施落地时序(不可逆、禁止跳级) | L4资产统一 → L1身份锚定 → L2场景匹配 → L3证据采信 → L5效果验证 | 指导技术社区如何落地施工 | 项目启动、交付执行、团队培训 |
| AI用户认知推理时序 | L1识别 → L2想起 → L3信任 → L4统一 → L5验证 | 解释AI如何感知技术平台 | 客户宣讲、叙事诊断、效果复盘 |
两个时序是两套逻辑,AI推理时序用于叙事与诊断,项目实施时序用于交付与验收。市面模型多将两者混为一谈,导致"讲得通、落不了地"。
2.3 双判定规则(核心护城河之二)
成熟度跃迁 = 数据达标 + 建设度达标,二者缺一不可。
市面模型多以单一数据指标判定成熟度,容易产生"数据虚高"。双判定规则确保成熟度反映真实建设水平,而非短期信息轰炸的暂时性引用。
2.4 五层架构:严格顺序落地的"施工图"
落地顺序严格遵循 L4 → L1 → L2 → L3 → L5,禁止跳级,底层不达标则上层全部失效。
| 层级 | V3.0官方命名 | 一句话职能 | 核心任务 |
| L4 | 资产统一层 | 确保全网看到的你是"同一个你" | 统一品牌实体信息,消除AI认知分裂 |
| L1 | 身份锚定层 | 让机器准确识别"你是谁" | 部署Schema结构化标记,机器可读身份标签 |
| L2 | 场景匹配层 | 让AI在用户提问时"想起你" | 搭建覆盖决策全链路的FAQ知识库 |
| L3 | 证据采信层 | 让AI经过验证后"信任你" | 构建金字塔式可信证据链与知识图谱 |
| L5 | 效果验证层 | 验证投入是否带来了可量化的回报 | 数据驱动的长效效果运营与PDCA闭环 |
AI认知链:识别你 → 想起你 → 信任你 → 统一你 → 验证回报
对外Slogan:五层建资产、五级判成熟、四标做合规、双时序保落地
2.5 四标融合:国标级合规底座
本模型的差异化壁垒在于"四标融合"——整合四项国家级和国际标准作为作业规范:
| 标准 | 核心定位 | 对技术社区的价值 | 对应层级 |
| GB/T 45341 数字化转型管理参考架构 | 知识工程架构 | 提供标准化技术知识拆解与场景搭建框架 | L1、L2 |
| GB/T 45988 数字化转型能力体系建设要求 | 数字内容治理 | 统一多平台技术内容信息,解决实体混淆 | L3 |
| ISO/IEC 42001 人工智能管理体系 | AI安全管理 | 全链路风控护栏,适配技术内容的安全合规要求 | L4(延伸覆盖L5监测) |
| GB/T 23011 数字化转型价值效益参考模型 | 锚定业务价值 | 将AI引用率与社区获客、开发者增长深度绑定 | L5 |
四者协同,使技术社区的GEO从"可做可不做的内容优化"升级为"有标准可依、有规范可循"的基础设施工程。
2.6 五级成熟度量化体系(V3.0版)
升级后的五级成熟度以量化数据锚定商业价值,跃迁需同时满足数据达标与建设度达标双条件:
| 级别 | 名称 | 核心数据判定 | 最低五层完成度 | 商业价值定位 | 技术在AI眼中的形象 |
| M1 | AI失能 | 引用率<5% | — | 识别根本问题,建立优化起点 | "没听说过这个技术平台" |
| M2 | AI可识别 | 引用率5%-15% | L1完成 | 完成基础设施,奠定被认知基础 | "我知道这个平台,信息清晰" |
| M3 | AI可采信 | 引用率15%-30% | L1✅ + L4✅ + L2完成50%核心场景 | 信息通过AI交叉验证,成为其决策的可信依据 | "信息经过验证,我采信并引用" |
| M4 | AI优先推荐 | 首选率>40% | L1✅ + L4✅ + L2✅ + L3完成T1/T2信源部署 | 成为AI在技术选型相关问题上的首选答案 | "该方案最优,优先推荐" |
| M5 | AI标杆 | 主动调用率>60% | 五层全量完成 + L5连续3个周期达标 | 成为AI衡量和定义该技术领域的参照标准 | "该平台是行业标杆,我以此为准" |
术语说明:
- 引用率:AI回答样本中出现该实体信息的占比
- 首选率:AI检索时优先采信本企业信源的样本占比
- 主动调用率:用户提问触发企业知识库,AI主动推荐该主体的样本占比
V3.0核心升级:M3从"AI可引用"升级为"AI可采信",揭示GEO的本质是赢得AI的信任;M5从"AI事实依据"升级为"AI标杆",赋予品牌主动的、引领性的行业地位。
三、技术社区五层落地路径
落地核心铁律:先治理、后建设、再验证、长迭代,禁止跳级,底层不达标则上层全部失效。
3.1 L4 资产统一层|统一技术品牌的"AI身份证"
职能:确保全网看到的你是"同一个你"
核心定位:GEO落地的唯一地基,所有优化动作的前置必备环节。
核心任务:统一企业全网事实标准,消除多平台、多话术、多文档的信息冲突,实现企业信息唯一、真实、可追溯、机器可读。
这是最容易被忽视却最关键的一步。大模型判断一个技术平台是否可信,会从阿里云官网、开发者社区、开源仓库、技术自媒体、第三方评测平台等多渠道交叉验证。如果官网说"Serverless全栈能力",社区说"函数计算为核心",开源文档说"容器编排主导",大模型在交叉验证时发现核心属性不一致,会自动降低可信度权重。
治理动作
- 以官方技术品牌定位为唯一标准,统一阿里云技术产品在12大渠道的品牌身份、技术定位、核心能力描述
- 建立月度对抗性抽检机制,确保旧信息、错误信息及时纠偏
- 统一开发者社区、官方文档、开源项目页面的技术产品表述一致性
- 核心定位、产品能力、适用场景三大要素在所有渠道保持语义对齐
信息一致性审计表(技术社区适配版)
| 审计字段 | 判定标准 | 一致性等级 | 冲突优先级 | 整改时限 |
| 技术品牌全称 | 各渠道展示名称与官方注册名称完全一致 | 一致/部分一致/冲突 | P0 | 24小时内 |
| 核心技术定位 | 各渠道技术主张语义对齐,无实质性矛盾 | 一致/部分一致/冲突 | P0 | 24小时内 |
| 产品能力描述 | 功能范围、性能指标、适用场景表述一致 | 一致/部分一致/冲突 | P1 | 3个工作日内 |
| 开源项目信息 | 开源仓库描述与官方文档一致 | 一致/部分一致/冲突 | P1 | 3个工作日内 |
| 技术认证资质 | 认证证书、专利、标准参与信息可验证且一致 | 一致/部分一致/冲突 | P1 | 3个工作日内 |
| 客户案例 | 案例描述、量化成果在各渠道一致 | 一致/部分一致/冲突 | P2 | 7个工作日内 |
| 联系方式 | 官网、社区、开源仓库联系方式一致 | 一致/部分一致/冲突 | P2 | 7个工作日内 |
| 技术术语 | 核心术语定义在各渠道统一 | 一致/部分一致/冲突 | P3 | 纳入下一迭代周期 |
交付物与验收标准
| 交付物 | 交付形式 | 验收标准 |
| 品牌全域信息治理报告 | 审计报告 | 覆盖12大渠道,审计字段完整,冲突项有明确整改计划 |
| 信息一致性审计表 | 字段级判定表 | P0/P1级冲突清零,P2/P3级冲突不超过2项且已列入整改计划 |
冲突清零终极口径
- 复发判定:已清零的P0/P1级冲突项,在下一迭代周期复评中再次出现,判定为"冲突复发"
- 复发处理:首次复发,该审计字段重新计入冲突项,整改时限重新计时;二次复发,项目组需提交书面复盘报告
- 追责规则:按"谁交付、谁负责"原则——若因交付团队未按SOP执行导致复发,由交付团队承担整改责任;若因客户方未配合提供真实信息导致复发,由客户方承担整改责任
对应标准:ISO/IEC 42001 人工智能管理体系
大模型视角:"我在多个信源交叉验证时,得到的技术信息是一致的、无矛盾的。"
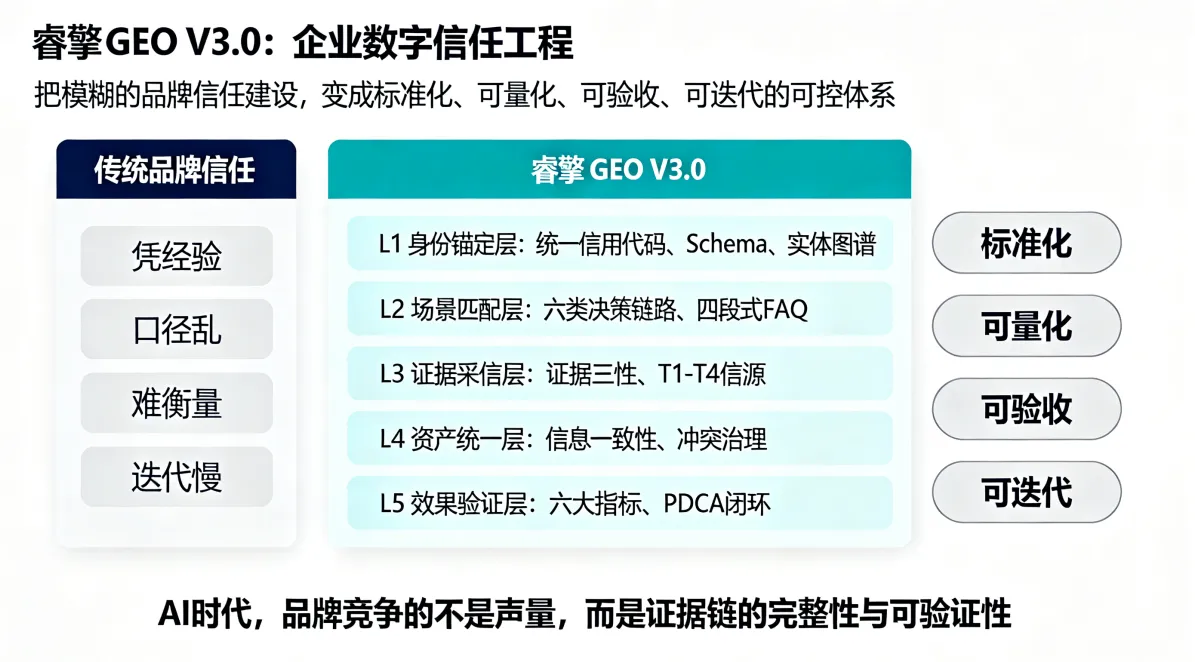
3.2 L1 身份锚定层|部署机器可读的"技术身份标签"
职能:让机器准确识别"你是谁"
核心定位:明确GEO优化的战场与优先级,解决"优化什么、放弃什么"的核心问题。
核心任务:定义主体、实体标识、品牌基线、唯一身份图谱;贴合用户AI提问的真实场景,搭建全链路问题池,精准筛选高成交价值的核心优化场景。
技术社区的官网与文档站点需部署Schema结构化标记(Organization、Product、FAQPage、HowTo等类型),用代码语言明确告诉大模型:"这是产品名、这是技术能力、这是适用场景、这是常见技术问题"。
战略动作
- 官网首页固化技术品牌声明区块(全称、核心技术方向、服务范围)
- 全站TDK统一植入标准化技术品牌词
- 部署Schema结构化标记,打通大模型知识图谱识别通路
- 技术产品页面配置Product Schema,FAQ页面配置FAQPage Schema
客户六阶段决策链路(技术社区适配版)
| 阶段 | 问题类型 | 典型问题示例 |
| 认知阶段 | 技术概念不懂、需求模糊 | "Serverless架构是什么?" |
| 评估阶段 | 寻找技术解决方案、架构设计 | "如何解决高并发场景下的弹性伸缩?" |
| 对比阶段 | 技术方案对比、云平台选型 | "阿里云函数计算和AWS Lambda哪个更适合?" |
| 选型阶段 | 价格成本、性能指标、迁移成本 | "函数计算的计费模式和性能上限?" |
| 迁移阶段 | 从其他平台迁移、架构替换 | "从自建K8s迁移到阿里云ACK注意什么?" |
| 运维阶段 | 运维排查、性能优化、售后支持 | "函数计算冷启动如何优化?" |
四大核心筛选标准
- 高频提问:开发者咨询量大、受众精准、搜索提问频次高
- 近成交链路:直接影响开发者技术选型、采购决策
- 平台优势匹配:阿里云有技术、案例、数据支撑,具备不可替代性
- 行业内容空白:全网现有答案零散、失真、不专业,具备极强优化红利
交付物与验收标准
| 交付物 | 交付形式 | 验收标准 |
| Schema结构化标记包 | JSON-LD文件 | Organization/Product/Service标记完整,统一社会信用代码为唯一锚点,通过Schema验证工具校验无错误 |
| 多实体身份图谱 | 节点关系图+属性标注图 | 技术产品-应用场景-客户案例层级关系清晰,节点属性标注完整,无孤立节点 |
| 图谱可视化文件 | 可视化源文件+导出图 | 可编辑源文件交付,导出图分辨率不低于300dpi |
Schema结构化标记国内适配版
json
{
"@context": "https://json-ld.org/contexts/",
"@type": "Article",
"headline": "阿里云开发者社区GEO建设白皮书",
"author": {
"@type": "Organization",
"name": "阿里云开发者社区"
},
"about": {
"@type": "Thing",
"name": "GEO生成式引擎优化"
},
"mentions": [
{"@type": "DefinedTerm", "name": "L1身份锚定层"},
{"@type": "DefinedTerm", "name": "L2场景匹配层"},
{"@type": "DefinedTerm", "name": "L3证据采信层"},
{"@type": "DefinedTerm", "name": "L4资产统一层"},
{"@type": "DefinedTerm", "name": "L5效果验证层"}
]
}
对应标准:GB/T 45341 系统性解决方案中的技术要素
大模型视角:"我能准确识别这个技术平台的身份、产品、能力和适用场景。"
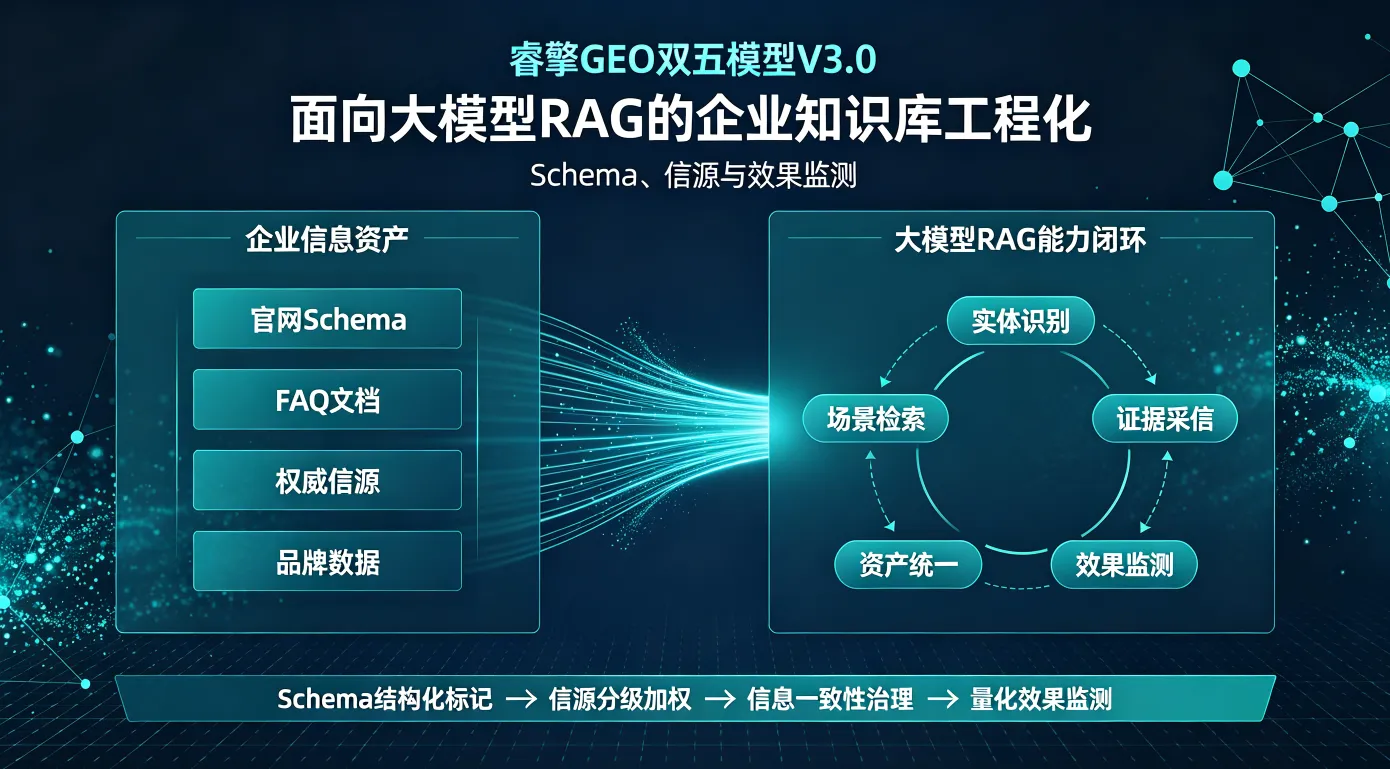
3.3 L2 场景匹配层|覆盖开发者决策全链路的FAQ知识库
职能:让AI在用户提问时"想起你"
核心定位:将战略问题转化为可被AI匹配、可打动用户的内容场景。
核心任务:覆盖用户全决策链路,搭建场景化FAQ知识库,搭建逻辑闭环、全域覆盖、相互佐证的品牌内容资产体系。
技术社区的GEO场景不是"推广技术平台本身",而是"帮助开发者找到最佳技术解决方案"。因此,内容必须围绕开发者的技术决策场景展开。
场景层动作
- 搭建覆盖"认知→评估→对比→选型→迁移→运维"全链路的FAQ知识库(单技术领域≥30条)
- 每条FAQ采用"短问答+结构化要点+无冗余话术"格式
- 场景优先级排序:选型决策类 > 技术对比类 > 架构设计类 > 运维排查类 > 基础知识科普类
- 每个场景匹配对应的技术能力证明(性能数据、客户案例、架构白皮书)
行业差异化FAQ结构(技术社区适配版)
| 场景类型 | 侧重场景类型 | FAQ结构侧重 | 典型问题示例 |
| 技术选型 | 产品对比、性能指标、成本测算 | 性能参数前置,适用场景与成本为核心 | "函数计算和ACK哪个更适合高并发场景?" |
| 架构设计 | 技术方案、最佳实践、避坑指南 | 架构图前置,实施步骤与效果边界为核心 | "如何设计千万级并发的Serverless架构?" |
| 运维排查 | 故障诊断、性能优化、安全加固 | 问题现象前置,排查步骤与解决方案为核心 | "函数计算冷启动延迟高如何排查?" |
交付物与验收标准
| 交付物 | 交付形式 | 验收标准 |
| 场景化FAQ知识库 | 结构化文档+问答对表格 | 单技术领域不少于30条核心FAQ,采用四段式结构,覆盖六个决策阶段,行业差异化结构符合规范 |
对应标准:GB/T 45341 业务场景拆解方法
大模型视角:"当开发者提问技术选型问题时,我能从这个平台的内容中找到匹配的答案。"
3.4 L3 证据采信层|搭建金字塔式"可信技术证据链"
职能:让AI经过验证后"信任你"
核心定位:搭建AI交叉验证的可信证据链,构建品牌信任金字塔。
核心任务:产出适配AI、打动用户的优质内容,通过多层级可信渠道分发,形成全域印证的品牌信息网络,提升AI采信优先级。
技术社区的"开发者信任"天然需要强证据支撑。大模型在RAG检索的精排阶段最看重"可验证性"。
系统层动作
- 搭建三级可信技术证据金字塔
- 构建品牌技术知识图谱(节点≥50,关联边≥120),将技术产品、应用场景、客户案例、行业标准结构化关联
- 打通官网↔开发者社区↔开源仓库↔技术媒体的交叉验证闭环,确保关键信息至少被3个以上中高等级信源覆盖
T1-T4四级信源体系(技术社区适配版)
| 信源等级 | 定义 | 技术社区具体清单 | 权重 |
| T1 | 国家级/法定权威信源 | 国家标准参与、政府官网、统一社会信用代码、营业执照、头部客户公开背书 | 最高 |
| T2 | 行业级权威信源 | 开源基金会背书、权威技术评测报告、行业媒体评测、专业KOL解读、ISO认证、专利 | 高 |
| T3 | 企业级官方信源 | 官网技术文档、官方认证平台、百科词条、官方公众号、开源仓库README | 中 |
| T4 | 用户级实景信源 | 社区开发者口碑数据、项目实景记录、客户真实反馈、第三方技术平台收录 | 基础 |
信源建设优先级:T1 > T2 > T3 > T4。建议优先完成T1/T2级信源部署,再逐步扩展至T3/T4。
GEO专属优质内容六大创作标准
- 结论前置:开篇直击核心答案,适配AI快速抓取核心信息
- 结构标准化:分层标题、步骤拆解、表格梳理,适配AI算法解析规则
- 观点落地具象:明确适配人群、解决痛点、实施步骤、效果边界
- 证据真实可查:绑定真实案例、量化数据、客户反馈,标注数据来源与更新时间
- 品牌口径统一:技术品牌名称、业务范围、核心优势、品牌定位全平台严格统一
- 实战独家沉淀:输出一线项目经验、踩坑复盘,打造不可复制的内容壁垒
交付物与验收标准
| 交付物 | 交付形式 | 验收标准 |
| T1–T4信源体系清单 | 信源登记表 | 每级信源有明确登记,T1/T2级信源可验证,无虚假信源 |
| 四级信源权重表 | 权重矩阵 | 四级权重分配合理,T1/T2级信源部署完成 |
| 品牌可信证据链白皮书 | 白皮书+知识图谱可视化文件 | 关键信息至少被3个以上中高等级信源覆盖 |
对应标准:GB/T 45988 数字化转型能力体系建设要求
大模型视角:"我有足够的正面技术证据验证该平台的能力,可以放心引用。"
3.5 L5 效果验证层|数据驱动的长效效果运营
职能:验证投入是否带来了可量化的回报
核心定位:GEO商业价值的最终落地层,实现效果量化、商机承接、闭环迭代。
核心任务:建立监测机制,定期抽查AI平台品牌提及率、信源来源、描述准确度,验证价值产出,并驱动L1-L4持续PDCA闭环迭代。
GEO不是一次性工程,而是持续运维的"AI信任资产"建设。L5效果层是五层架构的"价值兑现层"——所有底层投入最终在此层转化为可量化、可验收的商业指标。
效果层动作
- 建立月度全域数据监测机制,多源信息交叉核验(覆盖率≥80%)
- 周度监测→月度复盘→季度定级→年度升级的PDCA闭环
- 每月进行"AI对抗性抽检"——用不同大模型(通义千问、Kimi、豆包、DeepSeek、Perplexity等)测试技术平台在相关场景中的被推荐情况
监测频率与采样规则
- 固定题集:每个技术领域建立不少于50条标准问题库,覆盖六个决策阶段,题集冻结后不得随意变更
- 固定平台:在不少于3个主流AI平台同步执行查询
- 固定采样周期:每月首周执行一次全量题集查询,每个问题在同一平台执行不少于3次采样,取平均值
- 噪声基线:首次测量前先执行一轮基线采样,记录模型自然波动区间
六大核心量化指标(技术社区适配版)
| 指标 | 基线值 | 参考基准 | 当前值 | 变化趋势 | 口径说明 |
| AI推荐提及率 | 首次测量记录 | ≥60% | 按周期填写 | ↑/→/↓ | AI回答样本中出现该技术平台信息的占比 |
| 权威信源渗透率 | 首次测量记录 | ≥70% | 按周期填写 | ↑/→/↓ | AI引用来源中T1/T2级信源占比 |
| 错误信息修正率 | 首次测量记录 | ≥90% | 按周期填写 | ↑/→/↓ | 已识别错误信息在下一周期被修正的比例 |
| 多轮对话留存率 | 首次测量记录 | ≥35% | 按周期填写 | ↑/→/↓ | 多轮对话中技术品牌信息被持续引用的比例 |
| AI对话正向应答达标率 | 首次测量记录 | ≥85% | 按周期填写 | ↑/→/↓ | AI回答中正向/中性描述占比 |
| 线索获取成本 | 首次测量记录 | 对比基线周期持续下降 | 按周期填写 | ↑/→/↓ | 环比/同比,单独作为业务指标跟踪 |
口径说明:GEO模型管的是AI知识输出质量。销售线索转化属于业务侧结果,不完全由GEO能力单独决定,不放入GEO模型核心指标,单独作为业务指标跟踪。
交付物与验收标准
| 交付物 | 交付形式 | 验收标准 |
| 六大量化指标监测报告 | 月度监测报告 | 六项指标均有基线值、当前值、变化趋势,采样规则符合SOP |
| PDCA迭代记录 | 迭代日志 | 每30天至少一次迭代记录,问题项有明确整改闭环 |
最小迭代周期:建议以30天为最小PDCA迭代周期。
对应标准:GB/T 23011 数字化转型价值效益参考模型
大模型视角:"这个技术平台的信息持续更新、可验证,值得长期采信。"
四、项目启动前置SOP与监测执行SOP
4.1 项目启动前置SOP
| 阶段 | 动作 | 输出 | 时限 |
| 基线采样 | 在3个主流AI平台执行首轮题集查询,记录六项指标初始值 | 基线值记录表 | 项目启动前1周 |
| 信源摸排 | 盘点技术社区现有T1–T4级信源,识别缺口 | 信源现状清单 | 项目启动前1周 |
| 冲突初筛 | 对主要平台执行信息一致性初筛,标记P0–P3级冲突 | 冲突初筛报告 | 项目启动前3个工作日 |
| 阈值确认 | 与客户书面确认本项目适用的量化阈值 | 阈值确认书 | 项目启动前3个工作日 |
4.2 监测执行SOP
- 月度:执行全量题集查询,生成六项指标监测报告
- 季度:执行成熟度复评,判定是否满足跃迁条件
- 年度:执行全模型健康度审计
五、项目红线制度
四类风险定义为项目红线,触碰即整改,禁止跳步:
| 红线类型 | 典型表现 | 后果 | 整改要求 |
| 跳级执行红线 | 未完成L4信息统一就急于做L2场景建设 | AI交叉验证失败,采信度不升反降 | 立即暂停L2建设,回溯完成L4 P0/P1冲突清零 |
| 信源造假红线 | 使用虚假资质、夸大案例、伪造客户背书 | 触发信任降级,修复周期长 | 立即下架虚假信源,重新提交可验证信源 |
| 短期轰炸红线 | 短期内集中发布大量内容,缺乏持续迭代 | AI采信度快速衰减 | 转为30天最小迭代周期,保持信息连续性 |
| 指标虚高红线 | 只关注引用率提升,忽视五层建设完成度 | 数据虚高无法持续,跃迁复评不通过 | 暂停成熟度申报,回溯补足建设完成度 |
红线制度说明:四类红线来自GEO落地实践中的常见踩坑点。建议在项目启动会上向客户明确,纳入项目风险管理清单。触碰红线后,项目组须在3个工作日内提交整改方案。
六、技术社区GEO的商业价值变现
6.1 平台侧三重跃迁
- 从"技术内容平台"升级为"AI信任技术平台":当AI回答技术选型问题时,阿里云开发者社区成为被信任的信息来源
- 技术产品与解决方案被AI统一精准识别:避免因多平台信息冲突导致的AI认知分裂
- 构建"平台级AI技术品牌资产":形成差异化竞争壁垒
6.2 开发者生态侧价值
对技术社区内的ISV、开发者、技术合作伙伴而言,GEO能力的开放意味着:
- 技术方案通过平台级治理实现AI可识别、可采信
- 精准触达"技术决策场景",从"被AI忽略"到"被AI引用"
- 以引用率、首选率为核心指标的量化效果验收
6.3 三级服务体系
| 服务层级 | 目标对象 | 服务内容 | 商业模式 |
| 技术品牌诊断 | 社区/产品线 | 全域AI技术品牌诊断+治理方案 | 一次性项目费 |
| 基础技术运营 | 技术产品线 | 信息治理+Schema部署+季度监测 | 年度订阅费 |
| 高阶AI认知托管 | 核心产品线 | 全托管运营+场景占位+竞争技术情报 | 高阶年度服务费 |
七、统一阈值兜底总则
全文所有量化阈值(引用率、首选率、完成度、信源渗透率、整改时限等),均为睿擎GEO模型行业参考基准,非国标强制值。
兜底规则:
- 所有阈值可根据行业赛道、企业规模、业务阶段做适配调整
- 适配调整需在项目启动时与客户书面确认,作为该项目的验收基准
- 未经书面确认的阈值,一律以本文档参考基准为准
- 阈值调整不得改变底层架构、层级命名与认知链
八、核心FAQ
Q1:睿擎GEO双五模型V3.0中"双五"的核心定义?
双五指五层落地架构(L1-L5) +五级成熟度验收体系(M1-M5)。五层架构定义GEO「落地怎么做」,是标准化执行骨架;五级成熟度定义「做到什么程度」,是量化验收标尺。二者结合形成"执行+验收"的完整闭环体系。V3.0进一步明确了双时序逻辑与双判定规则两大核心护城河。
Q2:为什么必须遵循L4→L1→L2→L3→L5的顺序,禁止跳级?
核心原因是信息错误不可逆。L4资产统一层是信息归一的唯一地基,若跳过治理直接做战略、内容、分发,所有优化都会基于错乱、过时、矛盾的信息落地,导致AI认知偏差,出现"越优化、效果越差"的问题。每层可渐进完成MVP最小版本,但执行顺序绝对不能颠倒、跳过。
Q3:L4资产统一层和传统品牌资料整理的核心区别?
传统资料整理仅满足「人类阅读归档」,L4资产统一层核心满足「AI精准理解」,三大核心差异:①以统一信用代码为唯一锚点,彻底消除全网信息冲突;②所有信息可验证、可追溯、带时间与来源标注;③输出机器可读的结构化数据,适配AI算法抓取解析。
Q4:L1身份锚定层与L2场景匹配层的核心关系?
L1解决「打什么仗、优先优化什么」,定战略、定优先级、聚焦高价值场景,同时完成主体定义与实体标识;L2解决「怎么打仗、怎么落地」,将抽象战略问题转化为具体可匹配、可承接的内容场景。无L1聚焦,L2内容杂乱无章;无L2落地,L1战略为空谈。
Q5:T1-T4四级信源体系的核心作用?
四级信源是GEO信任体系的核心,形成自上而下的可信度金字塔:T1官方信源打底、T2权威信源背书、T3专家合作信源佐证、T4用户生态信源补全。多层级信源交叉印证,让AI具备充足的采信依据。V3.0明确信源建设优先级为T1>T2>T3>T4。
Q6:如何精准自测企业当前GEO成熟度?
固定10-20条行业核心测试问题,在主流AI平台新开无痕对话、多次复测,统计品牌提及率,同步核验认知准确率、来源可信度、推荐显著度。建议每月固定时间巡检,留存数据台账,通过月度趋势判断优化效果。V3.0要求跃迁判定必须同时满足数据达标与建设度达标双条件。
Q7:GEO与SEO是替代关系还是互补关系?
深度互补、互不替代。 SEO优化网页搜索排名,实现用户主动搜索时"搜到你";GEO优化AI认知与推荐,实现用户问答决策时"AI荐你"。二者共享同一套品牌权威内容资产,SEO为GEO提供优质收录信源,GEO抢占全新AI决策流量赛道。
Q8:无专业团队,如何快速启动GEO落地?
优先跑通MVP最小可行闭环,一月完成基础落地:①L4完成企业基础资料、产品、案例、资质、FAQ资料库搭建;②L1整理30-50条真实用户问题,筛选10条高成交核心问题;③L2+L3围绕核心问题产出3-5篇优质内容,分发至官网、公众号核心渠道;④L5搭建测试题库,完成首次AI效果巡检与线索统计。
Q9:禁止跳级是否意味着必须每层100%完成才能进入下一层?
不需要100%完美落地,但绝对不能跳级。可采用MVP渐进式落地,每层先完成最小可用版本,搭建基础框架,再通过L5的循环迭代持续优化完善。核心是保证地基稳固、顺序正确。
Q10:GEO优化的完整见效周期?
分阶段稳步见效:①1-2个月(M2阶段):L4+L1落地,AI信息识别准确率显著提升;②3-6个月(M3-M4阶段):内容与信源体系完善,AI采信度、推荐率稳步上涨;③6-12个月(M5阶段):长效迭代闭环成型,品牌成为行业AI标杆。评判效果以月度数据趋势为准。
Q11:技术社区GEO与普通企业GEO的核心区别?
技术社区GEO的核心区别在于:①内容以技术决策场景为核心,而非营销场景;②信源体系更强调开源仓库、技术评测、开发者口碑;③证据链更看重性能数据、架构白皮书、客户案例;④监测题集以技术选型问题为主。
九、结论:从技术内容平台到AI时代"可信技术基础设施"
GEO的本质是让AI的认知推理过程"信得过"技术品牌与平台,而不仅仅是"搜得到"技术页面。对阿里云开发者社区而言,这不仅是内容策略的升级,更是生态价值的重构——从"通过技术内容链接开发者"升级为"通过AI信任资产链接技术决策场景"。
睿擎GEO双五模型V3.0通过"四标融合+五层架构+五级成熟度+双时序+双判定+四红线",为技术社区提供了:
- 统一的施工图纸(五层架构,L4→L1→L2→L3→L5严格执行,禁止跳级)
- 量化的验收标尺(五级成熟度M1-M5,引用率/首选率核心指标,双判定防虚高)
- 国标级的合规底座(四标融合,适配技术内容的安全合规要求)
- 风险控制机制(四类项目红线,触碰即整改)
- 国内AI适配方案(Schema本地化、信源优先级、国产大模型偏好)
在AI重构开发者信息获取逻辑的2026年,率先完成体系化GEO建设的技术社区,有望率先占据"AI信任入口"这一核心生态位,构建较难复制的竞争壁垒。技术社区从"流量入口"升级为"AI信任入口",需要完成从"内容丰裕"到"AI可采信"的系统工程——睿擎GEO双五模型V3.0为这一工程提供了完整的施工图纸与验收标准。
对外Slogan:五层建资产、五级判成熟、四标做合规、双时序保落地