
前面讲了 Flink CheckPoint 的优化和参数详解,CheckPoint 的本质是状态的持久化,而状态存在内存中——内存才是 Flink 生产环境中最常见、最头疼的问题来源。Heap OOM、Direct Memory OOM、GC 频繁、Full GC 停顿长、Container 被 kill、状态持续增长不收敛,这些问题几乎每个 Flink 用户都遇到过,而且很多时候不是简单调大内存就能解决的。
这篇把 Flink 的内存优化和参数配置讲透:从 TaskManager 的内存模型(堆内存/堆外内存/Managed Memory/Network Memory/JVM Overhead)讲起,到每个内存区域的核心参数和调优方向,再到四大内存优化机制(堆内存/Managed Memory/Network Memory/JVM Overhead)和 GC 调优,最后诊断六大常见内存问题,给出生产环境配置模板、监控指标和上线 Checklist。
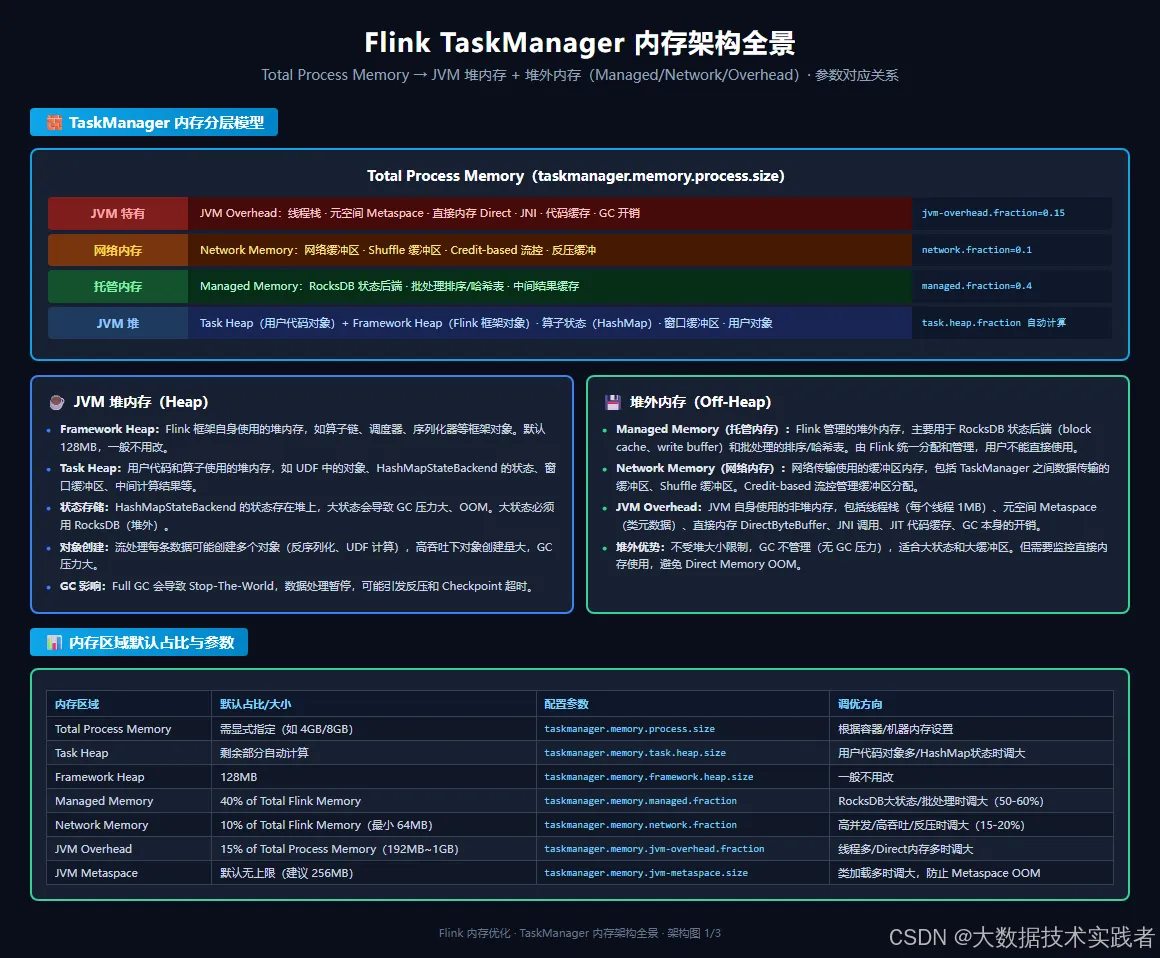
下面这张图是 Flink TaskManager 的内存架构全景,包含内存分层模型、各区域默认占比、参数对应关系。
一、Flink 内存架构
1.1 为什么内存优化这么重要
Flink 是有状态的流处理引擎,状态是 Flink 的核心——聚合结果、窗口数据、Join 状态、CEP 匹配状态,这些都存在内存中。内存不够用会导致 OOM 作业失败,内存配置不合理会导致 GC 频繁吞吐下降,内存泄漏会导致状态持续增长最终崩溃。
生产环境中内存相关的问题占 Flink 故障的 50% 以上,而且很多问题不是简单调大内存就能解决的——需要理解 Flink 的内存模型,知道每个区域的作用,才能针对性地调优。
1.2 TaskManager 内存分层模型
Flink TaskManager 的总内存(Total Process Memory)分为两大类:JVM 堆内存和堆外内存。
JVM 堆内存(Heap):
- Framework Heap:Flink 框架自身使用的堆内存,如算子链、调度器、序列化器等框架对象。默认 128MB,一般不用改。
- Task Heap:用户代码和算子使用的堆内存,如 UDF 中的对象、HashMapStateBackend 的状态、窗口缓冲区、中间计算结果等。这是用户代码最直接使用的内存区域。
堆外内存(Off-Heap):
- Managed Memory(托管内存):Flink 管理的堆外内存,主要用于 RocksDB 状态后端(block cache、write buffer)和批处理的排序/哈希表。由 Flink 统一分配和管理,用户不能直接使用。默认占 Total Flink Memory 的 40%。
- Network Memory(网络内存):网络传输使用的缓冲区内存,包括 TaskManager 之间数据传输的缓冲区、Shuffle 缓冲区。Credit-based 流控管理缓冲区分配。默认占 10%,最小 64MB。
- JVM Overhead:JVM 自身使用的非堆内存,包括线程栈(每个线程 1MB)、元空间 Metaspace(类元数据)、直接内存 DirectByteBuffer、JNI 调用、JIT 代码缓存、GC 本身的开销。默认占 Total Process Memory 的 15%(192MB~1GB)。
1.3 内存分配的两种方式
Flink 支持两种内存配置方式:
方式一:配置 Total Process Memory(推荐)
taskmanager.memory.process.size: 8g
配置总内存后,Flink 自动按比例分配各个区域(Managed 40%、Network 10%、Overhead 15%,剩余给 Heap)。简单方便,适合大多数场景。
方式二:配置各个区域的具体大小
taskmanager.memory.task.heap.size: 2g
taskmanager.memory.managed.size: 3g
taskmanager.memory.network.size: 1g
精确控制每个区域的大小,适合需要精细调优的场景。但要注意各区域之和不能超过总内存。
生产环境推荐用方式一(配置总内存 + 调整各区域 fraction),简单且不容易出错。
二、核心内存参数详解
2.1 总内存参数
# Total Process Memory(必须显式配置)
taskmanager.memory.process.size: 8g
这是最核心的参数,决定了 TaskManager 进程的总内存。需要根据容器/机器的内存来设置:
- YARN 场景:
taskmanager.memory.process.size≤ YARN 容器内存的 80-90%(留 10-20% 给 YARN NodeManager 的 overhead)。 - K8s 场景:
taskmanager.memory.process.size≤ container resources.limits.memory 的 80-90%(留 10-20% 给容器 overhead 和 JVM Native 内存)。 - 注意:不要把总内存设为等于容器内存,否则容易触发 Container OOM(JVM 实际使用的 Native 内存可能超过 Xmx)。
2.2 堆内存参数
# Framework Heap(默认 128MB,一般不用改)
taskmanager.memory.framework.heap.size: 128m

# Task Heap(不配置时自动计算 = 总内存 - 其他区域)
taskmanager.memory.task.heap.size: 2g
Task Heap 调优方向:
- 用户代码中创建大量对象(如大集合、复杂对象)时调大。
- 用 HashMapStateBackend(状态在堆上)时必须调大,但大状态建议用 RocksDB 而不是调大堆。
- 堆内存不是越大越好——堆越大 GC 停顿越长,大堆(>8GB)时 Full GC 可能达到秒级。
- 流处理场景建议堆内存 2-4GB 即可,大状态交给 RocksDB(堆外)。
2.3 Managed Memory 参数
# Managed Memory 占比(默认 0.4,即 40%)
taskmanager.memory.managed.fraction: 0.5

# 或直接配置大小
taskmanager.memory.managed.size: 4g
Managed Memory 调优方向:
- RocksDB 状态后端:大状态作业必须调大(0.5-0.6),增大 block cache 提高读命中率。RocksDB 的 block cache 和 write buffer 都从 managed memory 中分配。
- 批处理作业:排序(Sort)和哈希表(Hash Join)使用 managed memory,内存不足时会溢写磁盘(spill),影响性能。大表 Join 调大 managed memory 减少溢写。
- 流处理 + HashMap 状态后端:不需要 managed memory(状态在堆上),可以调小(0.1-0.2),把更多内存给堆。
- 注意:managed memory 是"预算",RocksDB 实际使用的内存可能超过预算(JNI 内存不受 JVM 控制),大状态作业要留足余量。
2.4 Network Memory 参数
# Network Memory 占比(默认 0.1,即 10%,最小 64MB)
taskmanager.memory.network.fraction: 0.15

# 或直接配置大小
taskmanager.memory.network.size: 1g

# 最大网络缓冲区数(默认 2048)
taskmanager.memory.network.max-buffers: 4096

# 缓冲区大小(默认 32KB)
taskmanager.memory.segment-size: 32kb
Network Memory 调优方向:
- 高吞吐、高并行度作业:调大 network fraction(0.15-0.2),否则缓冲区不足导致反压或 InsufficientResourcesException。
- max-buffers:并行度大时(如 >100)默认 2048 可能不够,需要调大(4096 或更大)。计算公式:每个输入通道需要 2 个缓冲区(Exclusive + Floating),并行度越大需要的缓冲区越多。
- segment-size:默认 32KB,大吞吐可调大(64KB)减少缓冲区数量,但增加延迟。低延迟保持 32KB。
- Credit-based 流控:Flink 1.5+ 默认开启,不需要手动配置。接收方向上游发送 Credit(可用缓冲区数量),上游只发送 Credit 数量的数据,避免缓冲区溢出。
2.5 JVM Overhead 参数
# JVM Overhead 占比(默认 0.15,即 15%,范围 192MB~1GB)
taskmanager.memory.jvm-overhead.fraction: 0.2

# 或直接配置大小
taskmanager.memory.jvm-overhead.size: 1g

# Metaspace 大小(默认无上限,建议显式设置)
taskmanager.memory.jvm-metaspace.size: 256m
JVM Overhead 调优方向:
- 高并行度、多线程场景:调大 jvm-overhead fraction(0.2),因为线程栈占用大(每个线程 1MB,100 个线程就是 100MB)。
- Direct Memory 使用多的场景:用户代码中大量使用 DirectByteBuffer,或网络内存大时,调大 Overhead。
- Metaspace:必须显式设置(256m 或 512m),默认无上限可能导致 Native OOM。大量动态类加载(Groovy、CGLIB)时调大。
- JVM Overhead 是最容易被忽略但最容易出问题的区域——很多 Container OOM 的根因是 Overhead 配置不足,实际使用超过配置导致 Native 内存超限。
三、内存优化机制
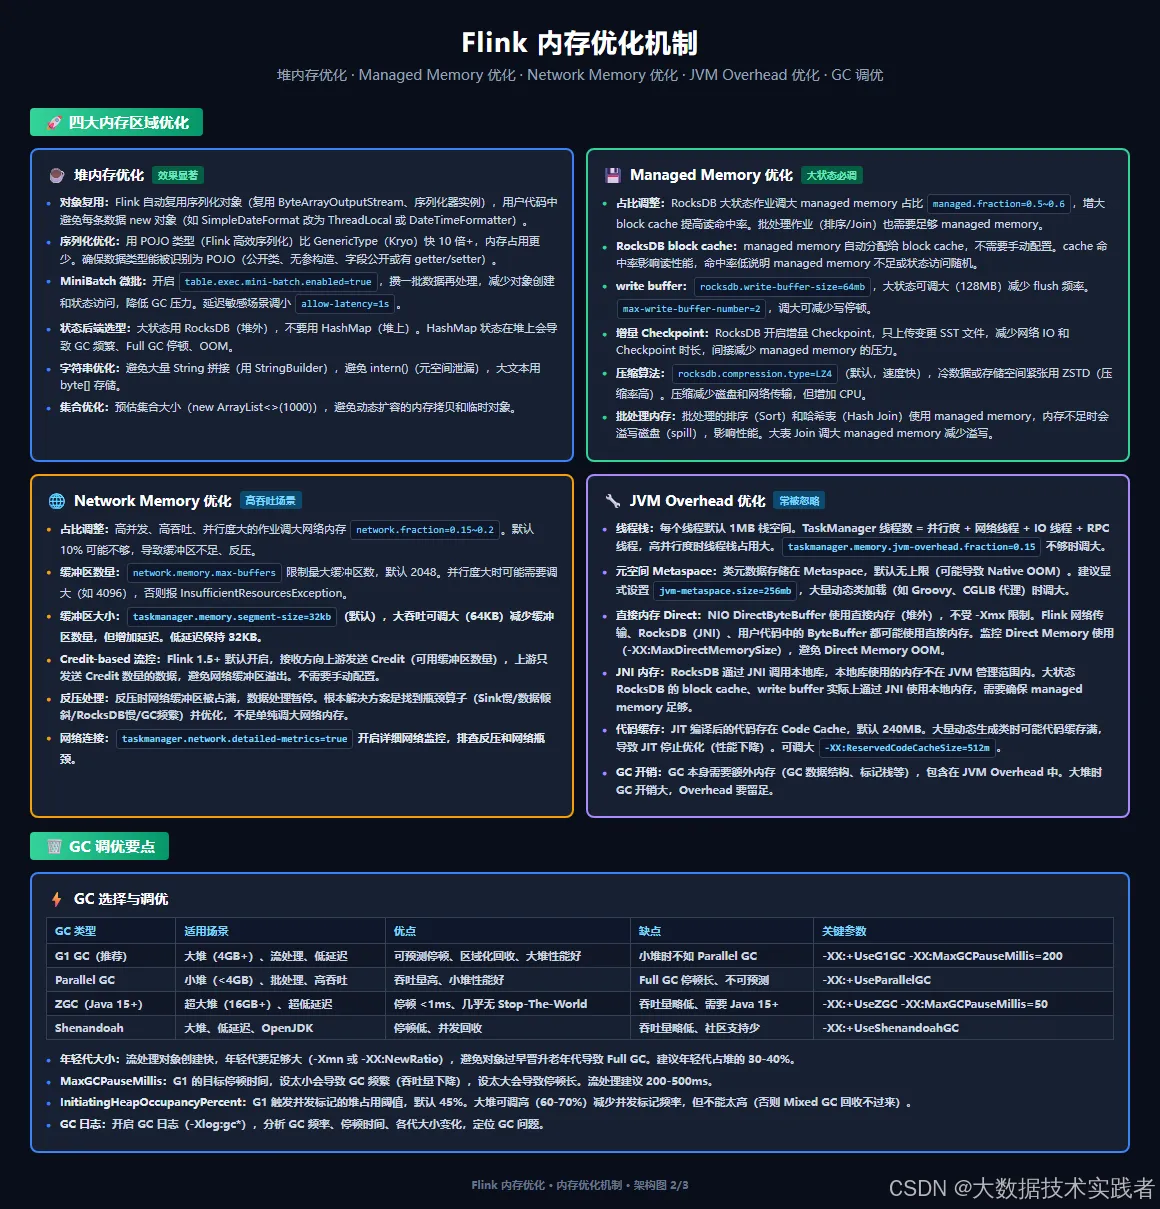
下面这张图是 Flink 的内存优化机制,包含四大内存区域优化、GC 选择与调优、关键调优参数。
3.1 堆内存优化
对象复用:
- Flink 自动复用序列化对象(复用 ByteArrayOutputStream、序列化器实例),用户代码中也要避免每条数据 new 对象。
- 反面教材:
SimpleDateFormat每次都 new(线程不安全 + 频繁创建对象),应该用ThreadLocal<SimpleDateFormat>或 Java 8+ 的DateTimeFormatter(线程安全)。 - 大字符串拼接用
StringBuilder,避免+拼接产生大量临时 String 对象。 - 集合初始化时预估大小(
new ArrayList<>(1000)),避免动态扩容的内存拷贝和临时对象。
序列化优化:
- 用 POJO 类型(Flink 高效序列化)比 GenericType(Kryo)快 10 倍+,内存占用更少。
- POJO 条件:公开类、无参构造函数、字段公开或有 getter/setter 方法。
- 显式声明 TypeInformation 避免 Kryo 回退(Kryo 序列化慢、内存大、不支持 POJO 的字段级优化)。
- 避免大量
String字段,能用枚举/数字编码的尽量用枚举/数字(序列化后体积小)。
MiniBatch 微批:
table.exec.mini-batch.enabled: true
table.exec.mini-batch.allow-latency: 1s
table.exec.mini-batch.size: 5000
- 攒一批数据再处理,减少对象创建和状态访问,降低 GC 压力。
- 延迟敏感场景调小
allow-latency(如 1 秒),吞吐优先场景调大(5 秒)。 - MiniBatch 对聚合类作业效果尤其明显(减少状态读写次数)。
状态后端选型:
- 大状态(>10GB)必须用 RocksDB(堆外),不要用 HashMap(堆上)。
- HashMap 状态在堆上会导致:GC 频繁(状态对象在老年代)、Full GC 停顿长、OOM 风险高。
- RocksDB 状态在堆外(本地磁盘 + managed memory 缓存),GC 不管理,无 GC 压力,支持 TB 级状态。
3.2 Managed Memory 优化
占比调整:
- RocksDB 大状态作业调大
managed.fraction=0.5~0.6,增大 block cache 提高读命中率。 - 批处理作业(排序/Join)也需要足够 managed memory,内存不足时溢写磁盘影响性能。
- 流处理 + HashMap 状态后端时不需要 managed memory,可以调小(0.1-0.2)把更多内存给堆。
RocksDB 内存管理:
- RocksDB 的 block cache(读缓存)和 write buffer(写缓存)都从 managed memory 中分配,Flink 自动管理,不需要手动配置。
- block cache 命中率影响读性能,命中率低说明 managed memory 不足或状态访问随机(如大状态随机 key 访问)。
- write buffer 满了之后 flush 成 SST 文件,
write-buffer-size=64mb(默认),大状态可调大(128MB)减少 flush 频率。 max-write-buffer-number=2(默认),调大可减少写停顿(flush 时写阻塞)。
增量 Checkpoint:
- RocksDB 开启增量 Checkpoint(默认开启),只上传变更 SST 文件,减少网络 IO 和 Checkpoint 时长。
- 增量 Checkpoint 间接减少 managed memory 的压力(Checkpoint 时不需要全量序列化状态)。
压缩算法:
rocksdb.compression.type=LZ4(默认):压缩速度快,压缩率中等,适合热数据。ZSTD:压缩率高,压缩速度中等,适合冷数据或存储空间紧张的场景。- 压缩减少磁盘和网络传输,但增加 CPU。CPU 紧张时用 LZ4,存储紧张时用 ZSTD。
3.3 Network Memory 优化
占比调整:
- 高并发、高吞吐、并行度大的作业调大
network.fraction=0.15~0.2。 - 默认 10% 可能不够,导致缓冲区不足、反压、InsufficientResourcesException。
缓冲区数量:
network.memory.max-buffers限制最大缓冲区数,默认 2048。- 并行度大时(>100)需要调大(4096 或更大),否则报 InsufficientResourcesException。
- 计算公式:每个输入通道需要 2 个缓冲区(Exclusive + Floating),总通道数 = 上游并行度 × 下游并行度(全连接时),需要的缓冲区数约为总通道数 × 2。
缓冲区大小:
segment-size=32kb(默认),大吞吐可调大(64KB)减少缓冲区数量,但增加延迟。- 低延迟场景保持 32KB,高吞吐场景可调大到 64KB。
反压处理:
- 反压时网络缓冲区被占满,数据处理暂停。根本解决方案是找到瓶颈算子并优化,不是单纯调大网络内存。
- 反压排查:从 Sink 往 Source 方向找第一个反压的算子(瓶颈),常见原因:Sink 写入慢、数据倾斜、RocksDB 读写慢、GC 频繁。
- 开启详细网络监控:
taskmanager.network.detailed-metrics=true,排查反压和网络瓶颈。
3.4 JVM Overhead 优化
线程栈:
- 每个线程默认 1MB 栈空间(
-Xss),TaskManager 线程数 = 并行度 + 网络线程 + IO 线程 + RPC 线程 + GC 线程。 - 高并行度(>100)时线程栈占用可能达到几百 MB,需要调大 Overhead。
- 可以通过
-Xss512k减小线程栈大小(但要确保不会 StackOverflowError),一般不建议改。
Metaspace:
- 类元数据存储在 Metaspace(Java 8+,替代永久代),默认无上限(只受 Native 内存限制)。
- 必须显式设置
jvm-metaspace.size=256m(或 512m),防止无上限导致 Native OOM。 - 大量动态类加载(Groovy 脚本、CGLIB 动态代理、Javassist、热部署)时调大 Metaspace。
- 避免大量使用
String.intern()(字符串存在常量池,Metaspace 中)。
直接内存 Direct:
- NIO DirectByteBuffer 使用直接内存(堆外),不受
-Xmx限制。 - Flink 网络传输使用 DirectByteBuffer(Network Memory 区域),RocksDB 通过 JNI 使用本地内存,用户代码中的 ByteBuffer 也可能使用直接内存。
- 监控 Direct Memory 使用(JMX:
java.nio:type=BufferPool,name=direct),或通过-XX:MaxDirectMemorySize限制上限。 - 注意:
-XX:MaxDirectMemorySize默认等于-Xmx,如果堆大但 Direct 内存使用多,可能超限。
JNI 内存:
- RocksDB 通过 JNI 调用本地 C++ 库,本地库使用的内存不在 JVM 管理范围内。
- 大状态 RocksDB 的 block cache、write buffer 实际上通过 JNI 使用本地内存,需要确保 managed memory 足够(managed memory 是"预算",实际 JNI 内存可能超用)。
- 监控 RocksDB 内存使用(RocksDB metrics:
rocksdb.block-cache-usage、rocksdb.estimate-table-readers-mem)。
代码缓存:
- JIT 编译后的代码存在 Code Cache,默认 240MB。
- 大量动态生成类时可能代码缓存满,导致 JIT 停止优化(性能下降,日志提示 "CodeCache is full")。
- 可调大
-XX:ReservedCodeCacheSize=512m。
3.5 GC 调优
GC 选择:
| GC 类型 | 适用场景 | 优点 | 缺点 | 关键参数 |
|---|---|---|---|---|
| G1 GC(推荐) | 大堆(4GB+)、流处理、低延迟 | 可预测停顿、区域化回收、大堆性能好 | 小堆时不如 Parallel GC | -XX:+UseG1GC -XX:MaxGCPauseMillis=200 |
| Parallel GC | 小堆(<4GB)、批处理、高吞吐 | 吞吐量高、小堆性能好 | Full GC 停顿长、不可预测 | -XX:+UseParallelGC |
| ZGC(Java 15+) | 超大堆(16GB+)、超低延迟 | 停顿 <1ms、几乎无 Stop-The-World | 吞吐量略低、需要 Java 15+ | -XX:+UseZGC -XX:MaxGCPauseMillis=50 |
| Shenandoah | 大堆、低延迟、OpenJDK | 停顿低、并发回收 | 吞吐量略低、社区支持少 | -XX:+UseShenandoahGC |
流处理推荐 G1 GC,配置:
env.java.opts.taskmanager: "-XX:+UseG1GC -XX:MaxGCPauseMillis=200 -XX:+PrintGCDetails -Xlog:gc*:file=/path/to/gc.log"
G1 关键调优参数:
- 年轻代大小:流处理对象创建快,年轻代要足够大(占堆的 30-40%),避免对象过早晋升老年代导致 Full GC。用
-XX:NewRatio=2(年轻代:老年代 = 1:2)或-Xmn显式设置。 - MaxGCPauseMillis:目标停顿时间,设太小(如 50ms)会导致 GC 频繁(吞吐量下降),设太大(如 1000ms)会导致停顿长影响延迟。流处理建议 200-500ms。
- InitiatingHeapOccupancyPercent(IHOP):G1 触发并发标记的堆占用阈值,默认 45%。大堆可调高(60-70%)减少并发标记频率,但不能太高(否则 Mixed GC 回收不过来,退化为 Full GC)。
- GC 日志:必须开启 GC 日志(
-Xlog:gc*),分析 GC 频率、停顿时间、各代大小变化,定位 GC 问题。
四、六大常见内存问题诊断
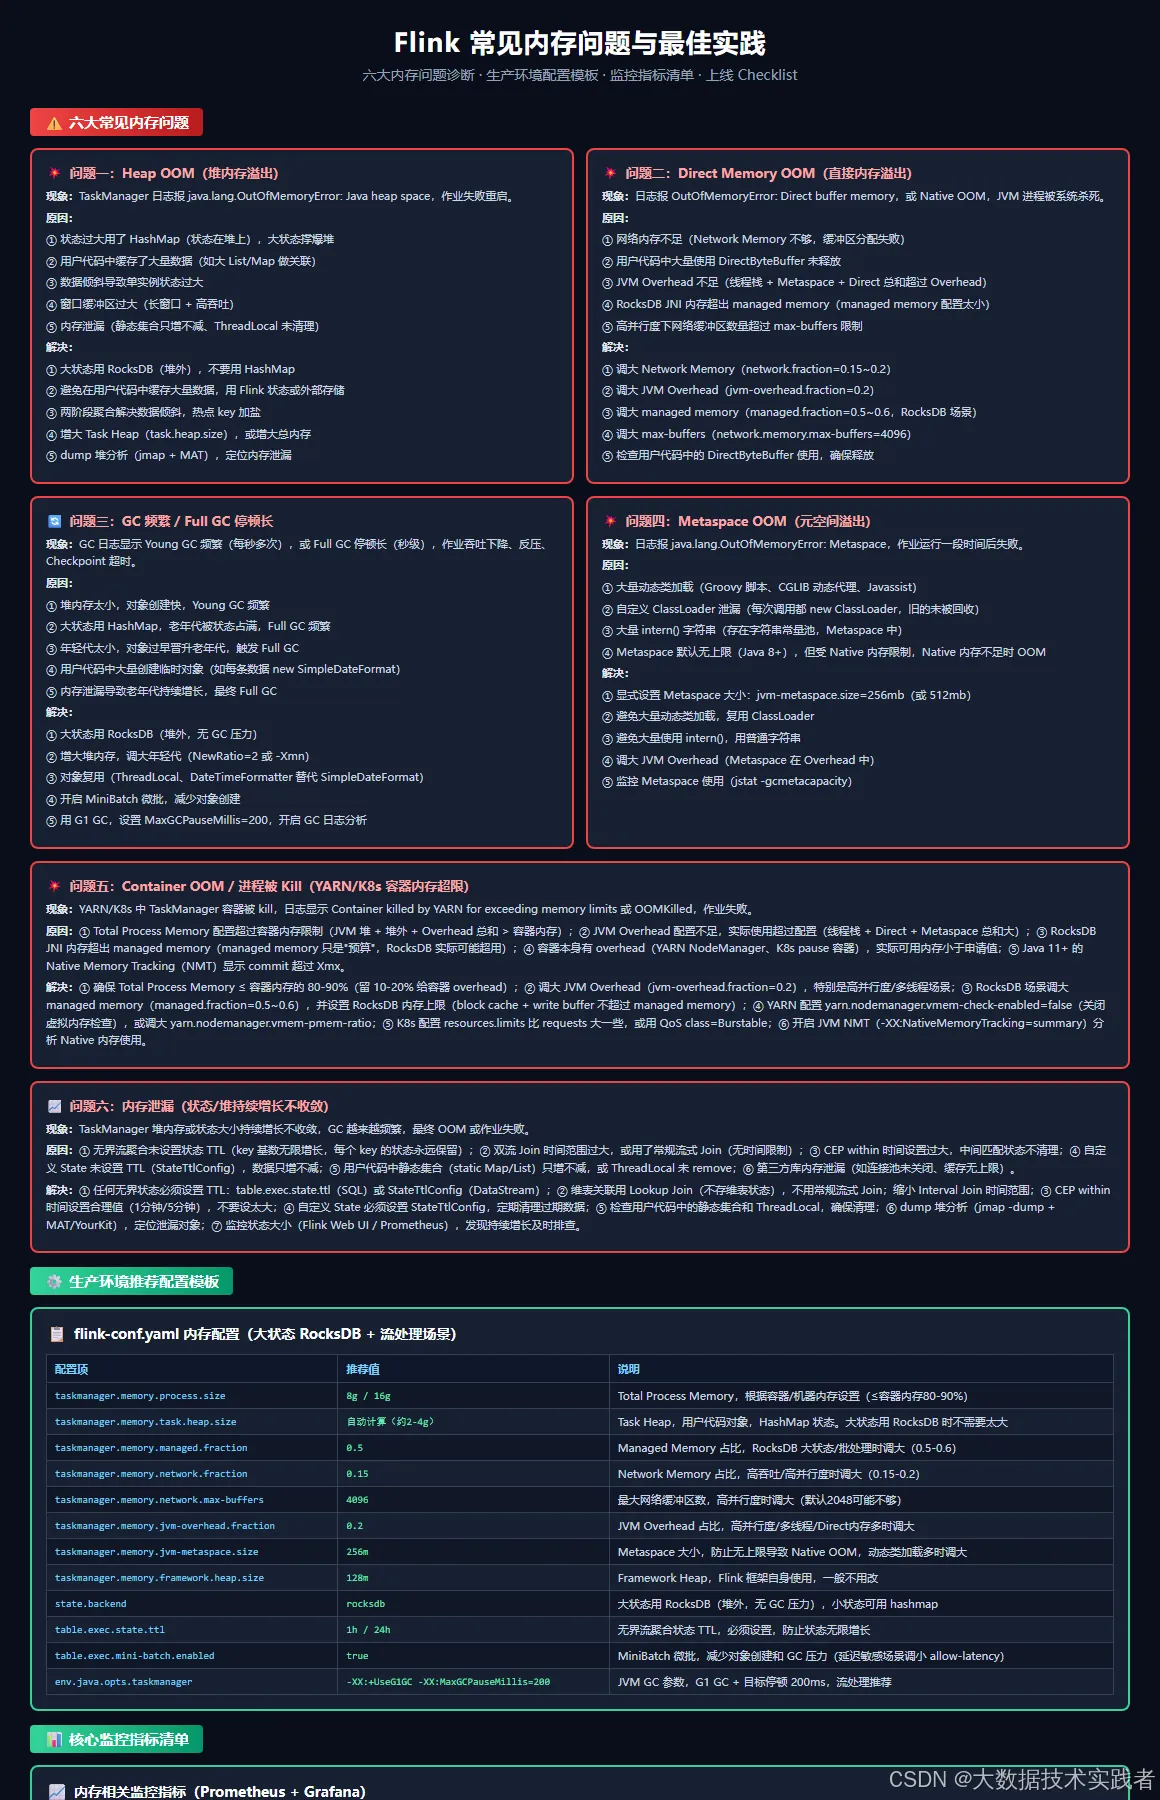
下面这张图是 Flink 常见内存问题与最佳实践,包含六大常见内存问题的诊断、生产环境配置模板、监控指标清单、上线 Checklist。
4.1 问题一:Heap OOM(堆内存溢出)
现象:TaskManager 日志报 java.lang.OutOfMemoryError: Java heap space,作业失败重启。
原因排查:
- 状态过大用了 HashMap:HashMapStateBackend 的状态在堆上,大状态撑爆堆。检查:Web UI 中状态大小,如果状态 > 堆内存的 50% 就危险了。解决:大状态用 RocksDB(堆外)。
- 用户代码中缓存大量数据:UDF 中用大 List/Map 做关联或缓存,数据只增不减。检查:代码中是否有静态集合或大的本地缓存。解决:用 Flink 状态(受 TTL 管理)或外部存储(Redis/HBase),不要在用户代码中缓存大量数据。
- 数据倾斜:热点 key 导致单实例状态过大,其他实例正常但热点实例 OOM。检查:Web UI 中各 SubTask 的状态大小是否均匀。解决:两阶段聚合(Local-Global)、热点 key 加盐、单独处理热点 key。
- 窗口缓冲区过大:长窗口(如 24 小时滚动窗口)+ 高吞吐,窗口内缓存大量数据。检查:窗口大小和吞吐,估算窗口内数据量。解决:用增量聚合(AggregateFunction/ReduceFunction)减少窗口缓冲区,或调大堆内存。
- 内存泄漏:静态集合只增不减、ThreadLocal 未清理、第三方库泄漏。检查:堆内存持续增长不收敛,GC 后也不下降。解决:dump 堆分析(
jmap -dump:format=b,file=heap.hprof <pid>+ MAT/YourKit),定位泄漏对象。
4.2 问题二:Direct Memory OOM(直接内存溢出)
现象:日志报 OutOfMemoryError: Direct buffer memory,或 Native OOM,JVM 进程被系统杀死(kill -9)。
原因排查:
- 网络内存不足:Network Memory 不够,缓冲区分配失败。检查:并行度是否大、network fraction 是否太小。解决:调大
network.fraction=0.15~0.2,调大max-buffers=4096。 - 用户代码中大量使用 DirectByteBuffer:NIO 直接缓冲区未释放。检查:代码中是否有
ByteBuffer.allocateDirect(),是否有 Netty/GRPC 等使用直接内存的库。解决:确保 DirectByteBuffer 释放(或依赖 GC 回收,但 Full GC 才回收直接内存),调大 Overhead。 - JVM Overhead 不足:线程栈 + Metaspace + Direct 总和超过 Overhead 配置。检查:高并行度时线程栈占用大,Metaspace 是否显式设置。解决:调大
jvm-overhead.fraction=0.2,显式设置jvm-metaspace.size=256m。 - RocksDB JNI 内存超出 managed memory:managed memory 只是"预算",RocksDB 实际 JNI 内存可能超用。检查:RocksDB metrics 中的 block-cache-usage、estimate-table-readers-mem。解决:调大
managed.fraction=0.5~0.6,设置 RocksDB 内存上限(rocksdb.block-cache-size、rocksdb.write-buffer-size)。 - 高并行度下网络缓冲区数量超过 max-buffers:默认 2048 不够。检查:并行度 > 100 时容易出现。解决:调大
network.memory.max-buffers=4096或更大。
4.3 问题三:GC 频繁 / Full GC 停顿长
现象:GC 日志显示 Young GC 频繁(每秒多次),或 Full GC 停顿长(秒级),作业吞吐下降、反压、Checkpoint 超时。
原因排查:
- 堆内存太小:对象创建快,Young GC 频繁。检查:堆内存大小、GC 日志中 Young GC 频率。解决:增大堆内存(
task.heap.size),或增大总内存。 - 大状态用 HashMap:老年代被状态占满,Full GC 频繁。检查:状态后端是否为 HashMap,状态大小是否接近堆大小。解决:大状态用 RocksDB(堆外,无 GC 压力)。
- 年轻代太小:对象过早晋升老年代,触发 Full GC。检查:GC 日志中老年代增长速度、晋升速率。解决:调大年轻代(
-XX:NewRatio=2或-Xmn),年轻代占堆的 30-40%。 - 用户代码中大量创建临时对象:每条数据 new 对象(如 SimpleDateFormat、大字符串拼接)。检查:代码中是否有频繁创建对象的地方。解决:对象复用(ThreadLocal、DateTimeFormatter)、StringBuilder、集合预分配大小。
- 内存泄漏:老年代持续增长,最终 Full GC。检查:GC 后老年代使用量是否持续增长。解决:dump 堆分析,定位泄漏对象。
GC 调优步骤:
- 开启 GC 日志(
-Xlog:gc*),分析 GC 频率、停顿、各代大小。 - 确认是 Young GC 频繁还是 Full GC 频繁:Young GC 频繁 → 增大年轻代或减少对象创建;Full GC 频繁 → 检查老年代增长原因(状态/泄漏)。
- 大状态一律用 RocksDB,消除堆上状态导致的 GC 问题。
- 用 G1 GC,设置合理的 MaxGCPauseMillis(200-500ms)。
4.4 问题四:Metaspace OOM(元空间溢出)
现象:日志报 java.lang.OutOfMemoryError: Metaspace,作业运行一段时间后失败。
原因排查:
- 大量动态类加载:Groovy 脚本、CGLIB 动态代理、Javassist、热部署框架,每次调用都生成新类。检查:是否使用了动态脚本引擎或动态代理。解决:复用 ClassLoader,缓存动态生成的类,避免每次都生成新类。
- 自定义 ClassLoader 泄漏:每次调用都 new ClassLoader,旧的 ClassLoader 未被回收(被其他对象引用)。检查:代码中是否有自定义 ClassLoader。解决:复用 ClassLoader,确保旧 ClassLoader 可被 GC(清除所有引用)。
- 大量 intern() 字符串:
String.intern()把字符串放入常量池(Metaspace 中),只增不减。检查:代码中是否大量使用 intern()。解决:避免使用 intern(),用普通字符串或外部缓存。 - Metaspace 默认无上限:Java 8+ Metaspace 默认不受限(只受 Native 内存限制),但 Native 内存不足时 OOM。检查:是否显式设置了 Metaspace 大小。解决:显式设置
jvm-metaspace.size=256m(或 512m),防止无上限。
4.5 问题五:Container OOM / 进程被 Kill
现象:YARN/K8s 中 TaskManager 容器被 kill,日志显示 Container killed by YARN for exceeding memory limits 或 OOMKilled,作业失败。
原因排查:
- Total Process Memory 超过容器内存:JVM 堆 + 堆外 + Overhead 总和 > 容器内存。检查:
taskmanager.memory.process.size是否 ≤ 容器内存的 80-90%。解决:总内存设为容器内存的 80-90%,留 10-20% 给容器 overhead。 - JVM Overhead 配置不足:实际使用(线程栈 + Direct + Metaspace + JNI)超过配置。检查:高并行度时线程栈占用大,Direct 内存使用多。解决:调大
jvm-overhead.fraction=0.2。 - RocksDB JNI 内存超出 managed memory:managed memory 是"预算",RocksDB 实际可能超用。检查:RocksDB block-cache-usage 是否超过 managed memory。解决:调大
managed.fraction=0.5~0.6,设置 RocksDB 内存上限。 - 容器本身有 overhead:YARN NodeManager、K8s pause 容器、容器运行时都需要额外内存。检查:容器实际可用内存是否小于申请值。解决:总内存设为容器内存的 80-90%,不要设满。
- YARN 虚拟内存检查:YARN 默认检查虚拟内存(vmem),Java 进程的虚拟内存可能很大(NIO、线程),超过虚拟内存限制被 kill。检查:YARN 日志中是否有 "virtual memory" 相关错误。解决:关闭虚拟内存检查(
yarn.nodemanager.vmem-check-enabled=false),或调大yarn.nodemanager.vmem-pmem-ratio(如 4.0)。
4.6 问题六:内存泄漏(状态/堆持续增长不收敛)
现象:TaskManager 堆内存或状态大小持续增长不收敛,GC 越来越频繁,最终 OOM 或作业失败。
原因排查:
- 无界流聚合未设置状态 TTL:key 基数无限增长(如用户 ID、设备 ID),每个 key 的聚合状态永远保留。检查:是否有无窗口的 group by,是否设置了 state.ttl。解决:设置
table.exec.state.ttl=1h(或 24h),DataStream API 用StateTtlConfig。 - 双流 Join 时间范围过大:Interval Join 时间范围大,或用了常规流式 Join(无时间限制,状态无限增长)。检查:Join 类型和时间范围。解决:维表关联用 Lookup Join(不存维表状态),缩小 Interval Join 时间范围。
- CEP within 时间设置过大:中间匹配状态保留时间长。检查:CEP pattern 的 within 时间。解决:within 时间设置合理值(1 分钟/5 分钟),不要设太大。
- 自定义 State 未设置 TTL:用户自定义的 KeyedState 没有设置 TTL,数据只增不减。检查:代码中自定义 State 的地方。解决:所有自定义 State 必须设置
StateTtlConfig,定期清理过期数据。 - 用户代码中静态集合/ThreadLocal 泄漏:static Map/List 只增不减,ThreadLocal 未 remove。检查:代码中是否有静态集合和 ThreadLocal。解决:静态集合设置上限或定期清理,ThreadLocal 使用后 remove。
- 第三方库内存泄漏:连接池未关闭、缓存无上限、监听器未注销。检查:使用的第三方库是否有已知的内存泄漏问题。解决:升级库版本,正确关闭资源,设置缓存上限。
核心原则:任何无界的状态都必须有 TTL,否则状态一定会无限增长。这是 Flink 生产环境中最常见的内存泄漏原因。
五、生产环境配置模板
下面是大状态 RocksDB + 流处理场景的生产环境推荐配置(flink-conf.yaml),可以直接参考修改:
# ========== 总内存 ==========
taskmanager.memory.process.size: 8g                    # Total Process Memory(≤容器内存80-90%)

# ========== 堆内存 ==========
taskmanager.memory.framework.heap.size: 128m           # Framework Heap(一般不用改)
# Task Heap 自动计算(总内存 - 其他区域),大状态用 RocksDB 时不需要太大

# ========== Managed Memory ==========
taskmanager.memory.managed.fraction: 0.5                # RocksDB 大状态时调大(0.5-0.6)

# ========== Network Memory ==========
taskmanager.memory.network.fraction: 0.15               # 高吞吐时调大(0.15-0.2)
taskmanager.memory.network.max-buffers: 4096            # 高并行度时调大(默认2048)
taskmanager.memory.segment-size: 32kb                    # 缓冲区大小(低延迟32KB,高吞吐64KB)

# ========== JVM Overhead ==========
taskmanager.memory.jvm-overhead.fraction: 0.2            # 高并行度时调大(默认0.15)
taskmanager.memory.jvm-metaspace.size: 256m              # Metaspace 显式设置(防止无上限)

# ========== 状态后端 ==========
state.backend: rocksdb                                     # 大状态用 RocksDB(堆外,无GC压力)
state.backend.incremental: true                            # 增量 Checkpoint
table.exec.state.ttl: 1h                                   # 无界流聚合状态 TTL(必须设置)

# ========== 性能优化 ==========
table.exec.mini-batch.enabled: true                        # MiniBatch 微批(减少对象创建和GC)
table.exec.mini-batch.allow-latency: 1s                   # MiniBatch 最大延迟

# ========== JVM GC ==========
env.java.opts.taskmanager: "-XX:+UseG1GC -XX:MaxGCPauseMillis=200 -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/tmp/heapdump.hprof"
配置说明:
- 小状态作业(<10GB)可以用 HashMap 状态后端,此时 managed.fraction 可以调小(0.1-0.2),把更多内存给堆。
- 无反压的作业 network.fraction 可以保持默认 0.1,高吞吐/高并行度时调大。
- 没有 SSD 的作业 RocksDB 性能会差一些,managed.fraction 可以适当调大增加缓存命中率。
- CheckPoint 相关配置参考前一篇《CheckPoint 优化及参数详解》。
六、核心监控指标
内存相关的监控是生产运维的核心,以下是必须监控的指标(Prometheus + Grafana):
| 指标 | 说明 | 告警阈值 |
|---|---|---|
| 堆内存使用 | Heap Used / Max | 持续 >80% 告警 |
| Managed Memory | RocksDB 内存使用 | 接近上限告警 |
| Network Memory | 网络缓冲区使用 | 缓冲区不足告警 |
| Direct Memory | 直接内存使用 | 接近 MaxDirectMemory 告警 |
| Metaspace 使用 | 类元数据占用 | 持续增长告警(可能泄漏) |
| GC 频率 | Young GC / Full GC 次数 | Full GC >1次/分钟告警 |
| GC 停顿时间 | GC pause duration | 单次 >1s 告警 |
| 状态大小 | 全量状态大小 | 持续增长告警(可能泄漏) |
| 线程数 | JVM 线程总数 | 持续增长告警(可能泄漏) |
| 容器内存 | YARN/K8s 容器使用 | >90% 告警(OOM 风险) |
| Native Memory | JVM Native 内存(NMT) | 接近容器限制告警 |
| 反压比例 | BackPressure 比例 | 高反压持续告警 |
监控建议:
- 用 Flink Prometheus Reporter 暴露指标,Grafana 搭建内存专用 Dashboard。
- 内存相关指标单独建 Dashboard,包含堆/Managed/Network/Direct/Metaspace 的趋势图、GC 频率和停顿图、状态大小趋势图。
- 告警通道用短信/电话(严重告警如 OOM、Full GC 频繁)+ 飞书/钉钉(普通告警如内存使用率高)。
- 定期检查监控数据,发现内存持续增长的趋势提前处理(如状态 TTL 未设置、内存泄漏),不要等到 OOM 才处理。
- OOM 时自动 dump 堆(
-XX:+HeapDumpOnOutOfMemoryError),便于事后分析。
七、上线 Checklist
发布前逐条确认:
- 总内存配置:Total Process Memory ≤ 容器内存的 80-90%,留 10-20% 给容器 overhead。
- 状态后端选型:大状态用 RocksDB(堆外),小状态可用 HashMap。
- Managed Memory:RocksDB/批处理时占比 0.5-0.6,流处理+HashMap 时可调小。
- Network Memory:高吞吐时占比 0.15-0.2,max-buffers 足够(高并行度时 4096+)。
- JVM Overhead:高并行度时占比 0.2,防止 Direct/Native OOM。
- Metaspace:显式设置 256m/512m,防止无上限导致 Native OOM。
- 状态 TTL:无界流聚合必须设置,防止状态无限增长。
- GC 配置:G1 GC + MaxGCPauseMillis=200,开启 GC 日志。
- 对象复用:用户代码避免每条数据 new 对象,用 ThreadLocal/DateTimeFormatter。
- MiniBatch:开启微批减少对象创建和 GC 压力(延迟敏感场景调小 allow-latency)。
- 序列化:用 POJO 类型,避免 Kryo 回退(内存大、速度慢)。
- 内存泄漏检查:静态集合/ThreadLocal/自定义 State TTL 检查。
- 监控告警:堆/Managed/Network/Direct/Metaspace/GC/状态大小监控全覆盖。
- 压测验证:峰值流量下压测,确认内存稳定不增长、GC 正常。
- 容器内存:YARN/K8s 容器内存足够,关闭虚拟内存检查或调大比例。
- 堆 dump 准备:配置 OOM 时自动 dump(
-XX:+HeapDumpOnOutOfMemoryError),便于分析。
八、总结
Flink 内存优化及参数详解要点回顾:
第一,Flink TaskManager 内存分为 JVM 堆内存(Framework Heap + Task Heap)和堆外内存(Managed Memory + Network Memory + JVM Overhead)。生产环境推荐配置 Total Process Memory,Flink 自动按比例分配各区域。大状态一律用 RocksDB(堆外),不要用 HashMap(堆上)。
第二,核心参数六大类:总内存(process.size,≤容器内存 80-90%)、堆内存(task.heap.size,流处理 2-4GB 即可)、Managed Memory(managed.fraction,RocksDB 大状态 0.5-0.6)、Network Memory(network.fraction + max-buffers,高吞吐 0.15-0.2)、JVM Overhead(jvm-overhead.fraction + jvm-metaspace.size,高并行度 0.2 + 256m)、GC 参数(G1 + MaxGCPauseMillis=200)。
第三,四大内存优化机制:堆内存优化(对象复用/POJO 序列化/MiniBatch/RocksDB 替代 HashMap)、Managed Memory 优化(占比调整/RocksDB block cache/write buffer/增量 CP/压缩)、Network Memory 优化(占比/max-buffers/segment-size/Credit-based 流控/反压处理)、JVM Overhead 优化(线程栈/Metaspace/Direct Memory/JNI/Code Cache)。GC 调优推荐 G1,年轻代占堆 30-40%,MaxGCPauseMillis 200-500ms。
第四,六大常见内存问题:Heap OOM(HashMap 大状态/用户缓存/数据倾斜/窗口缓冲区/内存泄漏)、Direct Memory OOM(网络内存不足/DirectByteBuffer/Overhead 不足/RocksDB JNI 超用/max-buffers 不够)、GC 频繁/Full GC 长(堆小/HashMap 状态/年轻代小/临时对象多/泄漏)、Metaspace OOM(动态类加载/ClassLoader 泄漏/intern()/无上限)、Container OOM(总内存超限/Overhead 不足/RocksDB 超用/容器 overhead/YARN 虚拟内存检查)、内存泄漏(无状态 TTL/Join 范围大/CEP within 大/静态集合/ThreadLocal/第三方库)。每个问题都有明确的排查方法和解决方案。
第五,生产环境配置模板:给出了大状态 RocksDB + 流处理场景的完整 flink-conf.yaml 配置(16 项关键配置),可以直接参考修改后在生产环境使用。
第六,监控指标和上线 Checklist:12 个核心监控指标(堆/Managed/Network/Direct/Metaspace/GC 频率/GC 停顿/状态大小/线程数/容器内存/Native Memory/反压),16 项上线 Checklist(总内存/状态后端/Managed/Network/Overhead/Metaspace/状态 TTL/GC 配置/对象复用/MiniBatch/序列化/泄漏检查/监控/压测/容器内存/堆 dump)。
内存优化的核心思路是"理解模型、合理分配、监控预警、快速定位"——理解 Flink 的内存模型(每个区域的作用),合理分配各区域大小(根据作业类型调整 fraction),通过全面的监控提前发现内存异常(持续增长、GC 频繁),OOM 时通过堆 dump 和 GC 日志快速定位根因。掌握了这些,就能让 Flink 作业在生产环境中稳定运行,不再被内存问题困扰。
Flink 优化系列还会继续深入(如反压原理与调优、状态管理优化、SQL 性能调优等),敬请关注。


